

크리에이터 조사에 오후 시간을 쏟다 보면 어느새 틱톡, 유튜브, 인스타그램을 훑어보고 조회수를 시트에 옮겨 적다가 정작 중요한 게시물 하나를 잃어버리는 일이 다반사죠.
매주 크리에이터 관련 연구 자료를 받는 것은 그런 루틴을 없애버립니다.
배우를 Apify 공개 크리에이터 게시물을 스크랩하고, n8n 자동화 워크플로우 모든 게시물에 점수를 매기고, 이상치를 표시하고 질문을 던집니다. AI 낚시바늘 패턴을 식별하는 모델.
그러면 매주 같은 날짜에 깔끔하게 정리된 요약본이 Gmail로 도착하여 첫 커피를 마시기 전에 준비할 수 있습니다.
아래는 액터 입력부터 시작하여 노드별로 구성된 전체 빌드 과정입니다. 참여도 점수 산정 로직 에 AI 콘텐츠 요약 그리고 오류 알림 기능도 있습니다. 이론이 아니라, 누구나 따라할 수 있는 시스템입니다.
아이모조's 빠른 평결
매주 당신의 이메일함에 도착하는 것들
노드를 수정하기 전에 출력을 잠그세요. 연구용 이메일 수신함은 모든 이메일이 동일한 질문에 동일한 순서로 답변할 때만 제대로 작동합니다.
| 요약 섹션 | 그것이 보여주는 것 | 소스 노드 |
|---|---|---|
| 상위 이상치 | 조회수가 가장 높은 게시물과 게시물 작성자 비교's 일반적인 중앙값 | 점수 코드 노드 |
| 참여 리더 | 조회수 대비 좋아요, 댓글, 공유 횟수가 가장 많은 게시물 | 점수 코드 노드 |
| 패턴 참고 사항 | 수상작 전반에 걸쳐 반복되는 핵심 요소, 형식 및 주제 | 기본 LLM 체인 |
| 콘텐츠 아이디어 | 이번 주에 팀에서 테스트해 볼 수 있는 세 가지 아이디어 | 기본 LLM 체인 |
| 원시 로그 링크 | 나중에 필터링할 수 있도록 스크랩한 모든 게시물이 포함된 Google 스프레드시트 | Google Sheets 노드 |
대행사는 이를 활용하여 클라이언트에게 브리핑하고, 브랜드 팀은 인플루언서 파트너십을 발굴하며 , 개인 크리에이터는 앱을 하나도 열지 않고 경쟁사를 추적합니다.
데이터 흐름은 단순하게 유지됩니다.
크리에이터 데이터에 적합한 Apify 액터 선택하기
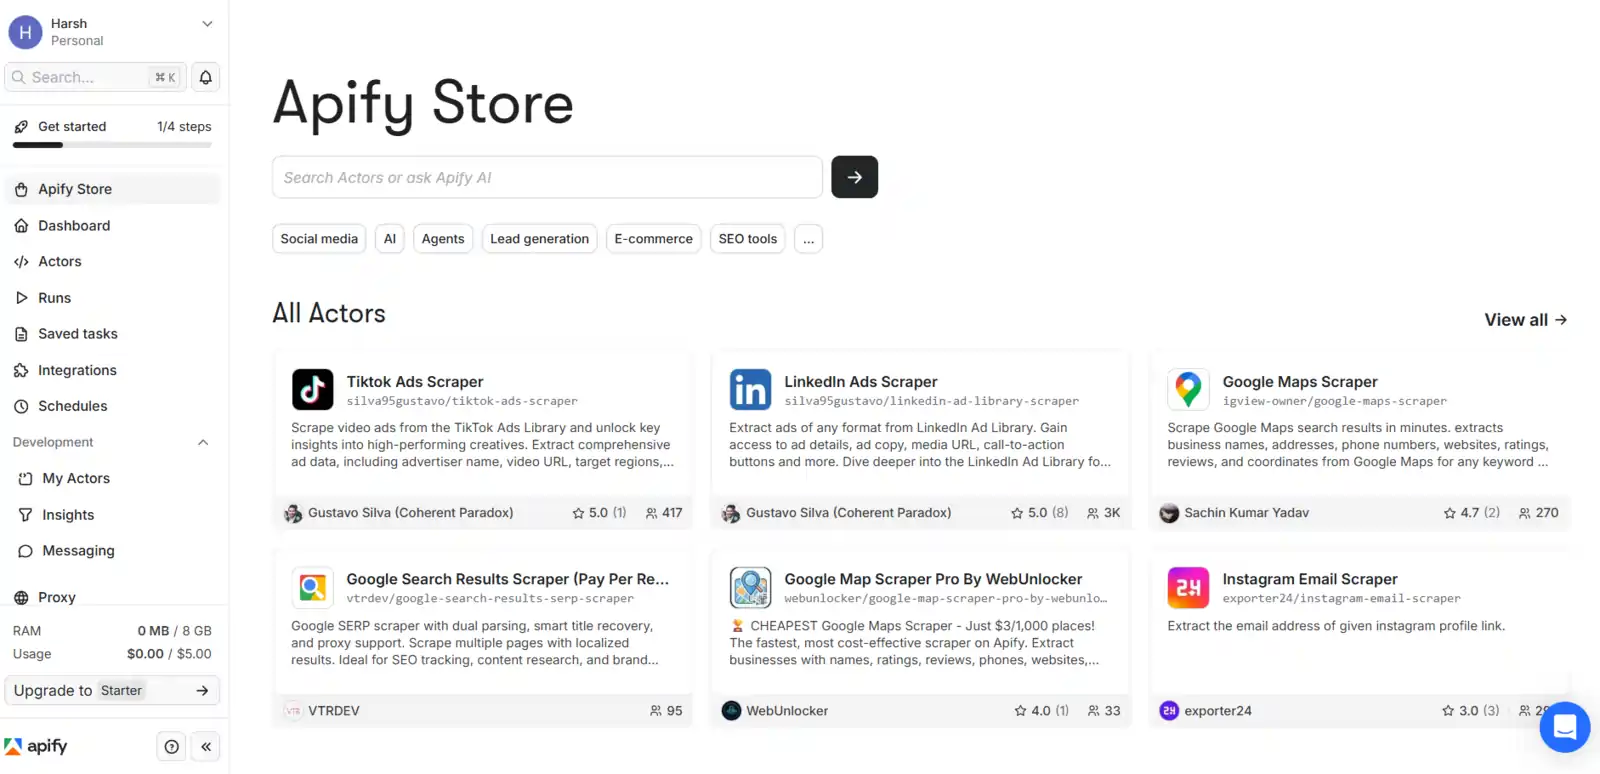
Apify Store는 Actors라는 이름의 스크래퍼를 제공합니다. 이 중 세 가지가 대부분의 크리에이터 조사 요구 사항을 충족하며, 각각 주간 단위로 간결한 데이터를 가져올 수 있는 날짜 필터를 제공합니다.
| 배우 | 주요 입력 필드 | 유지할 가치가 있는 출력 필드 |
|---|---|---|
| 유튜브 스크래퍼스트리머/유튜브 스크래퍼 | startUrls, maxResults, maxResultsShorts, maxResultStreams, sortVideosBy, oldestPostDate | 제목, URL, 날짜, 조회수, 좋아요 수, 댓글 수, 채널 이름, 구독자 수 |
| TikTok 스크레이퍼clockworks/tiktok-scraper | 프로필, 페이지당 결과 수, 프로필 정렬, 고정 게시물 제외, 가장 오래된 게시물 날짜 통합 | 텍스트, 웹비디오URL, 생성 시간 ISO, 재생 횟수, 조회 횟수, 댓글 수, 공유 횟수, 수집 횟수, 작성자 메타 팬 수 |
| 인스 타 그램 스크레이퍼apify/instagram-scraper | directUrls, resultsType, resultsLimit, onlyPostsNewerThan | 캡션, URL, 숏코드, 타임스탬프, 좋아요 수, 댓글 수, 동영상 조회수, 소유자 사용자 이름 |
여기서 몇 가지 세부 사항이 중요합니다. 유튜브 스크래퍼's 날짜 범위는 채널 URL에만 적용되며, 모든 유형 제한을 0으로 설정하면 해당 형식은 완전히 건너뛰게 됩니다.
TikTok Scraper의 profileSorting은 최신, 인기 또는 오래된 순으로 정렬할 수 있습니다. 날짜 필터 는 Actor 페이지에서 유료 필터로 표시되어 있으므로 활성화하기 전에 확인하십시오.
인스타그램 팔로워 수와 프로필 정보가 필요하신가요? Instagram Profile Scraper (apify/instagram-profile-scraper)에 사용자 이름 배열을 입력하세요. 팔로워 수, 프로필 정보, 인증 여부, 최신 게시물을 반환합니다.
자막은 선택 사항입니다. YouTube 스크래퍼's transcriptionAndSubtitle 및 TikTok 스크래퍼's downloadSubtitlesOptions는 음성 후크를 추출하여 다음과 같이 만듭니다. AI 패턴 음표가 훨씬 더 선명합니다.
n8n용 공식 Apify 노드 내부
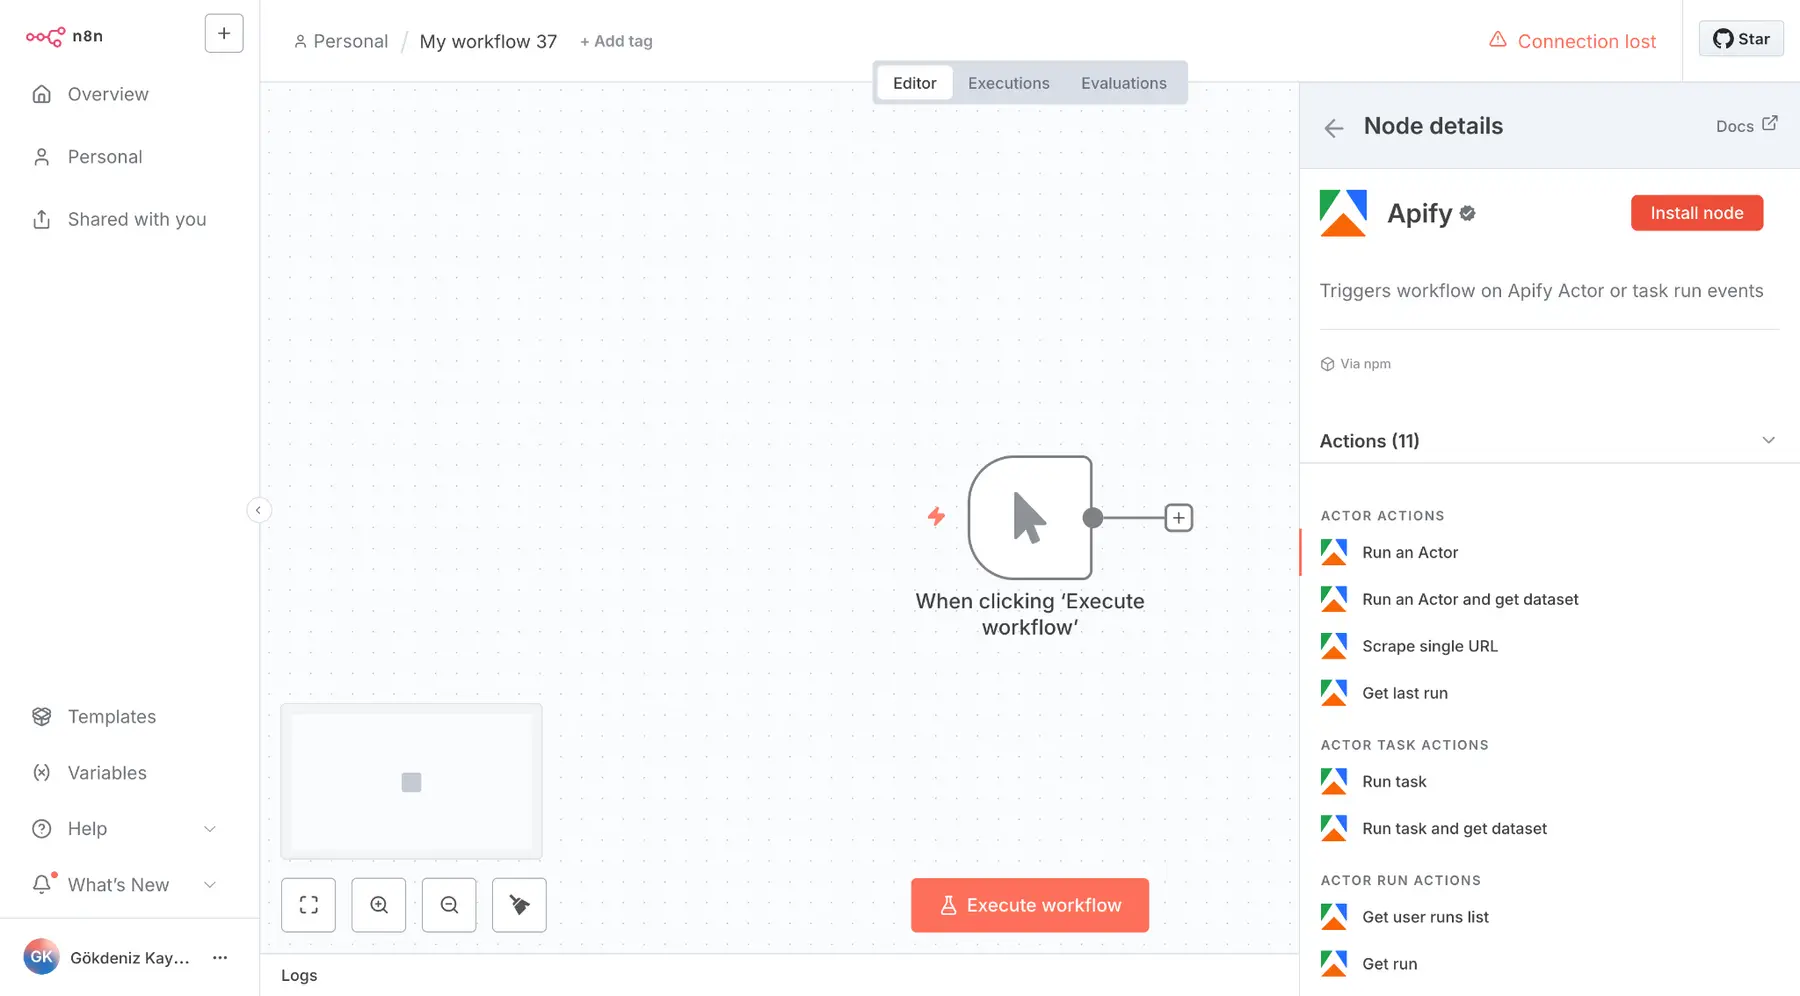
Apify는 검증된 커뮤니티 노드인 @apify/n8n-nodes-apify를 제공합니다. n8n 클라우드의 노드 패널에서 "Apify"를 검색하고 설치하세요. 단, 관리자 패널에서 검증된 커뮤니티 노드 설치가 허용되어 있어야 합니다.
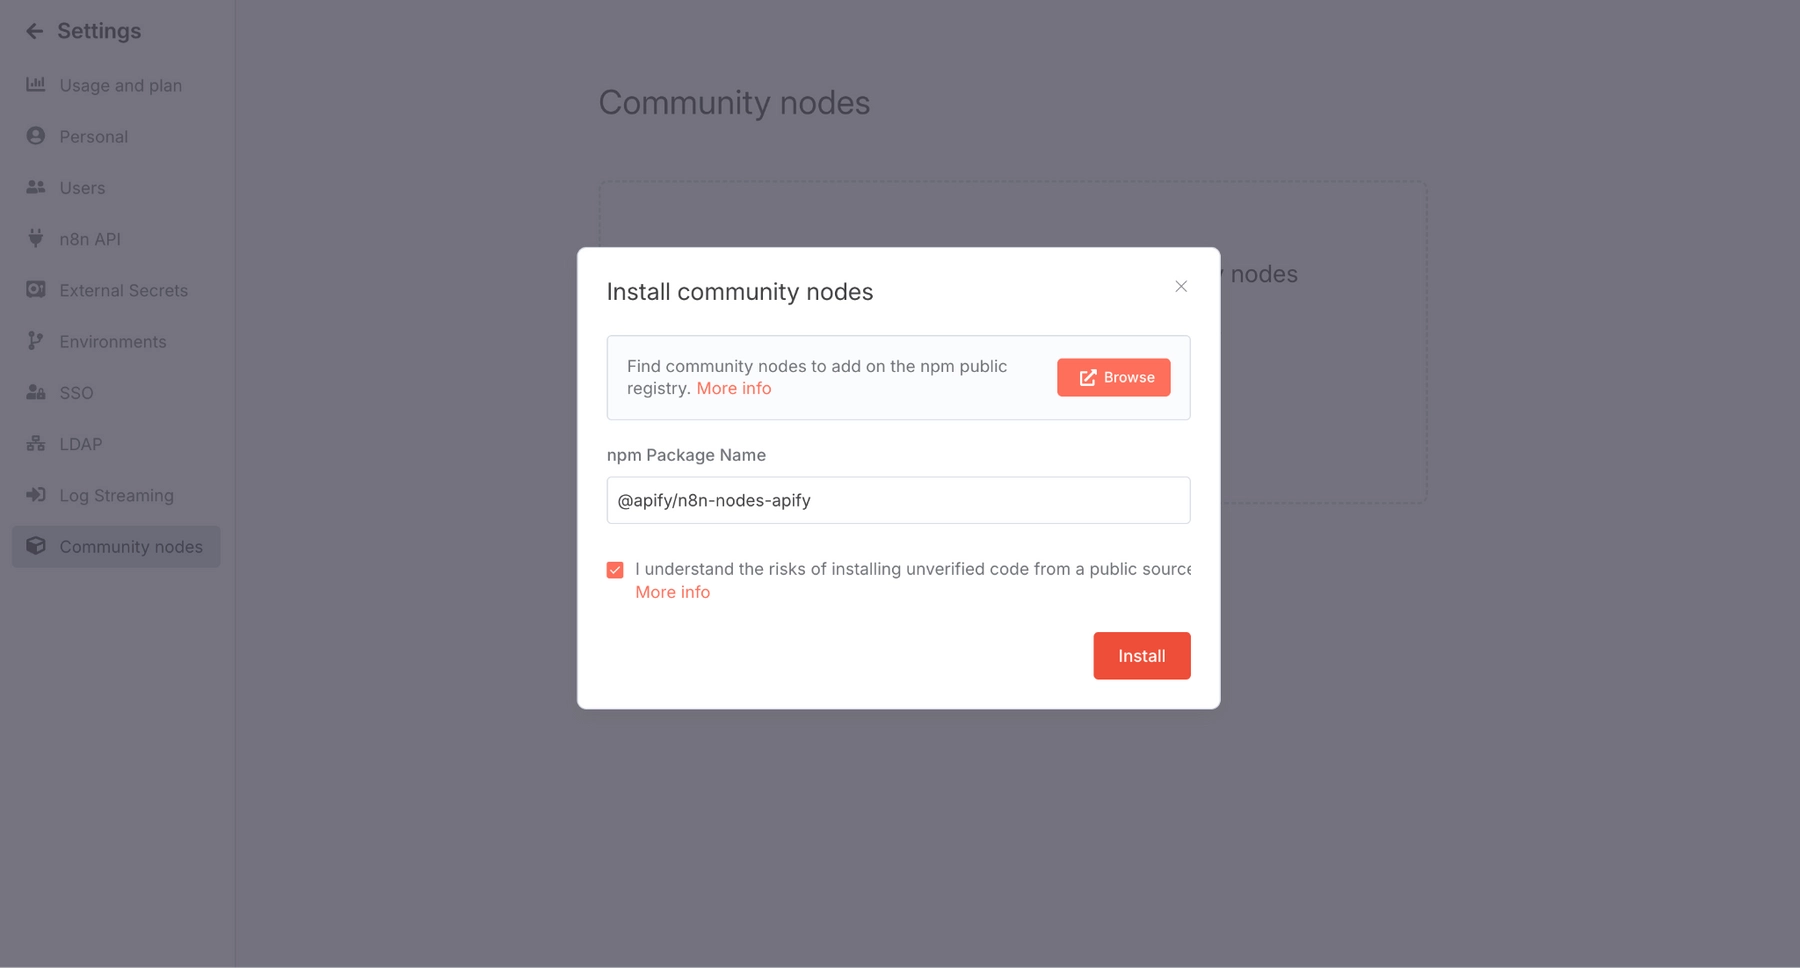
자체 호스팅 n8n에서 설정 > 커뮤니티 노드를 열고 패키지 이름을 붙여넣은 다음 설치하세요. 해당 노드에는 n8n 1.57.0 이상 버전이 필요합니다.
| 자원 | 운영 가능 | 이 빌드에서 사용 |
|---|---|---|
| 배우 | 액터 실행, 액터를 실행하고 데이터셋 가져오기, 웹 페치, 최신 실행 결과 가져오기 | 주요 스크래핑 단계 |
| 배우의 역할 | 작업을 실행하고, 작업을 실행한 후 해당 데이터셋을 가져옵니다. | 클리너 입력값이 Apify에 저장되었습니다. |
| 배우 처형 | 하나 가져오기, 여러 개 가져오기, 중단 | 디버깅 및 정리 |
| 스토리지 | 데이터셋 항목을 가져오고, 키-값 저장소 레코드를 가져옵니다. | defaultDatasetId를 사용하여 결과를 가져옵니다. |
| 트리거 | 새로운 Apify 이벤트 발생 시 (성공, 실패, 중단, 시간 초과, 기타) | 대규모 명단용 분할형 받은 편지함 |
인증은 양방향으로 작동합니다 . Apify API 자격 증명은 Apify 콘솔에서 API 토큰을 가져오며, Apify OAuth2 API는 n8n 클라우드에서만 단 한 번의 클릭으로 연결할 수 있습니다.
Actor 작업은 사용자 지정 입력 (JSON), 시간 초과(초), 메모리 사용량(메가바이트), 빌드 태그 및 완료 대기 시간도 노출합니다.
사용자 지정 입력란을 비워두면 액터는 저장된 기본 입력란을 사용합니다.
주간 크리에이터 리서치 워크플로 단계별 가이드
1단계: Google Sheets에서 제작자 명단 설정
'Creator Roster' 라는 이름의 시트를 만들고 다음 열들을 추가하세요. 팀원들은 n8n을 열지 않고도 Sheets에서 바로 크리에이터를 추가하거나 일시 중지할 수 있습니다.
'게시물 기록' 이라는 두 번째 탭을 추가하세요 . 모든 점수가 매겨진 게시물이 거기에 기록되어 시간이 지남에 따라 더 나은 기준선을 설정할 수 있는 기록을 제공합니다.
2단계: 각 스크래퍼를 Apify 액터 작업으로 저장합니다.
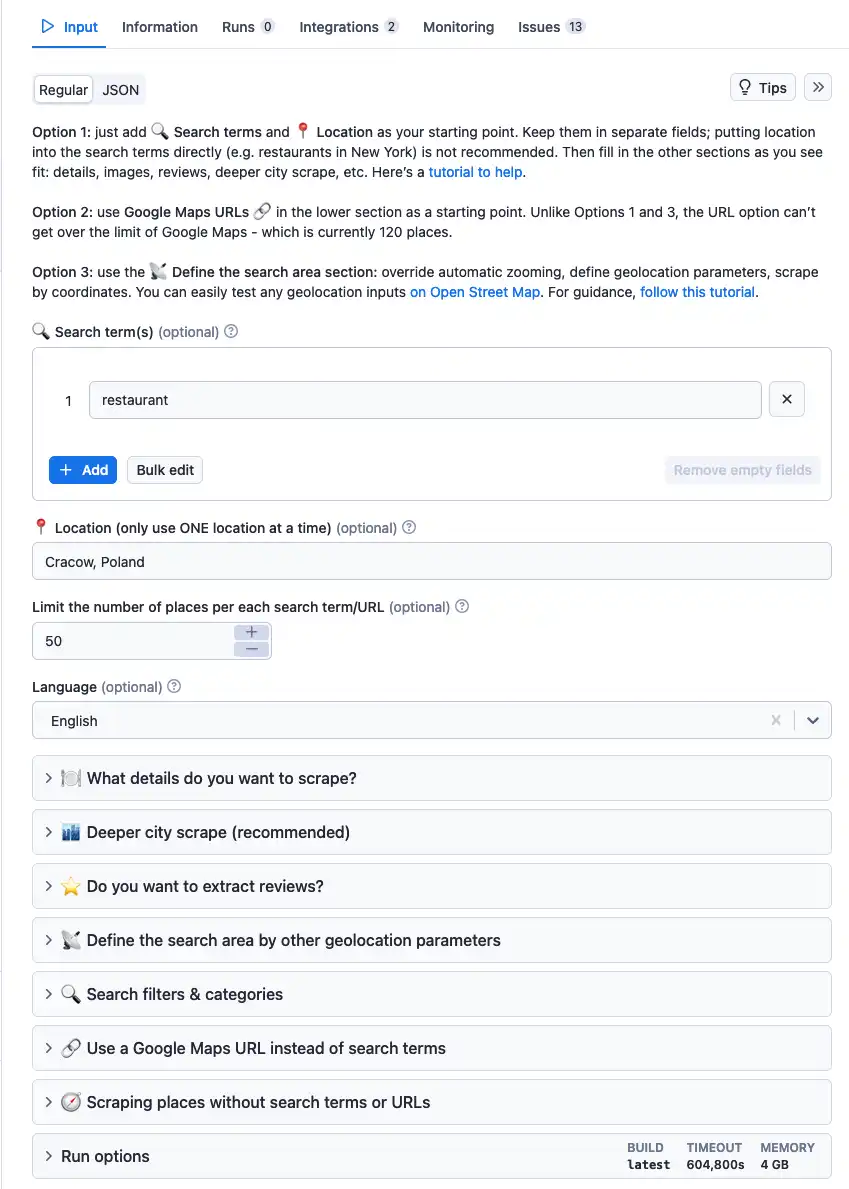
Apify 콘솔에서 각 액터를 열고 적절한 제한을 설정한 다음 " 새 작업으로 저장"을 클릭합니다.
Apify Actor 작업은 입력과 타임아웃 및 메모리를 저장하므로 n8n 측이 깔끔하게 유지됩니다.
다운로드 토글은 모두 꺼두세요. 동영상 파일 , 앨범 커버, 아바타는 용량만 늘리고 연구에는 도움이 되지 않습니다.
3단계: Apify, Google Sheets 및 Gmail 자격 증명 연결
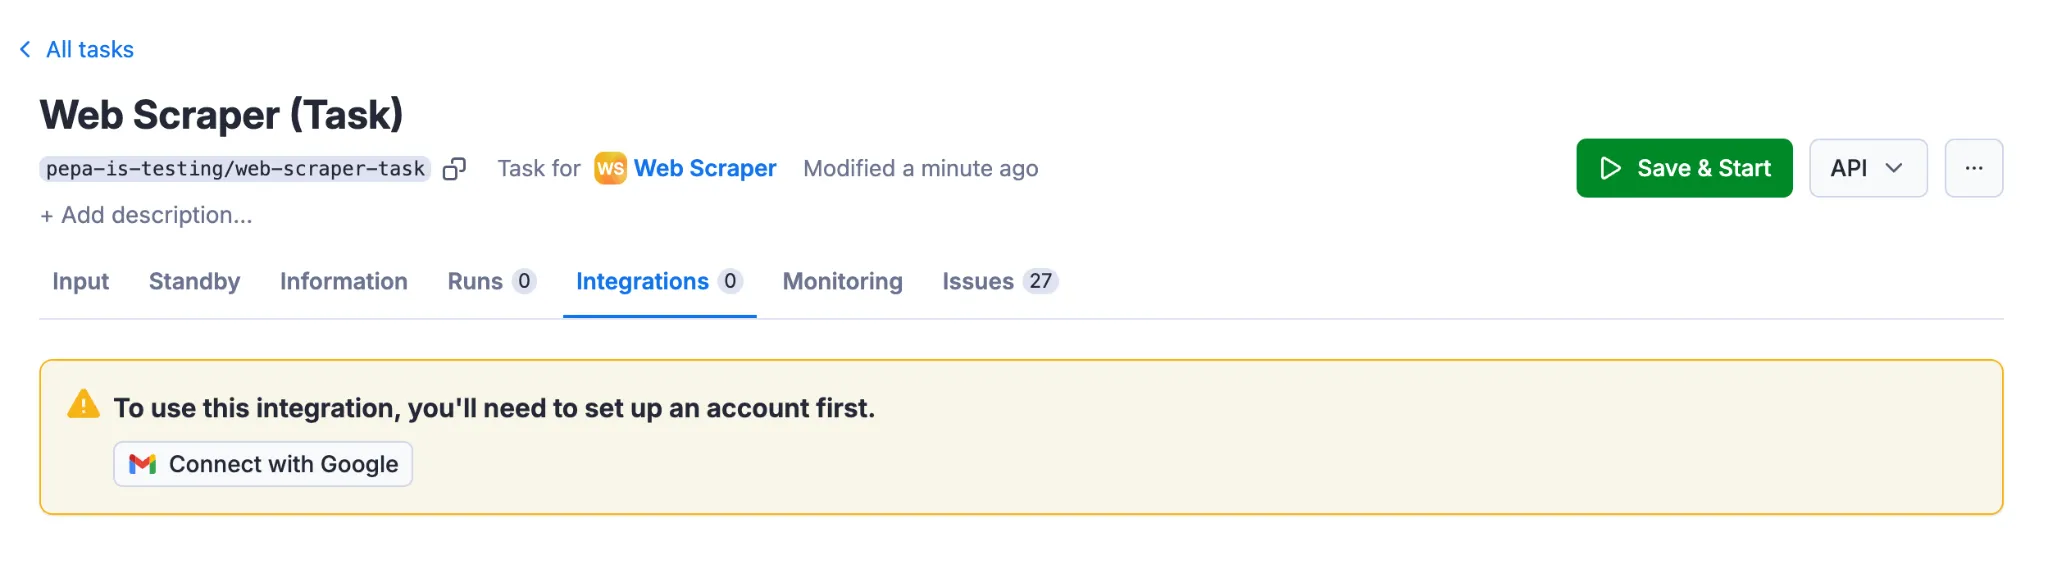
Apify 노드를 설치한 다음 n8n에 Apify API , Google Sheets OAuth2 및 Gmail OAuth2 세 가지 자격 증명을 추가하세요 . 추가 빌드를 진행하기 전에 각각을 테스트하십시오.
워크플로 도중에 자격 증명이 손상되면 스크래핑 노력이 낭비되므로 이 검사는 매우 유용합니다.
4단계: n8n 스케줄 트리거 구성
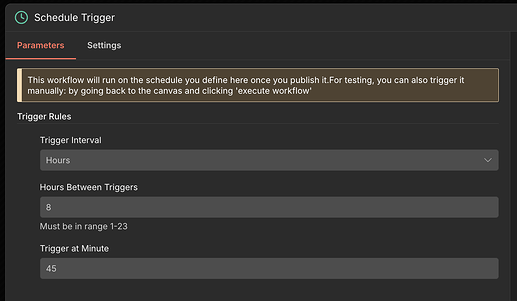
다음 설정을 사용하여 스케줄 트리거 노드를 추가하세요.
| 너는 싫어ld | 가치관 |
|---|---|
| 트리거 간격 | 주 |
| 유발 요인 사이의 간격(주 단위) | 1 |
| 평일 트리거 | 월 |
| 정각에 트리거 | 7am |
| 분에 트리거 | 0 |
워크플로 설정 에서 시간대를 설정하세요 . 시간대를 설정하지 않으면 n8n은 인스턴스 시간대를 사용하며, 자체 호스팅 설치의 경우 기본값으로 America/New_York이 사용됩니다.
cron을 선호하시나요? 0 7 * * 1을 사용하여 사용자 지정(Cron)을 사용하세요 . 어느 경우든 n8n 스케줄 트리거는 워크플로가 저장되고 게시된 후에만 실행됩니다.
5단계: 코드 노드를 사용하여 플랫폼 입력 구축
Google Sheets 노드(행 가져오기, 제작자 명단 탭)를 추가한 다음 코드 노드를 추가합니다. 이 코드 노드는 명단 행을 플랫폼별로 하나의 입력 객체로 변환합니다.
const rows = $input.all().map(i => i.json).filter(r => r.active === 'yes');

const since = $now.minus({ days: 7 }).toFormat('yyyy-MM-dd');

const pick = p => rows.filter(r => r.platform === p);

return [{ json: {

  youtube: {

    startUrls: pick('youtube').map(r => ({ url: r.profile_url })),

    maxResults: 15, maxResultsShorts: 15, maxResultStreams: 0,

    sortVideosBy: 'NEWEST', oldestPostDate: since

  },

  tiktok: {

    profiles: pick('tiktok').map(r => r.handle),

    resultsPerPage: 20, profileSorting: 'latest',

    excludePinnedPosts: true, oldestPostDateUnified: since

  },

  instagram: {

    directUrls: pick('instagram').map(r => r.profile_url),

    resultsType: 'posts', resultsLimit: 20, onlyPostsNewerThan: since

  }

}}];
$now는 n8n입니다's 룩손 날짜 기능이 내장되어 있어 7일 간격의 날짜가 매주 자동으로 조정됩니다. 수동으로 날짜를 수정할 필요가 전혀 없습니다.
6단계: 세 개의 Apify 액터를 병렬로 실행합니다.
Code 노드를 세 개의 Apify 노드로 분기합니다. 작업을 실행하고 데이터셋 항목을 반환하는 연산을 사용하여 Actor Tasks 리소스를 선택합니다.
사용자 지정 입력에서 일치하는 객체를 표현식으로 전달합니다.
{{ JSON.stringify($json.youtube) }}$json.tiktok과 $json.instagram에 대해서도 동일한 과정을 반복합니다. 사용자 지정 입력은 저장된 작업 입력을 덮어쓰지만, 시간 초과 및 메모리 사용량은 여전히 작업에서 가져옵니다.
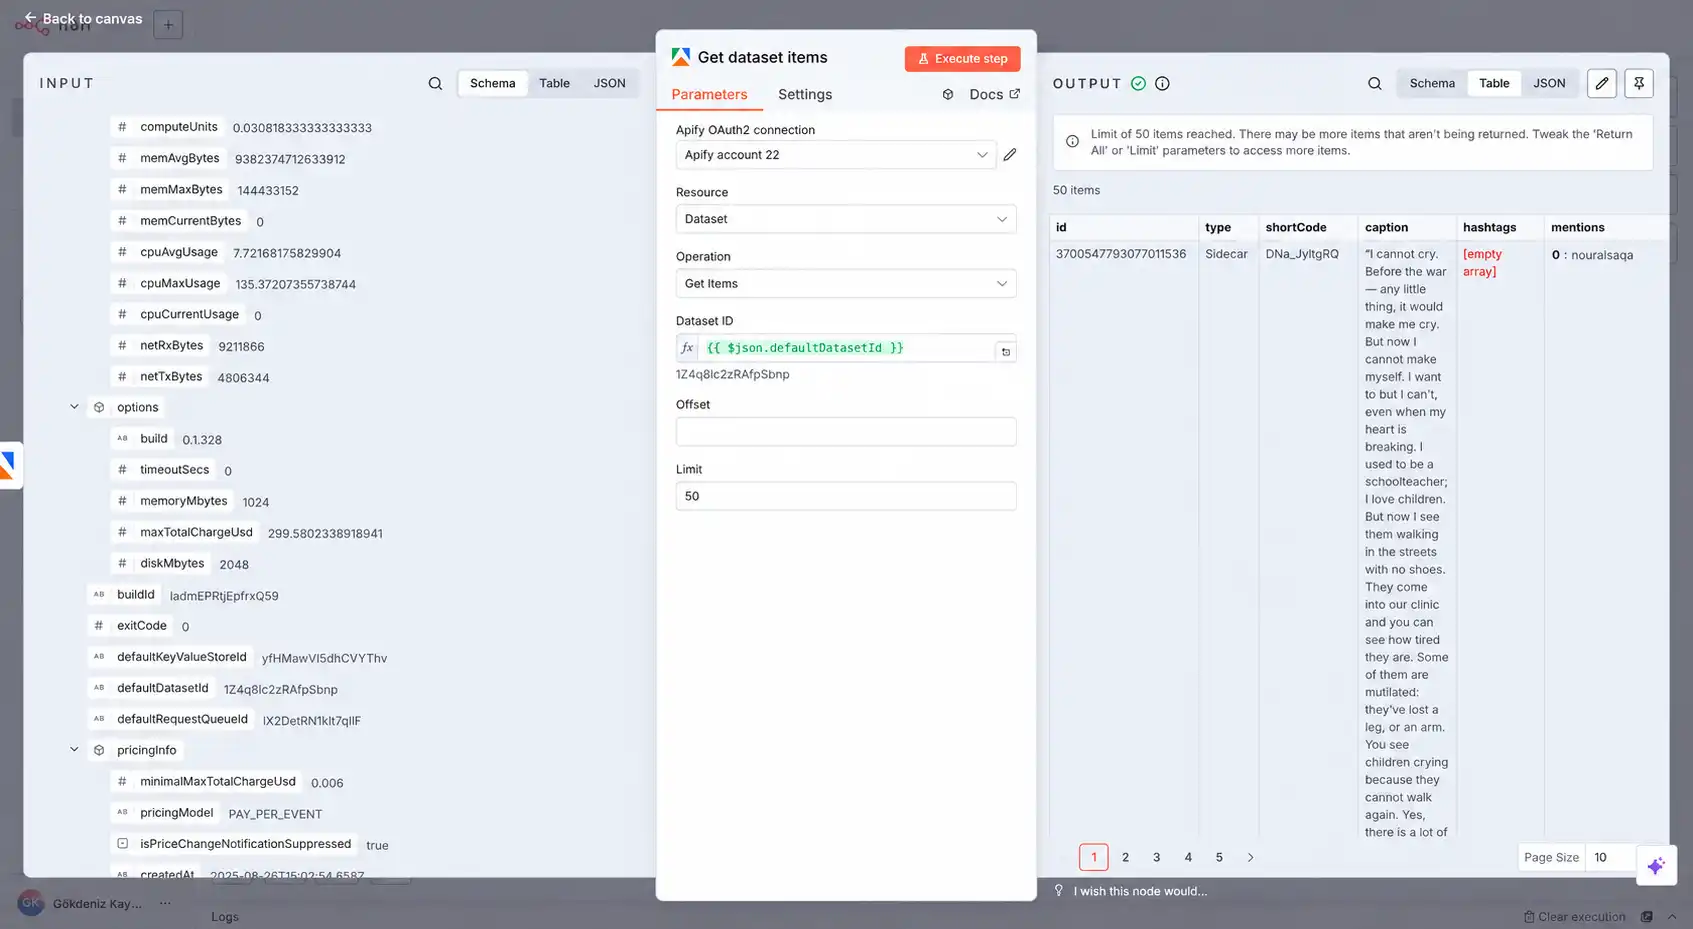
두 개의 별도 노드를 선호하시나요? `Wait for finish` 옵션을 켜고 액터를 실행한 다음, `{{ $json.defaultDatasetId }}`를 사용하여 데이터셋 항목을 가져오세요. 두 경로 모두 동일한 데이터를 반환합니다.
7단계: 하나의 스키마로 병합 및 정규화
세 개의 Apify 노드를 모두 '추가'로 설정된 병합 노드에 연결합니다. 각 플랫폼마다 필드 이름이 다르므로 코드 노드를 사용하여 이러한 필드를 하나의 공통된 형태로 매핑합니다.
const out = [];

for (const { json: p } of $input.all()) {

  if (p.error) continue; // skip failed inputs

  if (p.webVideoUrl) {

    out.push({ platform: 'tiktok', post_id: p.id, creator: p.authorMeta?.name,

      url: p.webVideoUrl, caption: p.text, published: p.createTimeISO,

      views: p.playCount, likes: p.diggCount, comments: p.commentCount,

      shares: p.shareCount });

  } else if (p.shortCode) {

    out.push({ platform: 'instagram', post_id: p.shortCode, creator: p.ownerUsername,

      url: p.url, caption: p.caption, published: p.timestamp,

      views: p.videoViewCount ?? null, likes: p.likesCount,

      comments: p.commentsCount, shares: null });

  } else if (p.viewCount !== undefined) {

    out.push({ platform: 'youtube', post_id: p.id, creator: p.channelName,

      url: p.url, caption: p.title, published: p.date,

      views: p.viewCount, likes: p.likes, comments: p.commentsCount,

      shares: null });

  }

}

return out.map(json => ({ json }));
YouTube 스크래퍼는 삭제된 동영상이나 누락된 채널에 대해 오류 항목을 기록합니다. p.error 검사는 이러한 오류가 점수에 영향을 미치기 전에 제거합니다.
8단계: 이상치 및 참여도 계산을 사용하여 모든 게시물에 점수를 매기세요
실제 조회수는 대형 계정의 조회수를 실제보다 높게 보이게 합니다. 크리에이터 이상치 점수는 각 게시물을 해당 크리에이터의 중간값과 비교하므로, 소규모 채널의 급증하는 조회수가 눈에 띄게 나타납니다.
| 메트릭 | 공식 | 그것이 당신에게 말하는 것 |
|---|---|---|
| 이상치 점수 | 게시물 조회수 ÷ 크리에이터 평균 조회수 | 포스트가 자신의 기준선을 얼마나 벗어났는지 |
| 참여율 | (좋아요 + 댓글 + 공유) ÷ 조회수 × 100 | 시청자들의 반응은 얼마나 격렬했는가? |
| 인스타그램 대체 기능 | 게시물 좋아요 수 ÷ 크리에이터 평균 좋아요 수 | 조회수가 없는 이미지 게시물에 적용됩니다. |
const items = $input.all().map(i => i.json);

const base = it => it.views || it.likes || 0;

const groups = {};

for (const it of items) (groups[it.creator] ??= []).push(base(it));

const median = a => { const s = [...a].sort((x, y) => x - y), m = Math.floor(s.length / 2);

  return s.length % 2 ? s[m] : (s[m - 1] + s[m]) / 2; };

return items.map(it => {

  const med = median(groups[it.creator]) || 1;

  const eng = it.views ? ((it.likes || 0) + (it.comments || 0) + (it.shares || 0)) / it.views * 100 : null;

  return { json: { ...it, outlier: +(base(it) / med).toFixed(2),

    engagement: eng === null ? null : +eng.toFixed(2) } };

}).sort((a, b) => b.json.outlier - a.json.outlier);
일주일치 게시물만으로는 충분한 기준선을 설정하기 어렵습니다. 몇 주 후에는 '게시물 로그' 탭을 읽고 과거 기록을 기반으로 중앙값을 계산하세요.
9단계: 중복 제거 노드를 사용하여 반복 항목을 차단합니다.
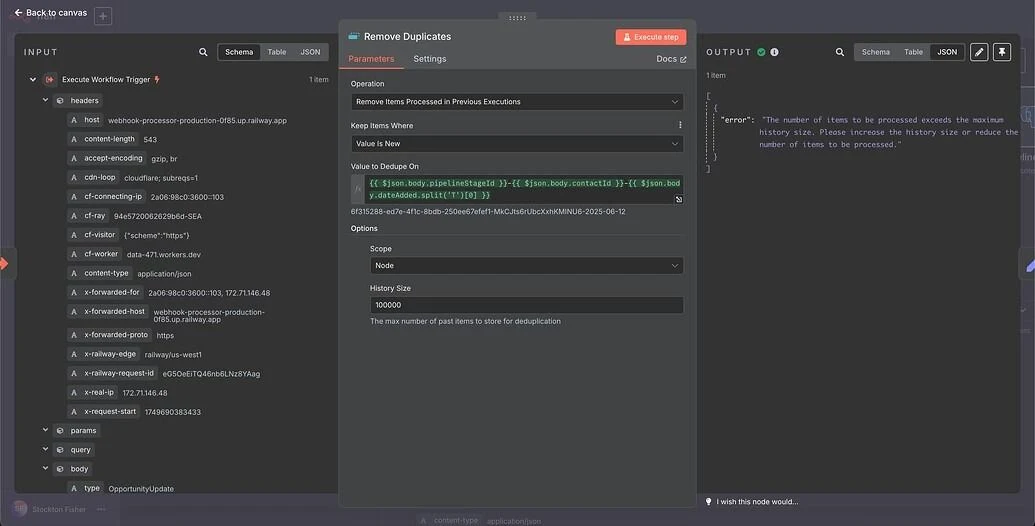
점수 계산 후 중복 제거 노드를 추가합니다 . 작업 설정을 "이전 실행 에서 처리된 항목 제거" 및 "값이 새로운 항목 유지 "로 지정합니다.
이 영구 중복 제거 기능은 수동으로 다시 트리거할 때 동일한 게시물이 두 번 이메일로 전송되는 것을 방지합니다. 테스트 중에는 중복 제거 기록을 지우면 이 기능이 초기화됩니다.
10단계: 추가 AI 패턴 분석 레이어
Limit 노드를 사용하여 상위 15개 게시물을 유지한 다음, Aggregate 노드를 모든 항목 데이터로 설정합니다. 그러면 전체 배치가 전달됩니다. AI 하나의 품목으로.
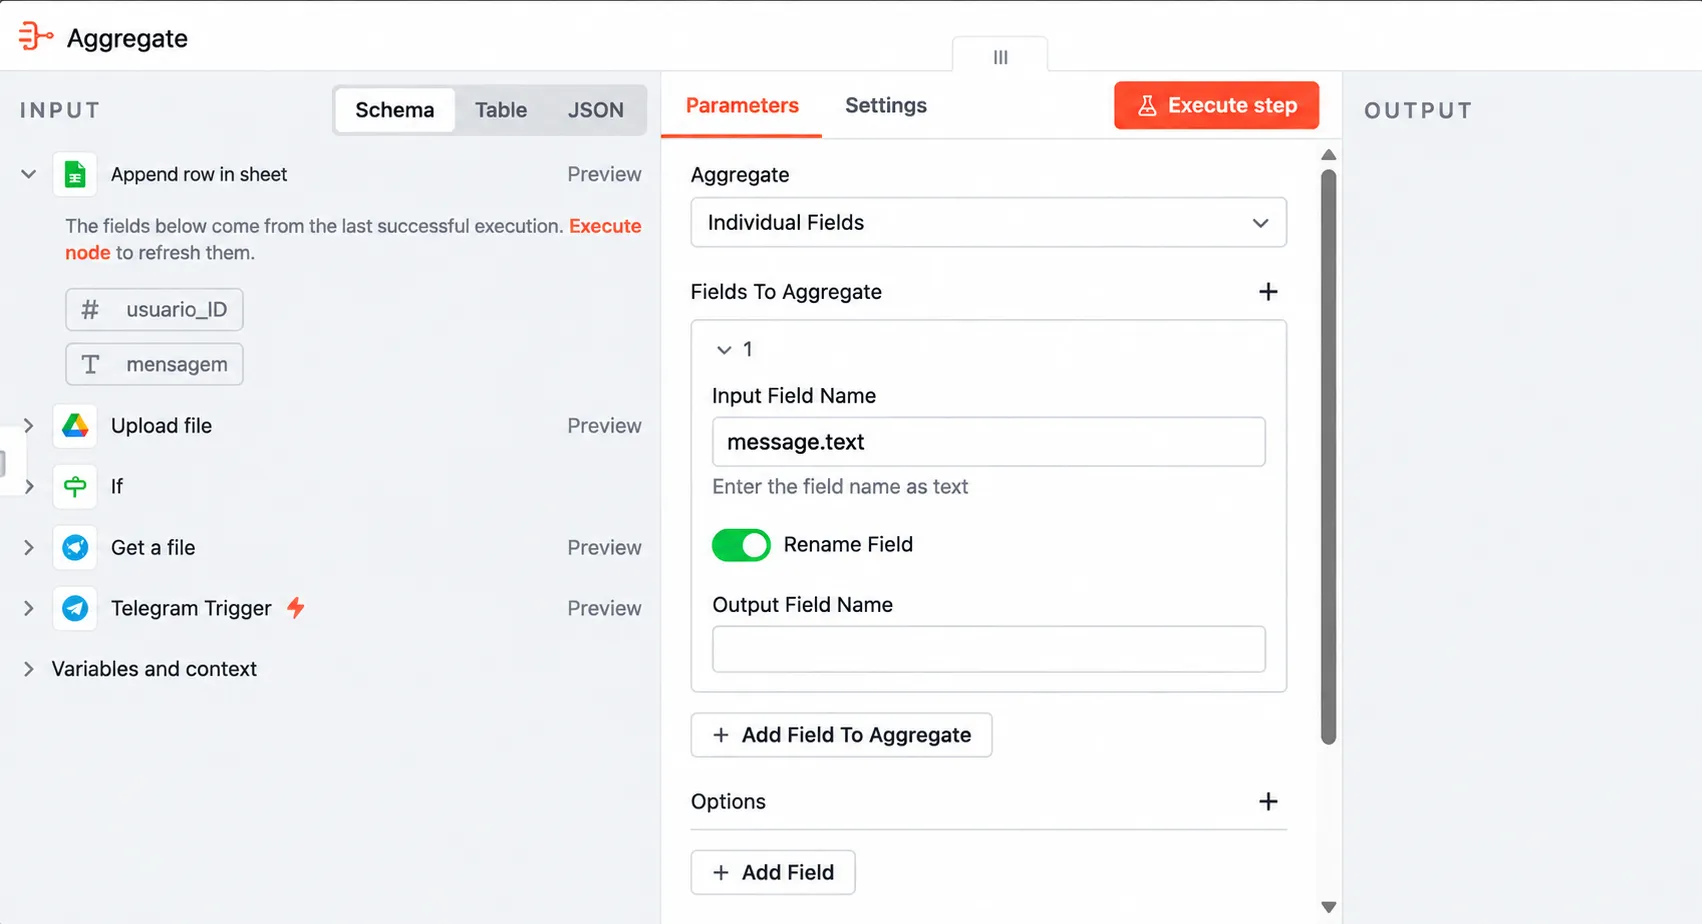
다음으로, OpenAI, Anthropic 또는 Gemini와 같이 이미 사용 중인 채팅 모델을 사용하여 기본 LLM 체인을 추가하세요.
'특정 출력 형식 요구' 옵션을 켜고 구조화된 출력 파서를 연결하세요.
당신은 단편 콘텐츠 전략가 입니다.
이번 주 소식은 다음과 같습니다.'s 인기 크리에이터의 게시물을 JSON 형식으로 제공하며, 이상치 점수 순으로 순위를 매깁니다.
다음과 같은 JSON을 반환합니다.
– “패턴”: 반복적으로 나타나는 3가지 유형 또는 형식, 각각 게시물 URL을 언급함
– “주제”: 2개 이상의 수상 게시물에 등장하는 주제
– “아이디어”: 우리 팀이 이번 주에 촬영할 수 있는 콘텐츠 아이디어 3가지
데이터에서 얻은 증거만 사용하십시오. 패턴이 약하면 그렇게 명시하십시오.
{{ JSON.stringify($json.data) }}자막만으로는 짧은 영상의 성패를 좌우하는 핵심적인 음성적 매력을 놓칠 수 있습니다.'s 운명.
YouTube 또는 TikTok 작업에서 자막 기능을 활성화한 경우, 자막 텍스트의 첫 줄을 정규화된 항목에 포함합니다.
해당 텍스트를 대략 처음 300자 정도로 다듬습니다. 그러면 모델은 실제 첫 문장들을 비교하여 승자들을 분석하고, 토큰 사용량을 최소화합니다.
"증거만 사용하라"는 문구는 중요합니다. AI 함유량 일반적인 트렌드 분석이 아닌 실제 게시물을 기반으로 한 패턴 분석.
11단계: HTML 요약본을 작성하고 Gmail을 통해 전송합니다.
최종 코드 노드 쌍은 다음과 같은 점수를 받은 게시물을 포함합니다. AI 출력 결과를 생성하고 이메일 본문을 구성합니다.
const posts = $('Limit').all().map(i => i.json);

const ai = ('BasicLLMChain').first().json.output;constrows=posts.map(p=>`<tr><td>{p.platform}</td><td>p.creator</td><td><ahref="{p.url}">(p.caption||'').slice(0,70)</a></td><td>{p.outlier}x</td><td>p.engagement??'–'%</td></tr>`).join('');consthtml=`<h2>TopOutliers</h2><tableborder="1"cellpadding="6">{rows}</table>

  <h2>Patterns</h2><ul>${ai.patterns.map(x => `<li>${x}</li>`).join('')}</ul>

  <h2>Ideas</h2><ul>${ai.ideas.map(x => `<li>${x}</li>`).join('')}</ul>`;

return [{ json: { html } }];const items = $input.all().map(i => i.json);

const base = it => it.views || it.likes || 0;

const groups = {};

for (const it of items) (groups[it.creator] ??= []).push(base(it));

const median = a => { const s = [...a].sort((x, y) => x - y), m = Math.floor(s.length / 2);

  return s.length % 2 ? s[m] : (s[m - 1] + s[m]) / 2; };

return items.map(it => {

  const med = median(groups[it.creator]) || 1;

  const eng = it.views ? ((it.likes || 0) + (it.comments || 0) + (it.shares || 0)) / it.views * 100 : null;

  return { json: { ...it, outlier: +(base(it) / med).toFixed(2),

    engagement: eng === null ? null : +eng.toFixed(2) } };

}).sort((a, b) => b.json.outlier - a.json.outlier);
다음으로 다음 설정으로 Gmail 노드를 추가하세요.
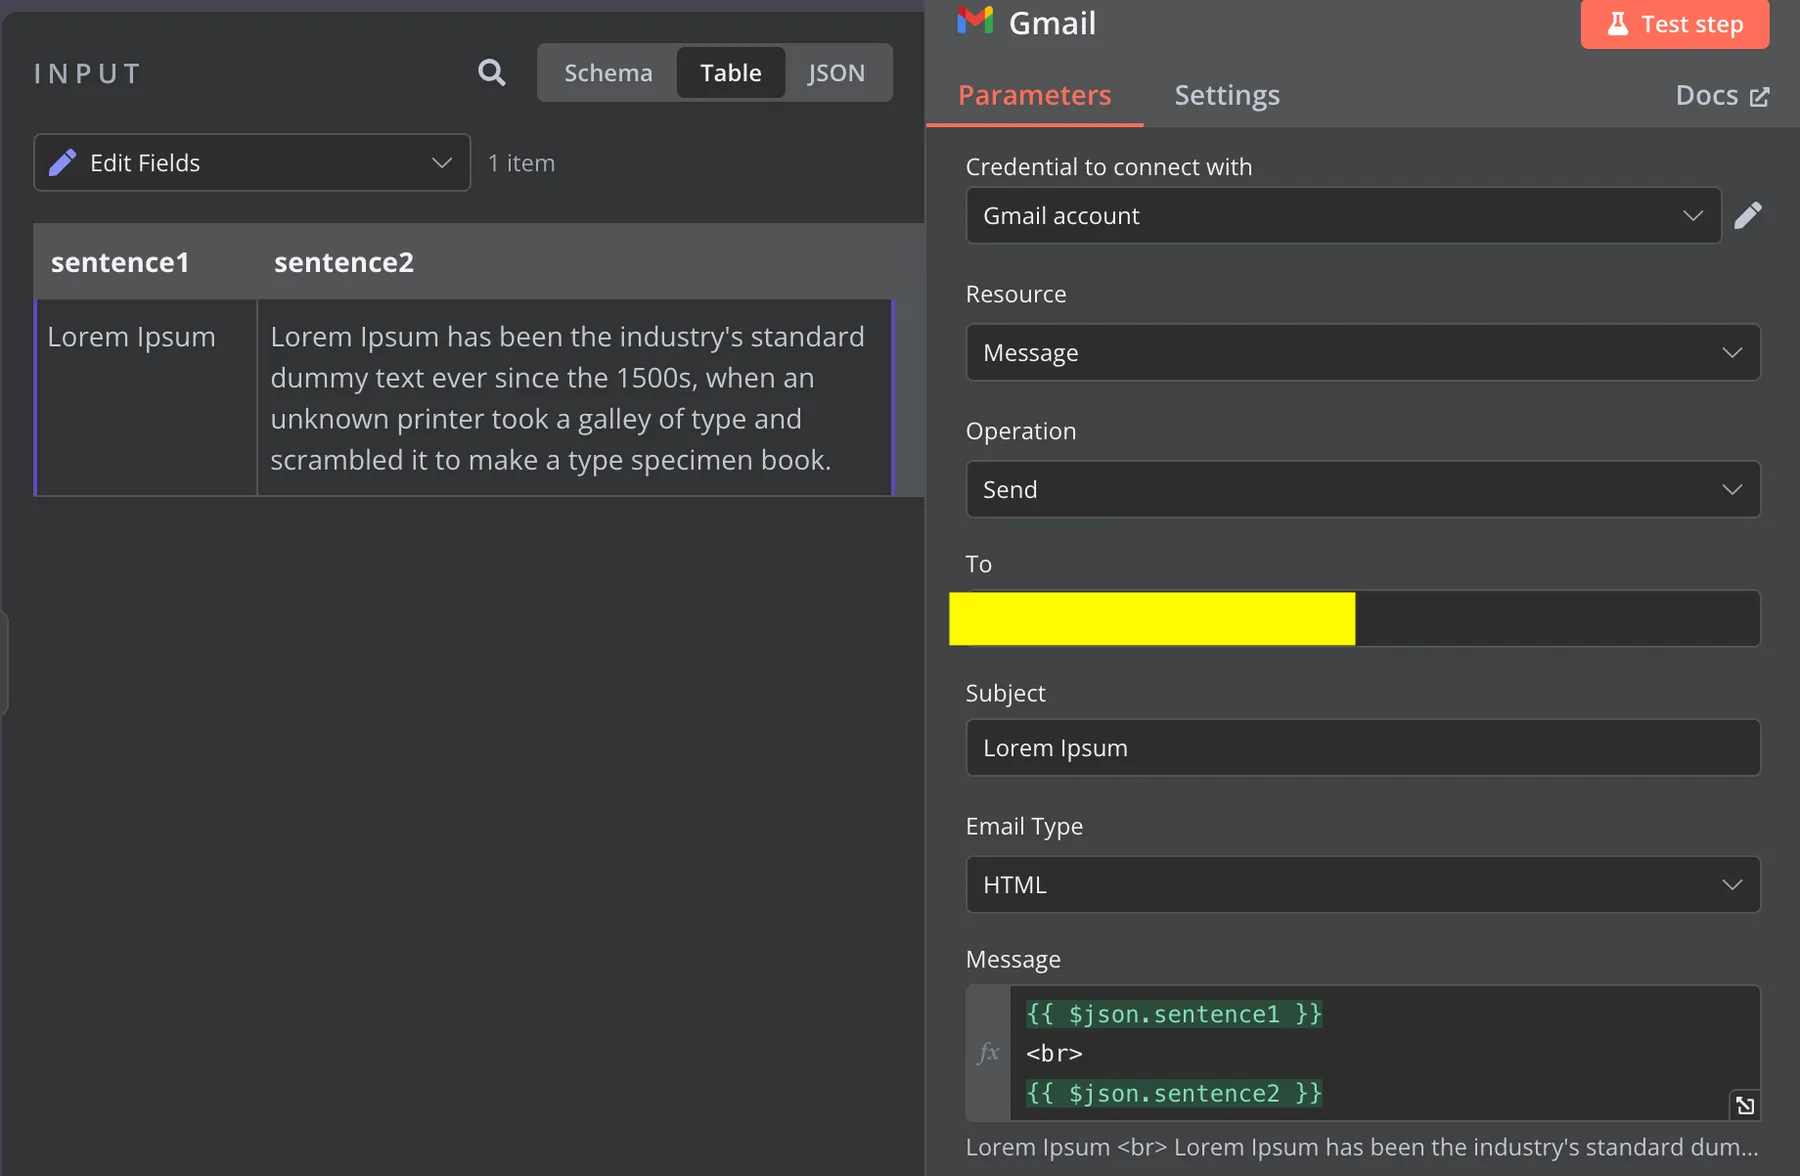
12단계: 게시물을 Google Sheets에 기록하고 게시합니다.
'중복 제거' 노드에서 '게시물 로그' 탭의 '행 추가' 또는 '행 업데이트'를 사용하여 Google Sheets 노드로 분기합니다. post_id를 기준으로 일치시켜 새로 고쳐진 통계가 이전 행을 덮어쓰도록 합니다.
정규화된 필드 이름이 이미 열과 일치하므로 매핑을 '자동으로 매핑' 으로 설정하세요 . 수동으로 한 번 실행하고 이메일을 확인한 후 워크플로를 게시하세요.
Apify 스케줄 및 이벤트 트리거를 활용한 확장
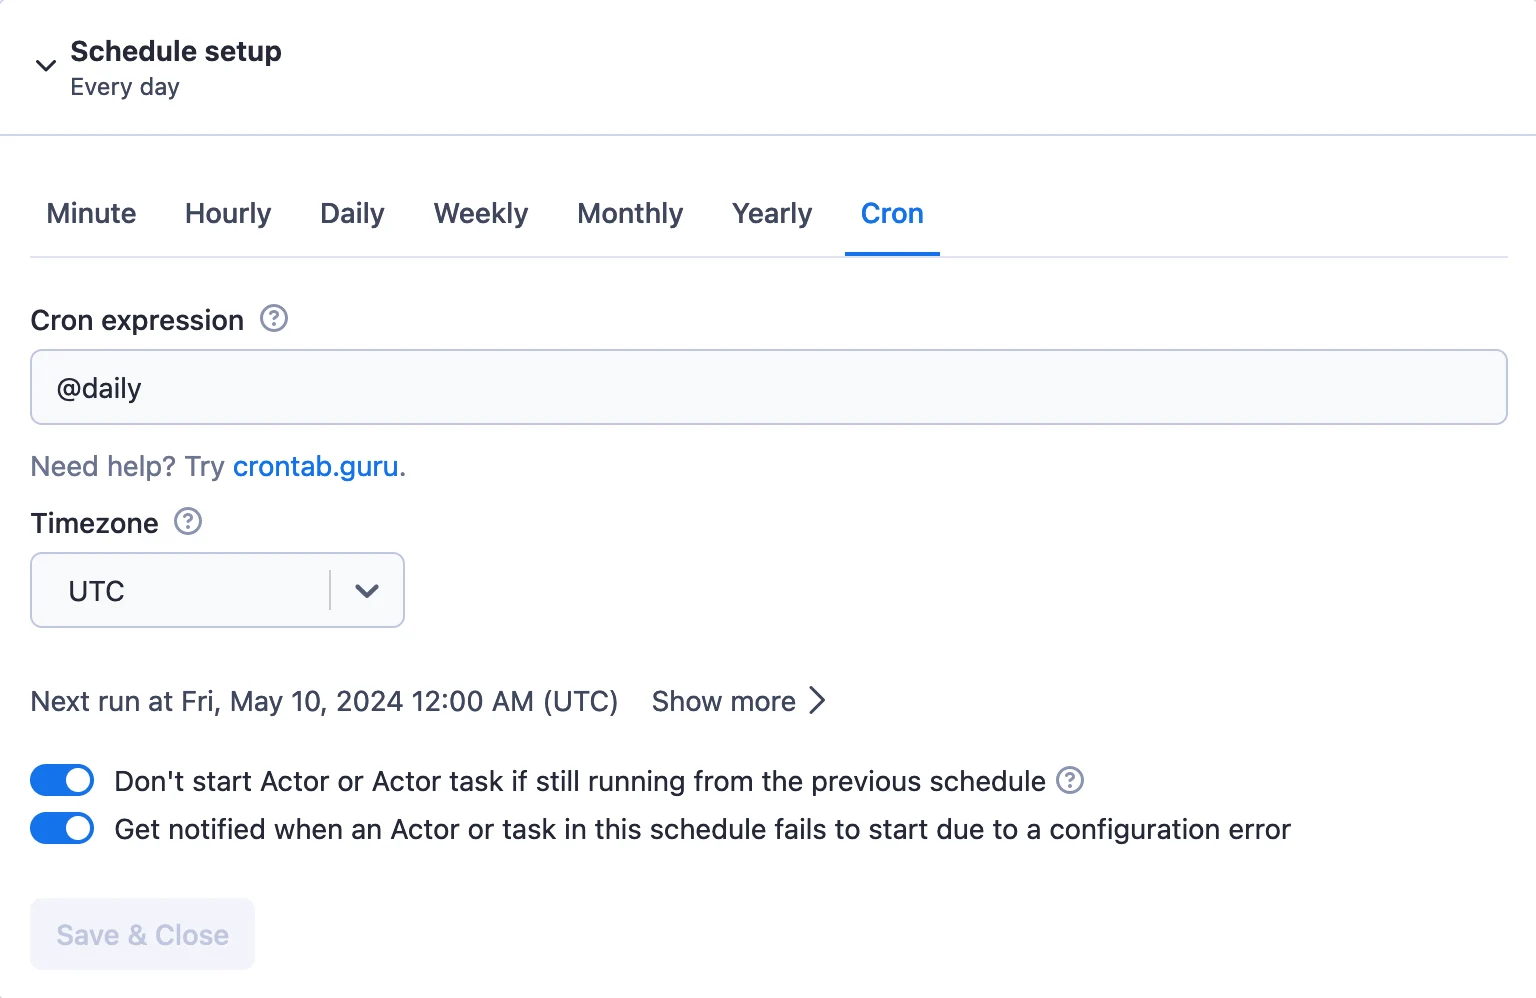
단일 예약 워크플로는 수십 명의 제작자 명단에 적합합니다. 하지만 그 이상으로 규모가 커지면, 장시간 소요되는 스크래핑 작업으로 인해 n8n 실행이 몇 분 동안 계속 열려 있게 되고, 하나의 느린 플랫폼 때문에 나머지 작업도 중단됩니다.
이번 수정 사항은 두 플랫폼에 걸쳐 작업을 분산합니다.
| 요인 | 단일 워크플로 | 워크플로 분할 |
|---|---|---|
| 설치 시간 | 빠른 | 조금 더 길다 |
| 긴 스크래핑 작업 | 실행 대기 시간 | n8n 내부 대기 없음 |
| 한 플랫폼이 실패합니다 | 소화 과정을 차단할 수 있습니다. | 다른 비행기들은 여전히 착륙합니다. |
| 자체 호스팅 요구 사항 | 추가 사항 없음 | 트리거에 대한 공개 WEBHOOK_URL |
새로운 Apify 스케줄은 처음에는 비활성화된 상태로 시작되므로 저장 후 활성화해야 합니다. Apify는 예약된 작업이 시작되지 않을 경우 이메일로 알려줍니다 .
매주 파이프라인을 건강하게 유지하기
진정한 적은 바로 '조용한 실패'입니다. 텅 빈 받은 편지함은 그저 한 주 동안 아무 일도 없었던 것처럼 보이므로, 처음부터 알림 기능을 구축해 두세요.
입력 제한만으로 사용량을 최소화합니다. 엄격한 날짜 범위, 프로필별 결과 제한, 필요한 경우에만 기록 제공 등을 통해 매주 수집되는 데이터 양을 줄였습니다.
크리에이터 콘텐츠 스크래핑이 진정한 한계에 부딪히는 지점
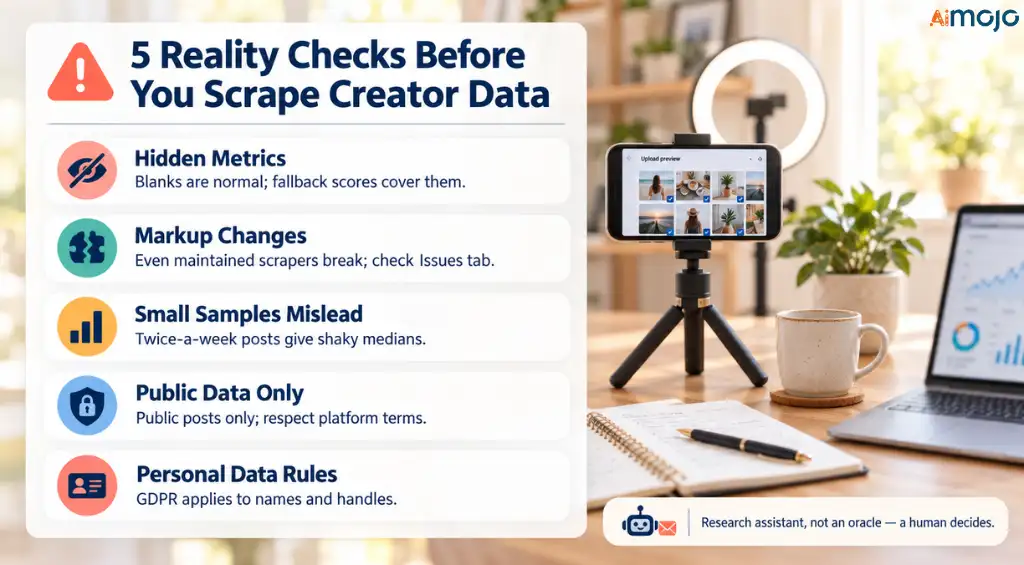
모든 자동 음성 안내는 이 부분을 건너뛰므로 여기에 명확하게 적어 놓겠습니다.
받은 편지함을 신탁이 아닌 연구 조수 처럼 대하세요 . 어떤 패턴을 촬영할지 결정하는 것은 여전히 사람입니다.
Apify 및 n8n Creator 관련 조사에 대한 빠른 답변
n8n은 코드 없이 Apify 액터를 트리거할 수 있습니까?
Apify 공식 노드는 액터 또는 작업을 실행하고, 결과를 기다린 후 데이터셋 항목을 반환하며, 이 모든 것은 n8n의 필드를 통해 구성됩니다.
이 워크플로는 어떤 크리에이터를 추적할 수 있나요?
공개 YouTube 채널, TikTok 프로필 또는 Instagram 계정. 더 많은 플랫폼을 추가하려면 다른 Apify Store 액터를 사용하세요.
Apify 노드는 다음과 같이 작동합니까? AI 에이전트 도구인가요?
추가 Apify 도구 아래에 AI 에이전트's 모델이 채팅에서 요청하는 대로 스크래핑을 실행할 수 있도록 하는 도구입니다.
맺음말
창작자 연구는 패턴을 가장 먼저 발견하는 사람에게 보상을 줍니다. 하지만 수동으로 스크롤하는 것은 엄청난 시간과 노력을 요구하며, 대부분의 팀은 몇 주 만에 조용히 포기합니다.
Apify와 n8n은 그 작업을 시스템에 맡깁니다.
스토어 액터는 최신 공개 게시물을 가져오고, 코드 노드는 각 작성자에 대해 점수를 매깁니다.'s 자신만의 기준선과 AI 층 숫자를 간략한 설명으로 변환합니다.
먼저 단일 예약 워크플로와 이미 팔로우하는 크리에이터 5명으로 시작하세요. 다이제스트가 유용하다고 판단되면 팔로우하는 크리에이터 목록을 늘리고 Apify Schedules를 사용하여 분할 설정으로 전환하세요.
3~4주 정도의 기록을 확인해 보세요.'s 이상치 점수가 더욱 선명해지고 월요일 이메일 수신함이 그 어떤 트렌드 보고서보다 더 유익해지기 시작할 때.
AiMojo 추천:


 보너스: $200를 받으세요AI 가입하시면 "마스터리 툴킷"을 무료로 드립니다!






