

ในขณะที่ยักษ์ใหญ่ด้านเทคโนโลยีต่อสู้เพื่อ AI ความเป็นผู้นำ อาลีบาบาได้เปิดฉากสร้างความฮือฮา: รุ่น Qwen3สิ่งเหล่านี้ไม่ใช่เพียงการอัปเกรดเท่านั้น แต่ยังเป็นการกำหนดนิยามใหม่ของศักยภาพของ AI โอเพนซอร์สอีกด้วย
Qwen3 เพิ่งเปิดตัวเมื่อสัปดาห์ที่แล้ว แปดแบบตั้งแต่เวอร์ชัน 600M น้ำหนักเบา (เหมาะสำหรับแล็ปท็อป) ไปจนถึง 235B MoE ยักษ์ใหญ่ ทำผลงานเหนือกว่าคู่แข่งชั้นนำอย่าง OpenAI และ Google แต่สิ่งที่ทำให้ Qwen3 แตกต่างก็คือ “การคิดแบบผสมผสาน”—สลับระหว่างการใช้เหตุผลเชิงลึกและการตอบสนองรวดเร็วอย่างชาญฉลาดขึ้นอยู่กับงาน
ที่สำคัญที่สุดคือมันเป็นโอเพนซอร์สอย่างสมบูรณ์นักพัฒนาทั่วโลกกำลังค้นพบว่า Qwen3 สามารถเทียบเท่าหรือเหนือกว่ารุ่นระดับพรีเมียมได้ ในราคาที่ถูกกว่ามาก
ครอบครัวรุ่น Qwen3: ขนาดสำหรับทุกความต้องการ
Qwen3 ถือเป็นก้าวกระโดดครั้งสำคัญใน AI การออกแบบโมเดลที่ให้ความยืดหยุ่นที่ไม่เคยมีมาก่อนทั้งกับโมเดลหนาแน่นและ ส่วนผสมของผู้เชี่ยวชาญ (MoE) แบบต่างๆ ที่นี่'s รายชื่อทั้งหมด:
| ชื่อรุ่น | พารามิเตอร์ทั้งหมด | พารามิเตอร์ที่ใช้งาน | ประเภทรุ่น | ความยาวบริบท |
|---|---|---|---|---|
| คิวเวน3-235B-A22B | 235 พันล้าน | 22 พันล้าน | โมเอะ | โทเค็น 128K |
| คิวเวน3-30B-A3B | 30 พันล้าน | 3 พันล้าน | โมเอะ | โทเค็น 128K |
| คิวเวน3-32B | 32 พันล้าน | N / A | หนาแน่น | โทเค็น 128K |
| คิวเวน3-14B | 14 พันล้าน | N / A | หนาแน่น | โทเค็น 128K |
| คิวเวน3-8B | 8 พันล้าน | N / A | หนาแน่น | โทเค็น 128K |
| คิวเวน3-4B | 4 พันล้าน | N / A | หนาแน่น | โทเค็น 32K |
| คิวเวน3-1.7B | 1.7 พันล้าน | N / A | หนาแน่น | โทเค็น 32K |
| คิวเวน3-0.6B | 0.6 พันล้าน | N / A | หนาแน่น | โทเค็น 32K |
สิ่งที่น่าสนใจที่สุดคือสถาปัตยกรรม MoE ช่วยให้ได้ประสิทธิภาพที่น่าประทับใจ ตัวอย่างเช่น โมเดล Qwen3-30B-A3B เปิดใช้งานพารามิเตอร์เพียง 3 พันล้านตัวในระหว่างการประมวลผล แต่มีประสิทธิภาพเหนือกว่าโมเดลที่มีพารามิเตอร์ 32 พันล้านตัวที่ทำงานเต็มรูปแบบ การออกแบบที่ชาญฉลาดนี้มอบประสิทธิภาพระดับสูงโดยไม่จำเป็นต้องใช้ทรัพยากรการคำนวณมากเกินไป
การวิจัยชี้ให้เห็นว่าโมเดล MoE เหล่านี้สามารถเทียบเท่ากับความสามารถของโมเดลขนาดใช้งานจริง 3-5 เท่า ทำให้คุ้มต้นทุนในการใช้งานเป็นอย่างยิ่ง
คุณสมบัติที่ทำให้ Qwen3 Models แตกต่าง
🔄 โหมดการคิดแบบไฮบริด: ครั้งแรกใน AI ออกแบบ
คิวเว่น3's นวัตกรรมที่ก้าวล้ำที่สุดคือแนวทางการคิดแบบสองทาง ซึ่งเป็นสิ่งที่กลุ่มโมเดลโอเพนซอร์สอื่น ๆ ไม่สามารถให้ความยืดหยุ่นได้เช่นนี้
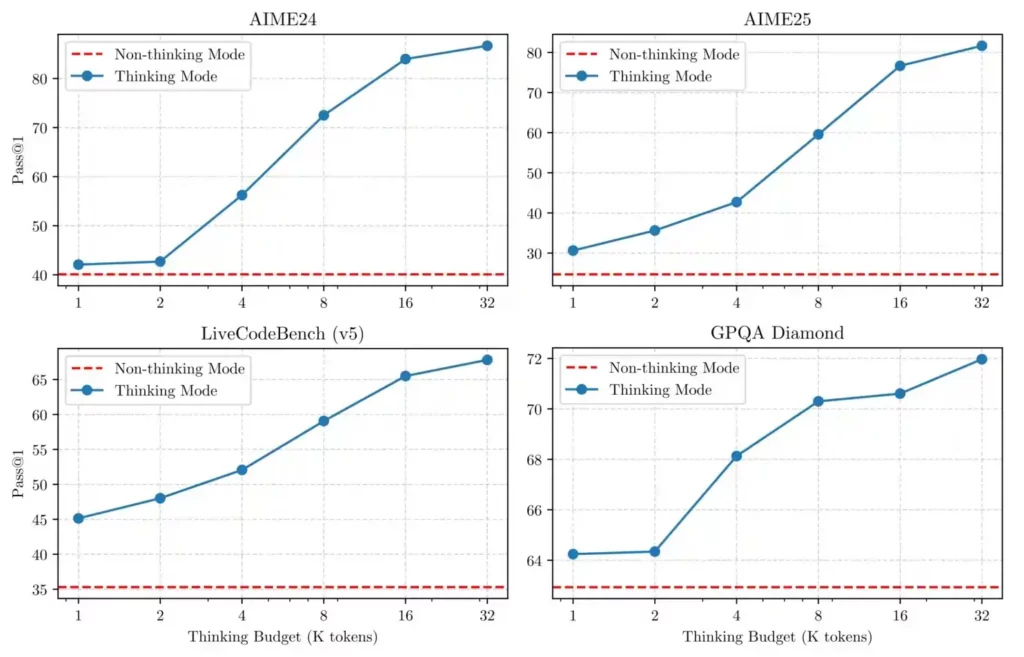
โหมดการคิด:เมื่อเผชิญกับปัญหาที่ซับซ้อนซึ่งต้องใช้เหตุผลหลายขั้นตอน (เช่น คณิตศาสตร์ การเขียนโปรแกรม หรือปริศนาตรรกะ) Qwen3 จะเปิดใช้งานโหมดการคิด ซึ่งช่วยให้สามารถคิดวิเคราะห์ทีละขั้นตอนผ่านงานที่ท้าทายก่อนที่จะให้คำตอบสุดท้าย
โหมดไม่ต้องคิด:สำหรับคำถามตรงไปตรงมาหรือการสนทนาทั่วไป Qwen3 จะเปลี่ยนไปใช้โหมดไม่ต้องคิด ทำให้ได้คำตอบที่รวดเร็วและกระชับ โดยไม่ต้องใช้การประมวลผลที่ไม่จำเป็น
ด้วย“งบประมาณการคิด” ที่ผู้ใช้สามารถควบคุมได้นักพัฒนาสามารถปรับแต่งปริมาณการใช้เหตุผลของ Qwen3 ได้อย่างละเอียด ส่งผลให้ประสิทธิภาพเพิ่มขึ้นสูงสุดถึง 65%ในงานต่างๆ เช่น คณิตศาสตร์ขั้นสูง
🌍 เชี่ยวชาญหลายภาษาใน 119 ภาษา
แม้ว่าโมเดลระดับสูงส่วนใหญ่จะเน้นที่ภาษาอังกฤษเป็นหลัก แต่ Qwen3 ได้รับการฝึกบนชุดข้อมูลที่ครอบคลุม 119 ภาษาและสำเนียง การสนับสนุนภาษาที่ครอบคลุมนี้ทำให้มีประโยชน์อย่างยิ่งสำหรับแอปพลิเคชันทั่วโลกและชุมชนภาษาที่ไม่ได้รับการบริการเพียงพอ
ผลการทดสอบภายในแสดงให้เห็นว่า Qwen3-235B-A22B ทำคะแนนความแม่นยำได้ 87% ในงานการให้เหตุผลที่ซับซ้อนในภาษาต่างๆ เช่น ภาษาอาหรับ ภาษาฮินดี และภาษาไทย ซึ่งใกล้เคียงกับความแม่นยำ 92% ในงานภาษาอังกฤษ ช่องว่างประสิทธิภาพที่แคบเช่นนี้ในภาษาต่างๆ ถือเป็นเรื่องที่ไม่เคยเกิดขึ้นมาก่อนในบรรดาโมเดลโอเพนซอร์ส
ความสามารถของตัวแทนและการรวมเครื่องมือ
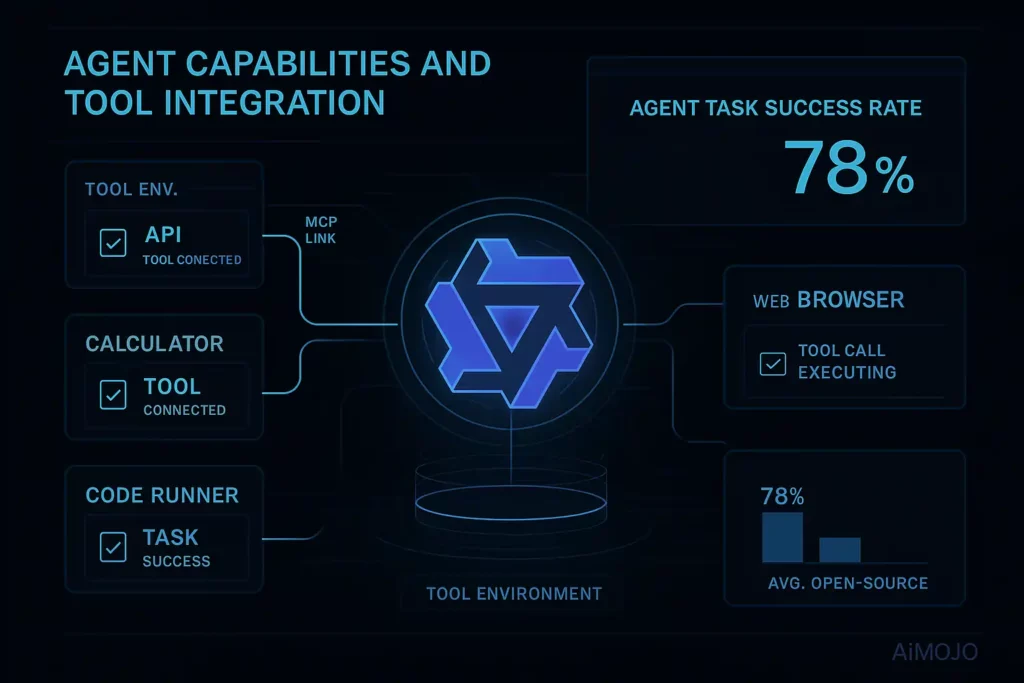
ทันสมัย AI แอปพลิเคชันต่างๆ จำเป็นต้องมีโมเดลเพื่อโต้ตอบกับเครื่องมือและระบบภายนอกมากขึ้น Qwen3 โดดเด่นในโดเมนนี้ด้วยการสนับสนุนที่ปรับปรุงสำหรับ โปรโตคอลบริบทแบบจำลอง (MCP) ปรับปรุงความสามารถในการเรียกเครื่องมือ และกรอบงาน Qwen-Agent เฉพาะสำหรับการสร้างตัวแทนอัจฉริยะ
การทดสอบโดยนักพัฒนาอิสระเผยให้เห็นว่าโมเดล Qwen3 มีอัตราความสำเร็จ 78% ในงานตัวแทนที่ซับซ้อนซึ่งต้องใช้การโต้ตอบกับเครื่องมือหลายรายการ ซึ่งเหนือกว่าคู่แข่งหลายรายในพื้นที่โอเพนซอร์สอย่างเห็นได้ชัด
สถาปัตยกรรมทางเทคนิคและวิธีการฝึกอบรม
คิวเว่น3's ความสามารถที่น่าประทับใจนั้นมาจากแนวทางการฝึกอบรมที่ซับซ้อนซึ่งครอบคลุมสามขั้นตอนที่แตกต่างกัน:
กระบวนการฝึกอบรมเบื้องต้น 3 ขั้นตอน
- ฐานความรู้การได้มา: การฝึกอบรมเบื้องต้นเกี่ยวกับโทเค็นประมาณ 36 ล้านล้านโทเค็นด้วยความยาวบริบท 4K สร้างความเข้าใจและความรู้ทางภาษาที่กว้างขวาง
- การปรับปรุงงานเฉพาะทาง: การฝึกอบรมที่เน้นหัวข้อ STEM ความท้าทายในการเขียนโค้ด และ การใช้เหตุผลที่ซับซ้อน ภารกิจเพื่อพัฒนาความสามารถในการแก้ปัญหาขั้นสูง
- การขยายบริบทยาว: การฝึกอบรมขั้นสุดท้ายด้วยข้อมูลบริบทที่ขยายเพื่อให้สามารถจัดการเอกสารได้สูงสุดถึง 32 โทเค็น (สำหรับรุ่นที่เล็กกว่า) หรือ 128 โทเค็น (สำหรับรุ่นที่ใหญ่กว่า)
การเพิ่มประสิทธิภาพหลังการฝึกอบรม
หลังจากการฝึกอบรมเบื้องต้น Qwen3 จะต้องผ่านกระบวนการหลังการฝึกอบรม XNUMX ขั้นตอน:

- การเริ่มต้นแบบเย็นของห่วงโซ่แห่งความคิด: ฝึกอบรมด้วยตัวอย่างการใช้เหตุผลที่ชัดเจนเพื่อสร้างรูปแบบการคิดเชิงตรรกะขั้นพื้นฐาน
- การเรียนรู้การเสริมแรงโดยอาศัยการใช้เหตุผล: การปรับปรุงโมเดล's ความสามารถในการใช้เหตุผลอย่างสอดคล้องกันในงานที่หลากหลาย
- โหมดความคิดแบบผสมผสาน: การบูรณาการความสามารถในการสลับระหว่างวิธีคิดและไม่คิด
- การเรียนรู้การเสริมแรงทั่วไป: การปรับแต่งขั้นสุดท้ายขึ้นอยู่กับความชอบของมนุษย์และเทคนิคการจัดตำแหน่ง
วิธีการดังกล่าวจะอธิบายว่าเหตุใดโมเดล Qwen3-4B แบบกะทัดรัดจึงเอาชนะคู่แข่งที่ใหญ่กว่าได้หลายรุ่น โดยวิธีการดังกล่าวจะได้รับประโยชน์จากความรู้ที่กลั่นกรองมาจากโมเดลขนาดใหญ่ในตระกูลเดียวกัน
เกณฑ์มาตรฐานประสิทธิภาพ: Qwen3 มีประสิทธิภาพอย่างไร
ผลการประเมินประสิทธิภาพล่าสุดทำให้หลายคนประหลาดใจ AI นักวิจัยพบว่าโมเดล Qwen3 มีประสิทธิภาพดีอย่างโดดเด่นเมื่อเทียบกับคู่แข่งที่ใหญ่กว่ามาก
การเปรียบเทียบรุ่นระดับสูงสุด
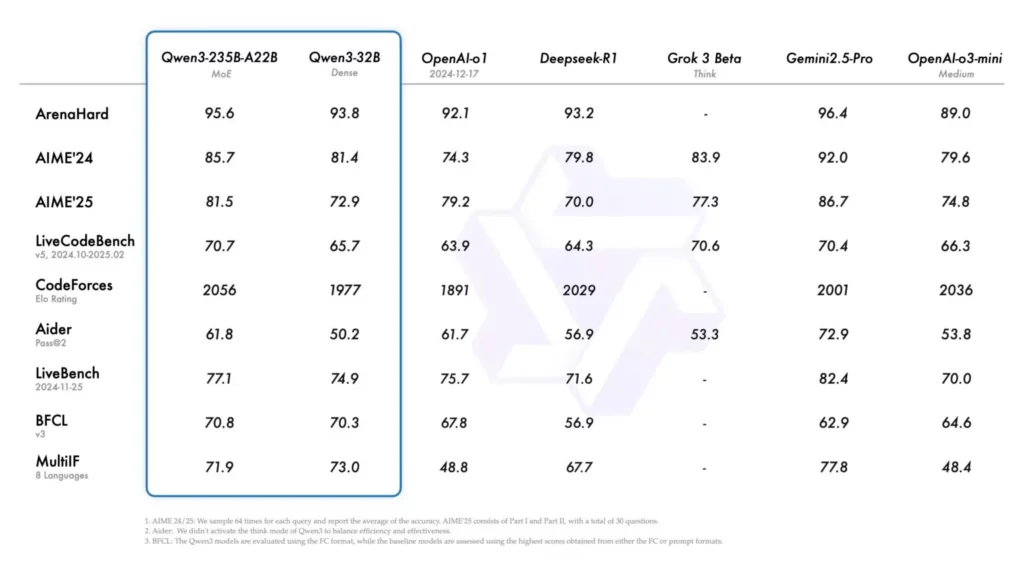
รุ่นเรือธง Qwen3-235B-A22B แสดงผลลัพธ์ที่น่าทึ่งเมื่อเปรียบเทียบกับรุ่นผู้นำในอุตสาหกรรม:
- ประสิทธิภาพการเขียนโค้ด: เป็นผู้นำในการทดสอบ CodeForces Elo Rating, BFCL และ LiveCodeBench v5 เหนือกว่าแม้แต่ DeepSeek-R1 และ OpenAI's o1.
- คณิตศาสตร์: มีคะแนนต่ำกว่า Gemini 3.2 Pro เพียง 2.5% ในเกณฑ์มาตรฐาน ArenaHard และ AIME แต่ทำได้ด้วยพารามิเตอร์ที่ทำงานน้อยกว่าอย่างเห็นได้ชัด
- เหตุผลโดยทั่วไป: ดำเนินการภายใน 5% ของ GPT-4o ในการวัดประสิทธิภาพการใช้เหตุผลที่ซับซ้อนในขณะที่เป็นโอเพ่นซอร์สอย่างเต็มรูปแบบ
ประสิทธิภาพตามขนาดและประสิทธิภาพ
สิ่งที่น่าประทับใจที่สุดก็คือรุ่น Qwen3 ที่เล็กลงเมื่อเปรียบเทียบกับรุ่นก่อนหน้า:

- Qwen3-30B-A3B (ที่มีพารามิเตอร์ที่ทำงานอยู่เพียง 3 พันล้านพารามิเตอร์) ทำงานได้ดีกว่ารุ่น QwQ-32B ก่อนหน้า (ที่มีพารามิเตอร์ที่ทำงานอยู่ทั้งหมด 32B)
- Qwen3-4B ให้ผลลัพธ์ที่เทียบเคียงได้กับโมเดลที่มีขนาดใหญ่กว่า 5 เท่าจากเมื่อปีก่อน
จากการทดสอบเปรียบเทียบโดยตรงกับDeepSeek-R1พบว่า Qwen3 ให้ผลลัพธ์ที่เหนือกว่าในงานเข้ารหัสและการจัดโครงสร้างข้อความ ในขณะที่ DeepSeek-R1 ยังคงได้เปรียบเล็กน้อยในปัญหาทางคณิตศาสตร์ที่ซับซ้อน
ประสิทธิภาพในโลกแห่งความเป็นจริง: เหนือกว่ามาตรฐาน
เกณฑ์มาตรฐานเชิงปริมาณบอกเล่าเรื่องราวเพียงบางส่วนเท่านั้น ที่นี่'s Qwen3 มีประสิทธิภาพอย่างไรในงานจริงในทางปฏิบัติ:
Qwen3-30B-A3B จัดการกับปัญหาฟิสิกส์ขั้นสูง เช่น ทฤษฎีสัมพันธภาพและการขยายเวลา ด้วยวิธีแก้ปัญหาที่มีโครงสร้างและแม่นยำ โมเดล 235B-A22B เพิ่มความลึก ตรวจจับความเข้าใจผิด และแนะนำวิธีทางเลือก แสดงให้เห็นถึงการใช้เหตุผลเชิงวิเคราะห์ที่แข็งแกร่ง


วิธีการเข้าถึงและใช้งาน Qwen3

โมเดล Qwen3 ทั้งหมดเป็นแบบเปิดภายใต้ใบอนุญาต Apache 2.0 ทำให้เข้าถึงได้ทั้งสำหรับการใช้งานส่วนตัวและเชิงพาณิชย์ ต่อไปนี้เป็นวิธีหลักในการเข้าถึงโมเดลเหล่านี้:
การเข้าถึงออนไลน์
- คเวนแชท: วิธีที่ง่ายที่สุดในการทดลองใช้รุ่น Qwen3 ผ่านทาง Alibaba's เว็บอินเตอร์เฟส
- กอดหน้า: มีโมเดลทั้งหมดให้เลือกบน Hugging Face เพื่อการใช้งานโดยตรงหรือปรับแต่งอย่างละเอียด
- โมเดลสโคป: ให้ตัวเลือกการปรับใช้และเอกสารเพิ่มเติม
- Kaggle: เสนอสภาพแวดล้อมโน้ตบุ๊กสำหรับการทดลองกับโมเดลต่างๆ
การปรับใช้ในท้องถิ่น
สำหรับการใช้งานในพื้นที่ เฟรมเวิร์กหลายตัวรองรับ Qwen3:
- โอลลามาและ LMStudio: เครื่องมือที่ใช้งานง่ายสำหรับการรันโมเดลในเครื่อง
- ลามะ.cpp: การใช้งาน C++ อย่างมีประสิทธิภาพเพื่อประสิทธิภาพการทำงานที่เหมาะสมที่สุด
- เอ็มแอลเอ็กซ์: การปรับใช้ที่ปรับให้เหมาะกับ Apple Silicon
- หม้อแปลงไฟฟ้า: ตัวเลือกการปรับใช้แบบพิเศษสำหรับกรณีการใช้งานที่เฉพาะเจาะจง
การปรับใช้เซิร์ฟเวอร์
สำหรับสภาพแวดล้อมการผลิต Qwen3 ทำงานร่วมกับ:
- สแลง: ปรับให้เหมาะสมสำหรับการปรับใช้เซิร์ฟเวอร์ที่มีปริมาณงานสูง
- วีแอลแอลเอ็ม: มอบการให้บริการที่มีประสิทธิภาพด้วยฟีเจอร์ขั้นสูงเช่น การแบ่งชุดอย่างต่อเนื่อง
แอปพลิเคชันและกรณีการใช้งาน
คิวเว่น3's ความคล่องตัวทำให้เหมาะกับการใช้งานต่างๆ มากมาย:
- การสร้างเนื้อหา: การสร้างบทความ สำเนาการตลาดและการเขียนเชิงสร้างสรรค์
- การพัฒนาซอฟต์แวร์: การสร้างรหัส การดีบัก และการจัดทำเอกสาร
- การศึกษา: การสร้างสรรค์สื่อการเรียนรู้และการตอบคำถามที่ซับซ้อน
- งานวิจัย: ช่วยเหลือในการทบทวนวรรณกรรมและการสร้างสมมติฐาน
- สนับสนุนลูกค้า: ขับเคลื่อนแชทบอทอัจฉริยะด้วยความสามารถในการใช้เหตุผลที่แข็งแกร่ง
- การวิเคราะห์ข้อมูล: การตีความข้อมูลที่ซับซ้อนและสร้างข้อมูลเชิงลึก
- การดึงข้อมูล-การสร้างเสริม (RAG): การสร้างระบบความรู้ที่ซับซ้อนโดยใช้ Qwen3's หน้าต่างบริบทและความสามารถในการใช้เหตุผล
ข้อจำกัดในปัจจุบันและการพัฒนาในอนาคต
แม้ว่า Qwen3 จะมีศักยภาพที่น่าประทับใจ แต่ก็มีข้อจำกัดบางประการ:
- บางครั้งโหมดการคิดอาจมีรายละเอียดมากเกินไปสำหรับงานง่ายๆ
- ถึงแม้จะมีหลายภาษา แต่ประสิทธิภาพก็ยังแตกต่างกันบ้างในแต่ละภาษา
- โมเดลขนาดใหญ่ที่สุดต้องใช้ทรัพยากรจำนวนมาก แม้ว่า MoE จะมีประสิทธิภาพเพิ่มขึ้นก็ตาม
มองไปข้างหน้า อาลีบาบา's แผนงานการพัฒนาชี้ให้เห็นความเป็นไปได้ที่น่าสนใจหลายประการ:
- การบูรณาการเพิ่มเติมกับความสามารถ Qwen3-VL (ภาษาภาพ)
- เปิดตัวรุ่น Qwen3-Audio เฉพาะทางสำหรับ การประมวลผลคำพูด.
- เวอร์ชัน Qwen3-Math ที่ได้รับการปรับปรุงให้เหมาะสมสำหรับการใช้งานด้านเทคนิคและวิทยาศาสตร์
บทสรุป: Qwen3's วางในไฟล์ AI ภูมิประเทศ
Qwen3 เป็นมากกว่าแค่อีกหนึ่ง AI แบบจำลองลดลง—มันเป็น การก้าวกระโดดทางยุทธศาสตร์ไปข้างหน้า ใน AI โอเพนซอร์ส
ด้วยนวัตกรรมต่างๆ เช่น การให้เหตุผลแบบไฮบริด สถาปัตยกรรม MoE ที่มีประสิทธิภาพ และการครอบคลุมภาษาทั่วโลก ทำให้ระบบนี้ถูกสร้างขึ้นเพื่อรองรับการขยายขนาดในโลกแห่งความเป็นจริง
สำหรับนักพัฒนา นักวิจัยและธุรกิจที่ต้องการความสามารถที่ล้ำสมัย โดยไม่มีการล็อคอินผู้ขายQwen3 เสนอ เปิดกว้าง ทรงพลัง และใช้งานได้จริง ทางเลือก—ตอกย้ำสถานะของตนเป็นหนึ่งในปี 2025's สำคัญที่สุด AI การพัฒนา


 โบนัส: รับ $200 ของเรา”AI Mastery Toolkit” ฟรีเมื่อคุณสมัคร!







