

クリエイター調査は、いつの間にか午後の時間を丸ごと奪ってしまう。TikTok、YouTube、Instagramをスクロールして再生回数をシートに書き写し、そして本当に重要な投稿を一つ見失ってしまう。
毎週届くクリエイター向けリサーチメールは、そのルーティンを台無しにする。
Apify アクター 公開されているクリエイターの投稿をスクレイピングし、 n8n自動化ワークフロー すべての投稿に点数を付け、異常値をフラグ付けし、 AI フックのパターンを見つけるためのモデル。
すると、毎週同じ曜日に、整理されたダイジェスト版がGmailに届き、朝一番のコーヒーを飲む前に読めるようになっています。
以下は、アクター入力からノードごとに構築された完全なビルドです。 エンゲージメントスコアリングロジック 〜へ AI 内容概要 エラーアラート機能も搭載。理論は一切不要。ただ、真似できるシステムを提供するだけです。
アイモジョ's クイック評決
毎週あなたの受信トレイに届くもの
ノードを操作する前に、出力を固定してください。研究用受信トレイは、すべてのメールが同じ質問に同じ順序で回答している場合にのみ機能します。
| 要約セクション | 表示される内容 | ソースノード |
|---|---|---|
| トップアウトライヤー | 最も閲覧数の多い投稿と作成者の比較's 通常の中央値 | スコアリングコードノード |
| エンゲージメントリーダー | 閲覧数あたりのいいね、コメント、シェア数が最も多い投稿 | スコアリングコードノード |
| パターンノート | 受賞記事に共通する繰り返し登場するフック、フォーマット、トピック | 基本的なLLMチェーン |
| コンテンツのアイデア | 今週、あなたのチームが試せる3つのアイデア | 基本的なLLMチェーン |
| 生ログリンク | 後でフィルタリングできるように、スクレイピングしたすべての投稿を含むGoogleスプレッドシート。 | Google スプレッドシート ノード |
代理店はこれをクライアントへのブリーフィングに利用し、ブランドチームはインフルエンサーとの提携先を探すために利用し、個人クリエイターはアプリを一切開かずに競合他社を追跡するために利用している。
データフローはシンプルです。
Creator DataにApify Actorsを選択する
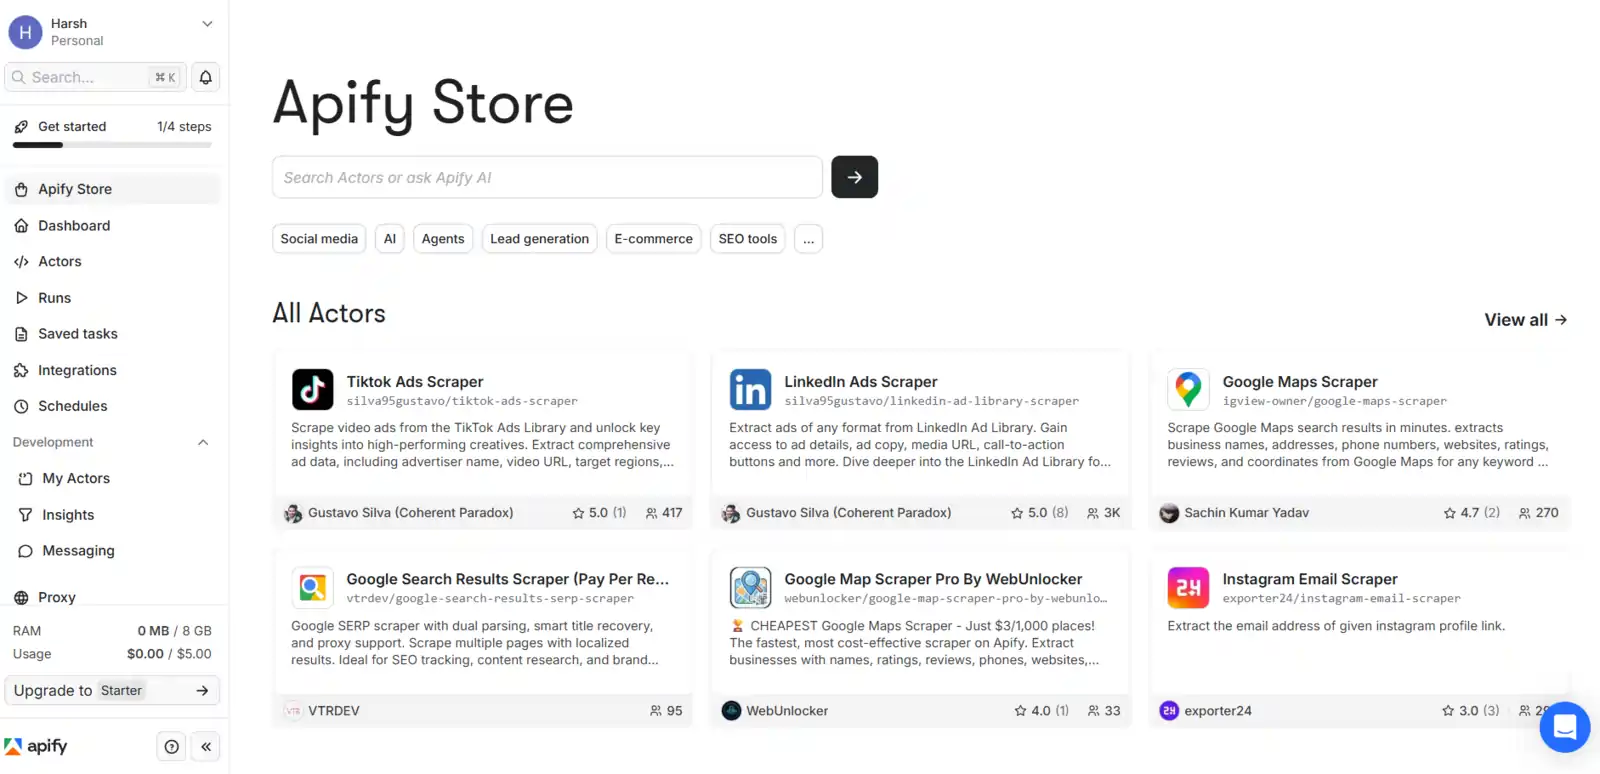
Apify Storeには、Actorと呼ばれるすぐに使えるスクレイパーが用意されています。そのうち3つは、クリエイターのリサーチニーズのほとんどをカバーしており、それぞれに日付フィルターが搭載されているため、週ごとのデータ取得を効率的に行うことができます。
| 俳優 | 主要入力フィールド | 保持する価値のある出力フィールド |
|---|---|---|
| YouTubeスクレイパーストリーマー/YouTubeスクレイパー | startUrls、maxResults、maxResultsShorts、maxResultStreams、sortVideosBy、oldestPostDate | タイトル、URL、日付、再生回数、いいね数、コメント数、チャンネル名、登録者数 |
| TikTokスクレーパー時計仕掛け/ティックトックスクレイパー | プロファイル、ページあたりの結果数、プロファイルの並べ替え、固定投稿の除外、最古の投稿日付(統一) | text、webVideoUrl、createTimeISO、playCount、diggCount、commentCount、shareCount、collectCount、authorMeta.fans |
| Instagramスクレイパーapify/instagram-scraper | directUrls、resultsType、resultsLimit、onlyPostsNewerThan | キャプション、URL、ショートコード、タイムスタンプ、いいね数、コメント数、動画再生回数、所有者ユーザー名 |
ここではいくつかの詳細が重要です。YouTubeスクレイパー's 日付範囲はチャンネルURLにのみ適用され、任意のタイプの制限を0に設定すると、その形式は完全にスキップされます。
TikTok ScraperのprofileSortingは、最新、人気、または最古の順で並べ替えることができます。日付フィルターは、Actorページで有料フィルターとしてマークされているため、有効にする前に確認してください。
Instagramのフォロワー数とプロフィール情報が必要ですか?ユーザー名の配列を指定してInstagram Profile Scraper(apify/instagram-profile-scraper)を追加してください。フォロワー数、プロフィール情報、認証済みアカウント、最新投稿が返されます。
文字起こしはオプションです。YouTubeスクレイパー's 文字起こしと字幕、そしてTikTokスクレイパー's downloadSubtitlesOptions は音声フックを引き出し、 AI パターンノートははるかに鮮明だ。
n8n 用の公式 Apify ノードの内部
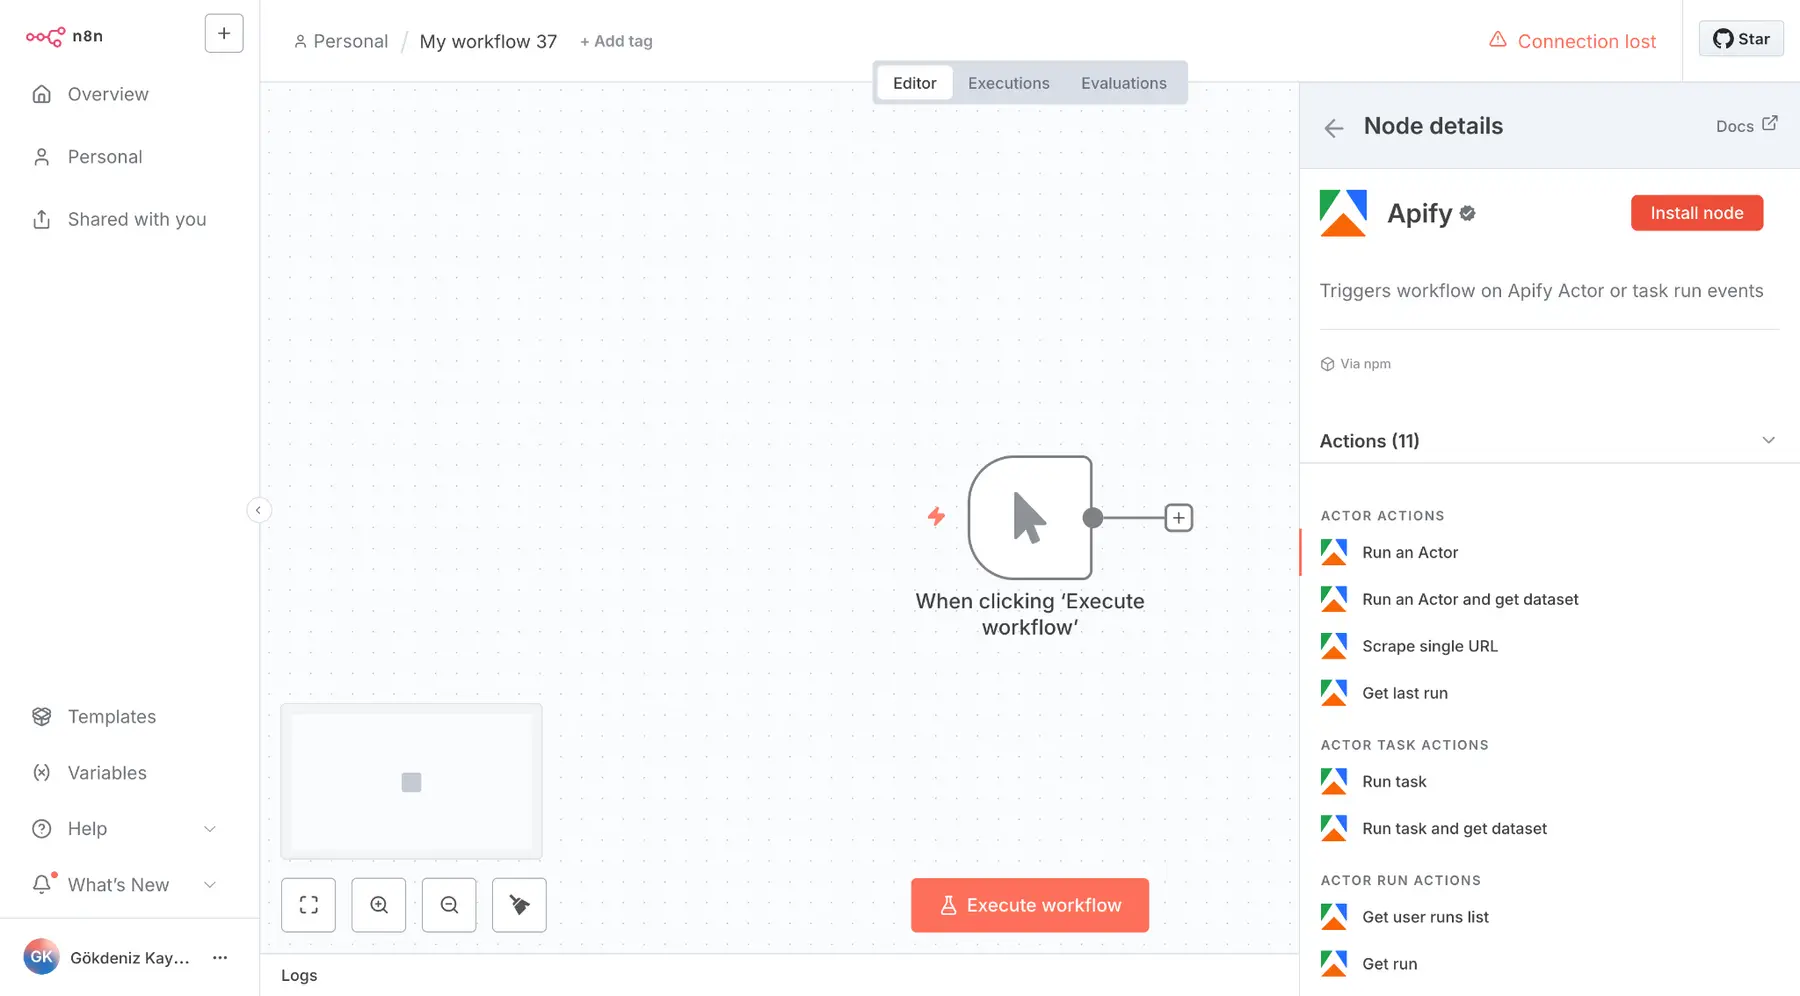
Apifyには、検証済みのコミュニティノード(@apify/n8n-nodes-apify)が同梱されています。n8n Cloudでは、ノードパネルで「Apify」を検索し、インストールしてください。ただし、管理パネルで検証済みのコミュニティノードが許可されていることが前提となります。
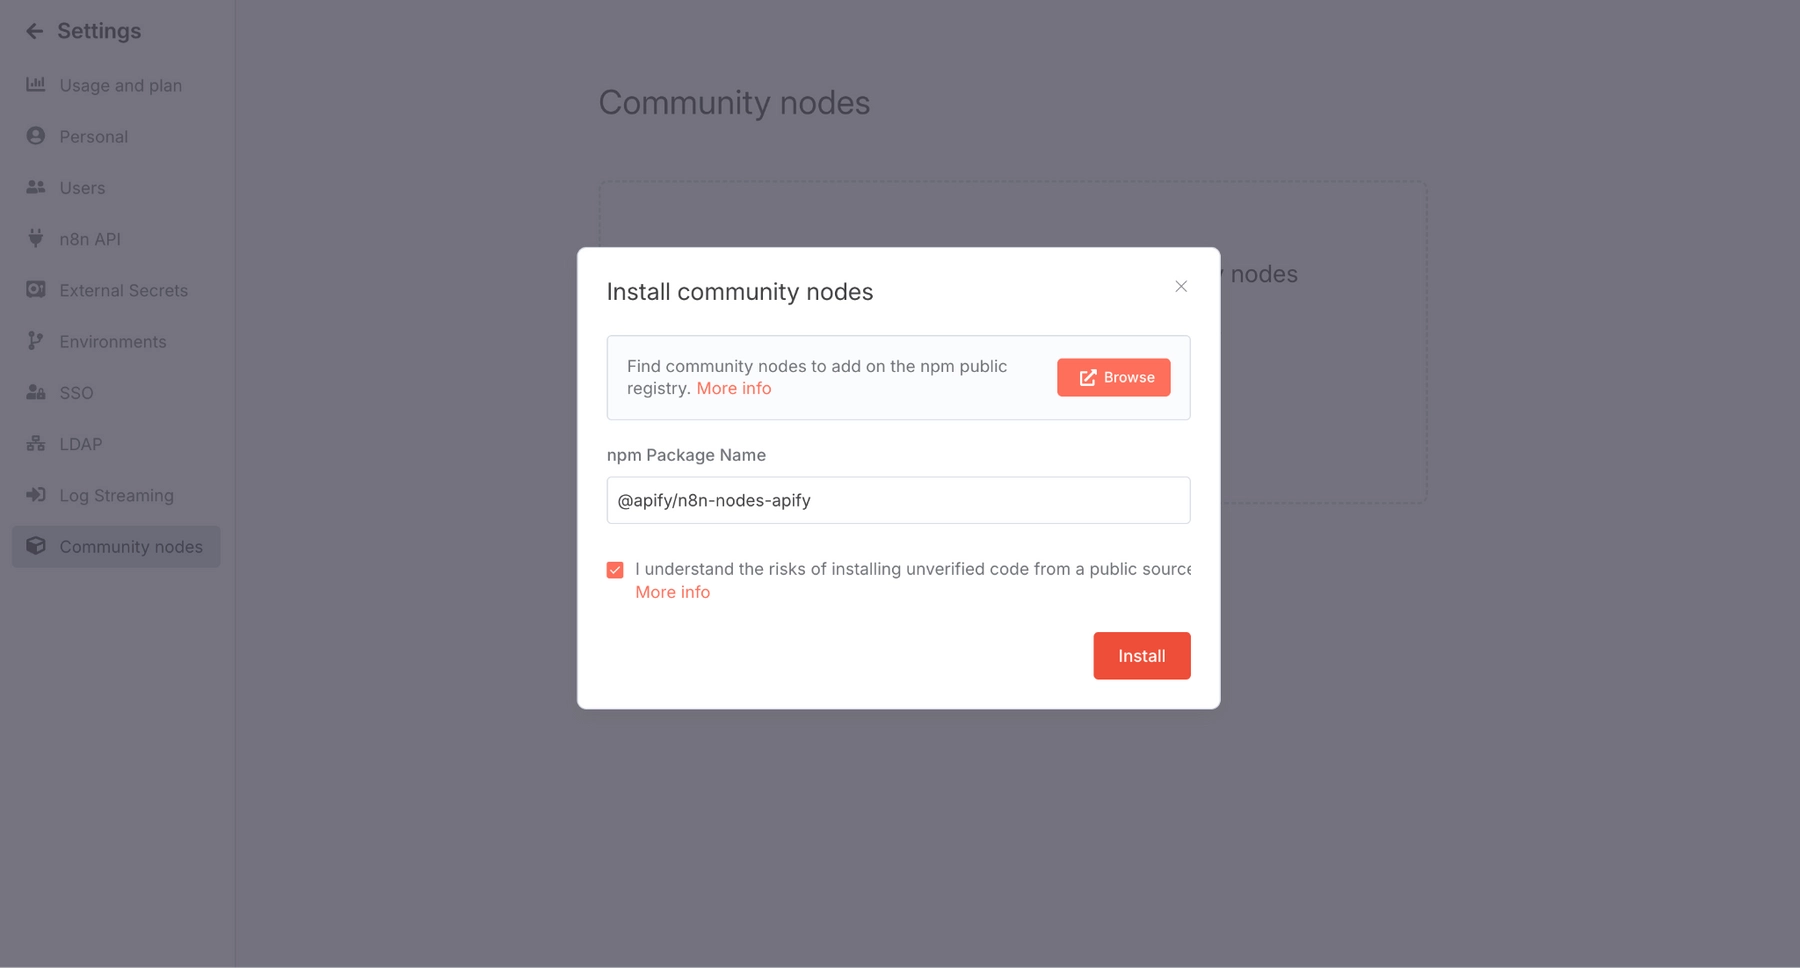
セルフホスト型のn8nでは、「設定」>「コミュニティノード」を開き、パッケージ名を貼り付けてインストールしてください。ノードにはn8n 1.57.0以降が必要です。
| 事業紹介 | 運用可能 | このビルドで使用する |
|---|---|---|
| 役者 | アクターの実行、アクターの実行とデータセットの取得、Webフェッチ、最新の実行結果の取得 | メインスクレイピングステップ |
| アクターのタスク | タスクを実行し、タスクを実行してそのデータセットを取得します。 | Apifyに保存されたクリーンな入力 |
| 俳優の処刑 | 1つ取得、複数取得、中止 | デバッグとクリーンアップ |
| Storage | データセット項目を取得し、キーバリューストアレコードを取得します。 | defaultDatasetId で結果を取得する |
| トリガー | 新しい Apify イベント発生時 (成功、失敗、中止、タイムアウト、その他) | 大規模ロスター向けの分割版受信箱 |
認証には2つの方法があります。Apify API認証情報では、ApifyコンソールからAPIトークンを取得します。一方、Apify OAuth2 APIは、 n8n Cloudでのみワンクリックで接続できます。
アクター操作では、カスタム入力(JSON)、タイムアウト(秒単位)、メモリ(メガバイト単位)、ビルドタグ、および完了待ちも利用できます。
カスタム入力欄を空欄にすると、アクターは保存済みのデフォルト入力を使用します。
毎週のクリエイターリサーチワークフローのステップバイステップガイド
ステップ1:Googleスプレッドシートでクリエイター名簿を作成する
「クリエイター名簿」という名前のシートを作成し、以下の列を追加してください。チームメンバーは、n8nを開かなくても、シートから直接クリエイターを追加したり、一時停止したりできます。
「投稿ログ」というタブをもう一つ追加してください。評価された投稿はすべてそこに記録され、長期的な基準値を把握するための履歴として役立ちます。
ステップ2:各スクレイパーをApifyアクタータスクとして保存する
Apify Consoleで各アクターを開き、適切な制限を設定して、[新しいタスクとして保存]をクリックします。
Apify Actorタスクは入力値に加えてタイムアウトとメモリを保存するため、n8n側は整理された状態を保つことができます。
ダウンロードの切り替えはすべてオフにしてください。動画ファイル、カバー画像、アバターは、調査に役立たないだけでファイルサイズを増やすだけです。
ステップ3:Apify、Googleスプレッドシート、Gmailの認証情報を接続します
Apifyノードをインストールし、n8nにApify API、Google Sheets OAuth2、Gmail OAuth2の3つの認証情報を追加します。開発を進める前に、それぞれをテストしてください。
ワークフローの途中で認証情報が破損すると、スクレイピング作業が無駄になるため、このチェックは有効です。
ステップ4:n8nスケジュールトリガーの設定
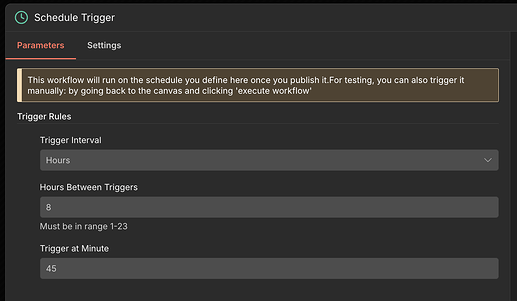
以下の設定でスケジュールトリガーノードを配置します。
| かどうかld | 値 |
|---|---|
| トリガー間隔 | ウィークス |
| トリガー間の週数 | 1 |
| 平日にトリガーする | 月曜日 |
| 時刻にトリガー | 7am |
| 分にトリガー | 0 |
ワークフロー設定でタイムゾーンを設定してください。設定しない場合、n8nはインスタンスのタイムゾーンにフォールバックし、セルフホスト型インストールではデフォルトでAmerica/New_Yorkが使用されます。
cron をご希望の場合は、カスタム (Cron)を0 7 * * 1 で使用してください。いずれの場合も、n8n スケジュール トリガーはワークフローが保存され、公開された後にのみ実行されます。
ステップ5:コードノードを使用してプラットフォーム入力を作成する
Google Sheetsノード(Get Row(s)、タブ:Creator Roster)を追加し、次にCodeノードを追加します。このCodeノードは、プラットフォームごとにロスターの行を1つの入力オブジェクトに変換します。
const rows = $input.all().map(i => i.json).filter(r => r.active === 'yes');

const since = $now.minus({ days: 7 }).toFormat('yyyy-MM-dd');

const pick = p => rows.filter(r => r.platform === p);

return [{ json: {

  youtube: {

    startUrls: pick('youtube').map(r => ({ url: r.profile_url })),

    maxResults: 15, maxResultsShorts: 15, maxResultStreams: 0,

    sortVideosBy: 'NEWEST', oldestPostDate: since

  },

  tiktok: {

    profiles: pick('tiktok').map(r => r.handle),

    resultsPerPage: 20, profileSorting: 'latest',

    excludePinnedPosts: true, oldestPostDateUnified: since

  },

  instagram: {

    directUrls: pick('instagram').map(r => r.profile_url),

    resultsType: 'posts', resultsLimit: 20, onlyPostsNewerThan: since

  }

}}];
$nowはn8nです's Luxonの日付機能が組み込まれているため、7日間の期間が毎週自動的に繰り越されます。手動で日付を編集する必要は一切ありません。
ステップ6:3つのApifyアクターを並列実行する
Code ノードを 3 つの Apify ノードに分岐します。タスクを実行してデータセット項目を返す操作を持つ Actor Tasks リソースを選択します。
カスタム入力では、一致するオブジェクトを式として渡します。
{{ JSON.stringify($json.youtube) }}$json.tiktok と $json.instagram についても同様の手順を繰り返してください。カスタム入力は保存済みのタスク入力を上書きしますが、タイムアウトとメモリは引き続きタスクから取得されます。
2 つの別々のノードをご希望ですか?Actor を「完了まで待機」をオンにして実行し、次に{{ $json.defaultDatasetId }} を使用してデータセット項目を取得します。どちらのパスでも同じデータが返されます。
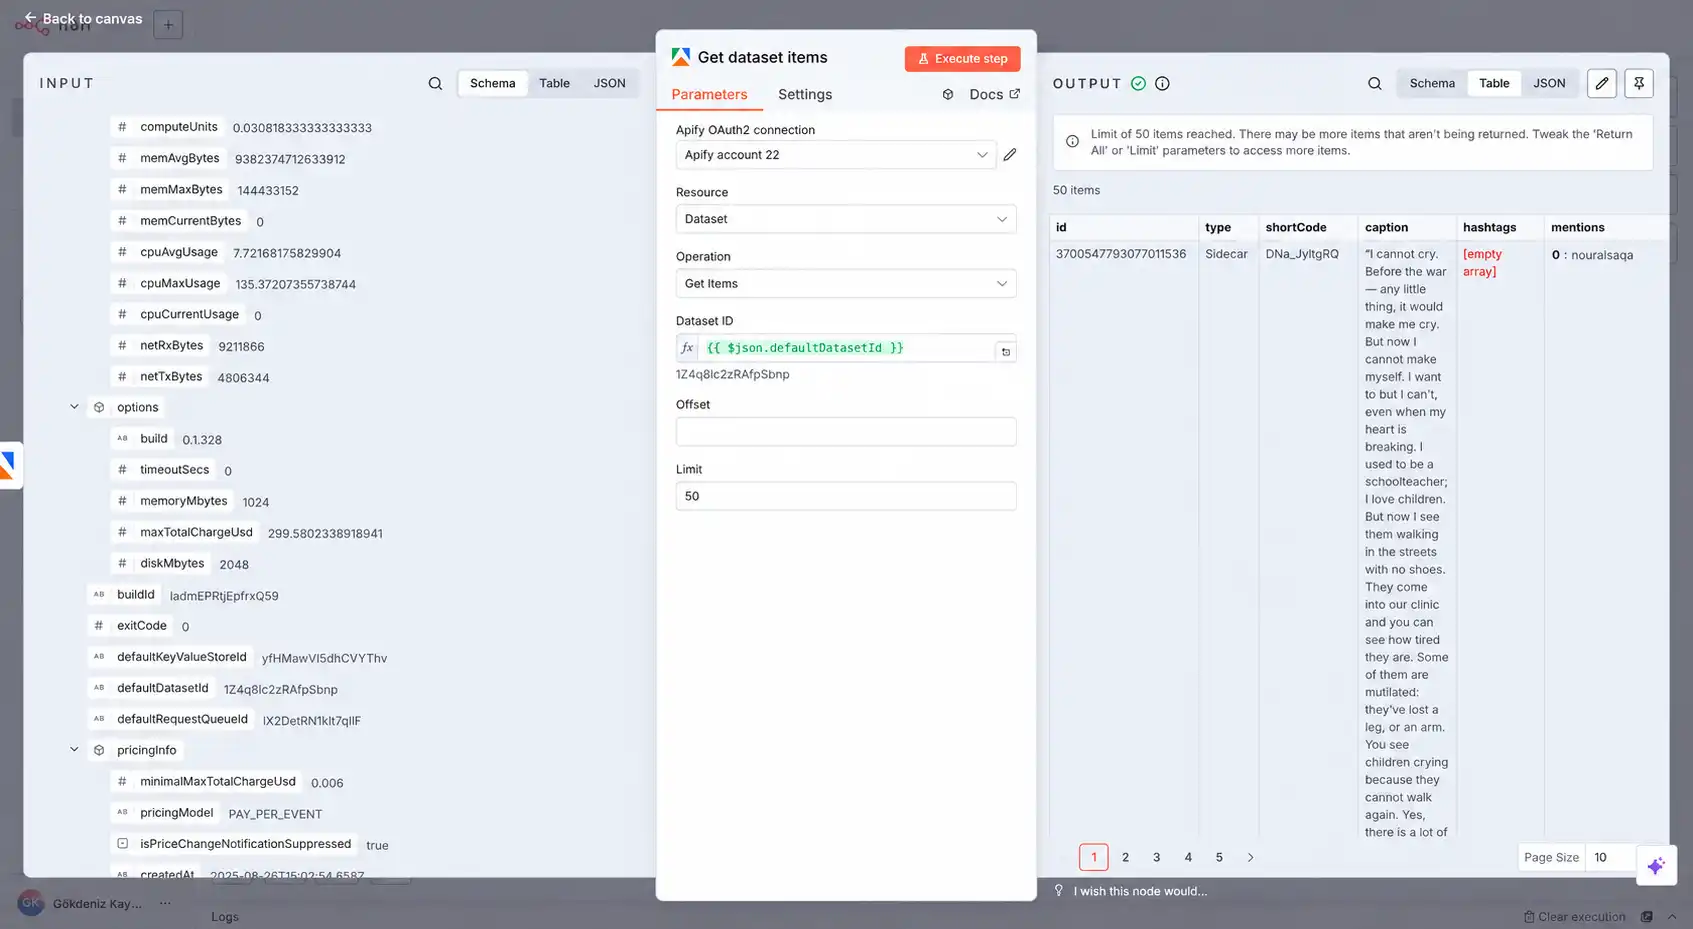
ステップ7:1つのスキーマにマージして正規化する
3つのApifyノードすべてを、追加モードに設定されたマージノードに接続します。プラットフォームごとにフィールド名が異なるため、コードノードを使用してそれらを1つの共通の形状にマッピングします。
const out = [];

for (const { json: p } of $input.all()) {

  if (p.error) continue; // skip failed inputs

  if (p.webVideoUrl) {

    out.push({ platform: 'tiktok', post_id: p.id, creator: p.authorMeta?.name,

      url: p.webVideoUrl, caption: p.text, published: p.createTimeISO,

      views: p.playCount, likes: p.diggCount, comments: p.commentCount,

      shares: p.shareCount });

  } else if (p.shortCode) {

    out.push({ platform: 'instagram', post_id: p.shortCode, creator: p.ownerUsername,

      url: p.url, caption: p.caption, published: p.timestamp,

      views: p.videoViewCount ?? null, likes: p.likesCount,

      comments: p.commentsCount, shares: null });

  } else if (p.viewCount !== undefined) {

    out.push({ platform: 'youtube', post_id: p.id, creator: p.channelName,

      url: p.url, caption: p.title, published: p.date,

      views: p.viewCount, likes: p.likes, comments: p.commentsCount,

      shares: null });

  }

}

return out.map(json => ({ json }));
YouTube Scraperは、削除された動画や存在しないチャンネルに関するエラー項目を書き込みます。p.errorチェックは、これらのエラー項目がスコアに影響を与える前に削除します。
ステップ8:外れ値とエンゲージメントの計算で各投稿をスコアリングする
生の再生回数は、大規模アカウントの見栄えを良くする傾向があります。クリエイターの異常値スコアは、各投稿をそのクリエイター自身の平均値と比較するため、小規模チャンネルの異常値が目立つようになります。
| メトリック | 式 | それがあなたに伝えるもの |
|---|---|---|
| 外れ値スコア | 投稿閲覧数 ÷ クリエイターの平均閲覧数 | 投稿が自身の基準値をどれだけ上回ったか |
| エンゲージメント率 | (いいね数+コメント数+シェア数)÷再生回数×100 | 視聴者の反応はどれほど激しかったか |
| Instagramのフォールバック | 投稿のいいね数 ÷ クリエイターのいいね数の中央値 | 閲覧数のない画像投稿に有効です |
const items = $input.all().map(i => i.json);

const base = it => it.views || it.likes || 0;

const groups = {};

for (const it of items) (groups[it.creator] ??= []).push(base(it));

const median = a => { const s = [...a].sort((x, y) => x - y), m = Math.floor(s.length / 2);

  return s.length % 2 ? s[m] : (s[m - 1] + s[m]) / 2; };

return items.map(it => {

  const med = median(groups[it.creator]) || 1;

  const eng = it.views ? ((it.likes || 0) + (it.comments || 0) + (it.shares || 0)) / it.views * 100 : null;

  return { json: { ...it, outlier: +(base(it) / med).toFixed(2),

    engagement: eng === null ? null : +eng.toFixed(2) } };

}).sort((a, b) => b.json.outlier - a.json.outlier);1週間分の投稿だけでは、十分な基準値とは言えません。数週間後には、「投稿ログ」タブを確認し、過去の投稿履歴から中央値を算出してください。
ステップ9:重複削除ノードを使用してブロックの繰り返しを削除する
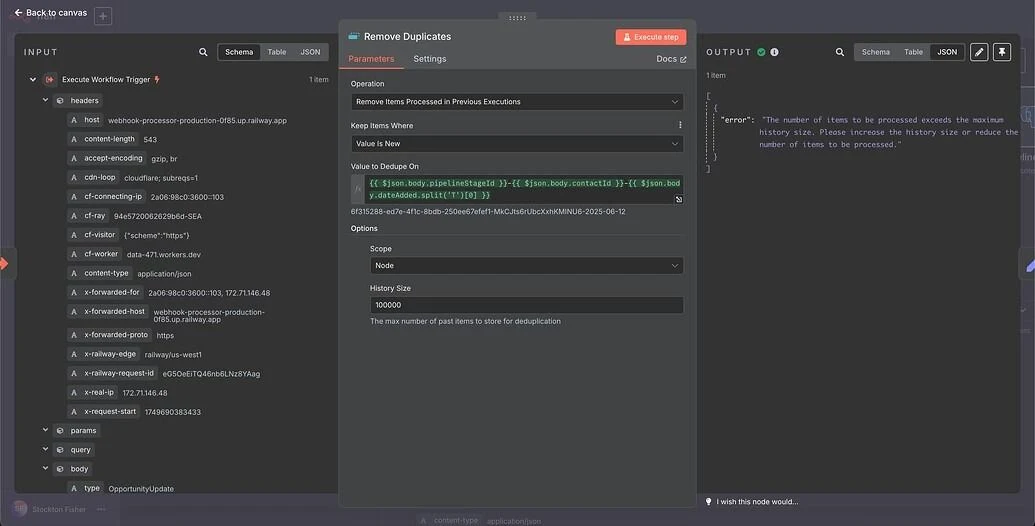
スコアリング後に重複削除ノードを追加します。操作を「以前の実行で処理されたアイテムを削除し、値が新しいアイテムを保持する」に設定します。
この永続的な重複排除機能により、手動で再トリガーした際に同じ投稿が二度メール送信されるのを防ぎます。重複排除履歴をクリアすると、テスト中は重複排除機能がリセットされます。
ステップ10:を追加します AI パターン分析レイヤー
Limitノードを使用して上位15件の投稿を保持し、次にAggregateノードをAll Item Dataに設定します。これにより、バッチ全体が渡されます。 AI 1つのアイテムとして。
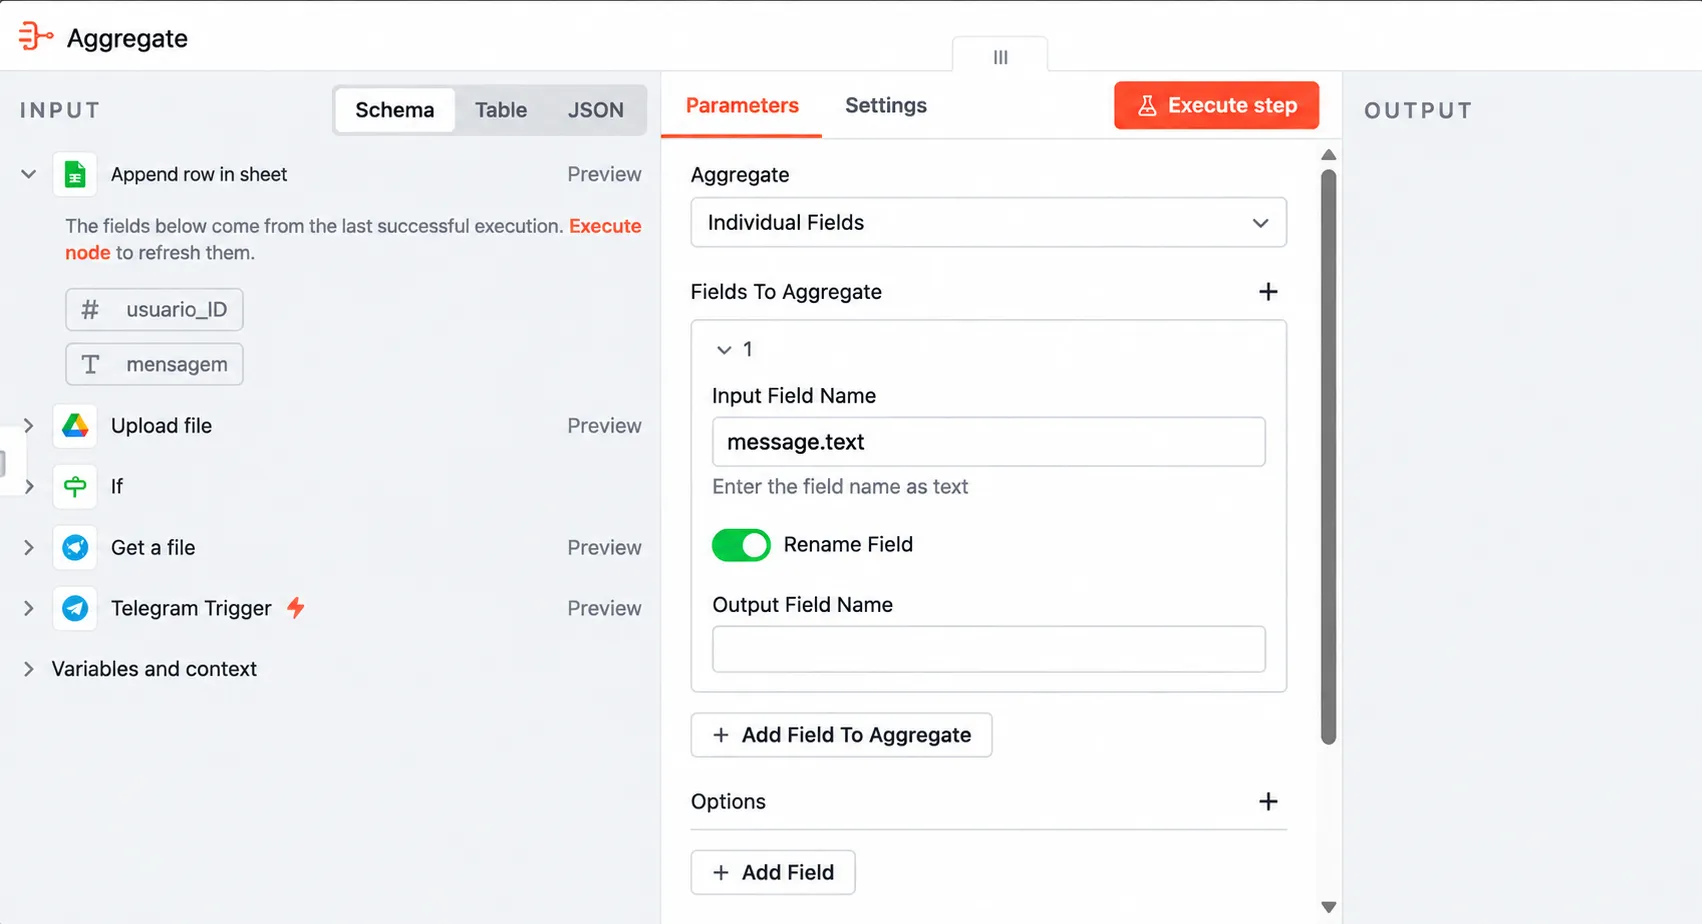
次に、OpenAI、Anthropic、Geminiなど、既に使用しているチャットモデルを使用して、基本的なLLMチェーンを追加します。
「特定の出力形式を要求する」を有効にし、構造化出力パーサーを接続します。
あなたはショートフォームコンテンツの戦略家です。
以下は今週のものです's トップクリエイターの投稿をJSON形式で表示し、外れ値スコアに基づいてランキング付けします。
以下の内容を含むJSONを返します。
– 「パターン」:投稿URLを引用する、繰り返し出現する3つのフックまたはフォーマット
– 「トピック」: 2つ以上の受賞記事に登場するトピック
– 「アイデア」:今週、私たちのチームが撮影できるコンテンツのアイデア3つ
データからの証拠のみを使用してください。パターンが弱い場合は、その旨を明記してください。
{{ JSON.stringify($json.data) }}字幕だけでは、短い動画の成否を左右する音声によるフックが欠けてしまう。's 運命。
YouTubeまたはTikTokタスクで文字起こし機能をオンにした場合、字幕テキストの冒頭部分を正規化されたアイテムに取り込む。
そのテキストを最初の300文字程度に切り詰めます。その後、モデルは勝者の実際のオープニングラインを比較し、トークンの使用量を少なく抑えます。
「証拠のみを使用する」という一線は重要です。 AI コンテンツ 一般的なトレンドに関する雑談ではなく、実際の投稿に基づいたパターン分析。
ステップ11:HTMLダイジェストを組み立ててGmailで送信する
最後のコードノードは、スコア付き投稿をペアにします。 AI 出力を行い、メール本文を作成します。
const posts = $('Limit').all().map(i => i.json);

const ai = ('BasicLLMChain').first().json.output;constrows=posts.map(p=>`<tr><td>{p.platform}</td><td>p.creator</td><td><ahref="{p.url}">(p.caption||'').slice(0,70)</a></td><td>{p.outlier}x</td><td>p.engagement??'–'%</td></tr>`).join('');consthtml=`<h2>TopOutliers</h2><tableborder="1"cellpadding="6">{rows}</table>

  <h2>Patterns</h2><ul>${ai.patterns.map(x => `<li>${x}</li>`).join('')}</ul>

  <h2>Ideas</h2><ul>${ai.ideas.map(x => `<li>${x}</li>`).join('')}</ul>`;

return [{ json: { html } }];const items = $input.all().map(i => i.json);

const base = it => it.views || it.likes || 0;

const groups = {};

for (const it of items) (groups[it.creator] ??= []).push(base(it));

const median = a => { const s = [...a].sort((x, y) => x - y), m = Math.floor(s.length / 2);

  return s.length % 2 ? s[m] : (s[m - 1] + s[m]) / 2; };

return items.map(it => {

  const med = median(groups[it.creator]) || 1;

  const eng = it.views ? ((it.likes || 0) + (it.comments || 0) + (it.shares || 0)) / it.views * 100 : null;

  return { json: { ...it, outlier: +(base(it) / med).toFixed(2),

    engagement: eng === null ? null : +eng.toFixed(2) } };

}).sort((a, b) => b.json.outlier - a.json.outlier);
次に、以下の設定でGmailノードを追加します。
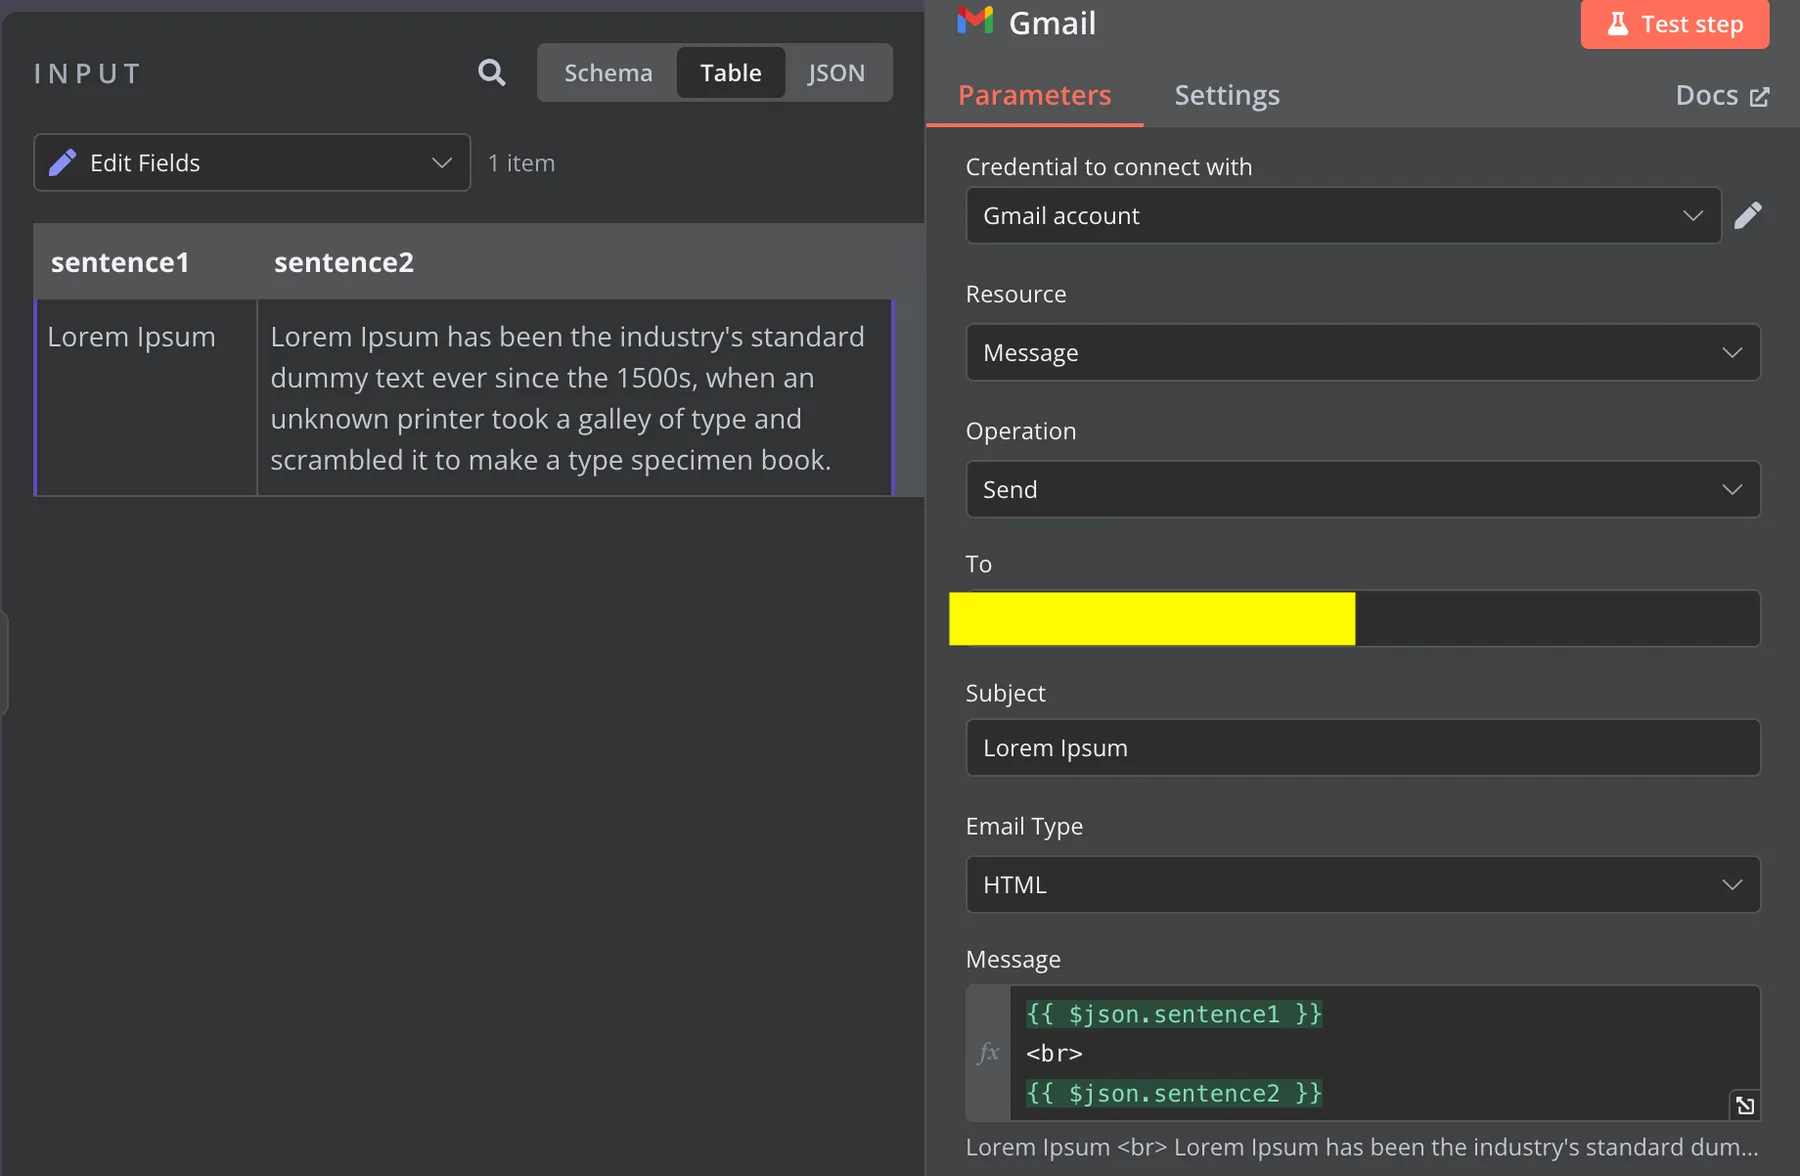
ステップ12:投稿をGoogleスプレッドシートに記録して公開する
[重複を削除] ノードから[投稿ログ] タブの[行を追加] または [行を更新]を使用して Google スプレッドシート ノードに分岐します。post_id で一致させることで、更新された統計情報が古い行を上書きします。
正規化されたフィールド名が既に列と一致しているため、マッピングを「自動マッピング」に設定してください。一度手動で実行し、メールを確認してからワークフローを公開してください。
Apifyのスケジュールとイベントトリガーを使ったスケーリング
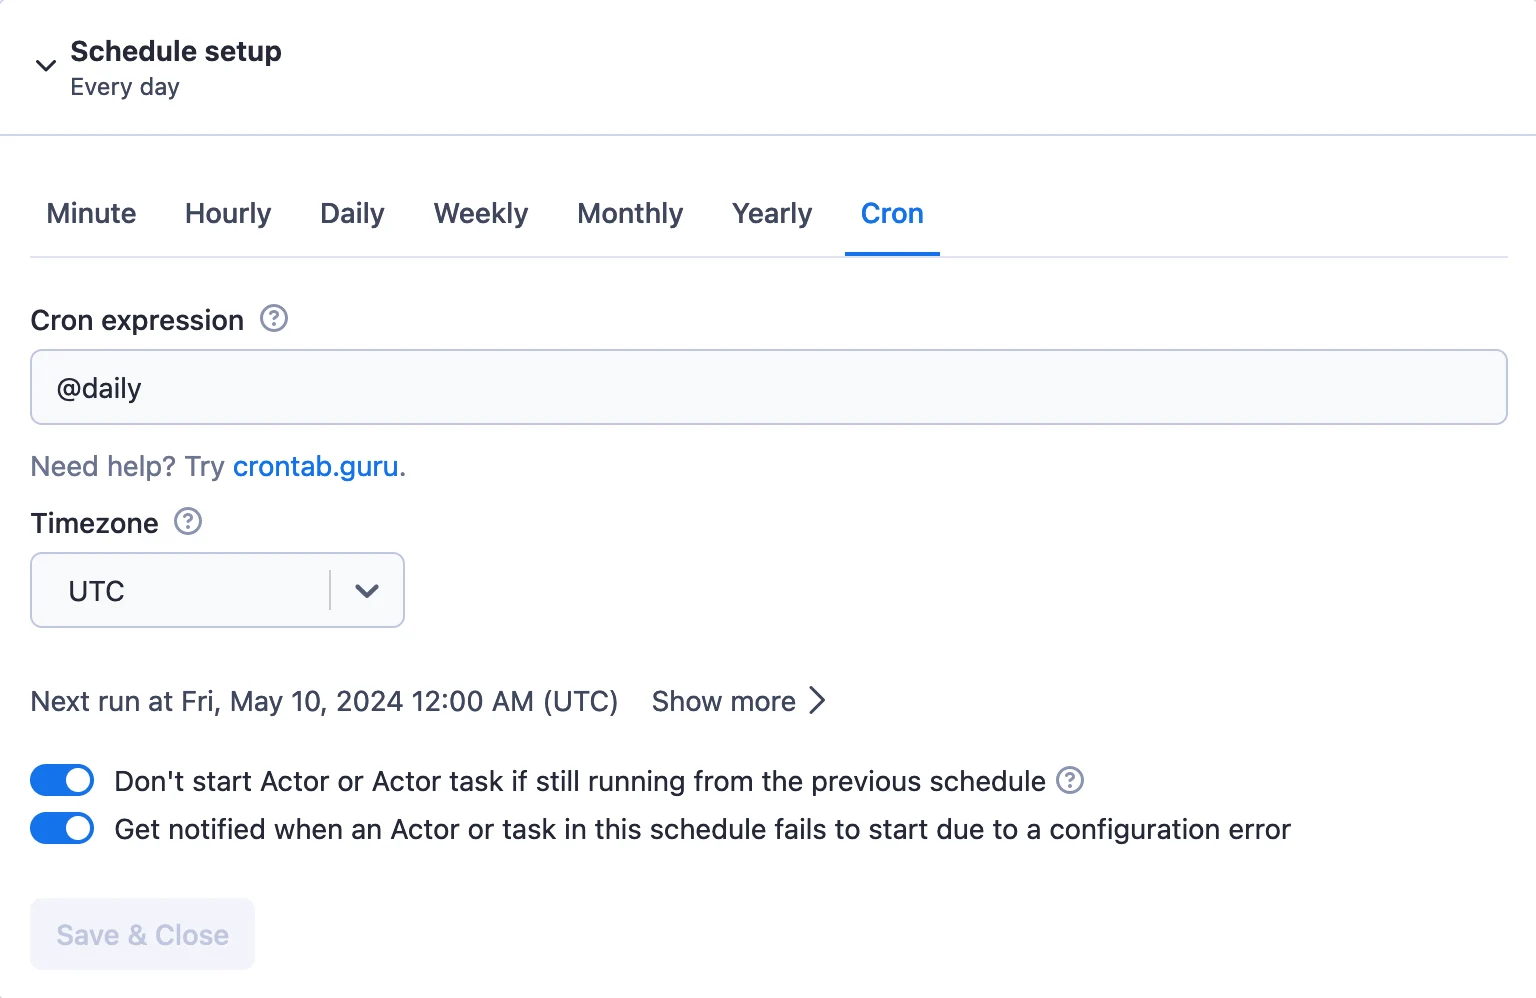
単一のスケジュールされたワークフローは、数十人のクリエイターのグループに適しています。それ以上の規模になると、長時間のスクレイピング作業によってn8nの実行が数分間も実行されたままになり、また、処理速度の遅いプラットフォームが1つあるだけで、他の処理も停止してしまいます。
この修正により、両方のプラットフォームで作業が分割されます。
| 因子 | 単一ワークフロー | 分割ワークフロー |
|---|---|---|
| 設定時間 | 速く | 少し長め |
| 長時間の削り取り作業 | 処刑は終始待機している | n8n内では待ち時間なし |
| 1つのプラットフォームが失敗する | 消化をブロックできます | 他の着陸機もまだ着陸する |
| セルフホスティングのニーズ | 追加なし | トリガー用の公開WEBHOOK_URL |
Apifyの新規スケジュールは初期設定では無効になっているため、保存後に有効にしてください。また、スケジュールされたタスクの開始に失敗した場合でも、Apifyからメールで通知されます。
毎週パイプラインを健全に保つ
真の敵は、静かに進行する失敗です。受信トレイが空っぽだと、まるで静かな一週間だったかのように見えてしまうので、初日からアラートを設定しておくことが重要です。
入力制限だけでも使用量を最小限に抑えることができます。日付範囲を厳密に設定し、プロファイルごとに結果数を制限し、必要な場合にのみトランスクリプトを取得するようにすることで、毎週のデータ取得量を少なく抑えています。
クリエイターによるスクレイピングが真の限界に達する時
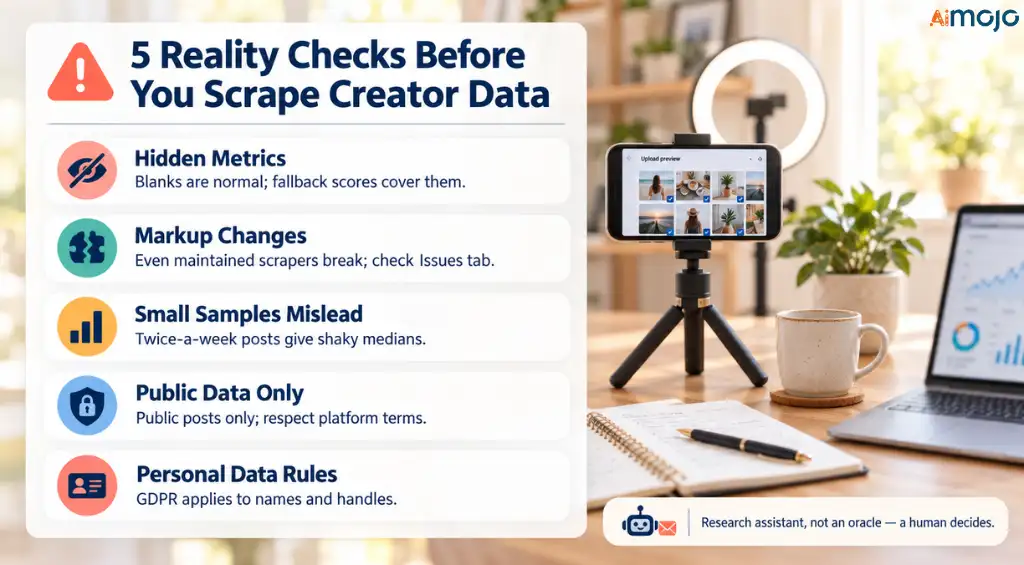
どの自動化提案もこの部分を省略しているので、ここで明確に述べておきます。
受信トレイは、神託ではなく、あくまで研究助手として扱いましょう。どのパターンを撮影する価値があるかは、最終的には人間が判断するのです。
Apifyとn8n Creatorに関する調査のクイックアンサー
n8nはコードを使わずにApifyアクターをトリガーできますか?
公式のApifyノードは、アクターまたはタスクを実行し、結果を待機し、データセット項目を返します。これらはすべてn8nのフィールドを通じて設定されます。
このワークフローはどのクリエイターを追跡できますか?
公開されているYouTubeチャンネル、TikTokプロフィール、またはInstagramアカウントであればどれでも使用できます。他のApify Storeアクターに置き換えることで、さらに多くのプラットフォームを追加できます。
Apifyノードは AI エージェントツール?
加えます Apifyツール の下で AI エージェント's モデルがチャットからオンデマンドでスクレイピングをトリガーできるようにするためのツール。
結論
クリエイター調査では、最初にパターンを見つけた人が報われる。手動でスクロールするのはフルタイムの仕事になり、ほとんどのチームは数週間後にひっそりと諦めてしまう。
Apifyとn8nは、その作業をシステムに任せる。
ストアアクターは最新の公開投稿を取得し、コードノードは各作成者に対してそれらを評価します。's 独自の基準値、そして AI 層 数字を簡潔な説明文に変換する。
まずは、単一のスケジュールワークフローと、既にフォローしている5人のクリエイターから始めましょう。ダイジェストが効果的だと分かったら、フォローするクリエイターを増やし、Apify Schedulesを使った分割設定に移行してください。
3~4週間分のログ履歴を記録させてください。's 異常値スコアが鋭くなり、月曜日の受信トレイに届くメールが、市販のどんなトレンドレポートよりも多くの情報で溢れるようになる時。
AiMojoのおすすめ:


 ボーナス: 200ドルの「AI 登録すると「マスタリーツールキット」が無料になります!






