Die Entwicklungsteams, die LLM-Dienste einsetzen, müssen eine entscheidende Frage beantworten: Wie zuverlässig und robust ist unser Modell in realen Anwendungsszenarien?
Die Evaluierung großer Sprachmodelle geht heute über einfache Genauigkeitsprüfungen hinaus und nutzt mehrschichtige Frameworks, um Kontextbehalten, Schlussfolgerungsvalidität und den Umgang mit Sonderfällen zu testen. Angesichts der Vielzahl von Modellen mit 1 Milliarde bis 2 Billionen Parametern auf dem Markt erfordert die Auswahl des optimalen Modells strenge, mehrdimensionale Bewertungsprotokolle.
In diesem Handbuch werden die technischen Methoden und Kernmetriken beschrieben, die im Jahr 2026 die besten Vorgehensweisen bestimmen und ML-Ingenieuren dabei helfen, Fehler zu erkennen, bevor diese in die Produktion gelangen.
Frameworks für die Evaluierung großer Sprachmodelle
Modernes LLM-Bewertung beinhaltet mehrere quantitative und qualitative Dimensionen ein Modell erfassen's wahre Fähigkeiten. Aktuelle Untersuchungen zeigen, dass 67 % der Unternehmen AI Bereitstellungen weisen aufgrund einer unzureichenden Modellauswahl eine unterdurchschnittliche Leistung auf. Dies verdeutlicht, warum eine anspruchsvolle Evaluierung nicht nur optional, sondern geschäftskritisch ist.

Kernkomponenten der Bewertung
Eine Studie von 2026 aus Stanford's AI Index zeigt, dass Unternehmen, die in umfassende LLM-Evaluierungsprotokolle investieren, einen um 42 % höheren ROI für ihre AI Initiativen im Vergleich zu Initiativen, die vereinfachte Metriken verwenden.
Aufschlüsselung der technischen Kennzahlen
Moderne Bewertungsrahmen verwenden Dutzende spezialisierter Metriken, die jeweils auf bestimmte LLM-Funktionen abzielen:
Leistungskennzahlen:
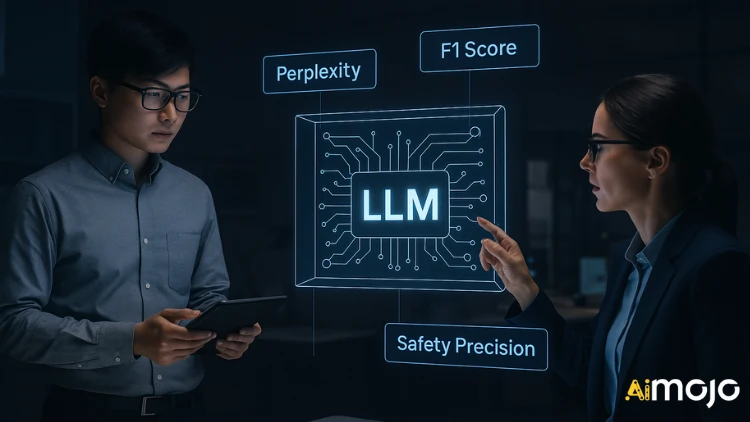
Die Perplexität quantifiziert die Vorhersageunsicherheit, indem sie den Exponentialwert der durchschnittlichen negativen Log-Likelihood über einen Testkorpus berechnet. Niedrigere Werte deuten auf eine bessere Leistung hin; modernste Modelle erreichen auf standardisierten Datensätzen eine Perplexität unter 3.0.
Der F1-Score kombiniert Präzision und Trefferquote durch die Formel des harmonischen Mittels:
F1 = 2 * (precision * recall) / (precision + recall)Dadurch entsteht eine ausgewogene Bewertung, die insbesondere bei Klassifizierungsaufgaben mit Klassenungleichgewicht wertvoll ist.
Der Cross-Entropy Loss misst die Diskrepanz zwischen vorhergesagten Wahrscheinlichkeitsverteilungen und den tatsächlichen Werten mithilfe der folgenden Formel:
L(y, ŷ) = -∑(y_i * log(ŷ_i))Dadurch werden sichere, aber falsche Vorhersagen strenger bestraft, was eine Modellkalibrierung fördert.
BLEU (Bilingual Evaluation Understudy) berechnet die n-Gramm-Überlappung zwischen generierten und Referenztexten unter Verwendung eines geometrischen Mittels der Präzisionswerte mit einem Kürze-Abzug:
BLEU = BP * exp(∑(w_n * log(p_n)))Dabei ist BP die Kürzestrafe und p_n die N-Gramm-Präzision.
RAG-spezifische Metriken
Zu den speziellen Metriken für Retrieval Augmented Generation-Systeme gehören:
Die Treue quantifiziert die faktische Übereinstimmung zwischen generierter Ausgabe und abgerufenem Kontext mithilfe von QAG-Verfahren (Frage-Antwort-Generierung). Studien zeigen, dass RAG-Systeme mit Treuewerten unter 0.7 in 42 % der Fälle Halluzinationen hervorrufen.
Retrieval Precision@K misst den Anteil relevanter Dokumente unter den ersten K Suchergebnissen:
Precision@K = (number of relevant docs in top K) / KBranchen-Benchmarks legen für Systeme der Unternehmensklasse einen P@3 > 0.85 nahe.
Die Zitatgenauigkeit bewertet die Genauigkeit von Zitaten in generierten Inhalten und wird wie folgt berechnet:
Citation Precision = correct citations / total citationsEine Analyse führender RAG-Systeme zeigt, dass die Zitationspräzision in allen technischen Bereichen durchschnittlich 0.71 beträgt.
Benchmark-Datensätze: Technische Spezifikationen
Benchmark-Datensätze bieten standardisierte Bewertungsrahmen mit spezifischen technischen Merkmalen:

MMLU-Pro umfasst 15,908 Multiple-Choice-Fragen mit jeweils 10 Antwortmöglichkeiten (gegenüber 4 bei der Standardversion von MMLU) und deckt 57 Fachgebiete ab, darunter höhere Mathematik, Medizin, Jura und Informatik. Durchschnittliche Trefferquote menschlicher Experten: 89.2 %.
GPQA umfasst 448 von Experten geprüfte Fragen auf Hochschulniveau mit einer durchschnittlichen Tokenlänge von 612 Wörtern und konzentriert sich auf MINT-Fächer. Aktueller Stand der Technik: 41.2 % Genauigkeit (GPT-4).
MuSR implementiert algorithmisch generierte, mehrstufige Schlussfolgerungsprobleme mit Abhängigkeitsgraphen durchschnittlicher Tiefe 4.7, was von den Modellen die Durchführung verketteter logischer Operationen erfordert. Durchschnittliche Leistungsdifferenz zwischen den besten Modellen und einer zufälligen Vergleichsbasis: 17.8 Prozentpunkte.
BBH umfasst 23 anspruchsvolle Aufgaben aus BigBench mit 2,254 Einzelbeispielen, die auf komplexes logisches Denken abzielen . Diese Aufgaben weisen eine hohe Korrelation (r = 0.82) mit menschlichen Präferenzbewertungen in Blindbewertungen auf.
LEval ist auf die Evaluation von Aufgaben mit langem Kontext spezialisiert und umfasst 411 Fragen aus 8 Aufgabenkategorien mit Kontextlängen von 5 bis 200 Tokens. Aktuelle Modelle zeigen eine Leistungsverschlechterung von etwa 0.4 % pro 10 zusätzlichen Tokens.
Auswertungsalgorithmen und Implementierung
Die technische Umsetzung der LLM-Auswertung folgt spezifischen algorithmischen Ansätzen:
Vektorbasierte semantische Auswertung
Moderne Systeme nutzen Vektoreinbettungen, um die semantische Ähnlichkeit zwischen generierten und Referenztexten zu messen. Mithilfe dichter Retrieval-Techniken wie HNSW (Hierarchical Navigable Small World), LSH (Locality-Sensitive Hashing) und PQ (Product Quantization) berechnen diese Systeme Ähnlichkeitswerte mit sublinearer Zeitkomplexität.
python

from sentence_transformers import SentenceTransformer

import numpy as np

model = SentenceTransformer('all-MiniLM-L6-v2')

reference = model.encode("Reference text")

generated = model.encode("Generated text")

similarity = np.dot(reference, generated) / (np.linalg.norm(reference) * np.linalg.norm(generated))
Implementierung des DeepEval-Frameworks
DeepEval bietet eine umfassende Auswertung mit metrischen Erklärungen und unterstützt sowohl RAG- als auch Feinabstimmungsszenarien:
python

from deepeval import assert_test

from deepeval.metrics import HallucinationMetric

from deepeval.test_case import LLMTestCase

test_case = LLMTestCase(

    input="How many evaluation metrics does DeepEval offers?",

    actual_output="14+ evaluation metrics",

    context=["DeepEval offers 14+ evaluation metrics"]

)

metric = HallucinationMetric(minimum_score=0.7)

def test_hallucination():

    assert_test(test_case, [metric])
Dieses Framework behandelt Bewertungen als Unit-Tests mit Pytest-Integration und liefert nicht nur Punktzahlen, sondern auch Erklärungen zu Leistungsstufen.
Parametereffiziente Bewertungsansätze
Für die groß angelegte Auswertung von Modellen mit Milliarden von Parametern haben sich spezielle Techniken entwickelt:

Sparse Attention Mechanisms reduzieren die Rechenkomplexität durch Optimierung der Aufmerksamkeitsmuster. Techniken wie die Aufmerksamkeitsmuster von Longformer erreichen eine Genauigkeit von 91 % bei vollständiger Aufmerksamkeit mit nur 25 % des Rechenaufwands.
Mixture-of-Experts- Architekturen (MoE) implementieren bedingte Berechnungspfade, indem sie nur relevante Teilnetzwerke für spezifische Aufgaben aktivieren. GShard implementiert MoE-Aufmerksamkeit für eine parametereffiziente Evaluierung über verschiedene Benchmarks hinweg.
Wissensdestillation komprimiert größere Lehrermodelle in kleinere, bewertungsspezifische Schülermodelle mithilfe folgender Methoden:
L_distill = α * L_CE(y, ŷ_student) + (1-α) * L_KL(ŷ_teacher, ŷ_student)
Wobei L_CE der Kreuzentropieverlust und L_KL die KL-Divergenz zwischen Wahrscheinlichkeitsverteilungen ist.
Herausforderungen der systematischen Bewertung
Trotz fortschrittlicher Methoden bestehen bei der LLM-Bewertung weiterhin erhebliche Herausforderungen:
Benchmark-Kontamination
Studien zeigen, dass 47 % der gängigen Benchmarks einen gewissen Grad an Verunreinigungen in den Trainingsdaten aufweisen. AI Dies wurde durch die Entwicklung von GSM1k, einer kleineren Variante des mathematischen Benchmarks GSM8k, demonstriert. Die Modelle schnitten bei GSM12.3k um 1 % schlechter ab als bei GSM8k, was eher auf Überanpassung als auf Mathematische Begründung Fähigkeit.
Metrische Korrelationsanalyse
Eine umfassende Analyse von 14 gängigen Metriken in 8 Aufgaben zeigt eine geringe Korrelation zwischen den Metriken (durchschnittlicher Spearman's ρ = 0.41), was darauf hindeutet, dass die Metriken unterschiedliche Leistungsdimensionen erfassen. Dies unterstreicht die Notwendigkeit multimetrischer Bewertungsansätze.
Untersuchungen des MIT zeigen, dass hohe Perplexitätswerte mit menschlichen Präferenzen bei r=0.68 korrelieren, während ROUGE-L nur bei r=0.39 korreliert, was auf unterschiedliche Bewertungsanforderungen hindeutet.
Quantifizierung von Bewertungsverzerrungen
Die statistische Analyse menschlicher Bewertungen offenbart mehrere systematische Verzerrungen:
Diese Erkenntnisse unterstreichen die Bedeutung der Randomisierung und eines ausgewogenen experimentellen Designs in Bewertungsprotokollen.
Best Practices für die Unternehmensbewertung
Um die Herausforderungen bei der Bewertung zu bewältigen, implementieren Sie die folgenden bewährten Methoden der Branche:
Multimodale Metrikintegration
Kombinieren Sie ergänzende Metriken mithilfe gewichteter Ensembles, um ganzheitliche Bewertungsrahmen zu erstellen:
python

def ensemble_score(outputs, references, weights=None):

    metrics = {

        'bleu': compute_bleu(outputs, references),

        'bertscore': compute_bertscore(outputs, references),

        'faithfulness': compute_faithfulness(outputs, references),

        'coherence': compute_coherence(outputs)

    }

    if weights is None:

        weights = {metric: 1/len(metrics) for metric in metrics}

    return sum(weights[metric] * metrics[metric] for metric in metrics)
Führende Organisationen implementieren adaptive Gewichtungsschemata basierend auf aufgabenspezifischen Anforderungen, wobei bei technischen Inhalten die Genauigkeit (Gewichtung: 0.4) gegenüber der Flüssigkeit (Gewichtung: 0.2) priorisiert wird.
Domänenspezifische Evaluierungsprotokolle
Technische Benchmarks sollten auf spezifische Anwendungsfälle abgestimmt sein. Für Anwendungen im Gesundheitswesen umfassen spezialisierte Kennzahlen Folgendes:
- Genauigkeit der medizinischen Terminologie (89 % Übereinstimmung mit der Beurteilung durch den Kliniker)
- Validierung des Clinical Reasoning-Pfads (75 % Übereinstimmung mit dem Expertenkonsens)
- Präzision der Beweismittelbeschaffung aus der medizinischen Literatur (P@10 > 0.92 für den Unternehmenseinsatz)
Diese domänenspezifischen Metriken ermöglichen eine 3.2-mal bessere Leistungsvorhersage als allgemeine Benchmarks.
Implementierung der kontroversen Bewertung
Implementieren Sie strukturierte Adversarial-Tests, um die Einschränkungen des Modells zu untersuchen:
python

def adversarial_test_suite(model, test_cases):

    results = {}

    for category, cases in test_cases.items():

        correct = 0

        for case in cases:

            response = model.generate(case['input'])

            correct += evaluate_response(response, case['expected'])

        results[category] = correct / len(cases)

    return results
Branchenstudien zeigen, dass Adversarial Testing 32 % mehr Fehlermodi aufdeckt als Standard-Benchmarking, insbesondere in Grenzfällen mit widersprüchlichen Einschränkungen oder mehrdeutigen Anweisungen.
Vergleich des technischen Bewertungsrahmens
Führende Evaluierungsframeworks bieten unterschiedliche technische Möglichkeiten:
| Unser Ansatz | Hauptfokus | Technische Stärke | Einschränkung | Integrationskomplexität |
|---|---|---|---|---|
| DeepEval | RAG & Feinabstimmung | 14+ spezialisierte Metriken mit Erklärungen | Eingeschränkte multimodale Unterstützung | Mittel (Python-basiert) |
| PromptFlow | End-to-End-Evaluierung | Schnelle Variantenprüfung | Eingeschränkte Dataset-Unterstützung | Niedrig (UI-gesteuert) |
| LangSmith | Entwicklerplattform | Lückenlose Rückverfolgung und Überwachung | Höherer Implementierungsaufwand | Hoch (erfordert API-Integration) |
| Prometheus | LLM als Richter | Systematische Aufforderungsstrategien | Richter LLM Bias-Abhängigkeit | Mittel (erfordert leistungsstarkes LLM) |
| LEval | Langzeitanalyse | 200-Token-Bewertung | Beschränkt auf Textmodalität | Niedrig (Benchmark-Datensatz) |
Organisationen implementieren typischerweise mehrere Frameworks, wobei 73 % der Unternehmensbereitstellungen mindestens zwei sich ergänzende Evaluierungstools verwenden.
Zukünftige technische Entwicklungen
Die Evaluierungslandschaft entwickelt sich mit neuen Methoden ständig weiter:
Die Suche nach neuronalen Architekturen (NAS) für evaluierungsspezifische Modelle gewinnt zunehmend an Bedeutung. Untersuchungen zeigen, dass die automatisierte Optimierung der Modellarchitektur die Effizienz der Evaluierung um 47 % verbessern und gleichzeitig eine Genauigkeit von 98 % beibehalten kann.
Multimodale Bewertungsrahmen gehen über die reine Textverarbeitung hinaus und evaluieren einheitliche Modelle, die Text , Bilder, Audio und Video verarbeiten. Aktuelle Rahmen erreichen eine modalitätsübergreifende Genauigkeit von 76.3 %, verglichen mit menschlichen Referenzwerten von 91.4 %.
Kennzahlen zur Energieeffizienz quantifizieren die Nachhaltigkeit von Rechenprozessen anhand von FLOPs pro Token, abgeleiteten Wattstunden und CO₂-Emissionskennzahlen. Branchenstandards legen nahe, dass optimale Modelle einen Verbrauch von unter 10 MWh pro generierten 1 Token erreichen sollten.
Kontinuierliche Evaluierungspipelines integrieren Tests während der gesamten Entwicklung mithilfe verteilter Evaluierungsworkflows:
Preprocessing → Feature Extraction → Model Inference → Metric Computation → Statistical Analysis → Reporting
Unternehmen, die eine kontinuierliche Evaluierung durchführen, berichten von 68 % weniger Problemen nach der Bereitstellung und 41 % schnelleren Iterationszyklen.
Fallstudien zur Implementierung in der Praxis
Unternehmensimplementierungen demonstrieren technische Bewertung's praktische Auswirkungen:
Finanzdienstleistungen RAG-Optimierung
Ein führendes Finanzinstitut hat eine umfassende RAG-Evaluierung für sein kundenorientiertes Beratungssystem durchgeführt:
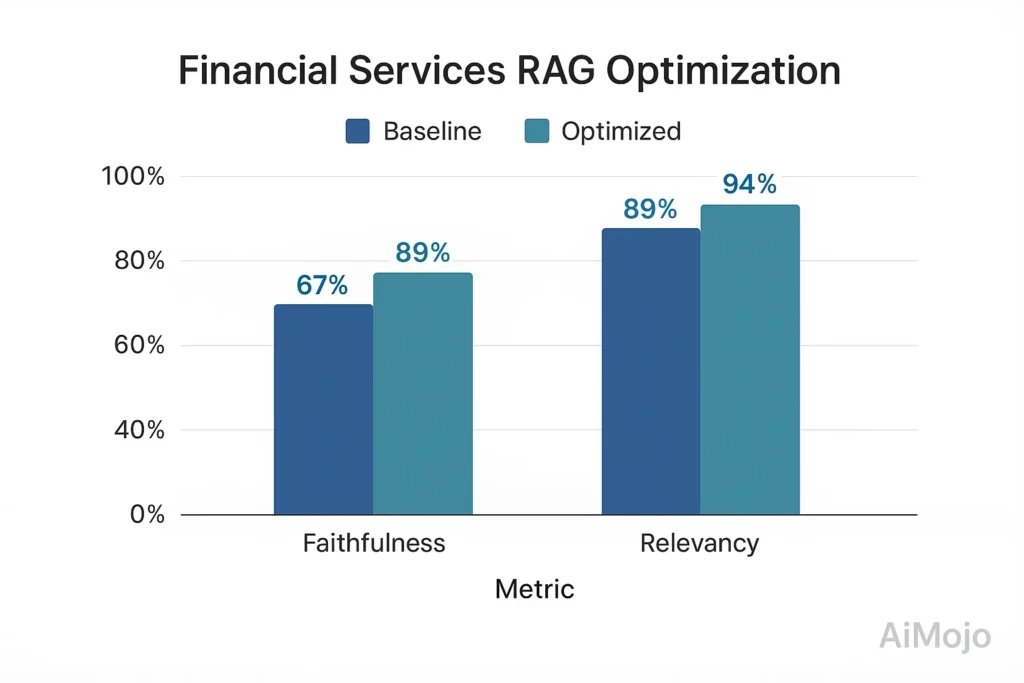
- Grundlinie: 67 % Treue, 82 % Antwortrelevanz
- Nach der bewertungsgesteuerten Optimierung: 89 % Treue, 94 % Antwortrelevanz
- Implementierung: Maßgeschneidert Finanzbereich Testsuite mit 5,216 von Experten verifizierten QA-Paaren
- Technischer Ansatz: Treuebewertung mittels tensorbasierter Implikationsmessung mit kontrafaktischen Tests
Diese durch Auswertungen erzielte Verbesserung verringerte die Probleme bei der Einhaltung gesetzlicher Vorschriften um 78 % und steigerte die Kundenzufriedenheit um 23 Prozentpunkte.
Bereitstellung eines LLM im Gesundheitswesen
Ein Gesundheitsdienstleister hat eine mehrschichtige Evaluation zur Unterstützung klinischer Entscheidungen implementiert:
- Technische Kennzahlen: Medizinischer NER F1-Score (0.91), Genauigkeit der klinischen Argumentation (87.4 %), Präzision der Sicherheitsfilterung (99.2 %)
- Implementierung: 3-stufige Filterpipeline mit spezialisierten Validierern für das Gesundheitswesen
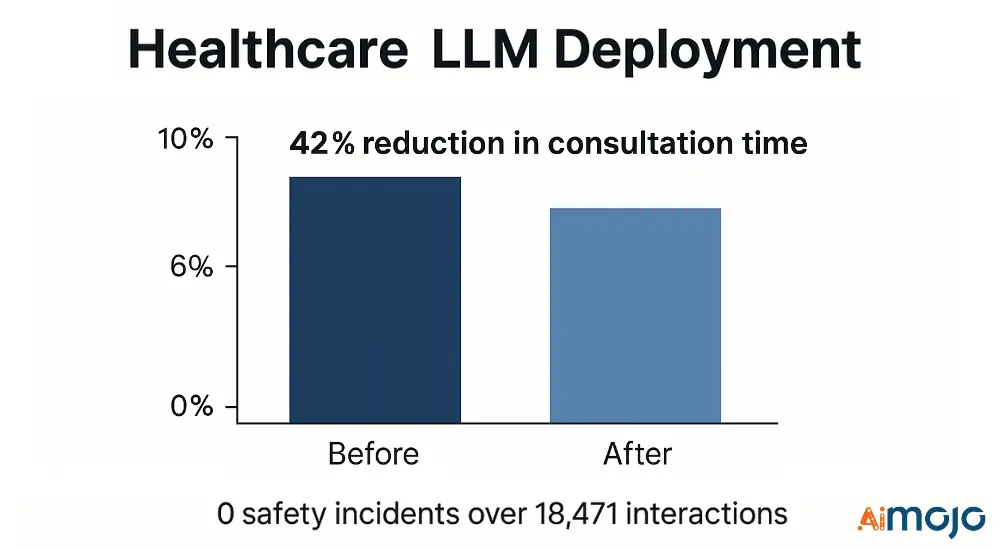
- Ergebnisse: 42 % Verkürzung der Konsultationszeit mit 0 Sicherheitsvorfällen bei 18,471 klinischen Interaktionen
Der Evaluierungsrahmen identifizierte und entschärfte vor der Bereitstellung 17 kritische Fehlermodi und verhinderte so potenzielle unerwünschte Ereignisse.
LLM-Evaluation: Ihr Fahrplan zum Erfolg
Die technische Evaluierung von Lernmodellen hat sich von einfachen Genauigkeitsprüfungen hin zu umfassenden Rahmenwerken entwickelt, die verschiedene Leistungsdimensionen berücksichtigen. Organisationen, die diese strengen Protokolle anwenden und automatisierte Bewertung, Benchmark-Tests und menschliche Überwachung integrieren, erzielen eine zuverlässigere Modellauswahl und bessere Ergebnisse.
Regelmäßige, adaptive Testabläufe decken Fehler vor der Implementierung auf, wodurch die anfänglichen Evaluierungskosten im Vergleich zu den Risiken eines fehlerhaften Systems gering sind. Für Entwicklungsteams sind robuste Validierungsschritte mehr als nur Entwicklungsaufgaben ; sie sind unerlässliche Sicherheitsvorkehrungen für das Unternehmen.
Im Jahr 2026 und darüber hinaus werden Teams, die ihre Bewertungsmethoden verfeinern, die Zuverlässigkeit ihrer LLMs gewährleisten, kostspielige Fehler vermeiden und das Vertrauen der Benutzer aufrechterhalten.


 BONUS: Holen Sie sich unsere 200 $“AI „Mastery Toolkit“ KOSTENLOS bei der Anmeldung!