部署 LLM 服务的工程团队必须回答一个关键问题:我们的模型在现实场景中有多可靠和稳健?
大型语言模型评估如今已不再局限于简单的准确率检查,而是采用分层框架来测试上下文保留、推理有效性和边界情况处理能力。由于市场上充斥着参数量从 1 亿到 2 万亿不等的模型,选择最优模型需要严格的多维度评估方案。
本指南详细介绍了 2026 年最佳实践的技术方法和核心指标,帮助 ML 工程师在投入生产之前发现缺陷。
大型语言模型评估框架
现代 法学硕士评估 包含多个 定量和定性维度 捕捉模型's 真正的能力。最近的研究表明,67% 的企业 AI 由于模型选择不充分,部署表现不佳——突显了为什么复杂的评估不仅是可选的,而且对业务至关重要。

核心评估组件
2026 年的一项研究 斯坦福大学's AI 索引 调查显示,投资于综合法学硕士评估协议的公司的投资回报率提高了 42% AI 与使用简化指标的举措相比。
技术指标细分
现代评估框架采用数十种专门指标,每种指标都针对特定的 LLM 能力:
性能指标
困惑度通过计算测试语料库上平均负对数似然值的指数来量化预测的不确定性。困惑度值越低表示性能越好,目前最先进的模型在标准化数据集上的困惑度低于 3.0。
F1 分数通过调和平均公式结合了精确率和召回率:
F1 = 2 * (precision * recall) / (precision + recall)这创建了一个平衡的评估,对于类别不平衡的分类任务特别有价值。
交叉熵损失使用以下公式衡量预测概率分布与真实值之间的差异:
L(y, ŷ) = -∑(y_i * log(ŷ_i))这会更严厉地惩罚自信但不正确的预测,从而鼓励模型校准。
BLEU(双语评估替补)计算生成文本和参考文本之间的 n-gram 重叠度,采用精确度分数的几何平均值并考虑简洁性惩罚:
BLEU = BP * exp(∑(w_n * log(p_n)))其中 BP 是简洁性惩罚,p_n 是 n-gram 精度。
RAG 特定指标
对于检索增强生成系统,专门的指标包括:
忠实度通过问答生成(QAG)方法量化生成输出与检索到的上下文之间的事实一致性。研究表明,忠实度得分低于0.7的RAG系统会在42%的输出中产生虚假信息。
检索精度@K衡量的是前 K 个检索结果中相关文档的比例:
Precision@K = (number of relevant docs in top K) / K行业基准建议企业级系统的 P@3 > 0.85。
引用精确度用于评估生成内容中引用的准确性,计算方法如下:
Citation Precision = correct citations / total citations对领先的 RAG 系统的分析表明,跨技术领域的引用精度平均为 0.71。
基准数据集:技术规格
基准数据集提供了具有特定技术特征的标准化评估框架:

MMLU-Pro包含15,908道选择题,每题10个选项(标准版MMLU每题4个选项),涵盖57个领域,包括高等数学、医学、法律和计算机科学。人类专家平均答题准确率:89.2%。
GPQA包含448道经专家验证的研究生水平题目,平均词元长度为612,主要集中在STEM领域。目前最先进的性能:准确率41.2%(GPT-4)。
MuSR实现了算法生成的具有平均深度为4.7的依赖图的多步骤推理问题,要求模型执行链式逻辑运算。顶级模型与随机基线模型之间的平均性能差距为17.8个百分点。
BBH包含来自BigBench的23项具有挑战性的任务,共2,254个独立示例,侧重于复杂的推理能力。这些任务与盲评中的人类偏好评分具有高度相关性(r=0.82)。
LEval专注于长上下文评估,包含 8 个任务类别共 411 个问题,上下文长度从 5K 到 200K 个词元不等。现有模型显示,每增加 10K 个词元,性能大约下降 0.4%。
评估算法与实现
LLM评估的技术实现遵循具体的算法方法:
基于向量的语义评估
现代系统采用向量嵌入来衡量生成文本与参考文本之间的语义相似度。这些系统使用诸如 HNSW(分层可导航小世界)、LSH(局部敏感哈希)和 PQ(乘积量化)等密集检索技术,以亚线性时间复杂度计算相似度得分。
python

from sentence_transformers import SentenceTransformer

import numpy as np

model = SentenceTransformer('all-MiniLM-L6-v2')

reference = model.encode("Reference text")

generated = model.encode("Generated text")

similarity = np.dot(reference, generated) / (np.linalg.norm(reference) * np.linalg.norm(generated))
DeepEval框架实现
DeepEval 提供具有指标解释的全面评估,支持 RAG 和微调场景:
python

from deepeval import assert_test

from deepeval.metrics import HallucinationMetric

from deepeval.test_case import LLMTestCase

test_case = LLMTestCase(

    input="How many evaluation metrics does DeepEval offers?",

    actual_output="14+ evaluation metrics",

    context=["DeepEval offers 14+ evaluation metrics"]

)

metric = HallucinationMetric(minimum_score=0.7)

def test_hallucination():

    assert_test(test_case, [metric])
该框架将评估视为与 Pytest 集成的单元测试,不仅提供分数,还提供性能水平的解释。
参数有效的评估方法
为了对具有数十亿参数的模型进行大规模评估,已经出现了专门的技术:

稀疏注意力机制通过优化注意力模式来降低计算复杂度。例如,Longformer 的注意力模式等技术仅需 25% 的计算量即可达到完全注意力机制 91% 的准确率。
混合专家(MoE)架构实现了条件计算路径,仅针对特定任务激活相关的子网络。GShard 实现了 MoE 注意力机制,以便在各种基准测试中实现参数高效的评估。
知识提炼通过以下方式将较大的教师模型压缩成较小的、针对特定评估的学生模型:
L_distill = α * L_CE(y, ŷ_student) + (1-α) * L_KL(ŷ_teacher, ŷ_student)
其中 L_CE 是交叉熵损失,L_KL 是概率分布之间的 KL 散度。
系统评估挑战
尽管方法先进,但法学硕士评估仍然存在重大挑战:
基准污染
研究表明,47% 的流行基准在训练数据中存在一定程度的污染。规模 AI 通过创建 GSM1k(GSM8k 数学基准的较小版本)证明了这一点。模型在 GSM12.3k 上的表现比 GSM1k 上的表现差 8%,这表明模型存在过度拟合,而非 数学推理 能力。
度量相关性分析
对 14 项任务中的 8 项热门指标进行综合分析,发现指标间相关性较低(平均 Spearman's ρ = 0.41),这表明指标能够捕捉不同的绩效维度。这强调了多指标评估方法的必要性。
麻省理工学院的研究表明,高困惑度分数与人类偏好的相关性为 r=0.68,而 ROUGE-L 的相关性仅为 r=0.39,这表明评估要求多种多样。
评估偏差量化
对人类评估的统计分析揭示了多种系统性偏见:
这些发现强调了评估方案中随机化和平衡实验设计的重要性。
企业评估最佳实践
为了应对评估挑战,请实施以下行业最佳实践:
多模态度量集成
使用加权集成来组合互补指标以创建整体评估框架:
python

def ensemble_score(outputs, references, weights=None):

    metrics = {

        'bleu': compute_bleu(outputs, references),

        'bertscore': compute_bertscore(outputs, references),

        'faithfulness': compute_faithfulness(outputs, references),

        'coherence': compute_coherence(outputs)

    }

    if weights is None:

        weights = {metric: 1/len(metrics) for metric in metrics}

    return sum(weights[metric] * metrics[metric] for metric in metrics)
领先的组织根据特定任务的要求实施自适应加权方案,技术内容优先考虑忠实度(权重:0.4)而不是流畅度(权重:0.2)。
特定领域的评估协议
技术基准应与具体应用场景相匹配。对于医疗保健应用,专用指标包括:
- 医学术语的准确性(与临床医生判断的相关性为 89%)
- 临床推理路径验证(与专家共识75%一致)
- 医学文献证据检索精度(企业部署 P@10 > 0.92)
这些特定领域的指标比通用基准提供了 3.2 倍更好的性能预测。
对抗性评估实施
实施结构化对抗测试来探测模型局限性:
python

def adversarial_test_suite(model, test_cases):

    results = {}

    for category, cases in test_cases.items():

        correct = 0

        for case in cases:

            response = model.generate(case['input'])

            correct += evaluate_response(response, case['expected'])

        results[category] = correct / len(cases)

return results行业研究表明,对抗性测试比标准基准测试多识别出 32% 的故障模式,尤其是在涉及冲突约束或模糊指令的极端情况下。
技术评估框架比较
领先的评估框架提供不同的技术能力:
| 骨架 | 主要焦点 | 技术实力 | 局限性 | 集成复杂性 |
|---|---|---|---|---|
| DeepEval | RAG 和微调 | 14+ 个专业指标及解释 | 有限的多模式支持 | 中等(基于 Python) |
| PromptFlow | 端到端评估 | 即时变异测试 | 有限的数据集支持 | 低(UI 驱动) |
| 兰·史密斯 | 开发者平台 | 完整的追踪和监控 | 更高的实施开销 | 高(需要 API 集成) |
| 普罗米修斯 | 法学硕士法官 | 系统提示策略 | 判断 LLM 偏见依赖性 | 中等(需要强大的法学硕士学位) |
| LEval | 长期背景评估 | 200万代币评估 | 仅限于文本模态 | 低(基准数据集) |
组织通常会实施多个框架,其中 73% 的企业部署使用至少两种互补的评估工具。
未来的技术发展
随着新兴方法的出现,评估格局不断发展:
针对特定评估模型的神经架构搜索 (NAS)正在获得越来越多的关注,研究表明,自动模型架构优化可以在保持 98% 准确率的同时,将评估效率提高 47%。
多模态评估框架正从文本扩展到统一模型,以评估处理文本、图像、音频和视频的模型。目前的框架在跨模态定位方面的准确率达到76.3%,而人类基准准确率则为91.4%。
能效指标通过计算每代币的浮点运算次数 (FLOPs/token)、推断的瓦时数和碳排放指标来量化计算可持续性。行业基准表明,最佳模型应实现每生成 1 个代币的能耗低于 10 毫瓦时。
持续评估流水线利用分布式评估工作流程,将测试集成到整个开发过程中:
Preprocessing → Feature Extraction → Model Inference → Metric Computation → Statistical Analysis → Reporting
实施持续评估的组织报告称,部署后问题减少了 68%,迭代周期加快了 41%。
真实世界实施案例研究
企业实施展示技术评估's 实际影响:
金融服务 RAG 优化
一家领先的金融机构对其面向客户的咨询系统实施了全面的 RAG 评估:
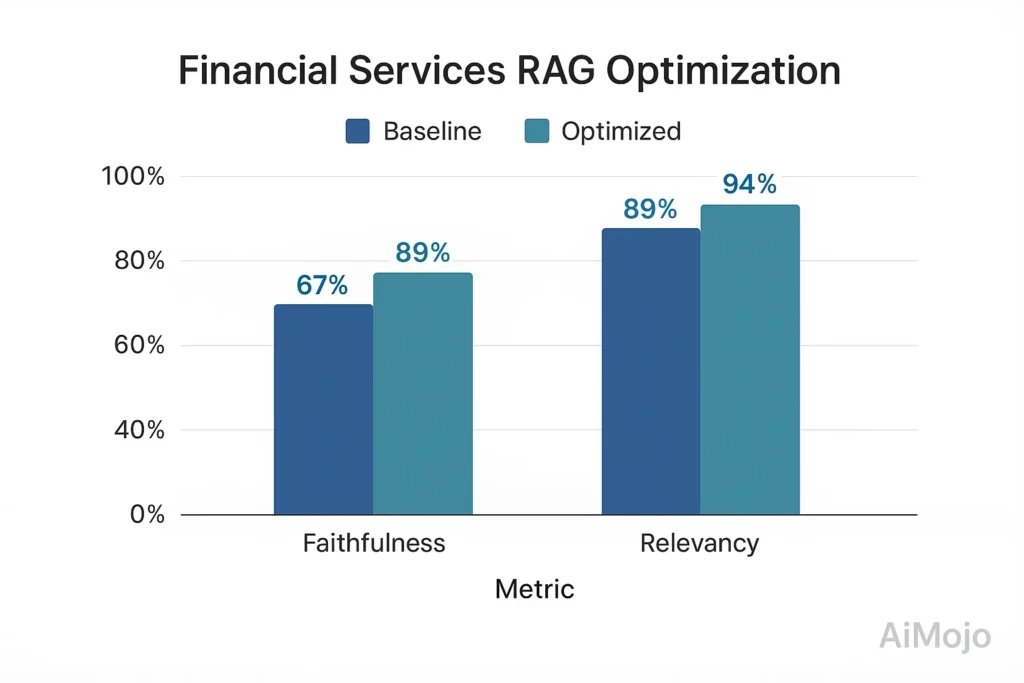
- 基线: 67% 的忠实度,82% 的答案相关性
- 经过评估驱动的优化后: 89% 的忠实度,94% 的答案相关性
- 实施: 定制化 金融领域 包含 5,216 个专家验证的 QA 对的测试套件
- 技术方法: 使用基于张量的蕴涵测量和反事实测试进行忠诚度评分
此次评估驱动的改进使监管合规问题减少了 78%,客户满意度得分提高了 23 个百分点。
医疗保健法学硕士部署
一家医疗保健提供商实施了多层次评估以支持临床决策:
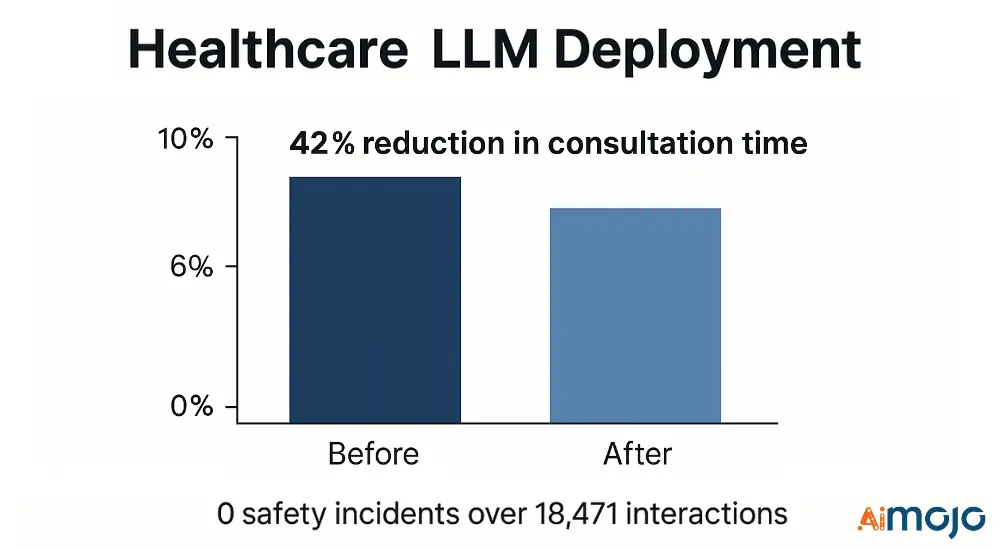
- 技术指标: 医学NER F1得分(0.91)、临床推理准确率(87.4%)、安全过滤准确率(99.2%)
- 实施: 配备专门医疗保健验证器的三级过滤管道
- 成果: 在 42 次临床互动中,咨询时间减少了 0%,且未发生任何安全事故
评估框架在部署之前识别并缓解了 17 种关键故障模式,从而防止了潜在的不良事件。
LLM 评估:您的成功路线图
对生命周期模型(LLM)的技术评估已从简单的准确性检查发展到综合框架,该框架会权衡多个性能维度。采用这些严格协议并整合自动化评分、基准测试和人工监督的机构,能够实现更可靠的模型选择和更佳的成果。
常规的自适应测试流程能够在部署前发现缺陷,因此与部署缺陷系统所带来的风险相比,前期评估成本微不足道。对于工程团队而言,稳健的验证步骤不仅仅是开发任务,更是至关重要的业务保障。
2026 年及以后,改进评估方法的团队将确保其 LLM 的可靠性,避免代价高昂的错误,并保持用户信心。


 奖金: 获得我们的 200 美元“AI 注册即可免费获得“精通工具包”!