การปรับแต่งอย่างรวดเร็วเพียงอย่างเดียวไม่เพียงพอสำหรับองค์กรอีกต่อไป AI ระบบต่างๆ เมื่อหน้าต่างบริบทโมเดลมีจำนวนโทเค็นเกิน 200 โทเค็น วิศวกรจึงรวม LLM เข้ากับเอกสาร ไพพ์ไลน์การดึงข้อมูล แผ่นบันทึก และการเรียกใช้เครื่องมือ ซึ่งเป็นแนวทางที่ได้รับการยอมรับ วิศวกรรมบริบท.
การเปลี่ยนแปลงเกิดขึ้นอย่างรวดเร็ว
วิศวกรรมบริบทเชื่อมช่องว่างนี้โดยการจัดการทั้งหมด AI สิ่งแวดล้อม เป็นระบบมากกว่าที่จะมุ่งเน้นไปที่อินพุตแต่ละรายการ
วิศวกรรมบริบท:
ระบบที่ใช้งานได้จริง
วิศวกรรมบริบทจะถือว่ากระบวนการทั้งหมดก่อนการเรียก LLM เป็นโครงสร้างพื้นฐานที่ออกแบบได้ ลองนึกถึง LLM's หน้าต่างบริบทเป็น RAM – มีหน่วยความจำในการทำงานที่จำกัดซึ่งกำหนดว่าโมเดลสามารถประมวลผลอะไรได้
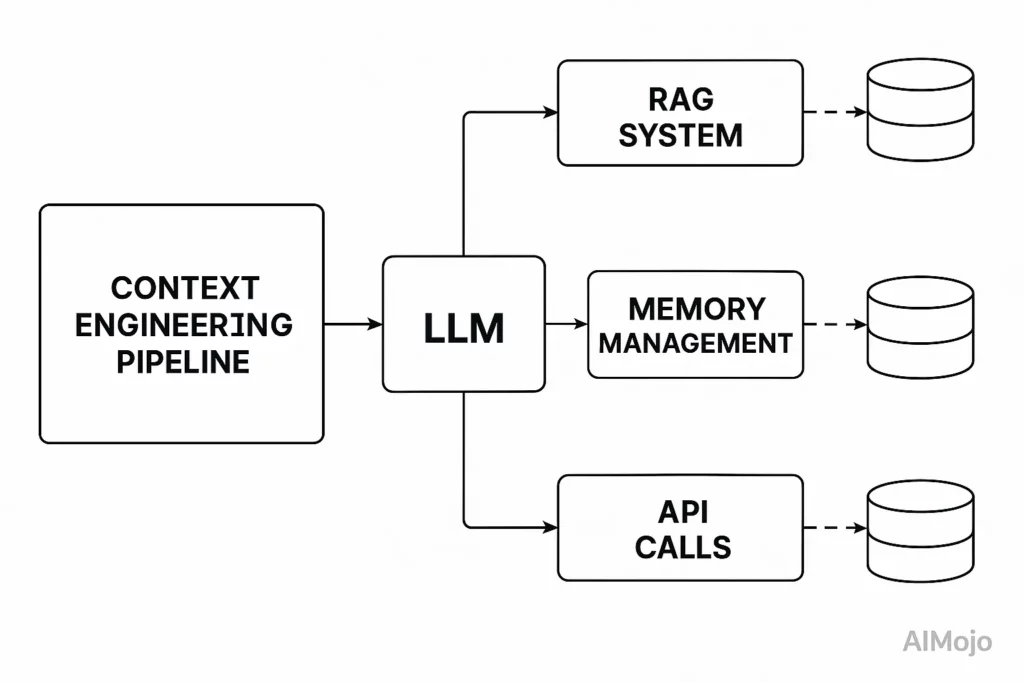
เช่นเดียวกับระบบปฏิบัติการที่จัดการอย่างระมัดระวังว่าอะไรเข้าไปใน RAM วิศวกรรมบริบทจะดูแลข้อมูลที่จะเติมใน LLM's หน้าต่างบริบท
Here's วิศวกรรมบริบทประกอบด้วยอะไรบ้าง:
วิศวกรรมบริบท เทียบกับ วิศวกรรมเชิงกระตุ้น:
ตัวเลขไม่โกหก
| แง่มุม | พร้อมรับงานวิศวกรรม | วิศวกรรมบริบท |
|---|---|---|
| โฟกัส | การสร้างสตริงอินพุตหนึ่งอัน | การประสานสัญญาณทั้งหมดรอบ ๆ โมเดล |
| เวลาในการพัฒนาโดยเฉลี่ย | ปรับแต่งอย่างรวดเร็ว 70% | ไพพ์ไลน์ข้อมูล 60%, กฎหน่วยความจำ 20%, คำเตือน 20% |
| โหมดความล้มเหลวทั่วไป | คุณภาพเอาต์พุตลดลงอย่างกะทันหันหลังจากข้อมูลดริฟท์ | มีความยืดหยุ่นผ่าน RAG, หน่วยความจำ, การเรียกใช้เครื่องมือ |
ตัวอย่างง่ายๆ : บอทฝ่ายบริการลูกค้าที่ฝึกฝนด้วยข้อความแจ้งเตือนเพียงอย่างเดียว สามารถจดจำนโยบายการคืนเงินได้เมื่อถูกถามโดยตรง แต่เมื่อผู้ใช้กล่าวถึง "คำสั่งซื้อหมายเลข 45791" บอทจะล้มเหลว หากเพิ่มการปรับแต่งบริบท—ประวัติการสนทนาและคำสั่งค้นหา RAG ในฐานข้อมูลคำสั่งซื้อ—บอทจะดึงรายละเอียดการซื้อและแนะนำขั้นตอนการคืนเงินที่ถูกต้องได้ทันที
เสาหลักทั้งสี่ของวิศวกรรมบริบทที่มีความสำคัญจริงๆ
1. การเขียนบริบท (AI ของคุณ's ระบบจดบันทึก)
การเขียนบริบทหมายถึงการบันทึกข้อมูลไว้นอกหน้าต่างบริบทเพื่อใช้ในอนาคต ซึ่งจะช่วยประหยัดพื้นที่โทเค็นอันมีค่าในขณะที่ยังคงเข้าถึงข้อมูลสำคัญได้
แผ่นจดบันทึกชั่วคราวทำงานคล้ายกับการจดบันทึกสำหรับเอเจนต์ภายในเซสชันเดียว นักวิจัยแบบหลายเอเจนต์ของ Anthropic จะบันทึกแผนเริ่มต้นไว้ใน " หน่วยความจำ " เพราะหากบริบทมีโทเค็นเกิน 200,000 โทเค็น แผนจะถูกตัดทอนและสูญหายไป
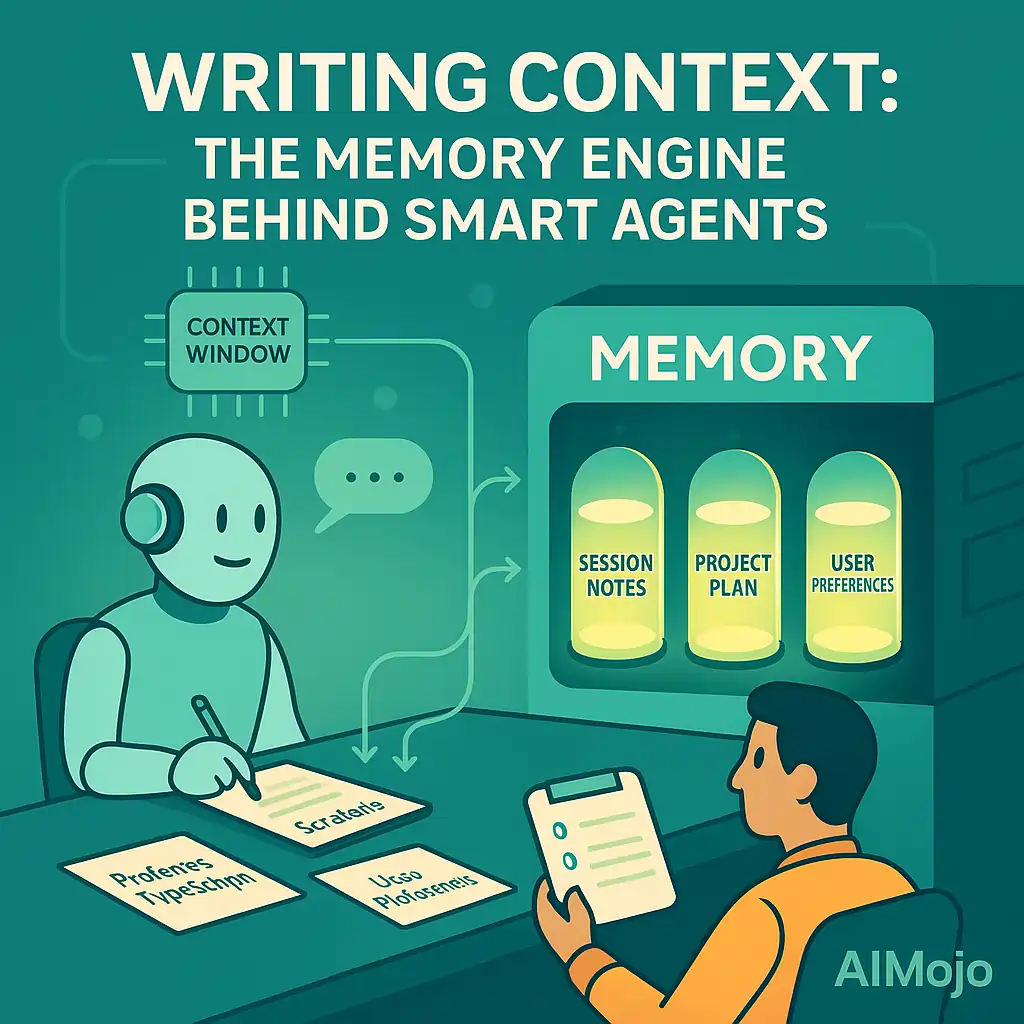
ความทรงจำระยะยาวจะเก็บรักษาข้อมูลไว้ได้ตลอดหลายช่วงเวลา ตัวอย่างเช่น ChatGPT สร้างการตั้งค่าผู้ใช้โดยอัตโนมัติจากบทสนทนา และ Cursor/Windsurf เรียนรู้รูปแบบการเขียนโค้ดและบริบทของโครงการ
2. การเลือกบริบท (ศิลปะแห่งการเลือกสิ่งที่สำคัญ)
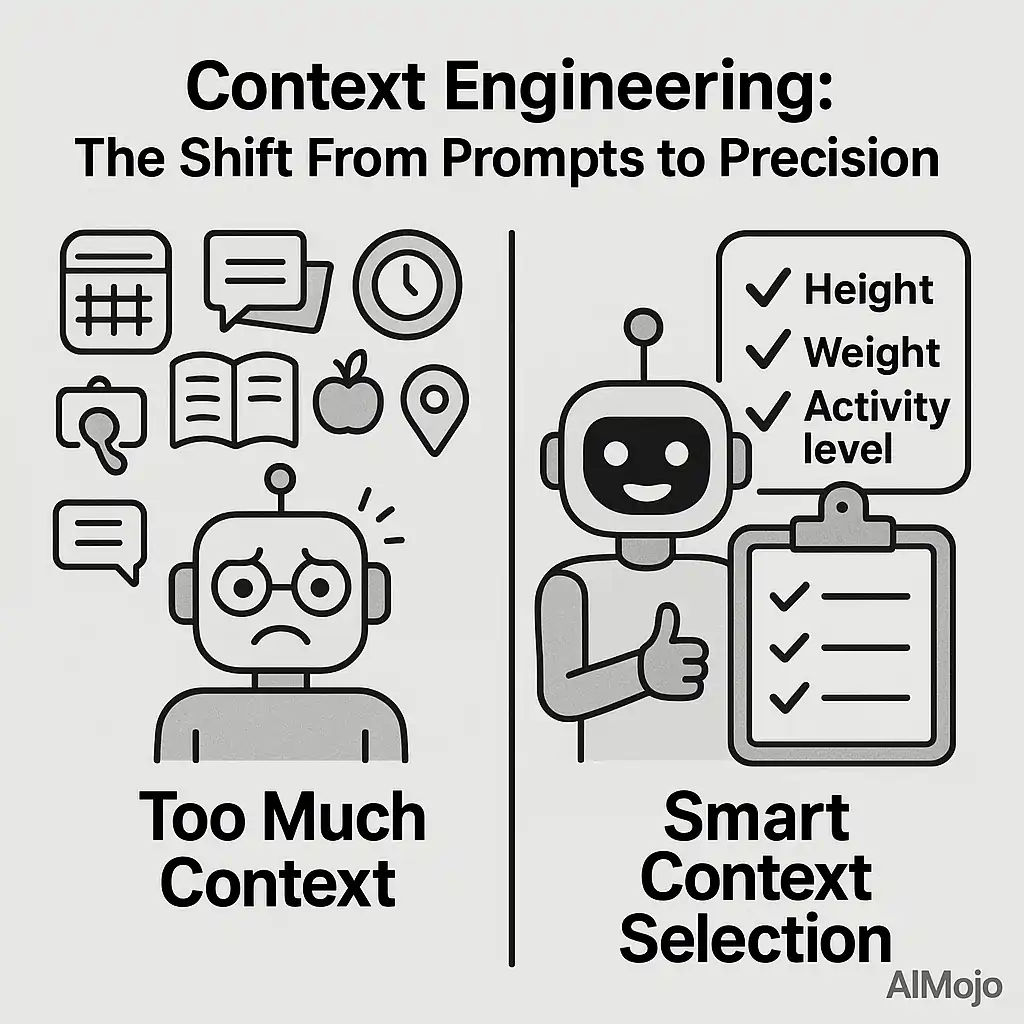
การเลือกบริบทจะนำเฉพาะข้อมูลที่เกี่ยวข้องกับงานที่ทำอยู่เข้ามา
เมื่อ AI โค้ชฟิตเนส สร้างแผนการออกกำลังกาย โดยจะต้องเลือกรายละเอียดบริบทที่รวมถึงผู้ใช้'s ส่วนสูง น้ำหนัก และระดับกิจกรรม ในขณะที่ละเลยข้อมูลที่ไม่เกี่ยวข้อง
ข้อคิดสำคัญ : ข้อมูลที่มากขึ้นไม่ได้หมายความว่าดีเสมอไป การออกแบบบริบทที่มีประสิทธิภาพหมายถึงการเลือกใช้ข้อมูลที่เหมาะสมที่สุดสำหรับแต่ละงาน
3. การบีบอัดบริบท (การปรับให้มากขึ้นเป็นน้อยลง)
เมื่อบทสนทนายาวเกินขีดจำกัด หน่วย ความจำของ LLMการบีบอัดบริบทจึงมีความสำคัญอย่างยิ่ง โดยปกติแล้วเอเจนต์จะทำเช่นนี้โดยการสรุปส่วนต้นๆ ของบทสนทนา

4. การแยกบริบท (แบ่งแยกและพิชิต)
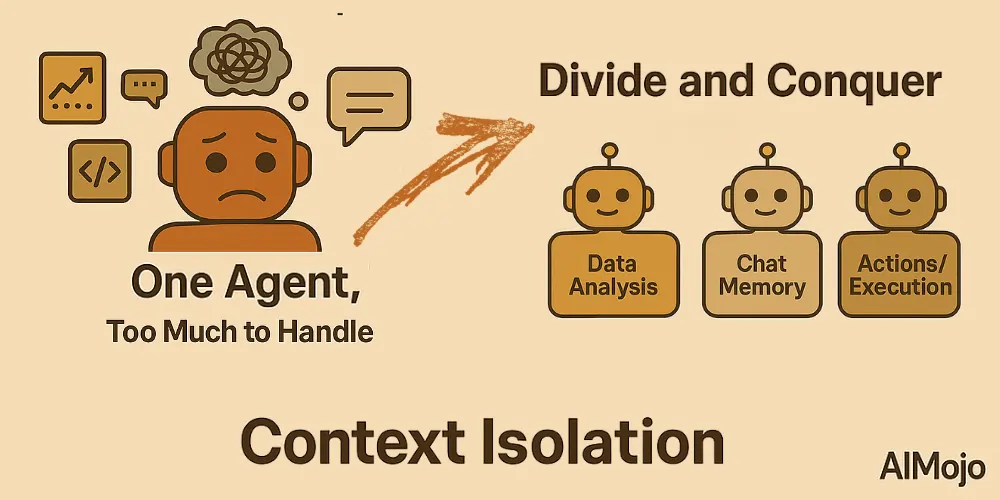
การแยกบริบทหมายถึงการแบ่งข้อมูลออกเป็นส่วนย่อยๆ เพื่อให้เอเจนต์สามารถจัดการกับงานที่ซับซ้อนได้ดียิ่งขึ้น แทนที่จะอัดความรู้ทั้งหมดลงในข้อความแจ้งเตือนขนาดใหญ่เพียงข้อความเดียว นักพัฒนาจะแบ่งบริบทออกเป็นส่วนย่อยๆ ที่มีความเชี่ยวชาญเฉพาะด้าน หรือสภาพแวดล้อมแบบแซนด์บ็อกซ์
วิศวกรรมบริบทในโลกแห่งความเป็นจริงในการปฏิบัติ
การปฏิวัติการบริการลูกค้า
| ก่อนวิศวกรรมบริบท | หลังจากวิศวกรรมบริบท |
|---|---|
| แชทบอททั่วไปที่ลืมบทสนทนาก่อนหน้าและให้คำตอบที่ไม่เกี่ยวข้อง | AI ตัวแทนที่จดจำประวัติการซื้อของคุณ เข้าถึงข้อมูลสต๊อกแบบเรียลไทม์ และประสานงานกับตัวแทนเมื่อจำเป็น |
ผู้ช่วยการเขียนโค้ดที่ไม่เคยลืม
ระบบ : เมื่อคุณถามว่า “ฉันจะแก้ไขข้อผิดพลาดในการตรวจสอบสิทธิ์นี้ได้อย่างไร?” ระบบวิศวกรรมบริบทจะดำเนินการโดยอัตโนมัติ:

แทนที่จะได้รับคำแนะนำการเขียนโค้ดแบบทั่วๆ ไป คุณจะได้รับโซลูชันเฉพาะที่ปรับให้เหมาะกับฐานโค้ดจริงของคุณ
สถาปัตยกรรมทางเทคนิคที่ขับเคลื่อนวิศวกรรมบริบท
การประกอบบริบทแบบไดนามิก
บริบทถูกสร้างขึ้นแบบทันทีทันใด โดยจะพัฒนาไปตามความคืบหน้าของการสนทนา ซึ่งรวมถึง:
- การดึงเอกสารที่เกี่ยวข้อง
- การรักษาความจำ
- การอัปเดตสถานะผู้ใช้
- การเรียก API และการสอบถามฐานข้อมูล
การจัดการหน้าต่างบริบท
ด้วยข้อจำกัดขนาดโทเค็น คงที่ (32K, 100K, 1M) วิศวกรต้องบีบอัดและจัดลำดับความสำคัญของข้อมูลอย่างชาญฉลาดโดยใช้:
- ฟังก์ชันการให้คะแนน (TF-IDF, การฝัง, ฮิวริสติกความสนใจ)
- การสรุปและการสกัดความโดดเด่น
- กลยุทธ์การแบ่งกลุ่มและการปรับแต่งแบบทับซ้อน
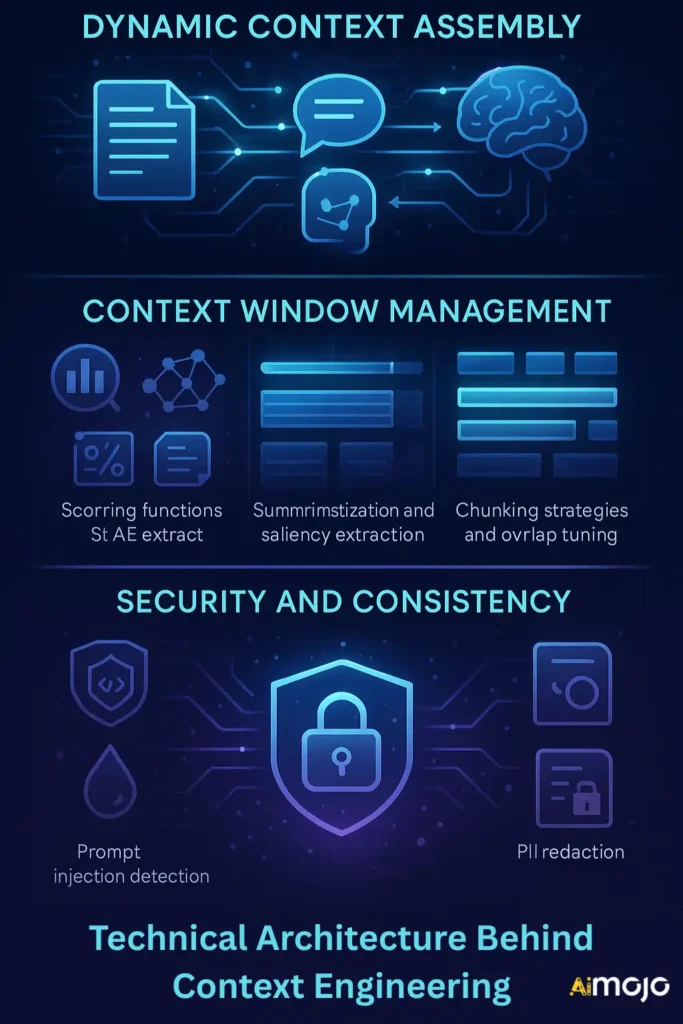
ความปลอดภัยและความสม่ำเสมอ
นำหลักการต่างๆ มาใช้ เช่น การตรวจจับการแทรกข้อความโดยทันทีการทำให้บริบทสะอาดการปกปิดข้อมูลส่วน บุคคล และการควบคุมการเข้าถึงบริบทตามบทบาท
การสร้างระบบวิศวกรรมบริบทแรกของคุณ
การสร้างเวิร์กโฟลว์ทางวิศวกรรมบริบทไม่ใช่แค่ทฤษฎีเท่านั้น's กระบวนการที่ทำซ้ำได้ ซึ่งสามารถนำไปปฏิบัติจริงหรือแม้กระทั่งแบบอัตโนมัติได้ นี่คือวิธีที่คุณสามารถนำไปปฏิบัติได้:
ขั้นตอนที่ 1: จัดทำแผนที่แหล่งที่มาของบริบทของคุณ
ระบุว่าตัวแทนของคุณต้องดึงข้อมูลจากที่ใด (เอกสาร ฐานข้อมูล API แชทก่อนหน้า ฯลฯ)
หลาม
# Example: Fetching relevant documents using embeddings
from sentence_transformers import SentenceTransformer, util

model = SentenceTransformer("all-MiniLM-L6-v2")
query = "project status update"
corpus = ["spec doc", "requirements", "last week's meeting notes"]

query_embedding = model.encode(query, convert_to_tensor=True)
corpus_embeddings = model.encode(corpus, convert_to_tensor=True)
hits = util.semantic_search(query_embedding, corpus_embeddings, top_k=2)[0]
relevant_docs = [corpus[hit['corpus_id']] for hit in hits]
ขั้นตอนที่ 2: การนำหน่วยความจำและบริบทการเขียนไปใช้
จัดเก็บข้อมูลที่สำคัญเพื่อให้พร้อมใช้งานเสมอสำหรับงานในอนาคต
หลาม
import json

def save_to_memory(memory_path, user_id, data):
    with open(memory_path, "r+") as file:
        memory = json.load(file)
        memory[user_id] = data
        file.seek(0)
        json.dump(memory, file)
        file.truncate()
ขั้นตอนที่ 3: สร้างการเลือกบริบทและตรรกะการบีบอัด
พัฒนากฎหรือแบบจำลองที่เลือกเฉพาะสิ่งที่เกี่ยวข้องกับงานมากที่สุด ย่อประวัติที่ยาวเหยียดให้อยู่ในรูปแบบสรุป
หลาม
def summarize_conversation(history):
    # Placeholder for use with an LLM summarizer or custom rules
    return history[-5:]  # Only the last 5 messages
ขั้นตอนที่ 4: แยกบริบทสำหรับการประสานงานตัวแทน
แบ่งข้อมูลออกเพื่อให้แต่ละตัวแทนหรือส่วนประกอบจัดการเฉพาะสิ่งที่ควรจัดการเท่านั้น
หลาม
user_profile_ctx = {"user_goals": "..."}
task_specific_ctx = {"current_task": "..."}
external_data_ctx = {"live_data": "..."}
full_context = {**user_profile_ctx, **task_specific_ctx, **external_data_ctx}
ขั้นตอนที่ 5: การจัดโครงสร้างเอาต์พุตและความพร้อมของ API
จัดรูปแบบบริบทเอาท์พุตให้สอดคล้องกันเพื่อให้'s คาดเดาได้สำหรับการเรียก LLM ดาวน์สตรีมหรือจุดสิ้นสุด API
หลาม
schema = {
    "user": {"age": 35, "goal": "muscle gain"},
    "plan": "high protein, 3x/week weight training"
}
ขั้นตอนที่ 6: ตรวจสอบ ทำซ้ำ และรักษาความปลอดภัย
ติดตามความล้มเหลว ตรวจสอบคุณภาพบริบท และปรับปรุงตรรกะสำหรับการรวมบริบท หน่วยความจำ และการดึงข้อมูล หมั่นทำความสะอาดอินพุตอยู่เสมอเพื่อหลีกเลี่ยงการแทรกข้อมูลทันทีและการรั่วไหลของข้อมูล
เหตุใดวิศวกรรมบริบทจึงให้ผลตอบแทนมากกว่าวิศวกรรมแบบเร่งด่วน
บริษัทต่างๆ จำเป็นต้องมีวิศวกรที่สามารถสร้างระบบที่ให้บริบทที่เหมาะสมแก่ AI รักษาข้อมูลให้ถูกต้องและเป็นปัจจุบัน และปกป้องผู้ใช้ด้วยการเพิ่มแนวทางด้านความปลอดภัย
ความเป็นจริงของตลาด : การออกแบบบริบทต้องอาศัยทักษะข้ามสายงาน ซึ่งรวมถึงการทำความเข้าใจกรณีการใช้งานทางธุรกิจ การกำหนดผลลัพธ์ และการจัดโครงสร้างข้อมูล เพื่อให้ LLM สามารถทำงานที่ซับซ้อนให้สำเร็จได้
สรุปคือใครๆ ก็เขียนข้อความแจ้งเตือนได้ แต่การสร้างเอเจนต์ที่รับรู้บริบท จดจำ ปรับตัว และเลือกบริบทได้อย่างมีประสิทธิภาพในวงกว้างต่างหาก คือวิธีที่นักพัฒนาจะเตรียมความพร้อมสำหรับอนาคตและส่งมอบมูลค่าที่แท้จริงด้วยแอปพลิเคชัน LLM ขั้นสูง


 โบนัส: รับ $200 ของเรา”AI Mastery Toolkit” ฟรีเมื่อคุณสมัคร!