
Nyfiken på att bygga, finjustera eller driftsätta stora språkmodeller?
Du är inte ensam – juridikexpertis är en av de hetaste färdigheterna inom AI i dag. Med projekt med öppen källkod GitHub växer snabbt och har blivit den självklara platsen för topprankade LLM-projekt, ramverk och forskning.
Den här guiden lyfter fram 12 viktiga GitHub-repositorier fyllda med källkod, praktiska handledningar och modellimplementeringar.
Få beprövade kunskaper inom juridik , accelerera ditt lärande och gå med i den globala gemenskap som formar framtiden för artificiell intelligens – allt med dessa GitHub-arkiv du absolut måste känna till.
Varför GitHub Är avgörande för LLM-utveckling
GitHub har blivit det pulserande hjärtat i LLM-ekosystemet, där banbrytande forskning möter praktisk implementering. Medan akademiska artiklar tillhandahåller teori, levererar GitHub själva koden som driver dagens program.'s de mest avancerade språkmodellerna.
Plattformen är värd för allt från Meta's Llama-implementeringar till OpenAI's forskningskodbaser, vilket gör det till det snabbaste sättet att få tillgång till beprövade tekniker och ligga steget före den snabba utvecklingen.
Viktiga anledningar till att GitHub dominerar LLM-utveckling:
För LLM-entusiaster är GitHub inte bara en resurs – den's din direkta linje till framtiden för AI utveckling.
1. llm-kurs
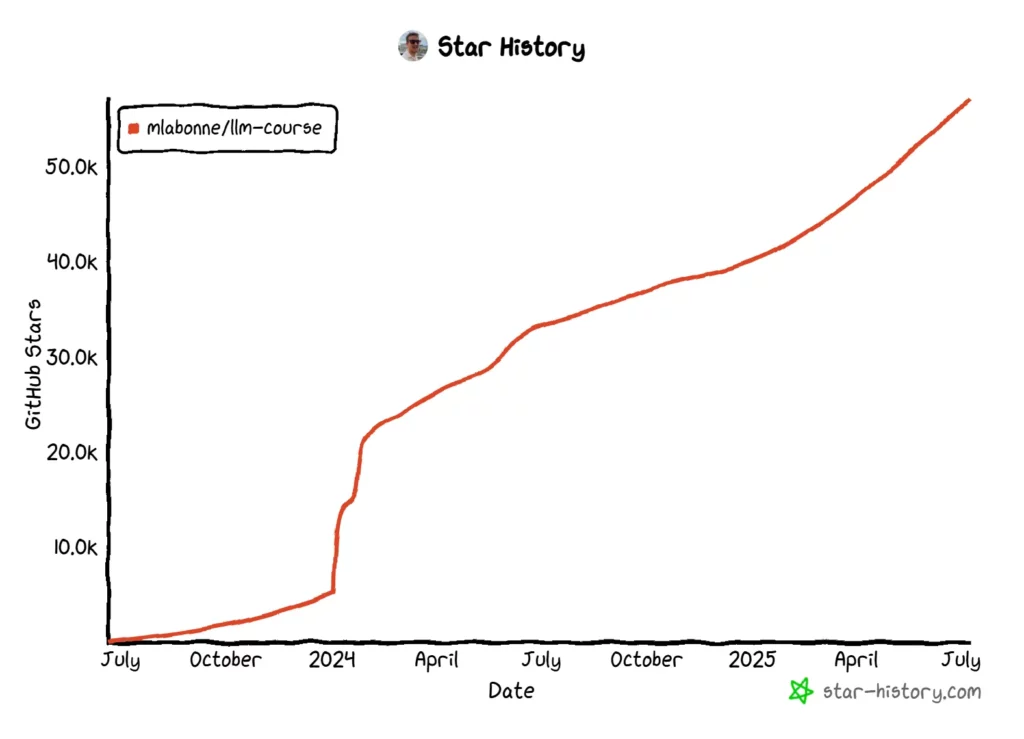
Maxime Labonnes LLM-kurs är en fantastisk utgångspunkt och en omfattande färdplan för alla som är seriösa med att studera LLM . Det är mer än bara en samling filer; det är en strukturerad inlärningsväg som tillgodoser olika karriärmål. Arkivet har vunnit enorm popularitet och kan skryta med över 51 500 stjärnor på GitHub.
Varför den's ett toppval
Detta arkiv utmärker sig eftersom det erbjuder två distinkta färdplaner, vilket gör att du kan skräddarsy din inlärningsresa:
Kursen täcker allt från grunderna i juridikmatematik till avancerade ämnen som kvantisering, finjustering och modellimplementering. Det är ett komplett paket för elever på alla nivåer.
VIKTIGA FUNKTIONER
Vem ska använda det?
Detta arkiv är perfekt för både nybörjare som behöver en strukturerad introduktion och erfarna yrkesverksamma som vill fördjupa sin expertis inom specifika områden inom LLM-utveckling.
2. HandsOnLLM
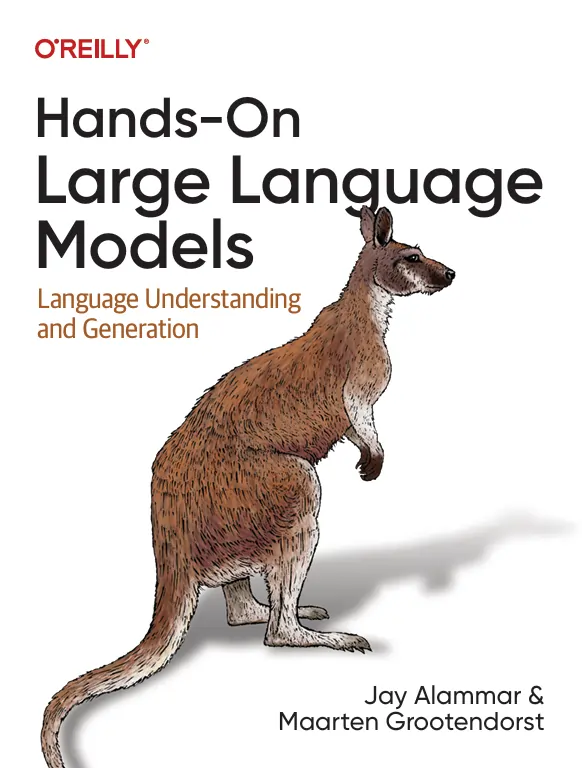
HandsOnLLM/Hands-On-Large-Language-Models-arkivet är den officiella följeslagaren till O'Reilly-boken med samma namn. Det är en visuellt rik och praktisk guide som avmystifierar hur LLM:er fungerar. Om du lär dig bäst genom att göra och uppskattar väl dokumenterade kodexempel, är det här arkivet för dig.
Varför den's ett toppval
Den erbjuder en praktisk, projektbaserad inlärningsmetod. Varje kapitel i boken åtföljs av Jupyter-anteckningsböcker, så att du kan följa med och experimentera med koden själv. Den fokuserar på verkliga projekt och exempel som du kan anpassa för dina egna användningsfall.
VIKTIGA FUNKTIONER
Vem ska använda det?
Utvecklare och dataforskare som föredrar en praktisk, projektbaserad inlärningsstil kommer att tycka att den här databasen är otroligt värdefull. Det är också en utmärkt resurs för alla som läser boken "Hands-on Large Language Models".
3. prompt-teknik
Guiden brexhq/prompt-engineering är en guldgruva för att bemästra konsten och vetenskapen bakom prompt engineering . I juridikexperternas värld bestäms kvaliteten på din produktion ofta av kvaliteten på din input, vilket gör denna färdighet absolut nödvändig. Denna arkivsamling, med nästan 9 000 stjärnor, erbjuder praktiska tips och strategier för att arbeta med modeller som GPT-4.
Varför den's ett toppval
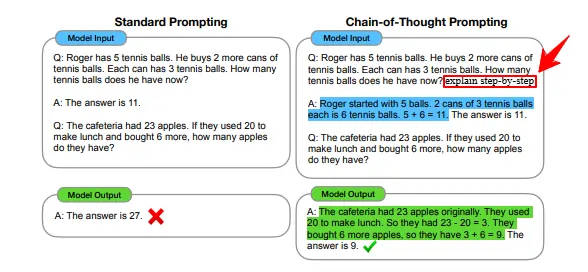
Den konsoliderar lärdomar från att skapa prompter för produktionsanvändningsfall, vilket gör den mycket praktisk. Arkivet är välorganiserat i handledningar som täcker allt från grundläggande principer till avancerade tekniker som Chain of Thought (CoT) prompter och självkonsekvens.
VIKTIGA FUNKTIONER
Vem ska använda det?
Alla som interagerar med juridikspecialister, från utvecklare och forskare till innehållsskapare och marknadsförare, kommer att dra nytta av detta arkiv. Att behärska prompt engineering är en viktig färdighet för att få ut det mesta av alla språkmodeller.
4. Fantastiskt-LLM
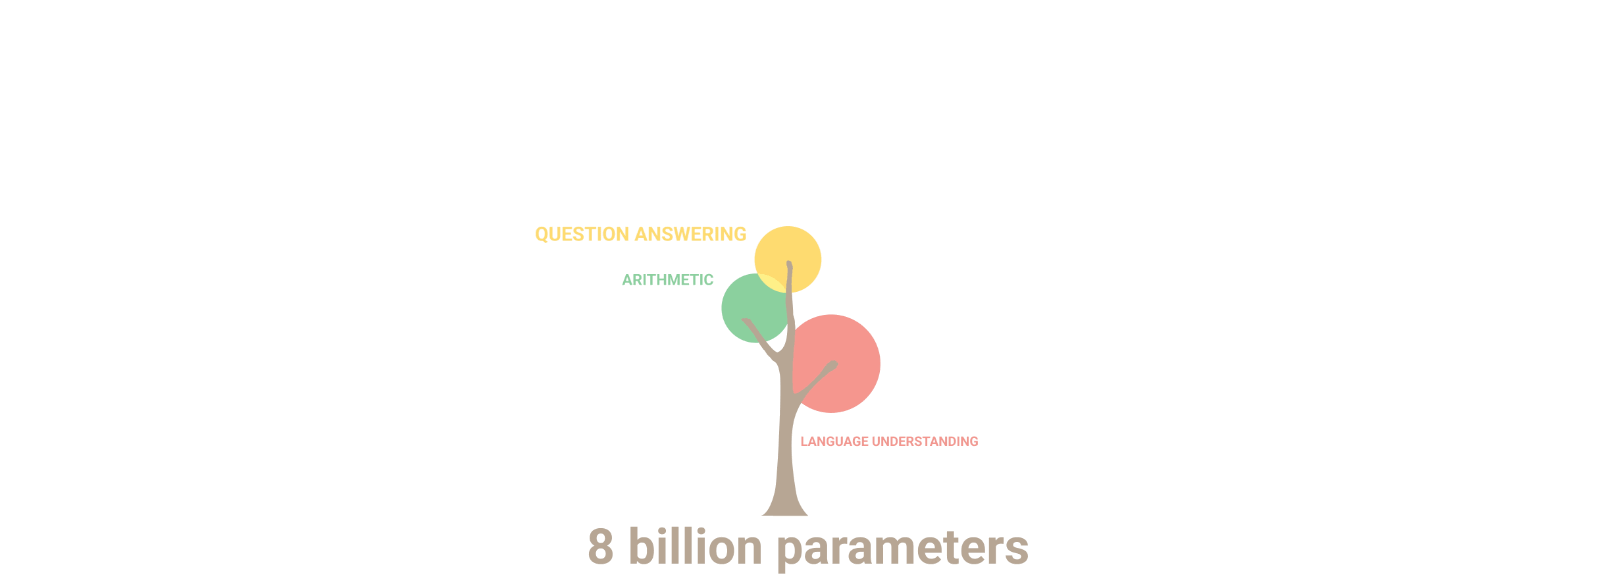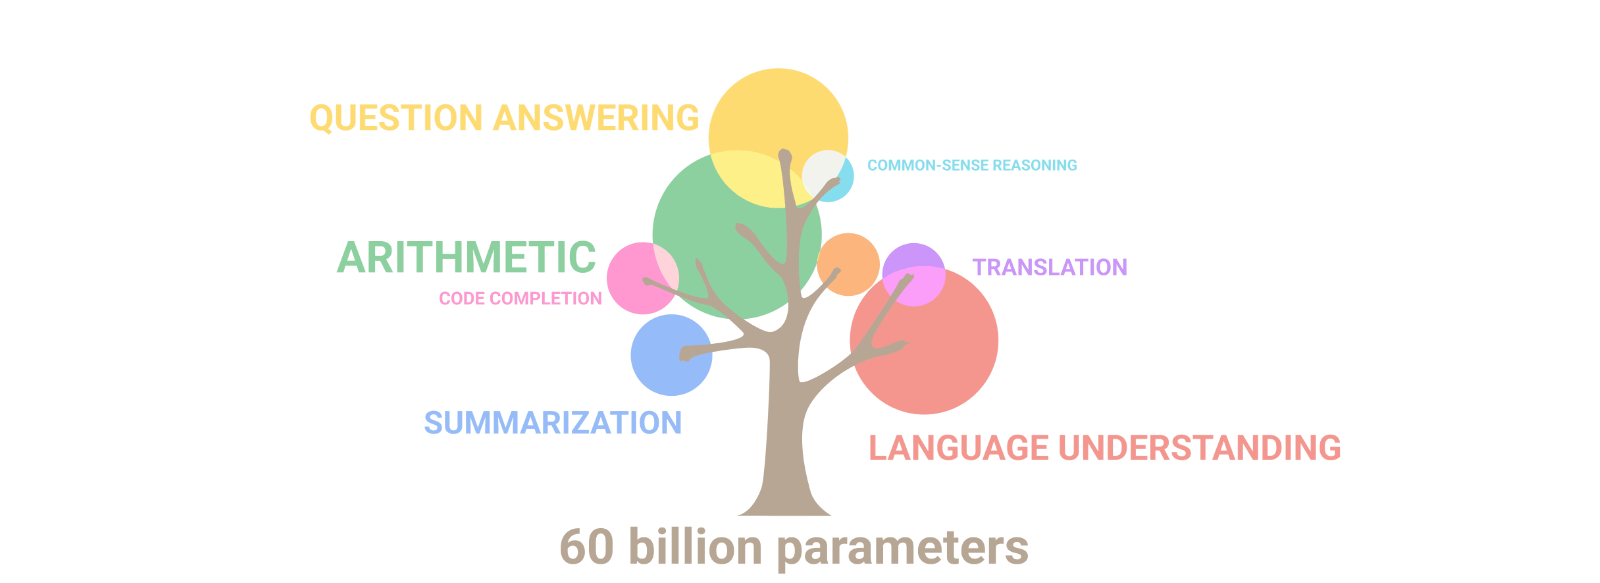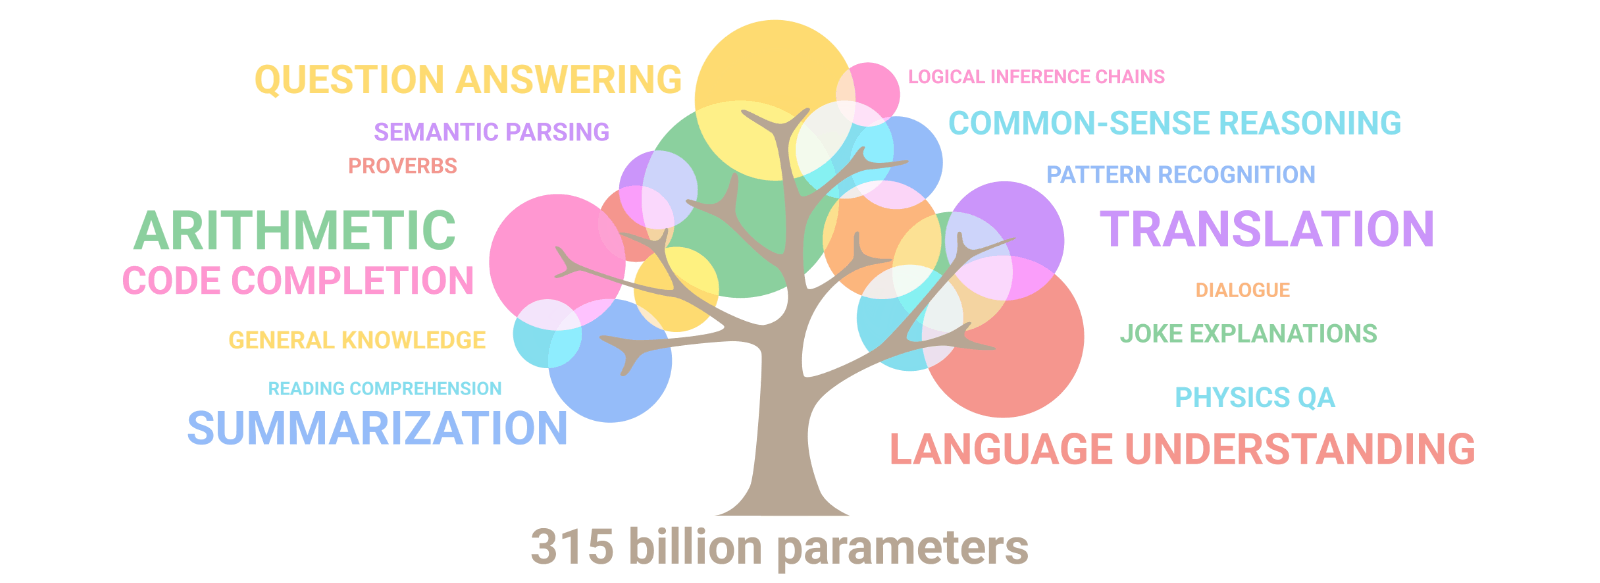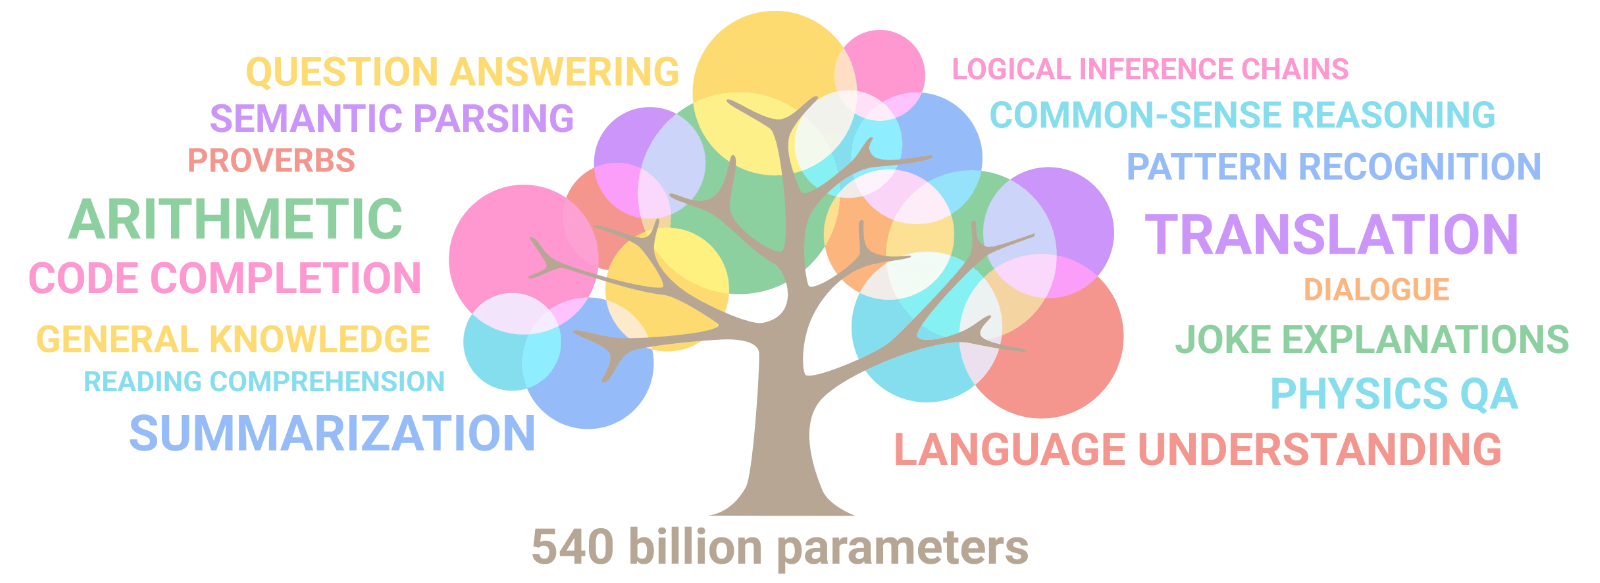
Hannibal046/Awesome-LLM-arkivet är en kurerad lista över allt som rör stora språkmodeller. Tänk på det som din centrala instrumentpanel för att hålla dig uppdaterad om LLM-ekosystemet. Det är en levande samling resurser som regelbundet uppdateras av communityn.
Varför den's ett toppval
Detta arkiv sparar dig otaliga timmar av sökande genom att samla viktiga resurser på ett ställe. Det inkluderar banbrytande forskningsrapporter, utbildningsramverk, implementeringsverktyg och utvärderingsriktmärken. Det har till och med en topplista för att spåra resultatet av olika LLM-program.
VIKTIGA FUNKTIONER
Vem ska använda det?
Detta är ett måste för forskare, studenter och yrkesverksamma som vill ha en enda kontaktpunkt för högkvalitativa resurser inom juridik. Det är perfekt för att upptäcka nya verktyg och hålla sig informerad om den senaste forskningen.
5. Verktygsbänk
I takt med att LLM:er blir mer agentinriktade blir deras förmåga att använda externa verktyg allt viktigare. OpenBMB/ToolBench-arkivet är en öppen källkodsplattform utformad för att utbilda, hantera och utvärdera LLM:er för verktygsinlärning. Det tillhandahåller ett ramverk och en storskalig instruktionsjusteringsdatauppsättning för att förbättra dessa funktioner.
Varför den's ett toppval
ToolBench fokuserar på ett kritiskt och trendigt område inom LLM-utveckling: verktygsanvändning. StableToolBench-tillägget förbättrar detta ytterligare genom att introducera funktioner som MirrorAPI , som simulerar tusentals verkliga API:er , och ett virtuellt API-system för att säkerställa stabilitet och konsekvens under utvärdering.

VIKTIGA FUNKTIONER
Vem ska använda det?
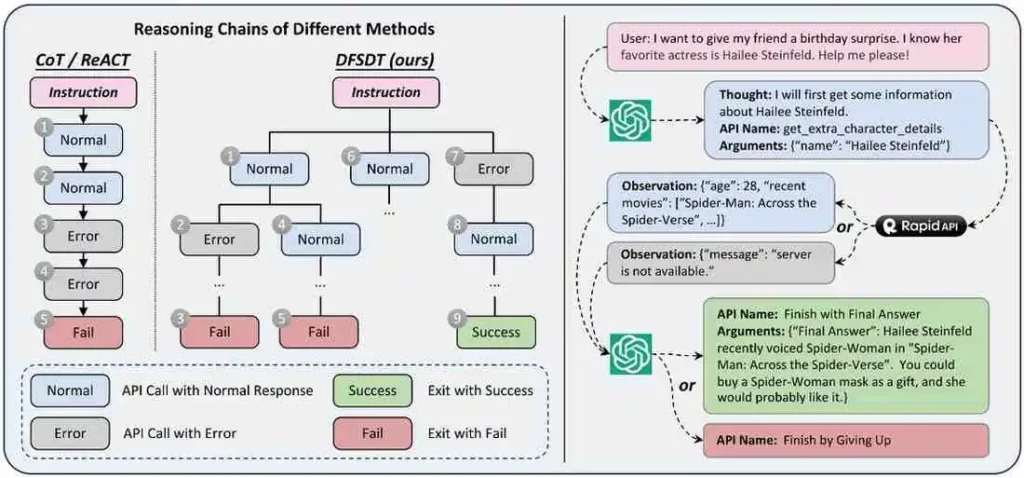
Forskare och utvecklare intresserade av att bygga agentiska LLM:er som kan interagera med externa API:er och verktyg kommer att tycka att ToolBench är ovärderligt. Det är idealiskt för de som arbetar med att skapa mer kapabla och autonoma AI medel.
6. Pythia
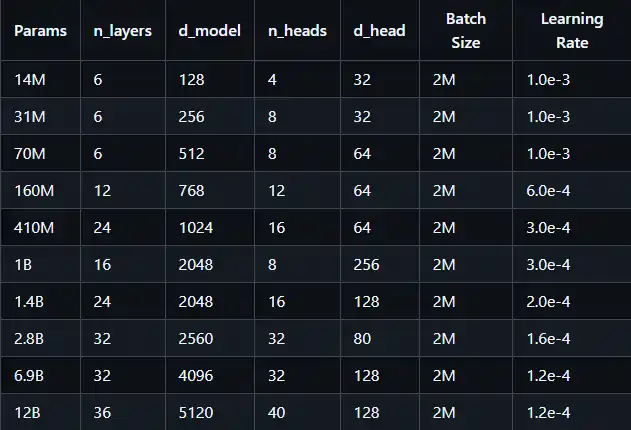
EleutherAI/pythia-arkivet, som utvecklats av EleutherAI, är en uppsättning modeller utformade för att möjliggöra forskning om tolkningsbarhet, inlärningsdynamik och etik. Till skillnad från många andra modellutgåvor skapades Pythia-sviten med transparens och vetenskaplig forskning som sina primära mål.
Varför den's ett toppval
Pythia ger fullständig öppen källkod till 16 olika modellkontrollpunkter, vilket gör det möjligt för forskare att studera hur juridiklärare utvecklas och utvecklas under utbildning. Detta är avgörande för att förstå modellernas "svarta låda"-karaktär och för att undersöka områden som skalningslagar och modellens etik.
VIKTIGA FUNKTIONER
Vem ska använda det?
AI Forskare, etiker och studenter som fokuserar på modellers tolkningsbarhet, säkerhet och de grundläggande principerna för juridikutbildning kommer att få mycket nytta av detta arkiv.
7. LLM-Agent-Paper-Lista
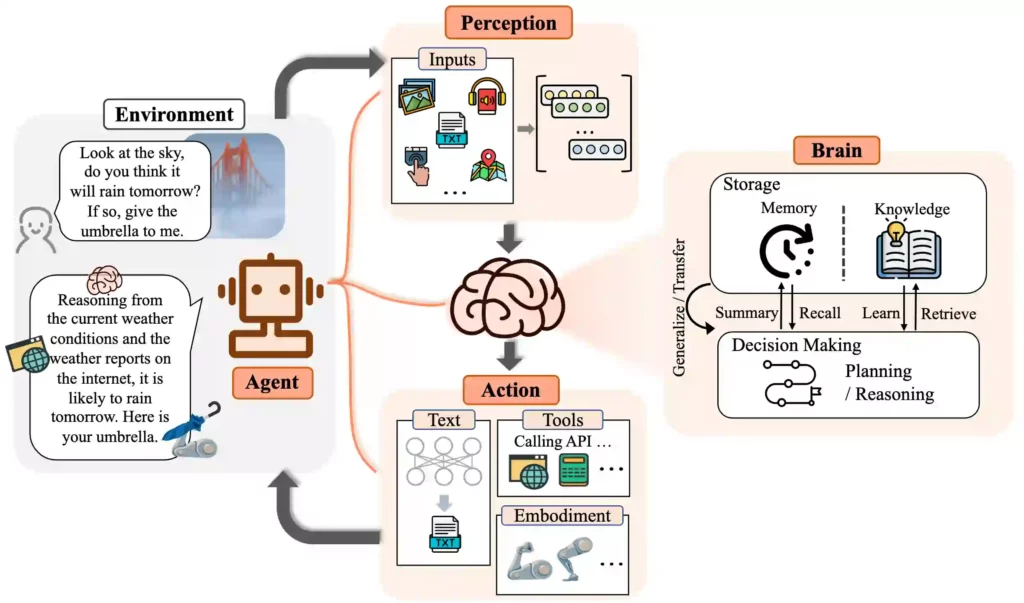
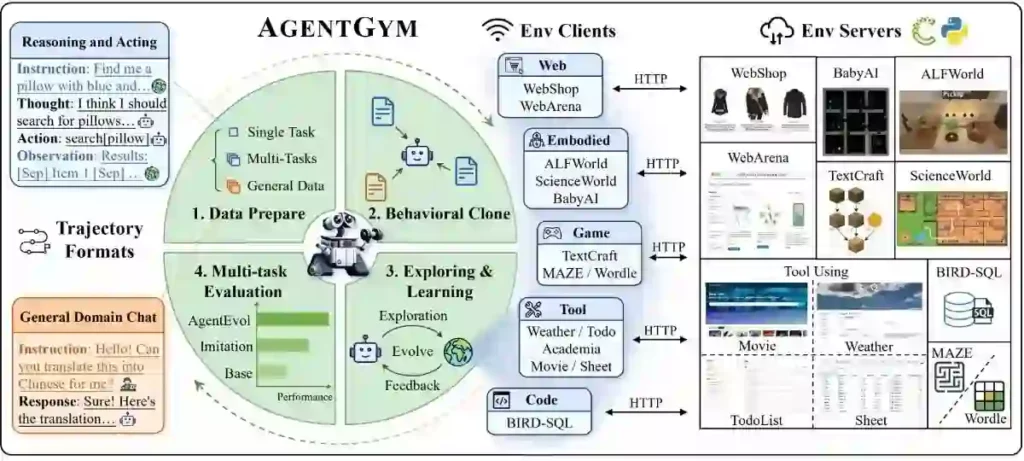
För dig som vill fördjupa dig i den akademiska sidan av AI medel, är WooooDyy/LLM-Agent-Paper-List en viktig resurs. Denna arkivsamling är en kurerad samling av forskningsartiklar som systematiskt utforskar utveckling, tillämpningar och implementering av LLM-baserade agenter.
Varför den's ett toppval
Det fungerar som ett grundläggande kunskapsbibliotek för ett av de mest spännande områdena inom AI idag. Istället för bara kod ger detta repo den teoretiska grunden du behöver för att förstå och bygga nästa generation av AI medel.
VIKTIGA FUNKTIONER
Vem ska använda det?
Denna samling riktar sig till akademiska forskare, doktorander och avancerade yrkesverksamma som vill bygga vidare på den banbrytande forskningen inom LLM-baserade agenter.
8. Fantastiska multimodala modeller för stora språk
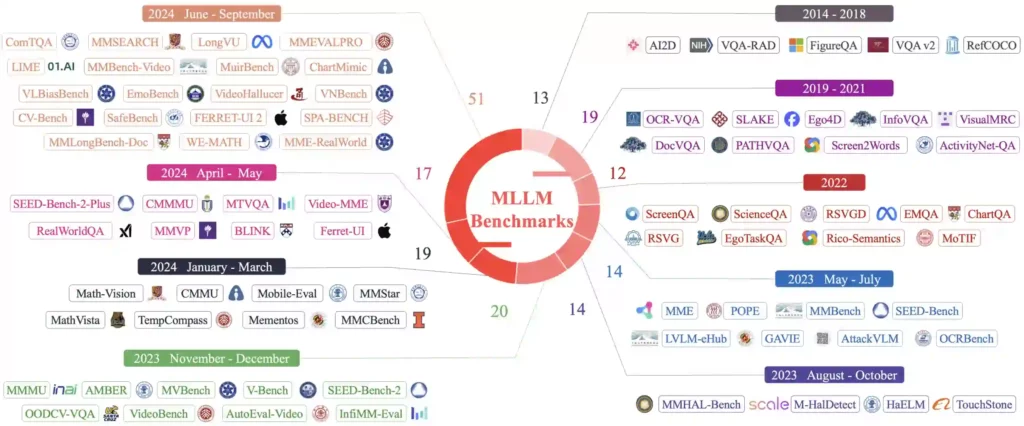
LLM:er är inte längre begränsade till bara text. BradyFU/Awesome-Multimodal-Large-Language-Models-arkivet är en kuraterad samling resurser fokuserade på de senaste framstegen inom multimodala LLM:er (MLLM), som kan bearbeta information från text, bilder, ljud och video.
Varför den's ett toppval
Detta arkiv är din inkörsport till MLLM:ernas värld. Det täcker ett brett spektrum av ämnen, från multimodal instruktionsinställning till tankekedjans resonemang och tekniker för att mildra hallucinationer. Det är också kopplat till VITA-projektet, en interaktiv multimodal LLM-plattform med öppen källkod.
VIKTIGA FUNKTIONER
Vem ska använda det?
Utvecklare och forskare som är intresserade av att bygga applikationer som går bortom text, såsom bildtexter, videoanalys eller röststyrda assistenter, kommer att finna den här samlingen extremt användbar.
9. DeepSpeed
microsoft/DeepSpeed, utvecklat av Microsoft, är ett bibliotek för djupinlärningsoptimering som gör distribuerad träning och inferens enkel och effektiv. Det integreras sömlöst med PyTorch och har varit avgörande för att träna några av världens största modeller, inklusive Megatron-Turing-modellen med 530 miljarder parametrar.
Varför den's ett toppval
DeepSpeed handlar om skalbarhet och effektivitet. Det erbjuder innovationer på systemnivå som gör att du kan träna massiva modeller med miljarder parametrar på begränsad hårdvara. Dess funktioner är viktiga för alla som är seriösa med att träna toppmoderna LLM:er från grunden eller finjustera stora.
VIKTIGA FUNKTIONER
Vem ska använda det?
Detta är ett verktyg för seriösa yrkesverksamma, dataforskare och forskare som behöver träna eller finjustera mycket stora språkmodeller. Om du når minnesgränser med din nuvarande konfiguration är DeepSpeed lösningen.
10. call.cpp
Arkivet ggml-org/llama.cpp är banbrytande för att köra LLM:er på konsumenthårdvara. Det's ett högpresterande C/C++-bibliotek för att köra inferens på lokala maskiner, inklusive stationära datorer och till och med mobila enheter. Det's byggd på GGML-tensorbiblioteket och är känd för sin effektivitet och minimala installation.
Varför den's ett toppval
llama.cpp gör kraftfulla LLM:er tillgängliga för alla. Du behöver inte ett massivt moln-GPU-kluster för att experimentera med modeller som Llama 3 , Mistral eller GPT-2. Dess fokus på CPU- och edge-enhetsprestanda har demokratiserat LLM-användningen. Du kan konfigurera en lokal server med bara några få kommandon och börja interagera med modeller.
VIKTIGA FUNKTIONER
Vem ska använda det?
Utvecklare, hobbyister och forskare som vill driva och experimentera med LLM:er lokalt utan att förlita sig på dyra molntjänster. Det's även perfekt för att bygga på enheten AI tillämpningar som prioriterar integritet och låg latens.
11. PaLM-rlhf-pytorch
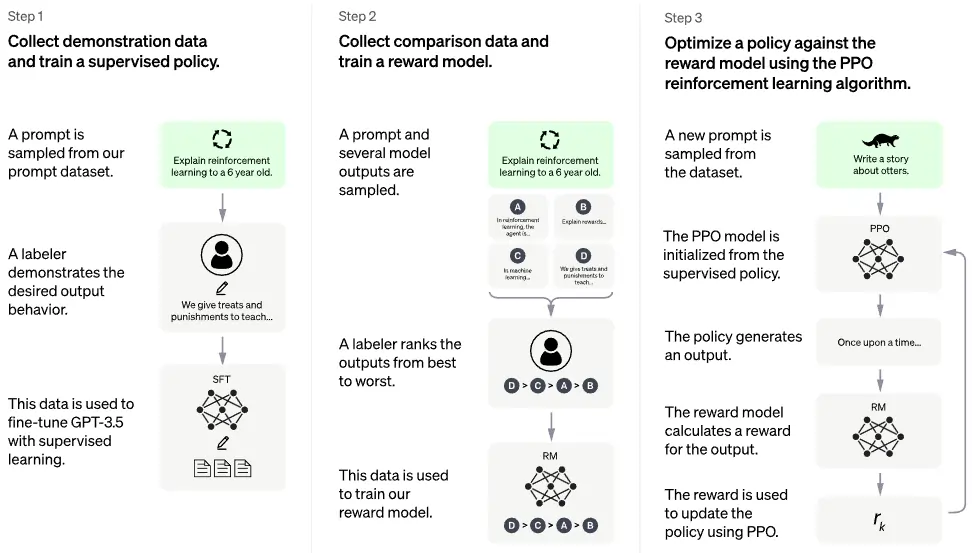
Förstärkande lärande med mänsklig feedback (RLHF) är den hemliga ingrediensen bakom de imponerande konversationsförmågorna hos modeller som ChatGPT. lucidrains/PaLM-rlhf-pytorch-arkivet erbjuder en öppen källkodsimplementering av RLHF tillämpad på Google.'s PaLM-arkitektur.
Varför den's ett toppval
Detta arkiv avmystifierar en av de viktigaste teknikerna inom modern LLM-utveckling. Det syftar till att replikera funktionaliteten hos ChatGPT med hjälp av PaLM-modellen , vilket ger ett konkret exempel på hur RLHF kan implementeras. Du kan läsa in förtränade modeller eller finjustera dem för dina egna behov.
VIKTIGA FUNKTIONER
Vem ska använda det?
Denna arkiv är för forskare och utvecklare som är intresserade av finjusteringsprocessen, särskilt de som vill förstå och implementera RLHF för att anpassa LLM:er till mänskliga preferenser.
12. nanoGPT
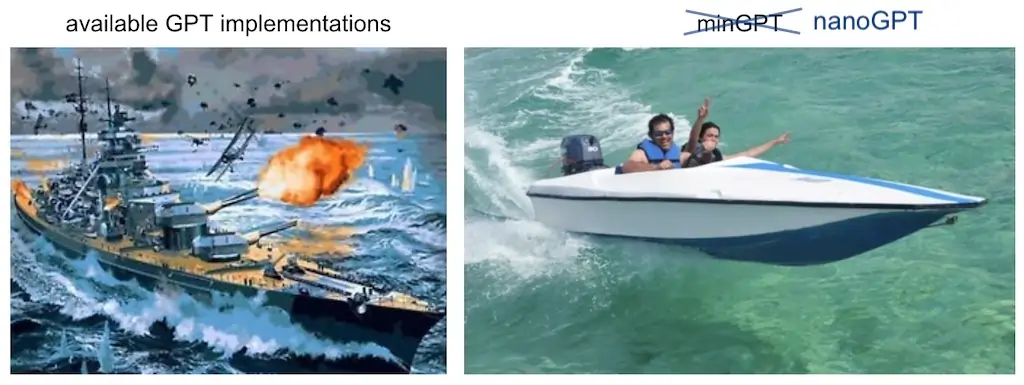
Skapad av den legendariske Andrej Karpathy, är karpathy/nanoGPT det enklaste och snabbaste arkivet för träning och finjustering av medelstora GPT:er. Dess kodbas är avsiktligt koncis, med den centrala träningsloopen i train.py och modelldefinitionen i model.py.
Varför den's ett toppval
nanoGPT prioriterar enkelhet och pedagogiskt värde. Den eliminerar all komplexitet hos stora bibliotek, vilket gör att du kan förstå transformatorarkitekturen från grunden. Trots sin enkelhet...'s tillräckligt kraftfull för att reproducera resultat på GPT-2-nivå och har inspirerat andra minimalistiska projekt som nanoVLM för visionspråksmodeller.
VIKTIGA FUNKTIONER
Vem ska använda det?
nanoGPT är idealiskt för studenter, lärare och utvecklare som vill ha en djupgående och grundläggande förståelse för GPT-arkitekturen. Om du är trött på svarta lådor och vill se hur saker och ting fungerar på riktigt, är detta arkivet för dig.
Dina Juristresa Börjar med dessa viktiga GitHub-arkiv
Skillnaden mellan att drömma om LLM:er och att faktiskt bygga dem? Dessa 12 GitHub-repositorier. Medan andra debatterar teori, har du nu direkt tillgång till koden som driver dagens mest avancerade språkmodeller.
Din konkurrensfördel väntar:
- Klona nanoGPT att förstå transformatorernas grunder
- Gaffel llama.cpp för lokal modelldistribution
- Star llm-kurs för strukturerade inlärningsvägar
- Bidra till DeepSpeed och gå med i Microsoft's optimeringsinsatser
Juristutbildningen rör sig snabbt—utvecklare som behärskar dessa arkiv idag blir imorgon's AI arkitekter. Välj dina tre bästa repositories, konfigurera din utvecklingsmiljö och börja experimentera. Varje commit, varje pull request, varje modell du tränar för dig närmare LLM-behärskning.


 BONUS: Få våra 200 dollarAI ”Mastery Toolkit” GRATIS när du registrerar dig!


