

Ingenjörsteam som driftsätter LLM-tjänster måste besvara en kritisk fråga: hur tillförlitlig och robust är vår modell i verkliga scenarier?
Utvärdering av stora språkmodeller går nu bortom enkla noggrannhetskontroller och använder skiktade ramverk för att testa kontextretention, resonemangsvaliditet och hantering av kantfall. Med marknaden översvämmad av modeller som sträcker sig från 1B till 2T-parametrar kräver valet av den optimala modellen rigorösa, flerdimensionella bedömningsprotokoll.
Den här guiden beskriver de tekniska metoder och kärnvärden som formar bästa praxis år 2026, och hjälper ML-ingenjörer att upptäcka brister innan de når produktion.
Ramverk för utvärdering av stora språkmodeller
Modern Konst LLM utvärdering innehåller flera kvantitativa och kvalitativa dimensioner att fånga en modell's verkliga förmågor. Ny forskning visar att 67 % av företagen AI Implementeringar presterar undermåligt på grund av otillräckligt modellval – vilket belyser varför sofistikerad utvärdering inte bara är valfri utan affärskritisk.

Kärnkomponenter i utvärderingen
En studie från 2026 Stanford's AI index visar att företag som investerar i omfattande LLM-utvärderingsprotokoll ser 42 % högre ROI på sina AI initiativ jämfört med de som använder förenklade mätvärden.
Teknisk mätvärdesfördelning
Moderna utvärderingsramverk använder dussintals specialiserade mätvärden, som var och en riktar sig mot specifika LLM-förmågor:
Prestandamätningar
Perplexitet kvantifierar prediktionsosäkerheten genom att beräkna exponentialen för genomsnittlig negativ log-likelihood över en testkorpus. Lägre värden indikerar bättre prestanda, där toppmoderna modeller uppnår perplexitet under 3.0 på standardiserade datamängder.
F1-poäng kombinerar precision och återkallelse genom formeln för harmonisk medelvärde:
F1 = 2 * (precision * recall) / (precision + recall)Detta skapar en balanserad bedömning som är särskilt värdefull för klassificeringsuppgifter med obalans i klassen.
Korsentropiförlust mäter skillnaden mellan förutspådda sannolikhetsfördelningar och grundsanning med hjälp av formeln:
L(y, ŷ) = -∑(y_i * log(ŷ_i))Detta bestraffar säkra men felaktiga förutsägelser hårdare, vilket uppmuntrar modellkalibrering.
BLEU (Bilingual Evaluation Understudy) beräknar n-gram-överlappning mellan genererade texter och referenstexter med hjälp av ett geometriskt medelvärde av precisionspoäng med en korthetsstraff:
BLEU = BP * exp(∑(w_n * log(p_n)))Där BP är korthetsstraff och p_n är n-gram precision.
RAG-specifika mätvärden
För Retrieval Augmented Generation-system inkluderar specialiserade mätvärden:
Trovärdighet kvantifierar faktamässig konsistens mellan genererad utdata och hämtad kontext med hjälp av QAG-metoder (Question-Answer Generation). Forskning visar att RAG-system med trovärdighetspoäng under 0.7 producerar hallucinationer i 42 % av utdata.
Retrieval Precision@K mäter andelen relevanta dokument bland de mest hämtade resultaten i K:
Precision@K = (number of relevant docs in top K) / KBranschreferenstester tyder på att P@3 > 0.85 är för företagssystem.
Citeringsprecision utvärderar noggrannheten hos citat i genererat innehåll, beräknat som:
Citation Precision = correct citations / total citationsAnalys av ledande RAG-system visar en citeringsprecision på i genomsnitt 0.71 över tekniska områden.
Benchmarkdataset: Tekniska specifikationer
Benchmark-dataset tillhandahåller standardiserade utvärderingsramverk med specifika tekniska egenskaper:

MMLU-Pro har 15 908 flervalsfrågor med 10 alternativ per fråga (jämfört med 4 i standard-MMLU), som täcker 57 områden inklusive avancerad matematik, medicin, juridik och datavetenskap. Genomsnittlig expertprestation: 89.2 %.
GPQA innehåller 448 expertverifierade frågor på avancerad nivå med en genomsnittlig tokenlängd på 612, med fokus på STEM-områden. Nuvarande SOTA-prestanda: 41.2 % noggrannhet (GPT-4).
MuSR implementerar algoritmiskt genererade flerstegsproblem med beroendegrafer med ett genomsnittligt djup på 4.7, vilket kräver att modeller utför kedjiga logiska operationer. Genomsnittligt prestandaskillnad mellan toppmodeller och slumpmässig baslinje: 17.8 procentenheter.
BBH består av 23 utmanande uppgifter från BigBench med 2 254 individuella exempel fokuserade på komplext resonemang . Dessa uppgifter visar hög korrelation (r=0.82) med mänskliga preferenser i blinda utvärderingar.
LEval specialiserar sig på utvärdering av långa kontexter med 411 frågor fördelade på 8 uppgiftskategorier med kontextlängder från 5 000 till 200 000 tokens. Nuvarande modeller visar en prestandaförsämring på cirka 0.4 % per 10 000 ytterligare tokens.
Utvärderingsalgoritmer och implementering
Den tekniska implementeringen av LLM-utvärdering följer specifika algoritmiska metoder:
Vektorbaserad semantisk utvärdering
Moderna system använder vektorinbäddningar för att mäta semantisk likhet mellan genererade texter och referenstexter. Med hjälp av täta hämtningstekniker som HNSW (Hierarchical Navigable Small World), LSH (Locality-Sensitive Hashing) och PQ (Product Quantization) beräknar dessa system likhetspoäng med sublinjär tidskomplexitet.
python

from sentence_transformers import SentenceTransformer

import numpy as np

model = SentenceTransformer('all-MiniLM-L6-v2')

reference = model.encode("Reference text")

generated = model.encode("Generated text")

similarity = np.dot(reference, generated) / (np.linalg.norm(reference) * np.linalg.norm(generated))
Implementering av DeepEval-ramverket
DeepEval tillhandahåller omfattande utvärdering med metriska förklaringar, och stöder både RAG och finjusteringsscenarier:
python

from deepeval import assert_test

from deepeval.metrics import HallucinationMetric

from deepeval.test_case import LLMTestCase

test_case = LLMTestCase(

    input="How many evaluation metrics does DeepEval offers?",

    actual_output="14+ evaluation metrics",

    context=["DeepEval offers 14+ evaluation metrics"]

)

metric = HallucinationMetric(minimum_score=0.7)

def test_hallucination():

    assert_test(test_case, [metric])
Detta ramverk behandlar utvärderingar som enhetstester med Pytest-integration, och ger inte bara poäng utan även förklaringar till prestandanivåer.
Parametereffektiva utvärderingsmetoder
För storskalig utvärdering av modeller med miljarder parametrar har specialiserade tekniker framkommit:

Mekanismer för gles uppmärksamhet minskar beräkningskomplexiteten genom optimering av uppmärksamhetsmönster. Tekniker som Longformers uppmärksamhetsmönster visar 91 % noggrannhet vid full uppmärksamhet med endast 25 % av beräkningen.
Arkitekturer med blandade experter (MoE) implementerar villkorliga beräkningsvägar och aktiverar endast relevanta delnätverk för specifika uppgifter. GShard implementerar MoE-uppmärksamhet för parametereffektiv utvärdering över olika riktmärken.
Kunskapsdestillation komprimerar större lärarmodeller till mindre, utvärderingsspecifika elevmodeller med hjälp av:
L_distill = α * L_CE(y, ŷ_student) + (1-α) * L_KL(ŷ_teacher, ŷ_student)
Där L_CE är korsentropiförlust och L_KL är KL-divergens mellan sannolikhetsfördelningar.
Utmaningar vid systematisk utvärdering
Trots avancerade metoder kvarstår betydande utmaningar vid utvärdering av juridikstudier:
Riktmärkesförorening
Studier visar att 47 % av populära riktmärken har någon grad av kontaminering i träningsdata. AI demonstrerade detta genom att skapa GSM1k, en mindre variant av GSM8k:s matematiska riktmärke. Modellerna presterade 12.3 % sämre på GSM1k än på GSM8k, vilket indikerar överanpassning snarare än matematiska resonemang förmåga.
Metrisk korrelationsanalys
Omfattande analys av 14 populära mätvärden över 8 uppgifter visar låg korrelation mellan mätvärden (genomsnittlig Spearman's ρ = 0.41), vilket indikerar att mätvärden fångar olika prestationsdimensioner. Detta understryker behovet av utvärderingsmetoder med flera mätvärden.
Forskning från MIT visar att höga förvirringspoäng korrelerar med mänskliga preferenser vid r=0.68, medan ROUGE-L endast korrelerar vid r=0.39, vilket indikerar olika bedömningskrav.
Kvantifiering av utvärderingsbiaser
Statistisk analys av mänskliga utvärderingar avslöjar flera systematiska biaser:
Dessa resultat belyser vikten av randomisering och balanserad experimentell design i utvärderingsprotokoll.
Bästa praxis för företagsutvärdering
För att hantera utvärderingsutmaningar, implementera dessa bästa praxis i branschen:
Multimodal metrisk integration
Kombinera kompletterande mätvärden med hjälp av viktade ensembler för att skapa holistiska utvärderingsramverk:
python

def ensemble_score(outputs, references, weights=None):

    metrics = {

        'bleu': compute_bleu(outputs, references),

        'bertscore': compute_bertscore(outputs, references),

        'faithfulness': compute_faithfulness(outputs, references),

        'coherence': compute_coherence(outputs)

    }

    if weights is None:

        weights = {metric: 1/len(metrics) for metric in metrics}

    return sum(weights[metric] * metrics[metric] for metric in metrics)
Ledande organisationer implementerar adaptiva viktningssystem baserade på uppgiftsspecifika krav, där tekniskt innehåll prioriterar korrekthet (vikt: 0.4) framför flyt (vikt: 0.2).
Domänspecifika utvärderingsprotokoll
Tekniska riktmärken bör anpassas till specifika användningsfall. För hälso- och sjukvårdstillämpningar inkluderar specialiserade mätvärden:
- Noggrannhet i medicinsk terminologi (89 % korrelation med läkares bedömning)
- Validering av kliniskt resonemang (75 % överensstämmelse med expertkonsensus)
- Precision vid evidenshämtning från medicinsk litteratur (P@10 > 0.92 för företagsimplementering)
Dessa domänspecifika mätvärden ger 3.2 gånger bättre prestandaprognoser än generiska riktmärken.
Implementering av kontradiktorisk utvärdering
Implementera strukturerad kontradiktorisk testning för att undersöka modellens begränsningar:
python

def adversarial_test_suite(model, test_cases):

    results = {}

    for category, cases in test_cases.items():

        correct = 0

        for case in cases:

            response = model.generate(case['input'])

            correct += evaluate_response(response, case['expected'])

        results[category] = correct / len(cases)

    return results
Branschundersökningar visar att kontradiktorisk testning identifierar 32 % fler fellägen än standard benchmarking, särskilt i kantfall som involverar motstridiga begränsningar eller tvetydiga instruktioner.
Jämförelse av teknisk utvärderingsramverk
Ledande utvärderingsramverk erbjuder olika tekniska funktioner:
| Ramverk | Primärt fokus | Teknisk styrka | Begränsning | Integrationskomplexitet |
|---|---|---|---|---|
| DeepEval | RAG & Finjustering | 14+ specialiserade mätvärden med förklaringar | Begränsat multimodalt stöd | Medium (Python-baserat) |
| PromptFlow | Utvärdering från början till slut | Snabb variationstestning | Begränsat stöd för dataset | Låg (gränssnittsdriven) |
| LangSmith | Utvecklarplattform | Fullständig spårning och övervakning | Högre implementeringsomkostnader | Hög (kräver API-integration) |
| Prometheus | Jur.kand. som domare | Systematiska uppmaningsstrategier | Domare LLM-beroende | Medel (kräver kraftfull juridikexamen) |
| LEval | Långkontextbedömning | 200K tokenutvärdering | Begränsad till textmodalitet | Låg (referensdataset) |
Organisationer implementerar vanligtvis flera ramverk, där 73 % av företagsimplementeringarna använder minst två kompletterande utvärderingsverktyg.
Framtida teknisk utveckling
Utvärderingslandskapet fortsätter att utvecklas med nya metoder:
Neural Architecture Search (NAS) för utvärderingsspecifika modeller blir alltmer populärt, och forskning visar att automatiserad optimering av modellarkitektur kan förbättra utvärderingseffektiviteten med 47 % samtidigt som 98 % noggrannhet bibehålls.
Multimodala bedömningsramverk expanderar bortom text för att utvärdera enhetliga modeller som bearbetar text , bilder, ljud och video. Nuvarande ramverk uppnår en tvärmodal grundnoggrannhet på 76.3 % jämfört med mänskliga baslinjer på 91.4 %.
Energieffektivitetsmått kvantifierar beräkningsmässig hållbarhet med hjälp av FLOP:er/token, inferens från wattimmar och koldioxidutsläppsmått. Branschriktmärken tyder på att optimala modeller bör uppnå <10 mWh per 1 000 genererade tokens.
Kontinuerliga utvärderingsrörledningar integrerar testning genom hela utvecklingen med hjälp av distribuerade utvärderingsarbetsflöden:
Preprocessing → Feature Extraction → Model Inference → Metric Computation → Statistical Analysis → Reporting
Organisationer som implementerar kontinuerlig utvärdering rapporterar 68 % färre problem efter driftsättning och 41 % snabbare iterationscykler.
Fallstudier av implementering i verkligheten
Företagsimplementeringar demonstrerar teknisk utvärdering's praktisk påverkan:
RAG-optimering för finansiella tjänster
Ett ledande finansinstitut implementerade en omfattande RAG-utvärdering för sitt kundorienterade rådgivningssystem:
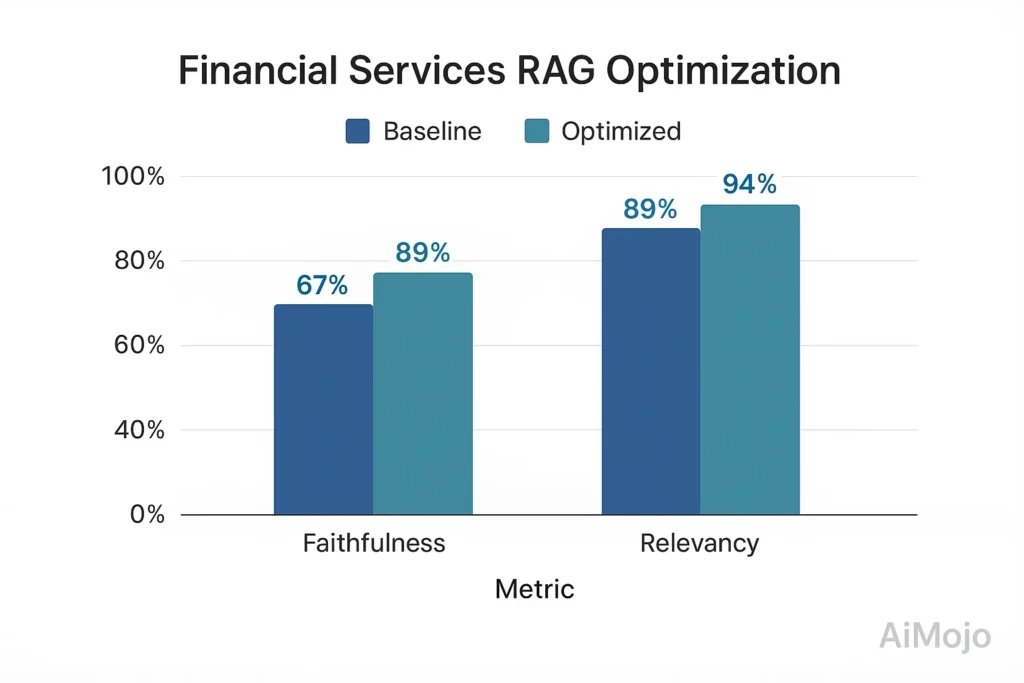
- Baslinje: 67 % trohet, 82 % svarsrelevans
- Efter utvärderingsdriven optimering: 89 % trohet, 94 % svarsrelevans
- Genomförande: Custom finansiell domän testsvit med 5,216 XNUMX expertverifierade QA-par
- Teknisk metod: Trohetspoängsättning med tensorbaserad entailmentmätning med kontrafaktisk testning
Denna utvärderingsdrivna förbättring minskade problem med regelefterlevnad med 78 % och ökade kundnöjdheten med 23 procentenheter.
Implementering av juridik inom hälso- och sjukvård
En vårdgivare implementerade flerskiktad utvärdering för kliniskt beslutsstöd:
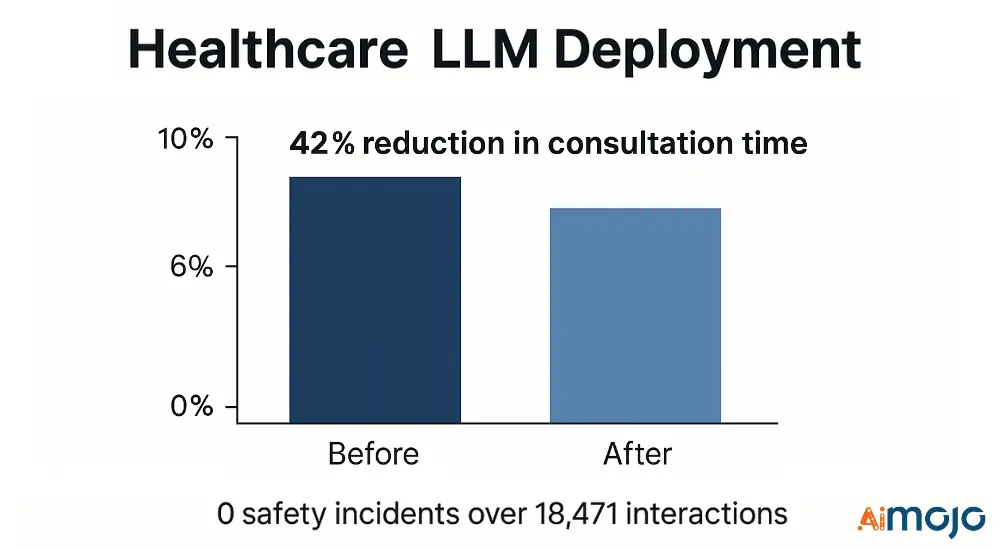
- Tekniska mätvärden: Medicinsk NER F1-poäng (0.91), noggrannhet i kliniskt resonemang (87.4 %), precision i säkerhetsfiltrering (99.2 %)
- Genomförande: 3-stegs filtreringspipeline med specialiserade hälsovårdsvaliderare
- Resultat: 42 % minskning av konsultationstiden med 0 säkerhetsincidenter vid 18,471 XNUMX kliniska interaktioner
Utvärderingsramverket identifierade och åtgärdade 17 kritiska fellägen före driftsättning, vilket förhindrade potentiella negativa händelser.
LLM-utvärdering: Din väg till framgång
Teknisk utvärdering av juridiska masterprogram har gått från enkla noggrannhetskontroller till omfattande ramverk som väger flera prestandadimensioner. Organisationer som använder dessa rigorösa protokoll – och integrerar automatiserad poängsättning, benchmarktestning och mänsklig tillsyn – uppnår ett mer tillförlitligt modellval och starkare resultat.
Regelbundna, adaptiva testpipelines avslöjar brister före driftsättning, vilket gör den initiala utvärderingskostnaden liten jämfört med riskerna med att implementera ett bristfälligt system. För ingenjörsteam är robusta valideringssteg mer än bara utvecklingsuppgifter ; de är viktiga affärsskydd.
År 2026 och framåt kommer team som förfinar sina utvärderingsmetoder att hålla sina juridiska masterprogram pålitliga, förhindra kostsamma fel och bibehålla användarnas förtroende.


 BONUS: Få våra 200 dollarAI ”Mastery Toolkit” GRATIS när du registrerar dig!


