Nysgjerrig på å bygge, finjustere eller distribuere store språkmodeller?
Du er ikke alene – LLM-ekspertise er en av de mest populære ferdighetene innen AI i dag. Med open source-prosjekter GitHub vokser raskt og har blitt det sentrale knutepunktet for toppledere LLM-prosjekter, rammeverk og forskning.
Denne guiden setter søkelyset på 12 viktige GitHub-repositorier fullpakket med kildekode, praktiske veiledninger og modellimplementeringer.
Få dokumentert LLM-kunnskap , akselerer læringen din og bli med i det globale fellesskapet som former fremtiden for kunstig intelligens – alt med disse uunnværlige GitHub-arkivene.
Hvorfor GitHub Er viktig for LLM-utvikling
GitHub har blitt det bankende hjertet i LLM-økosystemet, der banebrytende forskning møter praktisk implementering. Mens akademiske artikler gir teori, leverer GitHub selve koden som driver dagens teknologi.'s de mest avanserte språkmodellene.
Plattformen er vert for alt fra Meta's Llama-implementeringer til OpenAI's forskningskodebaser, noe som gjør det til den raskeste måten å få tilgang til velprøvde teknikker og ligge i forkant av den raske utviklingen.
Viktige grunner til at GitHub dominerer LLM-utvikling:
For LLM-entusiaster er GitHub ikke bare en ressurs – det's din direkte linje til fremtiden AI utvikling.
1. llm-kurs
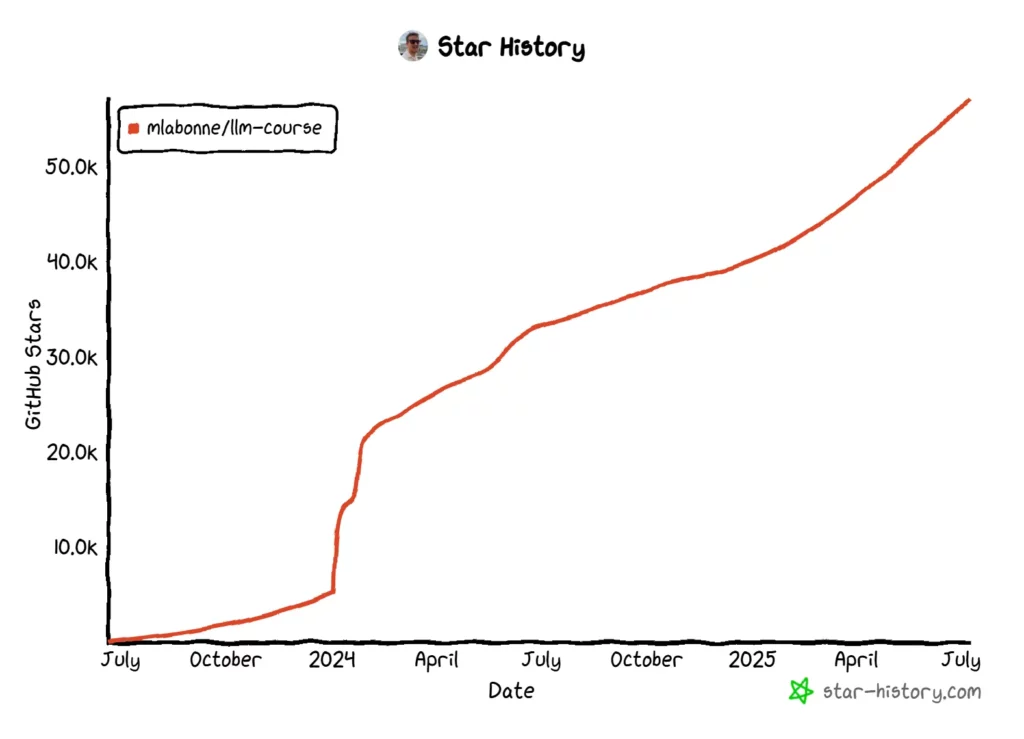
Maxime Labonnes LLM-kurs er et fantastisk utgangspunkt og en omfattende veiledning for alle som er seriøse med å lære seg LLM-er . Det er mer enn bare en samling filer; det er en strukturert læringsløype som passer for ulike karrieremål. Arkivet har oppnådd enorm popularitet, og kan skryte av over 51 500 stjerner på GitHub.
Hvorfor det's et toppvalg
Dette arkivet skiller seg ut fordi det tilbyr to forskjellige veikart, slik at du kan skreddersy læringsreisen din:
Kurset dekker alt fra det grunnleggende innen matematikk ved lov om lover og lover til avanserte emner som kvantisering, finjustering og modellutplassering. Det er en komplett pakke for elever på alle nivåer.
Viktige funksjoner
Hvem skal bruke det?
Dette arkivet er perfekt for både nybegynnere som trenger en strukturert innføring og erfarne fagfolk som ønsker å utdype sin ekspertise innen spesifikke områder innen LLM-utvikling.
2. HandsOnLLM
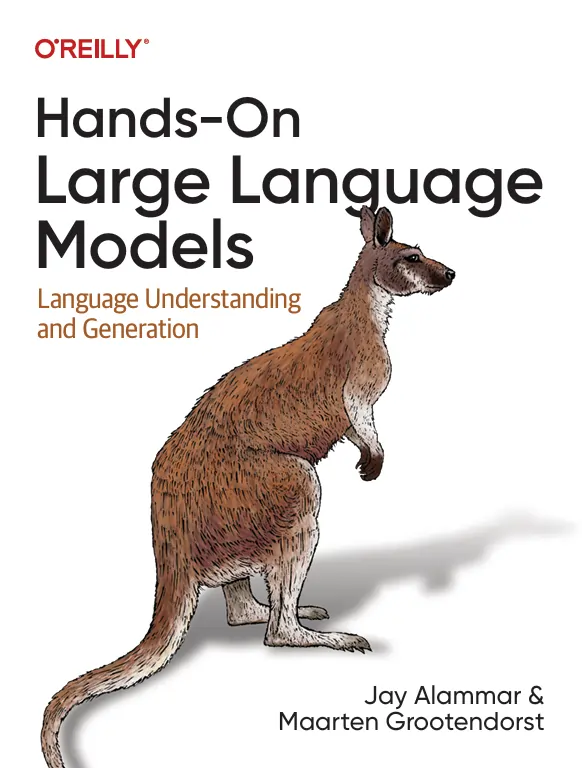
HandsOnLLM/Hands-On-Large-Language-Models-arkivet er det offisielle tillegget til O'Reilly-boken med samme navn. Det er en visuelt rik og praktisk guide som avmystifiserer hvordan LLM-er fungerer. Hvis du lærer best ved å gjøre og setter pris på veldokumenterte kodeeksempler, er dette arkivet for deg.
Hvorfor det's et toppvalg
Den tilbyr en praktisk, prosjektbasert tilnærming til læring. Hvert kapittel i boken er ledsaget av Jupyter-notatbøker, slik at du kan følge med og eksperimentere med koden selv. Den fokuserer på prosjekter og eksempler fra den virkelige verden som du kan tilpasse til dine egne brukstilfeller.
Viktige funksjoner
Hvem skal bruke det?
Utviklere og dataforskere som foretrekker en praktisk, prosjektbasert læringsstil, vil finne dette arkivet utrolig verdifullt. Det er også en utmerket ressurs for alle som leser boken «Hands-on Large Language Models».
3. prompt-engineering
brexhq/prompt-engineering-guiden er en skattkiste for å mestre kunsten og vitenskapen bak prompt engineering . I LLM-verdenen bestemmes kvaliteten på resultatet ofte av kvaliteten på innspillet ditt, noe som gjør denne ferdigheten helt essensiell. Dette arkivet, med nesten 9,000 stjerner, tilbyr praktiske tips og strategier for å jobbe med modeller som GPT-4.
Hvorfor det's et toppvalg
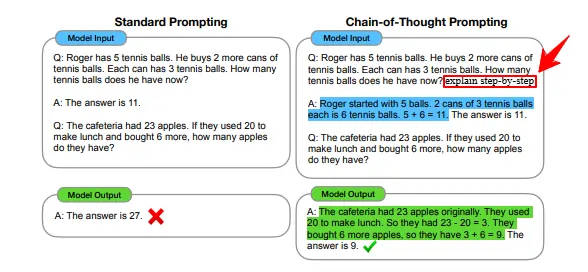
Den konsoliderer lærdommer fra å lage ledetekster for bruk i produksjon, noe som gjør det svært praktisk. Arkivet er godt organisert i veiledninger som dekker alt fra grunnleggende prinsipper til avanserte teknikker som Chain of Thought (CoT)-ledetekster og selvkonsistens.
Viktige funksjoner
Hvem skal bruke det?
Alle som samhandler med LLM-er, fra utviklere og forskere til innholdsskapere og markedsførere, vil dra nytte av dette arkivet. Å mestre prompt engineering er en nøkkelferdighet for å få mest mulig ut av enhver språkmodell.
4. Fantastisk-LLM
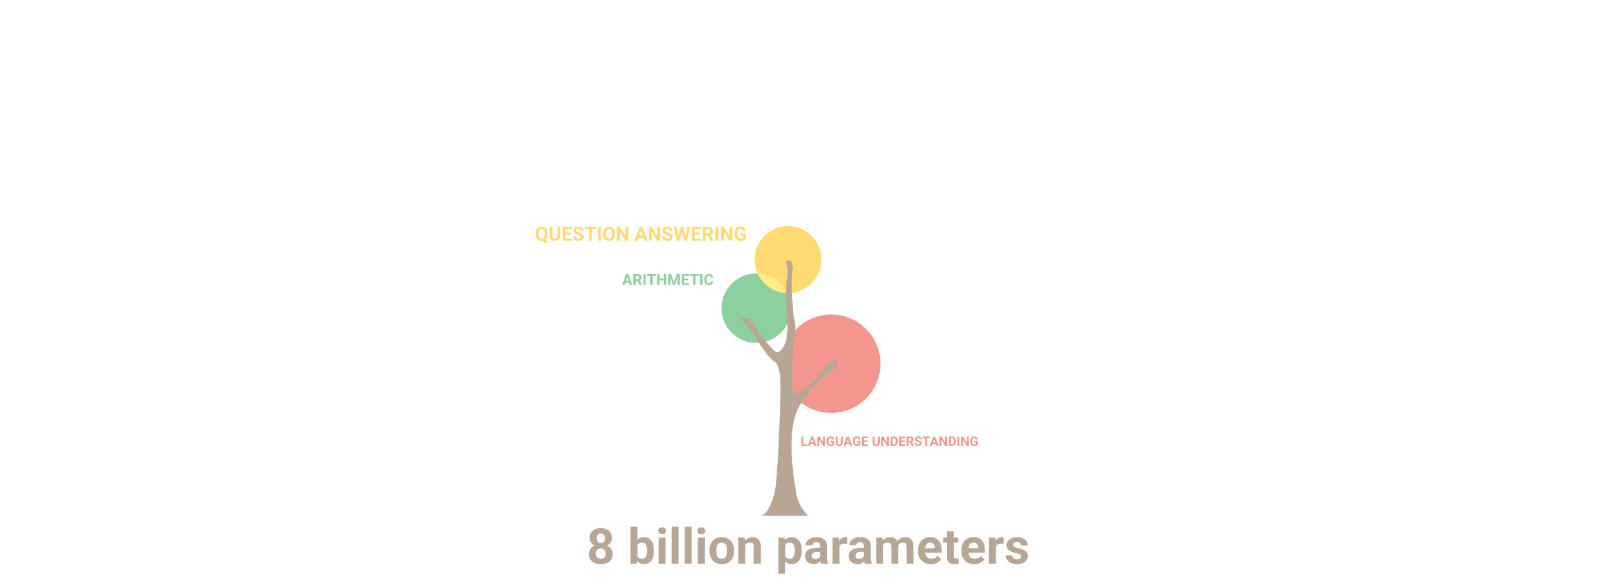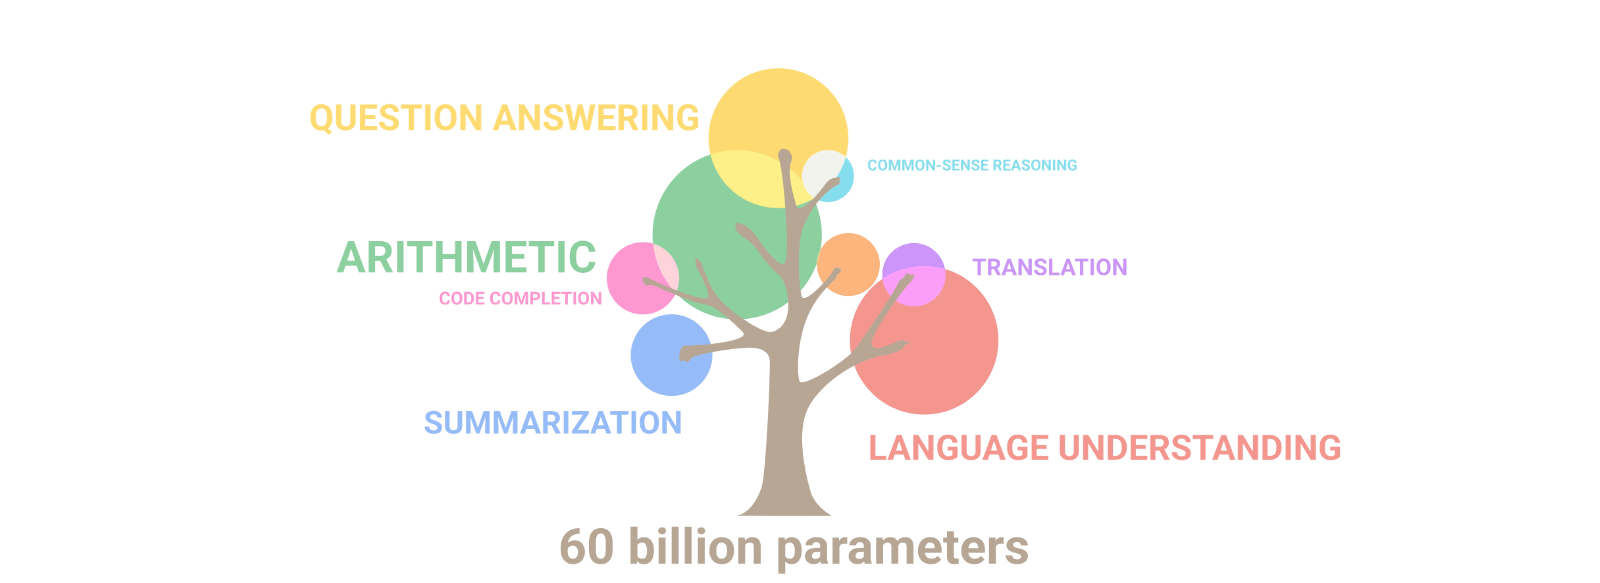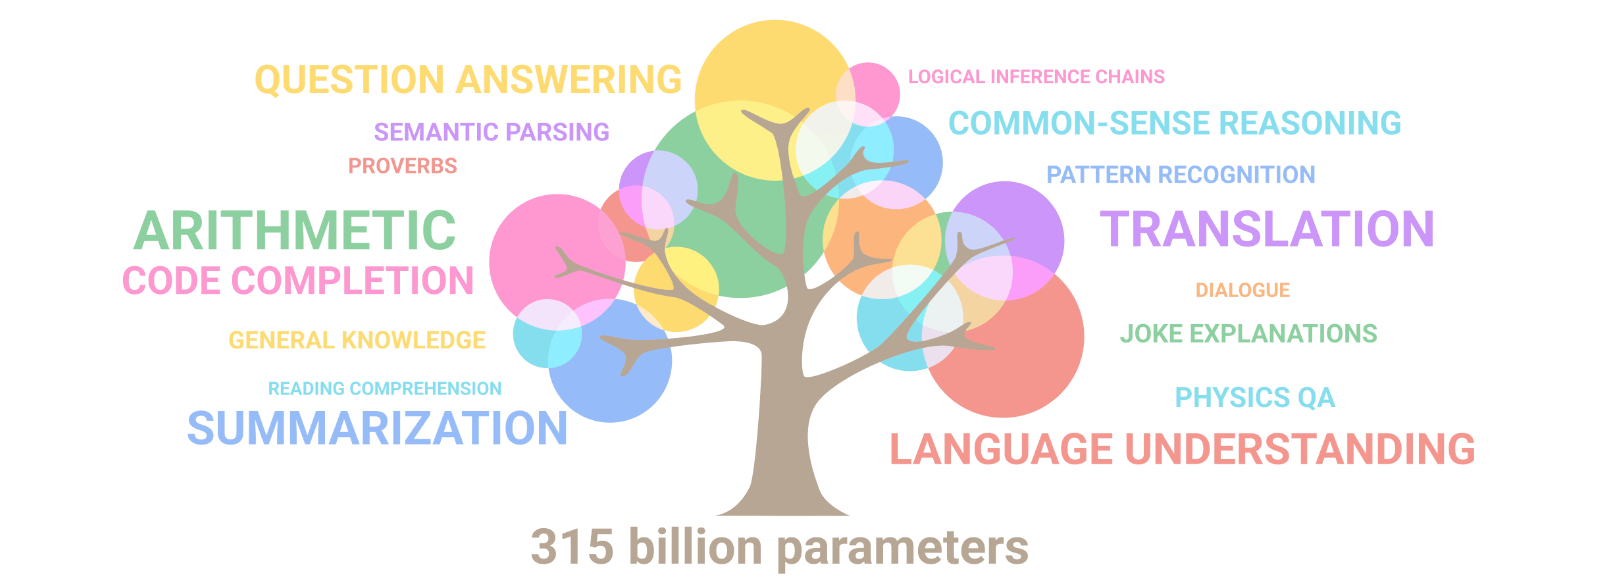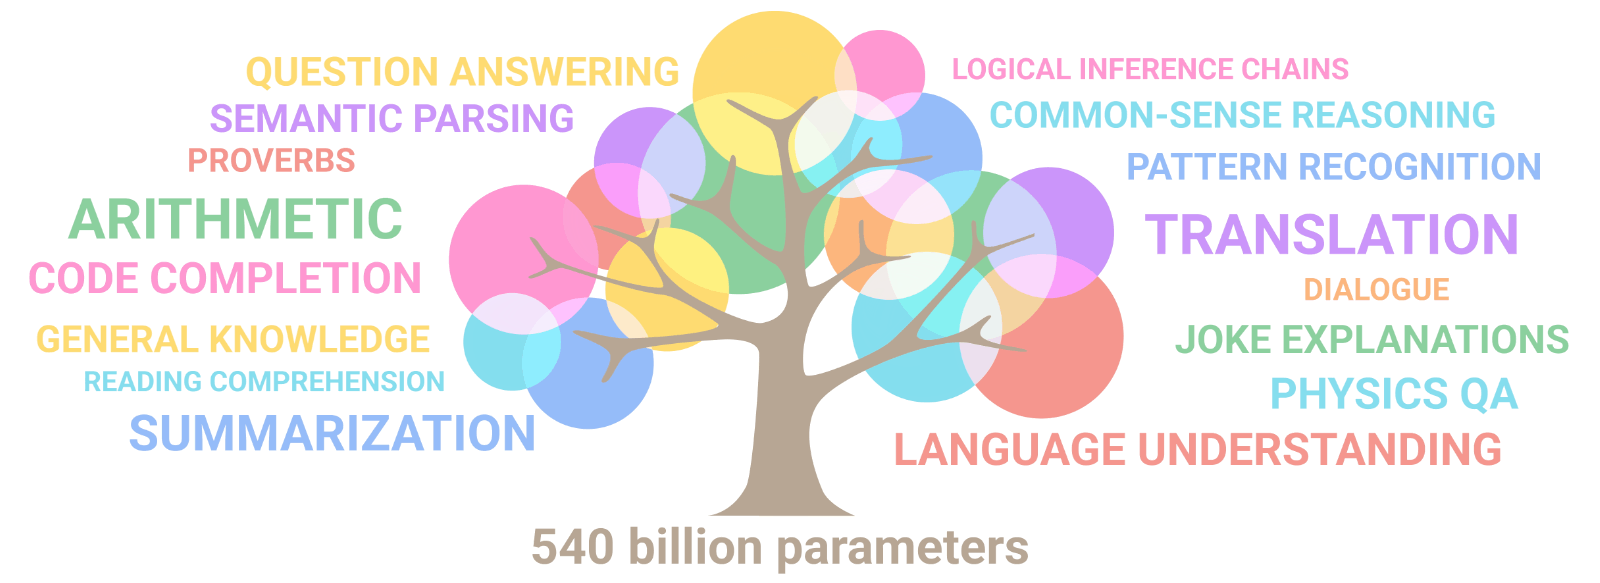
Hannibal046/Awesome-LLM-arkivet er en kuratert liste over alt relatert til store språkmodeller. Tenk på det som ditt sentrale dashbord for å holde deg oppdatert på LLM-økosystemet. Det er en levende samling av ressurser som regelmessig oppdateres av fellesskapet.
Hvorfor det's et toppvalg
Dette arkivet sparer deg for utallige timer med søking ved å samle viktige ressurser på ett sted. Det inkluderer banebrytende forskningsartikler, opplæringsrammeverk, implementeringsverktøy og evalueringsbenchmarks. Det har til og med en poengtavle for å spore resultatene til ulike LLM-er.
Viktige funksjoner
Hvem skal bruke det?
Dette er et must for forskere, studenter og praktikere som ønsker å ha alt de trenger for LLM-ressurser av høy kvalitet. Det er perfekt for å oppdage nye verktøy og holde seg oppdatert på den nyeste forskningen.
5. Verktøybenk
Etter hvert som LLM-er blir mer agentstyrte, blir deres evne til å bruke eksterne verktøy stadig viktigere. OpenBMB/ToolBench-repositoriet er en åpen kildekode-plattform utviklet for å trene, betjene og evaluere LLM-er for verktøylæring. Det tilbyr et rammeverk og et storskala instruksjonsjusteringsdatasett for å forbedre disse mulighetene.
Hvorfor det's et toppvalg
ToolBench fokuserer på et kritisk og trendy område innen LLM-utvikling: verktøybruk. StableToolBench-utvidelsen forbedrer dette ytterligere ved å introdusere funksjoner som MirrorAPI , som simulerer tusenvis av virkelige API-er , og et virtuelt API-system for å sikre stabilitet og konsistens under evaluering.

Viktige funksjoner
Hvem skal bruke det?
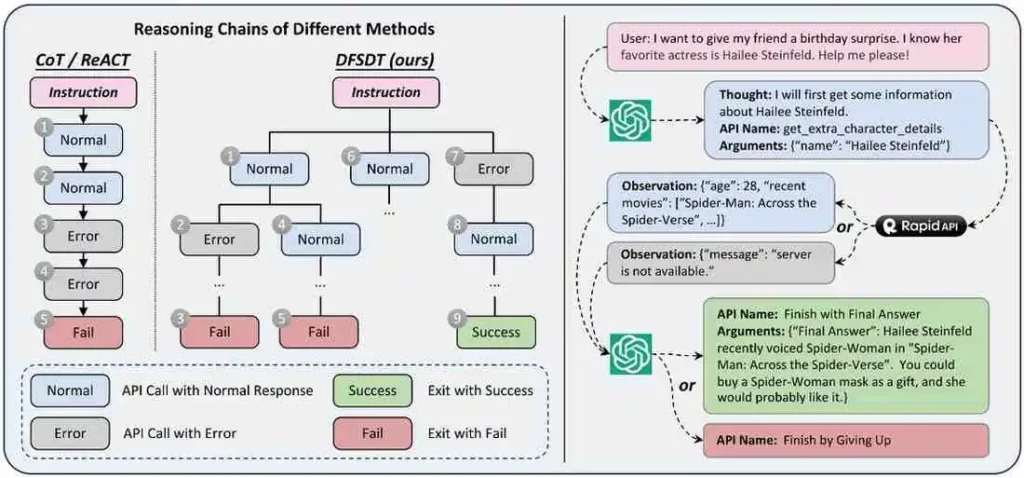
Forskere og utviklere som er interessert i å bygge agentiske LLM-er som kan samhandle med eksterne APIer og verktøy vil synes ToolBench er uvurderlig. Det er ideelt for de som jobber med å skape mer kapable og autonome AI agenter.
6. Pythia
EleutherAI/pythia-repositoriet er utviklet av EleutherAI, og er en serie med modeller som er utformet for å muliggjøre forskning på tolkbarhet, læringsdynamikk og etikk. I motsetning til mange andre modellutgivelser ble Pythia-pakken laget med åpenhet og vitenskapelig forskning som sine primære mål.
Hvorfor det's et toppvalg
Pythia gir fullstendig åpen kildekode-tilgang til 16 forskjellige modellsjekkpunkter, slik at forskere kan studere hvordan LLM-er utvikler seg og utvikler seg under opplæring. Dette er avgjørende for å forstå den «svarte boksen»-naturen til disse modellene og for å undersøke områder som skaleringslover og modellens etikk.
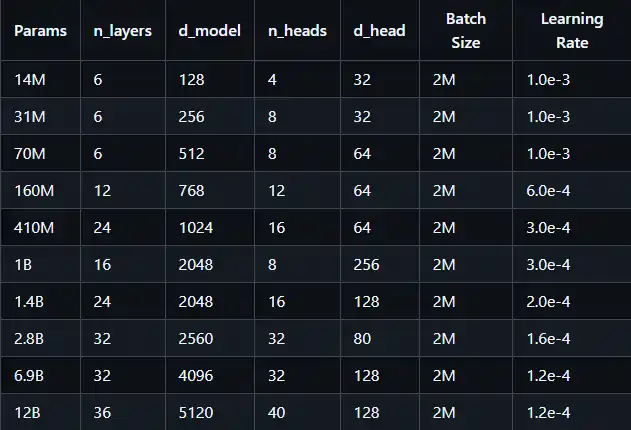
Viktige funksjoner
Hvem skal bruke det?
AI Forskere, etikere og studenter som fokuserer på modelltolkbarhet, sikkerhet og de grunnleggende prinsippene for LLM-opplæring vil få mye nytte av dette arkivet.
7. LLM-Agent-Paper-Liste
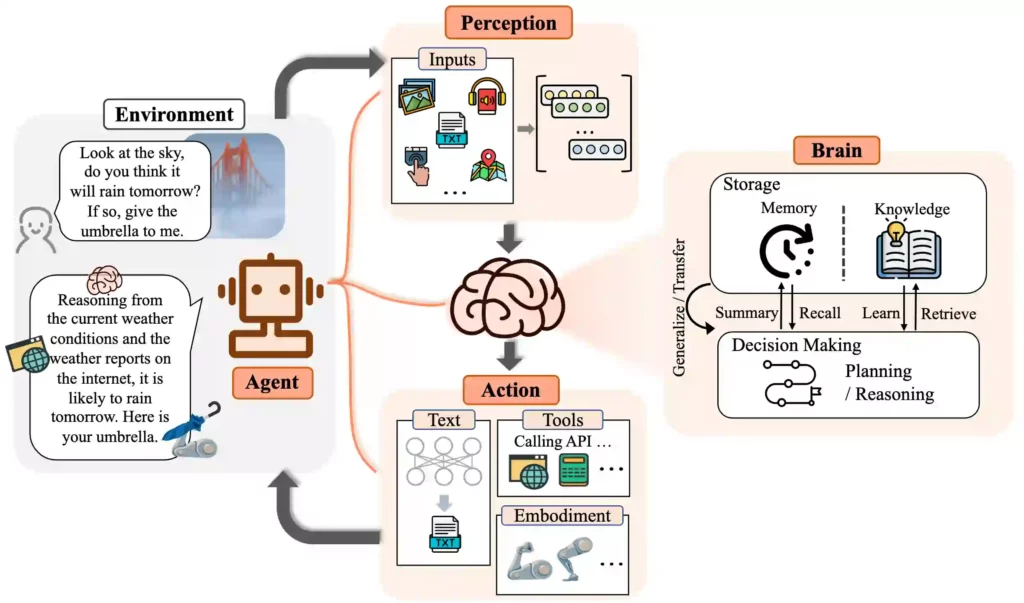
For de som ønsker å dykke dypt inn i den akademiske siden av AI agenter, er WooooDyy/LLM-Agent-Paper-List en viktig ressurs. Dette arkivet er en kuratert samling av forskningsartikler som systematisk utforsker utvikling, anvendelser og implementering av LLM-baserte agenter.
Hvorfor det's et toppvalg
Det fungerer som et grunnleggende kunnskapsbibliotek for et av de mest spennende feltene innen AI i dag. I stedet for bare kode, gir dette repositoriet det teoretiske grunnlaget du trenger for å forstå og bygge neste generasjon av AI midler.
Viktige funksjoner
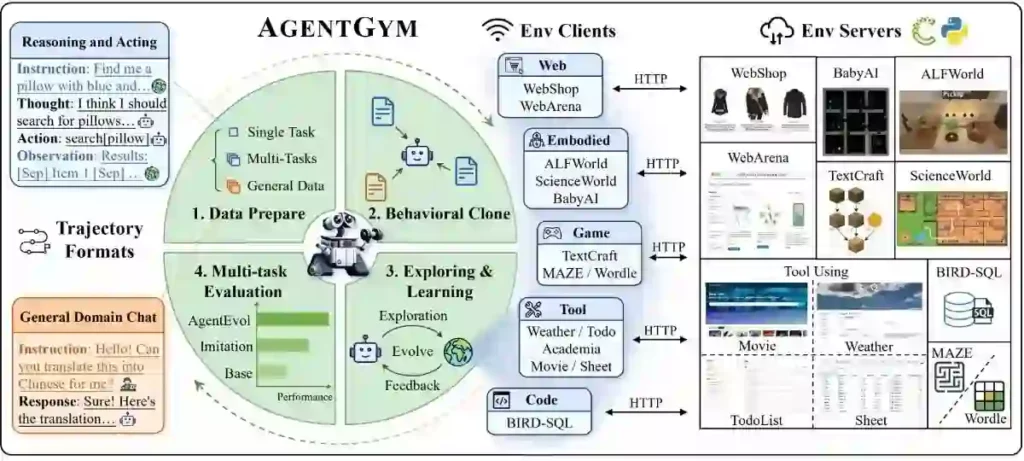
Hvem skal bruke det?
Dette arkivet er rettet mot akademiske forskere, masterstudenter og avanserte praktikere som ønsker å bygge videre på banebrytende forskning innen LLM-baserte agenter.
8. Fantastiske multimodale modeller på store språk
LLM-er er ikke lenger begrenset til bare tekst. BradyFU/Awesome-Multimodal-Large-Language-Models-arkivet er en kuratert samling av ressurser fokusert på de nyeste fremskrittene innen multimodale LLM-er (MLLM-er), som kan behandle informasjon fra tekst, bilder, lyd og video.
Hvorfor det's et toppvalg
Dette arkivet er din inngangsport til MLLM-enes verden. Det dekker et bredt spekter av emner, fra multimodal instruksjonsjustering til tankekjede-resonnement og teknikker for å redusere hallusinasjoner. Det er også koblet til VITA-prosjektet, en åpen kildekode-plattform for interaktiv multimodal LLM.
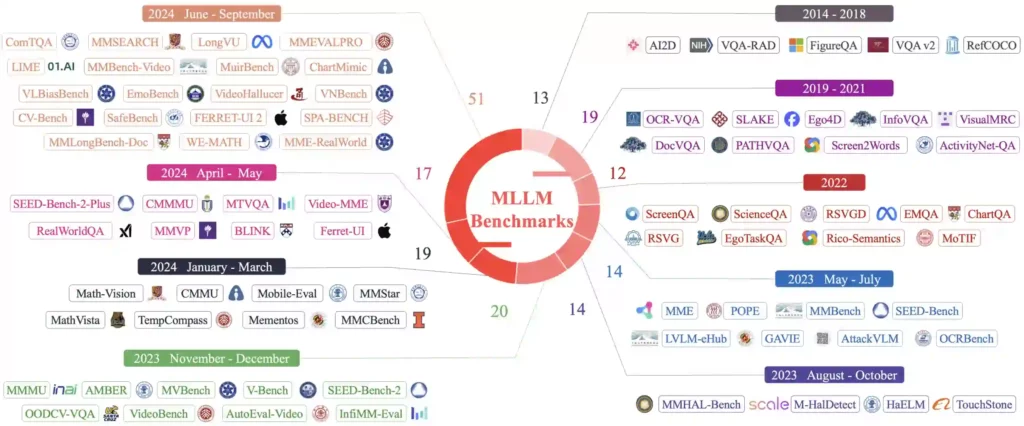
Viktige funksjoner
Hvem skal bruke det?
Utviklere og forskere som er interessert i å bygge applikasjoner som går utover tekst, for eksempel bildeteksting, videoanalyse eller stemmestyrte assistenter, vil finne denne samlingen svært nyttig.
9. DeepSpeed
microsoft/DeepSpeed er utviklet av Microsoft og er et bibliotek for optimalisering av dyp læring som gjør distribuert trening og inferens enkel og effektiv. Det integreres sømløst med PyTorch og har vært avgjørende for trening av noen av verdens største modeller, inkludert Megatron-Turing-modellen med 530 milliarder parametere.
Hvorfor det's et toppvalg
DeepSpeed handler om skalering og effektivitet. Den tilbyr innovasjoner på systemnivå som lar deg trene massive modeller med milliarder av parametere på begrenset maskinvare. Funksjonene er essensielle for alle som tar seriøse spørsmål om å trene toppmoderne LLM-er fra bunnen av eller finjustere store modeller.
Viktige funksjoner
Hvem skal bruke det?
Dette er et verktøy for seriøse praktikere, dataforskere og forskere som trenger å trene eller finjustere svært store språkmodeller. Hvis du treffer minnegrenser med ditt nåværende oppsett, er DeepSpeed løsningen.
10. ring.cpp
ggml-org/llama.cpp-arkivet er banebrytende for å kjøre LLM-er på forbrukermaskinvare. Det's et høytytende C/C++-bibliotek for å kjøre inferens på lokale maskiner, inkludert stasjonære datamaskiner og til og med mobile enheter. Det's bygget på GGML tensorbiblioteket og er kjent for sin effektivitet og minimale oppsett.
Hvorfor det's et toppvalg
llama.cpp gjør kraftige LLM-er tilgjengelige for alle. Du trenger ikke en massiv skybasert GPU-klynge for å eksperimentere med modeller som Llama 3 , Mistral eller GPT-2. Fokuset på CPU- og kantenhetsytelse har demokratisert LLM-bruken. Du kan sette opp en lokal server med bare noen få kommandoer og begynne å samhandle med modeller.
Viktige funksjoner
Hvem skal bruke det?
Utviklere, hobbyister og forskere som ønsker å kjøre og eksperimentere med LLM-er lokalt uten å være avhengige av dyre skytjenester. Det's også perfekt for bygging på enhet AI søknader som prioriterer personvern og lav latens.
11. PaLM-rlhf-pytorch
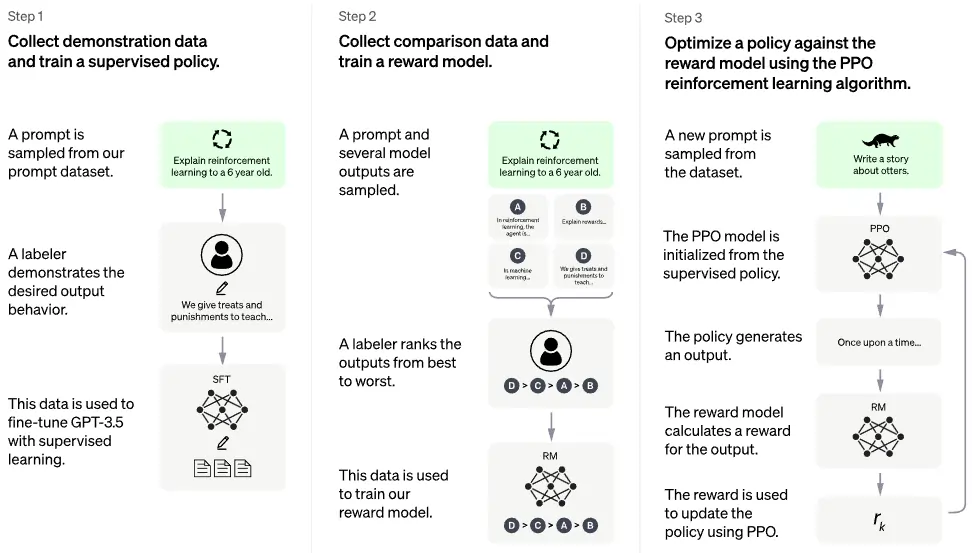
Forsterkende læring med menneskelig tilbakemelding (RLHF) er den hemmelige ingrediensen bak de imponerende samtaleegenskapene til modeller som ChatGPT. lucidrains/PaLM-rlhf-pytorch-arkivet tilbyr en åpen kildekode-implementering av RLHF anvendt på Google.'s PaLM-arkitektur.
Hvorfor det's et toppvalg
Dette arkivet avmystifiserer en av de viktigste teknikkene innen moderne LLM-utvikling. Det har som mål å gjenskape funksjonaliteten til ChatGPT ved hjelp av PaLM-modellen , og gir et konkret eksempel på hvordan RLHF kan implementeres. Du kan laste inn forhåndstrente modeller eller finjustere dem etter dine egne behov.
Viktige funksjoner
Hvem skal bruke det?
Dette arkivet er for forskere og utviklere som er interessert i finjusteringsprosessen, spesielt de som ønsker å forstå og implementere RLHF for å samkjøre LLM-er med menneskelige preferanser.
12. nanoGPT
karpathy/nanoGPT ble skapt av den legendariske Andrej Karpathy, og er det enkleste og raskeste arkivet for trening og finjustering av mellomstore GPT-er. Kodebasen er bevisst konsis, med kjernetreningsløkken i train.py og modelldefinisjonen i model.py.
Hvorfor det's et toppvalg
nanoGPT prioriterer enkelhet og pedagogisk verdi. Den fjerner all kompleksiteten til store biblioteker, slik at du kan forstå transformatorarkitekturen fra grunnen av. Til tross for enkelheten,'s kraftig nok til å reprodusere resultater på GPT-2-nivå og har inspirert andre minimalistiske prosjekter som nanoVLM for visjonsspråkmodeller.
Viktige funksjoner
Hvem skal bruke det?
nanoGPT er ideelt for studenter, lærere og utviklere som ønsker en dyp, grunnleggende forståelse av GPT-arkitekturen. Hvis du er lei av svartboksbiblioteker og vil se hvordan ting egentlig fungerer, er dette depotet for deg.
Din LLM-reise Starter med disse viktige GitHub-arkivene
Forskjellen mellom å drømme om LLM-er og å faktisk bygge dem? Disse 12 GitHub-repositoriene. Mens andre diskuterer teori, har du nå direkte tilgang til koden som driver dagens mest avanserte språkmodeller.
Din konkurransefordel venter:
- Klon nanoGPT å forstå det grunnleggende om transformatorer
- Gaffel llama.cpp for lokal modelldistribusjon
- Stjerne llm-kurs for strukturerte læringsløp
- Bidra til DeepSpeed og bli med i Microsoft's optimaliseringstiltak
LLM-feltet utvikler seg raskt –utviklere De som mestrer disse lagrene i dag blir i morgen's AI arkitekter. Velg dine tre beste repositorier, sett opp utviklingsmiljøet ditt og begynn å eksperimentere. Hver commit, hver pull-forespørsel, hver modell du trener bringer deg nærmere mestring av LLM.


 BONUS: Få våre 200 dollarAI «Mestringsverktøysett» GRATIS når du registrerer deg!