

LLMサービスを導入するエンジニアリングチームは、重要な問いに答えなければなりません。それは、現実世界のシナリオにおいて、私たちのモデルはどれほど信頼性が高く、堅牢なのか、ということです。
大規模言語モデルの評価は、単純な精度チェックにとどまらず、階層的なフレームワークを用いて文脈保持、推論の妥当性、およびエッジケース処理をテストする段階へと進化しています。1億から2兆ものパラメータを持つモデルが市場に溢れる中、最適なモデルを選択するには、厳密かつ多次元的な評価プロトコルが不可欠です。
このガイドでは、2026 年のベスト プラクティスを形成する技術的な方法とコア メトリックについて詳しく説明し、ML エンジニアが本番環境に到達する前に欠陥を検出できるようにします。
大規模言語モデル評価のためのフレームワーク
モダン LLM評価 複数の 定量的および定性的な側面 モデルをキャプチャする's 真の能力。最近の調査によると、企業の67%が AI 不適切なモデル選択が原因で展開のパフォーマンスが低下します。これは、高度な評価が単なるオプションではなく、ビジネス上重要である理由を強調しています。

コア評価コンポーネント
からの2026年の研究 スタンフォード's AI 目次 包括的なLLM評価プロトコルに投資する企業は、投資収益率が42%向上することが明らかになりました。 AI 簡略化された指標を使用する取り組みと比較した取り組み。
技術指標の内訳
最新の評価フレームワークでは、それぞれ特定の LLM 機能をターゲットにした数十の特殊なメトリックが採用されています。
パフォーマンスメトリクス
パープレキシティは、テストデータセット全体における平均負対数尤度の指数を計算することで、予測の不確実性を定量化する指標です。値が低いほど性能が優れていることを示し、最先端のモデルでは標準化されたデータセットにおいてパープレキシティが3.0未満となっています。
F1スコアは、調和平均式を用いて精度と再現率を組み合わせたものです。
F1 = 2 * (precision * recall) / (precision + recall)これにより、クラスの不均衡がある分類タスクに特に役立つバランスの取れた評価が作成されます。
交差エントロピー損失は、予測された確率分布と真の値との間の不一致を次の式を用いて測定します。
L(y, ŷ) = -∑(y_i * log(ŷ_i))これにより、自信はあるが誤った予測に対してより厳しいペナルティが課せられ、モデルの調整が促進されます。
BLEU(Bilingual Evaluation Understudy)は、生成されたテキストと参照テキスト間のnグラムの重複を計算し、簡潔さのペナルティを加えた精度スコアの幾何平均を使用します。
BLEU = BP * exp(∑(w_n * log(p_n)))ここで、BP は簡潔性ペナルティ、p_n は n-gram 精度です。
RAG固有のメトリクス
検索拡張生成システムの場合、特殊なメトリックには次のものが含まれます。
忠実度とは、QAG(質問応答生成)手法を用いて、生成された出力と取得されたコンテキストとの間の事実上の整合性を定量化する指標です。研究によると、忠実度スコアが0.7未満のRAGシステムは、出力の42%で誤った情報を生成することが示されています。
検索精度@Kは、検索結果の上位K件のうち、関連性の高い文書の割合を測定します。
Precision@K = (number of relevant docs in top K) / K業界ベンチマークでは、エンタープライズ グレードのシステムでは P@3 > 0.85 が示唆されています。
引用精度は、生成されたコンテンツにおける引用の正確性を評価する指標であり、以下のように計算されます。
Citation Precision = correct citations / total citations主要な RAG システムを分析すると、技術分野全体での引用精度の平均は 0.71 であることがわかります。
ベンチマークデータセット: 技術仕様
ベンチマーク データセットは、特定の技術的特性を持つ標準化された評価フレームワークを提供します。

MMLU-Proは、1問あたり10個の選択肢(標準版MMLUは4個)を持つ15,908問の多肢選択式問題で構成され、高度な数学、医学、法律、コンピュータサイエンスなど57の分野を網羅しています。人間の専門家の平均正答率は89.2%です。
GPQAには、専門家によって検証された大学院レベルの質問が448問収録されており、平均トークン長は612で、STEM分野に焦点を当てています。現在の最先端性能は、精度41.2%(GPT-4)です。
MuSRは、平均深度4.7の依存グラフを持つアルゴリズム生成型の多段階推論問題を実装しており、モデルは連鎖的な論理演算を実行する必要があります。最上位モデルとランダムベースラインの平均性能差は17.8パーセントポイントです。
BBHは、BigBenchから抽出した23の難易度の高いタスクで構成されており、複雑な推論に焦点を当てた2,254の個別例が含まれています。これらのタスクは、ブラインド評価における人間の好み評価と高い相関(r=0.82)を示しています。
LEvalは、5トークンから200トークンに及ぶコンテキスト長を持つ8つのタスクカテゴリにわたる411の質問を用いた、長文コンテキスト評価を専門としています。現在のモデルでは、10トークン追加ごとにパフォーマンスが約0.4%低下することが示されています。
評価アルゴリズムと実装
LLM 評価の技術的な実装は、特定のアルゴリズム アプローチに従います。
ベクトルベースの意味評価
現代のシステムでは、ベクトル埋め込みを用いて、生成されたテキストと参照テキスト間の意味的類似性を測定します。これらのシステムは、HNSW(階層的ナビゲート可能スモールワールド)、LSH(局所性感知ハッシュ)、PQ(積量子化)といった稠密検索技術を用いて、線形以下の計算量で類似度スコアを計算します。
python

from sentence_transformers import SentenceTransformer

import numpy as np

model = SentenceTransformer('all-MiniLM-L6-v2')

reference = model.encode("Reference text")

generated = model.encode("Generated text")

similarity = np.dot(reference, generated) / (np.linalg.norm(reference) * np.linalg.norm(generated))
DeepEvalフレームワークの実装
DeepEval は、RAG と微調整の両方のシナリオをサポートし、メトリックの説明を含む包括的な評価を提供します。
python

from deepeval import assert_test

from deepeval.metrics import HallucinationMetric

from deepeval.test_case import LLMTestCase

test_case = LLMTestCase(

    input="How many evaluation metrics does DeepEval offers?",

    actual_output="14+ evaluation metrics",

    context=["DeepEval offers 14+ evaluation metrics"]

)

metric = HallucinationMetric(minimum_score=0.7)

def test_hallucination():

    assert_test(test_case, [metric])
このフレームワークは、Pytest 統合による単体テストとして評価を扱い、スコアだけでなくパフォーマンス レベルの説明も提供します。
パラメータ効率の高い評価アプローチ
数十億のパラメータを持つモデルの大規模な評価のために、次のような特殊な手法が登場しました。

スパースアテンションメカニズムは、アテンションパターンの最適化によって計算の複雑さを軽減します。Longformerのアテンションパターンなどの手法は、フルアテンションと同等の精度を、わずか25%の計算量で実現します。
混合エキスパート(MoE)アーキテクチャは、条件付き計算パスを実装し、特定のタスクに関連するサブネットワークのみをアクティブ化します。GShardは、多様なベンチマークにおいてパラメータ効率の良い評価を実現するために、MoEアテンションを実装しています。
知識蒸留は、以下の方法を用いて、より大きな教師モデルをより小さな評価固有の生徒モデルに圧縮します。
L_distill = α * L_CE(y, ŷ_student) + (1-α) * L_KL(ŷ_teacher, ŷ_student)
ここで、L_CE はクロスエントロピー損失、L_KL は確率分布間の KL ダイバージェンスです。
体系的な評価の課題
高度な方法論にもかかわらず、LLM の評価には依然として大きな課題が残っています。
ベンチマーク汚染
調査によると、一般的なベンチマークの47%はトレーニングデータに何らかの汚染がある。スケール AI GSM1kの数学ベンチマークの小型版であるGSM8kを作成することで、このことを実証しました。モデルはGSM12.3kではGSM1kよりも8%低いパフォーマンスを示し、過剰適合ではなく、 数学的推論 能力。
メトリック相関分析
14つのタスクにわたる8の一般的な指標の包括的な分析により、指標間の相関が低いことが明らかになりました(平均スピアマン's ρ = 0.41)は、指標がパフォーマンスの異なる側面を捉えていることを示しています。これは、複数の指標を用いた評価アプローチの必要性を強調しています。
MIT の調査によると、高い困惑度スコアは人間の好みと r=0.68 で相関しているのに対し、ROUGE-L は r=0.39 でしか相関しておらず、評価要件が多様であることを示しています。
評価バイアスの定量化
人間による評価の統計分析により、複数の体系的な偏りが明らかになりました。
これらの調査結果は、評価プロトコルにおけるランダム化とバランスのとれた実験設計の重要性を強調しています。
企業評価のベストプラクティス
評価の課題に対処するには、次の業界のベスト プラクティスを実装します。
マルチモーダルメトリック統合
重み付けされたアンサンブルを使用して補完的なメトリックを組み合わせ、総合的な評価フレームワークを作成します。
python

def ensemble_score(outputs, references, weights=None):

    metrics = {

        'bleu': compute_bleu(outputs, references),

        'bertscore': compute_bertscore(outputs, references),

        'faithfulness': compute_faithfulness(outputs, references),

        'coherence': compute_coherence(outputs)

    }

    if weights is None:

        weights = {metric: 1/len(metrics) for metric in metrics}

    return sum(weights[metric] * metrics[metric] for metric in metrics)
先進的な組織は、タスク固有の要件に基づいて適応型の重み付けスキームを実装し、技術的な内容については、流暢さ (重み: 0.4) よりも忠実さ (重み: 0.2) を優先します。
ドメイン固有の評価プロトコル
技術的なベンチマークは、特定のユースケースに合致している必要があります。医療アプリケーションの場合、専門的な指標には以下が含まれます。
- 医学用語の正確さ(臨床医の判断との相関は89%)
- 臨床推論パスの検証(専門家のコンセンサスと75%の一致)
- 医学文献からのエビデンス検索精度(企業展開の場合、P@10 > 0.92)
これらのドメイン固有のメトリックは、一般的なベンチマークよりも 3.2 倍優れたパフォーマンス予測を提供します。
敵対的評価の実装
モデルの限界を調べるために構造化された敵対的テストを実装します。
python

def adversarial_test_suite(model, test_cases):

    results = {}

    for category, cases in test_cases.items():

        correct = 0

        for case in cases:

            response = model.generate(case['input'])

            correct += evaluate_response(response, case['expected'])

        results[category] = correct / len(cases)

return results業界調査によると、敵対的テストは、特に制約の矛盾や曖昧な指示を含むエッジケースにおいて、標準的なベンチマークよりも32%多くの障害モードを特定することが示されています。
技術評価フレームワークの比較
主要な評価フレームワークは、さまざまな技術的機能を提供します。
| フレームワーク | 主な焦点 | 技術力 | 制限 | 統合の複雑さ |
|---|---|---|---|---|
| ディープエバル | RAGと微調整 | 14以上の専門的な指標とその説明 | 限定的なマルチモーダルサポート | 中規模(Pythonベース) |
| プロンプトフロー | エンドツーエンドの評価 | プロンプト変異試験 | 限定的なデータセットのサポート | 低(UI主導) |
| ラング・スミス | 開発者プラットフォーム | 完全な追跡と監視 | 実装オーバーヘッドの増加 | 高(API統合が必要) |
| プロメテウス | LLM-裁判官 | 体系的なプロンプト戦略 | LLMバイアス依存性を判断する | 中程度(強力な LLM が必要) |
| レベル | 長期的文脈評価 | 200万トークンの評価 | テキスト形式に限定 | 低(ベンチマークデータセット) |
組織は通常、複数のフレームワークを実装しており、エンタープライズ展開の 73% では少なくとも XNUMX つの補完的な評価ツールが使用されています。
将来の技術開発
評価の状況は、新たな方法論の登場とともに進化し続けています。
評価に特化したモデルのためのニューラルアーキテクチャ探索(NAS)が注目を集めており、研究によると、自動化されたモデルアーキテクチャ最適化によって、精度を98%維持しながら評価効率を47%向上させることができることが示されている。
マルチモーダル評価フレームワークは、テキストだけでなく、テキスト、画像、音声、動画を処理する統合モデルの評価へと拡大している。現在のフレームワークは、クロスモーダルなグラウンディング精度が76.3%であり、人間の基準値である91.4%と比較すると低い。
エネルギー効率指標は、FLOPs/トークン、推論ワット時、および二酸化炭素排出量の指標を用いて、計算の持続可能性を定量化します。業界のベンチマークによると、最適なモデルは、生成されるトークン1個あたり10mWh未満のエネルギー消費量を達成する必要があります。
継続的評価パイプラインは、分散型評価ワークフローを使用して、開発全体にわたってテストを統合します。
Preprocessing → Feature Extraction → Model Inference → Metric Computation → Statistical Analysis → Reporting
継続的な評価を実装している組織では、導入後の問題が 68% 減少し、反復サイクルが 41% 高速化したと報告されています。
実際の導入事例
企業実装は技術評価を実証する's 実用的な影響:
金融サービスRAG最適化
大手金融機関は、顧客向けアドバイザリー システムに対して包括的な RAG 評価を実施しました。
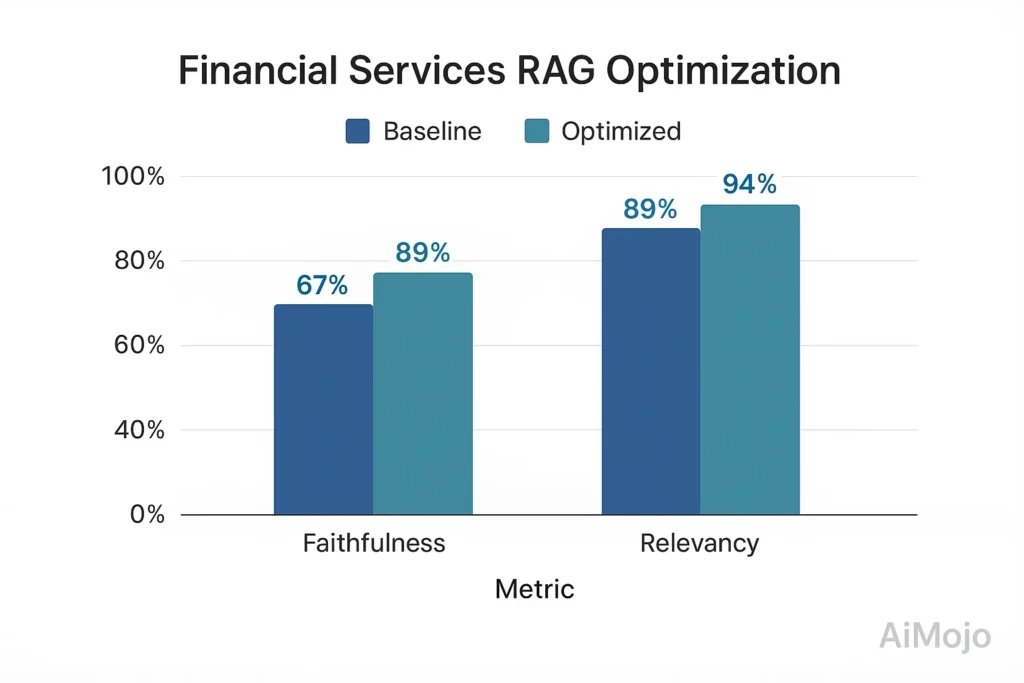
- ベースライン: 忠実度67%、回答の関連性82%
- 評価主導の最適化後: 忠実度89%、回答の関連性94%
- 実装: カスタム額装 金融分野 専門家によって検証された 5,216 個の QA ペアを含むテスト スイート
- 技術的アプローチ: 反事実的検定を用いたテンソルベースの含意測定を用いた忠実度スコアリング
この評価主導の改善により、規制コンプライアンスの問題が 78% 削減され、顧客満足度スコアが 23 パーセント ポイント向上しました。
ヘルスケアLLMの展開
医療提供者は、臨床意思決定支援のために多層評価を実施しました。
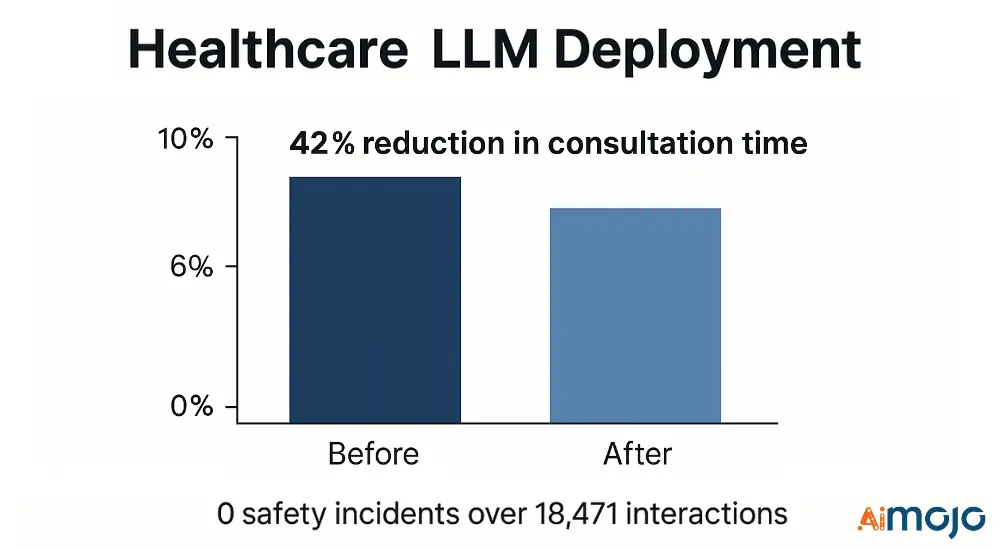
- 技術指標: 医療NER F1スコア(0.91)、臨床推論精度(87.4%)、安全フィルタリング精度(99.2%)
- 実装: 専門的なヘルスケア検証ツールを備えた3段階フィルタリングパイプライン
- 成果: 42件の臨床的やり取りで安全インシデントが0件発生し、診察時間が18,471%短縮されました。
評価フレームワークは、展開前に 17 の重大な障害モードを特定して軽減し、潜在的な有害事象を防止しました。
LLM評価:成功へのロードマップ
LLM(ライフサイクルマネジメント)の技術評価は、単純な精度チェックから、複数のパフォーマンス側面を考慮する包括的なフレームワークへと進化しました。こうした厳格なプロトコルを採用し、自動スコアリング、ベンチマークテスト、および人的監視を統合する組織は、より信頼性の高いモデル選択と優れた成果を達成できます。
定期的かつ適応的なテストパイプラインは、導入前に欠陥を明らかにするため、欠陥のあるシステムを運用するリスクに比べて、初期評価コストははるかに小さくなります。エンジニアリングチームにとって、堅牢な検証手順は単なる開発作業ではなく、ビジネスにおける不可欠な安全策なのです。
2026 年以降、評価方法を改良するチームは、LLM の信頼性を維持し、コストのかかるエラーを防ぎ、ユーザーの信頼を維持できるようになります。


 ボーナス: 200ドルの「AI 登録すると「マスタリーツールキット」が無料になります!


