
Sai esattamente a che momento mi riferisco. Fotogramma uno, il tuo AI Il personaggio sembra perfetto. Poi gira la testa, fa due passi, apre la bocca per parlare... ed ecco che all'improvviso il volto di qualcun altro si ritrova cucito sullo stesso vestito. Gli zigomi si spostano, il naso si ridisegna, quel piccolo neo che tanto amavi è sparito.
La deriva dell'identità è ciò che rovina silenziosamente la maggior parte AI video, ed è il motivo per cui ho smesso di ammirare i demo reel e mi sono effettivamente seduto a testarli Seedance 2.5 in APOB AI me stesso.
La domanda che mi interessava era semplice: Face-Lock è in grado di mantenere l'identità di un personaggio ben definita anche quando l'azione inizia ? Un bel viso immobile è banale. Un viso che resiste a un ciclo di camminata, a un lento avvicinamento, a una rotazione della testa e a una battuta di dialogo senza tremare: ecco, questa è la vera sfida.
Quindi ho eseguito diverse generazioni direttamente dall'APOB AI Ho analizzato la dashboard, ho guardato i fotogrammi uno per uno e ho recuperato il resto dei dettagli dalle pagine ufficiali del prodotto, in modo che corrispondano perfettamente a ciò che vedrai sul tuo schermo. Ecco esattamente cosa è successo.
Seedance 2.5 in APOB AI: con cosa stai effettivamente lavorando
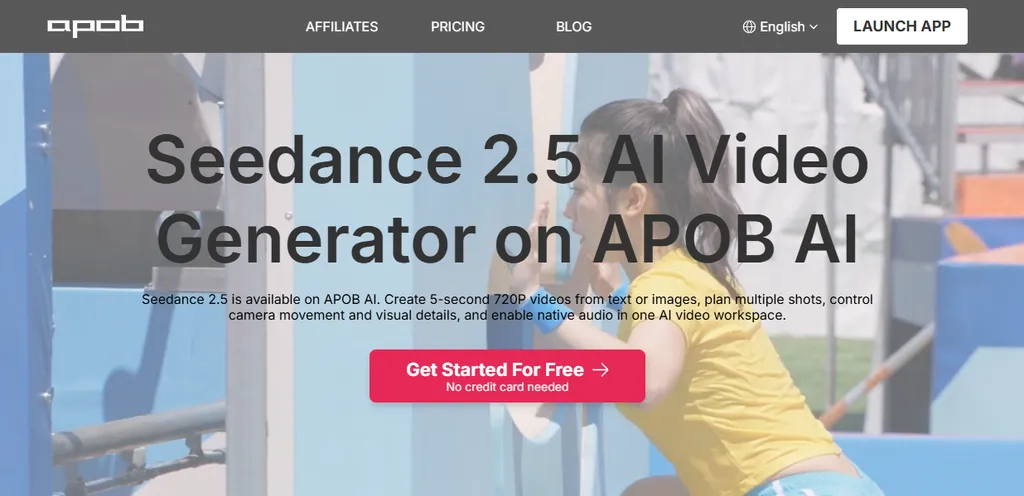
Breve premessa prima dei risultati. Seedance 2.5 è il nuovo modello di generazione video di ByteDance, basato sulla stessa architettura audio-video integrata di Seedance 2.0, ma orientato verso narrazioni più lunghe, riferimenti multimodali e un editing preciso a livello di timestamp.
APOB AI è la piattaforma che racchiude quel modello in uno spazio di lavoro a misura di creatore: lo stesso strumento che molte persone già usano per costruire AI influenzatori, portavoce virtuali e personaggi ricorrenti del marchio.
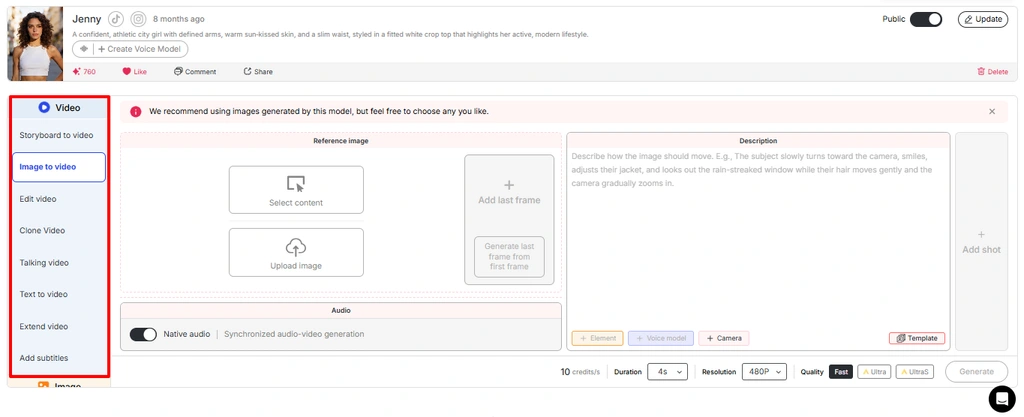
All'interno dell'APOB AI Nel pannello video è disponibile un menu completo di modalità: Da testo a video, Da immagine a video, Avatar parlante, Sincronizzazione labialeScambio di volti nei video, estensione del video, aggiunta di sottotitoli e modifica del video (ReVideo).
Nello specifico, nell'ambiente di lavoro Seedance 2.5, la build che ho testato eseguiva un output di 5 secondi a 720p con livelli di qualità Fast, Ultra e UltraS, un'opzione per attivare/disattivare l'audio nativo e una serie di elementi di riferimento che è possibile agganciare per ancorare un personaggio. Questo è l'ambiente rispetto al quale viene valutato tutto il resto, ed è il livello in cui Face-Lock ha successo o fallisce.

Cosa significa realmente Face-Lock in Seedance 2.5
APOB AI commercializza “Advanced Face-Lock” come un punto di forza di vendita premium: la capacità di mantenere un’identità coerente su centinaia di post. Eliminando il marketing e Blocco facciale Il modello tratta l'identità del tuo personaggio come un punto di riferimento fisso invece di una nuova ipotesi a ogni fotogramma.
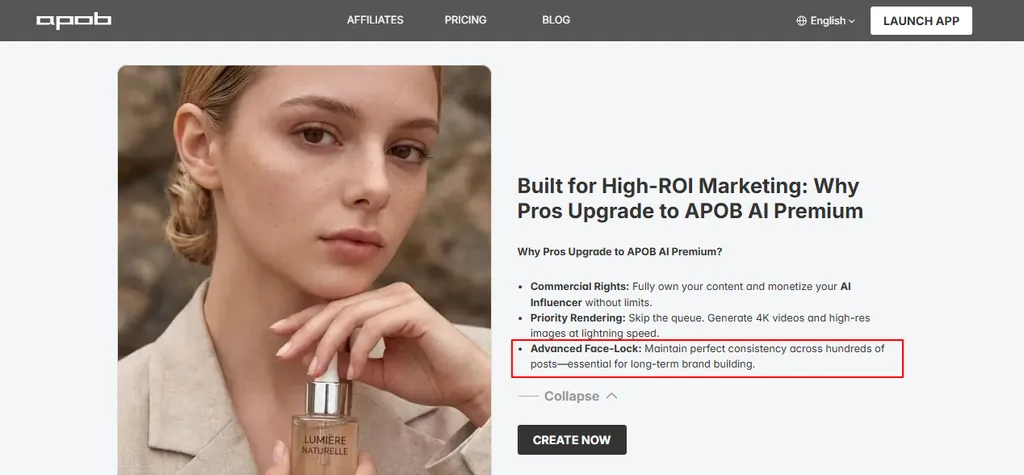
Quando funziona, la persona nella prima inquadratura è la stessa persona nella ventiduesima: stessa mascella, stessa distanza tra gli occhi, stessa texture della pelle, stesse lentiggini, tutto uguale.
È il movimento che rende tutto davvero difficile, ed è importante capirne il perché prima di dare la colpa allo strumento. AI I modelli video non hanno una memoria interna del volto: lo ricostruiscono a partire dall'immagine di riferimento e dal prompt in ogni fotogramma.
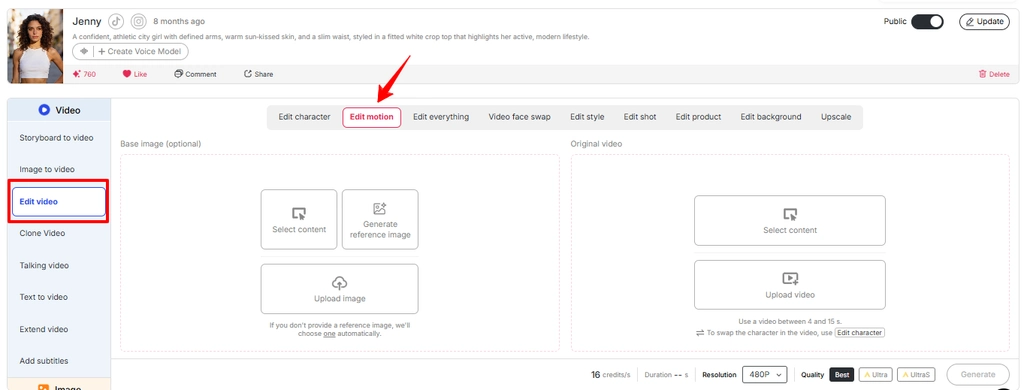
Una rotazione della testa costringe il modello a inventare angolazioni che non aveva mai visto nell'immagine di partenza. Un arco di ripresa ricostruisce il volto da nuove posizioni. I dialoghi ridisegnano continuamente bocca, mento e guance. Ognuna di queste situazioni rappresenta un'opportunità per l'identità di cambiare, e questo cambiamento si manifesta solitamente nei fotogrammi in cui il modello aveva meno informazioni a disposizione.
Un trucco sul campo che mi ha risparmiato un sacco di crediti sprecati: osservate i piccoli dettagli come un sistema di allarme precoce. Se un logo sulla maglietta si smussa o si capovolge a metà clip, quasi sempre anche il viso trema. Nei, lentiggini, tatuaggi e tratti asimmetrici sono i canarini: logo stabile, viso stabile, e tendono a cambiare insieme. Se questi elementi rimangono intatti per tutta la durata della clip, di solito anche l'identità del personaggio rimane tale.
La mia prova con Seedance 2.5: il viso rimane stabile anche in movimento?
Non volevo una testa parlante seduta su una sedia. È la solita tattica facile che usano in ogni manifestazione. Volevo del movimento che mettesse davvero sotto pressione l'identità.
L'impostazione, direttamente dal pannello Testo a video: una scena verticale di una città al neon in formato 9:16, un soggetto che cammina su un marciapiede bagnato con riflessi e una lenta inquadratura cinematografica in primo piano. Le impostazioni erano 720P, qualità UltraS, 5 secondi. Il tutto è terminato in circa due minuti al costo visualizzato di 1,000 crediti, ovvero 200 crediti al secondo. Ho eseguito diverse varianti dello stesso brief per assicurarmi che il primo risultato non fosse frutto del caso.
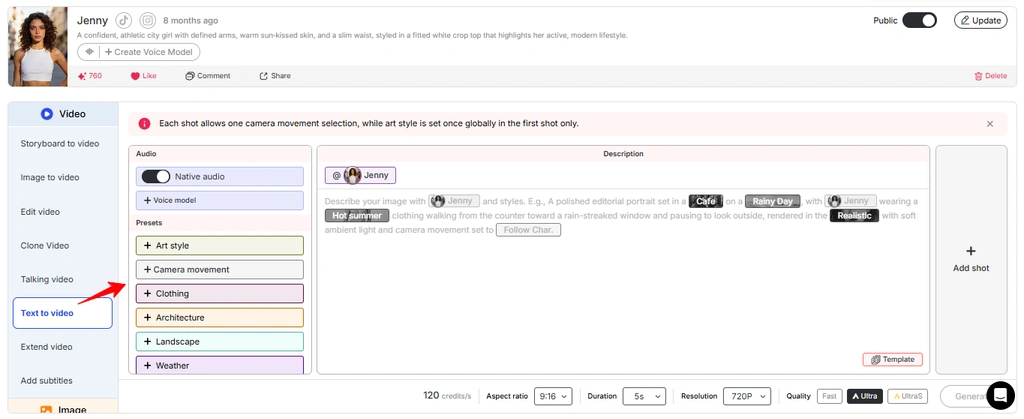
Ciò che ha retto mi ha davvero sorpreso. Durante l'intero ciclo di camminata e la fase di avvicinamento, il soggetto è rimasto visivamente stabile: non si è fuso con uno sconosciuto, la silhouette ha mantenuto la sua forma e l'identità è apparsa come quella di un'unica persona dall'inizio alla fine.
Anche i riflessi sul terreno bagnato e l'illuminazione al neon sono stati riprodotti in modo convincente, il che di solito indica che la modella ha compreso la scena abbastanza bene da mantenere il soggetto ancorato alla realtà, anziché farlo fluttuare in un mare di pixel. Per un soggetto in movimento con una distanza variabile dalla fotocamera, si tratta di un risultato più che accettabile, non di un premio di consolazione.
I punti critici si sono manifestati esattamente dove ci si aspetterebbe. Rotazioni rapide, occlusioni (qualcosa che passa brevemente davanti al viso) e ampie oscillazioni dell'espressione facciale rimangono le zone più pericolose.
Nei fotogrammi in cui la modella ha dovuto inventare un'angolazione per la quale non aveva alcun riferimento, i micro-dettagli si sono leggermente spostati: un sopracciglio leggermente diverso, una mascella ammorbidita per un istante prima di tornare alla normalità. E quando ho elaborato i dialoghi tramite l'audio nativo, la zona della bocca ha sopportato il carico maggiore, ed è lì che si notano per primi eventuali slittamenti.
Verdetto onesto: Blocco del volto in Seedance 2.5 su APOB AI sopravvive al movimento ordinario — camminare, movimenti della telecamera cinematografica, curve moderate — chiaramente meglio del più vecchio AI strumenti video L'ho usata. Non è a prova di proiettile in caso di rotazioni aggressive o dialoghi lunghi e ricchi di espressioni. Il consiglio pratico è: fidatevi per la maggior parte delle riprese, controllatele a campione per quelle più rischiose e tenete a portata di mano uno strumento di riparazione per i rari casi di errore.
La tua immagine di riferimento decide se il blocco del volto sopravvive
Quasi ogni volta che Face-Lock non funzionava per me, il vero colpevole era l'immagine di riferimento, non il modello. Se gli si fornisce un selfie sfocato, di profilo e con poca luce, gli si chiede di indovinare gran parte del viso, e proprio da questa intuizione inizia il problema. Come concordano i creatori di contenuti che puntano alla coerenza dei personaggi , la soluzione è un punto di riferimento identitario, non solo un suggerimento migliore.
Le regole di riferimento che hanno realmente influenzato i miei risultati, all'incirca in ordine di impatto:
Quella è la linea di demarcazione tra un video amatoriale e qualcosa che pubblicheresti su un account di un brand e condivideresti quotidianamente.
Promuovendo Seedance 2.5, così l'identità rimane intatta.
La traccia è l'altra metà dell'equazione. Tracce libere invitano il modello a improvvisare, ed è proprio l'improvvisazione che fa sì che le espressioni facciali cambino. Tracce rigide, invece, gli forniscono un percorso predefinito.
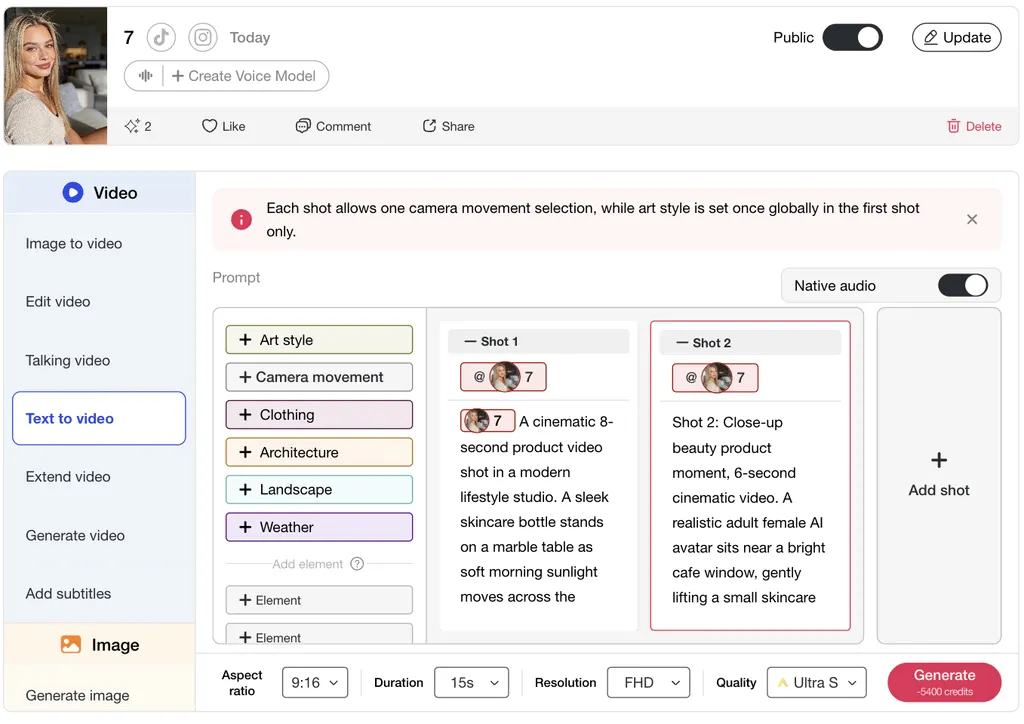
La struttura che mi ha permesso di ottenere un'inquadratura più ravvicinata è stata costantemente questa: soggetto → azione principale → ambiente → movimento di macchina → illuminazione → stile → audio → vincoli.
Quest'ultimo blocco, quello dei vincoli, è quello che la maggior parte delle persone salta. Aggiungere "niente testo, niente loghi, niente dialoghi" quando non sono necessari all'inquadratura elimina gli elementi casuali che destabilizzano la scena. Se non è necessario che la bocca si muova, è meglio non inserire dialoghi; una bocca immobile è una bocca stabile, punto e basta.
Fai in modo che ogni inquadratura rappresenti un'azione chiara. "Cammina, si gira, ride e saluta" sono quattro diverse occasioni per muoversi in cinque secondi. "Cammina verso la telecamera, con un'espressione calma" è un'azione precisa che la modella può effettivamente mantenere. Quindi, concatena queste azioni precise utilizzando il controllo Aggiungi inquadratura o lo strumento Estendi video, mantenendo la stessa descrizione del personaggio per ognuna di esse.
Nelle riprese video, la delicatezza è sempre meglio dell'appariscenza: una lenta carrellata o una ripresa stabile preservano un volto molto meglio di un'orbita veloce che lo fa passare attraverso angolazioni che il soggetto non ha mai visto. Se un'orbita eroica è irrinunciabile, generatela e poi correggete i fotogrammi persi in seguito, invece di sperare.
Come la conversione da immagine a video e il controllo dell'ultimo fotogramma aiutano il blocco del volto
Una funzionalità che merita una menzione a parte: la conversione da immagine a video con controllo del primo e dell'ultimo fotogramma. Seedance 2.5 considera l'ultimo fotogramma non più come un vago suggerimento, ma come un punto di arrivo imprescindibile. Per i lavori di identità visiva, questa è una vera e propria superpotenza.
Il flusso di lavoro che ho preferito è il seguente: prima di tutto, creare un'immagine principale di grande impatto, con personaggio, abbigliamento, sfondo e atmosfera ben definiti; poi importare quell'immagine in Image to Video come fotogramma di apertura.
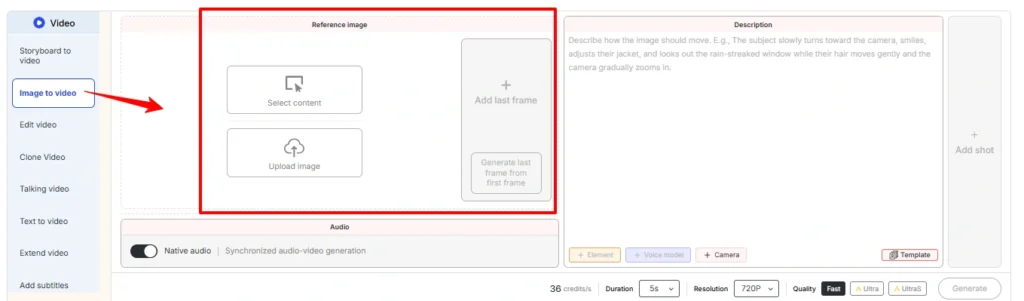
Se hai una posa finale pulita, impostala anche come ultimo fotogramma. Poiché ora il modello interpola tra due immagini fisse e corrette per l'identità, invece di inventare un finale da zero, c'è molto meno spazio perché il viso si muova nel mezzo.
Mantenere il contatto visivo durante le riprese e le estensioni
Una singola clip è la modalità facile. La vera prova è una sequenza: lo stesso personaggio in cinque inquadrature, oppure una breve clip allungata in qualcosa di più lungo, che rimanga comunque percepibile come un'unica persona dall'inizio alla fine.
È qui che la disciplina del flusso di lavoro si rivela fondamentale. Extend Video mantiene una clip di riferimento e, secondo le note del modello di ByteDance, mira a preservare la coerenza del personaggio principale, dell'ambiente e del ritmo in ogni fase dell'estensione.
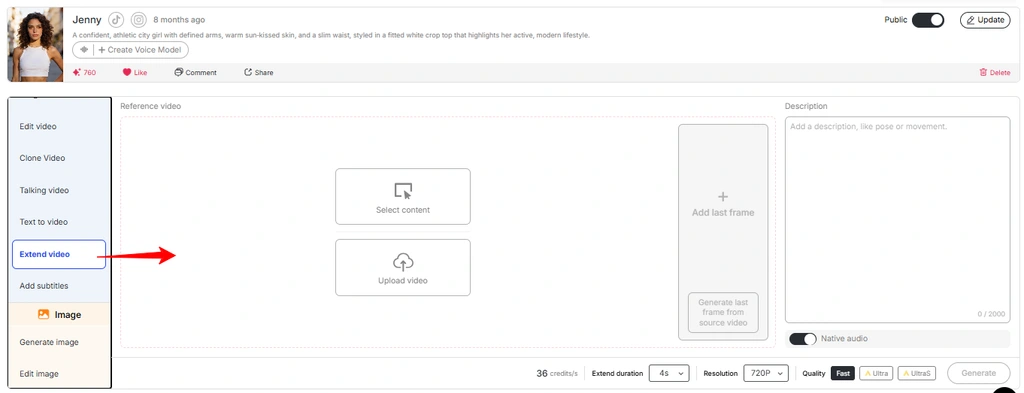
In pratica, più la descrizione varia tra una sessione e l'altra, più velocemente l'identità del personaggio si erode. Tratta la scheda del tuo personaggio come una risorsa di produzione bloccata: stesse parole, stesso riferimento, sempre.
Per le riprese composte da più inquadrature, strutturate la lista delle inquadrature puntando sulla continuità, non sulla varietà: riutilizzate la descrizione del soggetto parola per parola, mantenete i riferimenti agli abiti e cambiate solo l'azione e l'ambientazione tra un'inquadratura e l'altra.
Se, nonostante tutto, un volto dovesse comunque spostarsi, Video Face Swap e Edit Video ( ReVideo ) consentono di correggere segmenti specifici anziché rigenerare l'intero filmato e ricominciare da capo con l'identificazione. Nella versione che ho testato, Edit Video accettava caricamenti da 3 a 30 secondi a 720p, permettendo così di correggere con precisione un'oscillazione di due secondi senza intaccare il resto del filmato.
Come si confronta Seedance 2.5 Face-Lock con altri AI Modelli video
Il contesto è importante in questo caso, perché "buono" ha un significato solo se confrontato con gli altri risultati. Nei confronti generali con il 2026, il quadro si presenta più o meno così:
I modelli di classe Veo tendono a eccellere nel fotorealismo dei primi piani e nell'audio sincronizzato con le labbra, i modelli di classe Kling sono forti nei colori cinematografici e nei dialoghi tra più personaggi, ma spesso si affidano all'assemblaggio di più brevi clip, e Seedance 2.5 viene ripetutamente criticato per la rigorosa coerenza dei personaggi e la coerenza spaziale nell'arco di un'unica generazione continua.
Nello specifico, per Face-Lock, la caratteristica di "singola generazione continua" è fondamentale. Quando un modello mantiene un personaggio per tutta la durata di un'inquadratura senza interruzioni, invece di richiedere un lavoro di assemblaggio e sperare, ci sono semplicemente meno punti in cui l'identità può rompersi.
Questa è la ragione pratica per cui Seedance 2.5 è in APOB AI Si rivela affidabile per il lavoro con personaggi ripetuti: il modello è progettato per mantenere stabile un soggetto durante il movimento, e gli strumenti di sovrapposizione e riparazione dei riferimenti di APOB AI si basano proprio su questo punto di forza.
Dove Seedance 2.5 in APOB AI Lotta ancora
Senza giri di parole, ho riscontrato alcuni punti deboli durante le mie partite, e conoscerli permette di risparmiare crediti.
Le scene con più soggetti sono più difficili. Quando diversi personaggi condividono un'inquadratura, il modello divide la sua attenzione e i volti secondari si muovono prima del protagonista. I movimenti fisici aggressivi – capriole, piroette rapide, coreografie veloci – spingono comunque la verosimiglianza fisica al limite, e i volti possono risentirne in quei fotogrammi.
Un dialogo prolungato con ampie variazioni di espressione rimane il metodo più affidabile per rilevare eventuali imperfezioni, poiché la zona della bocca viene continuamente ricostruita e i tratti circostanti si adattano di conseguenza.
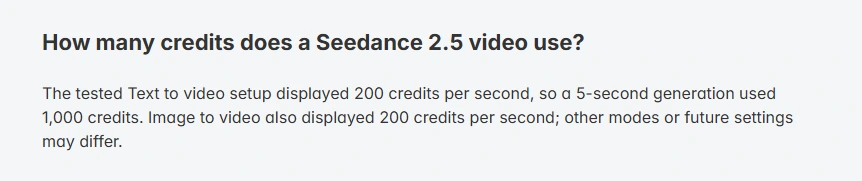
Passiamo quindi agli aspetti pratici. La generazione consuma crediti (200 al secondo in quella prova di conversione da testo a video), le modalità principali di Seedance 2.5 che ho testato avevano un limite di 5 secondi e 720p, e ogni clip viene sottoposta a una revisione prima di essere pubblicata. Interfacce, limiti e prezzi cambiano con gli aggiornamenti del prodotto, quindi considerate le cifre esatte qui riportate come un'istantanea datata piuttosto che come una scheda tecnica permanente.
Sblocco facciale in base al tipo di movimento: Guida rapida
| Tipo di movimento | Affidabilità del sistema di blocco facciale | Gioca in modo intelligente |
|---|---|---|
| Camminata / movimento al rallentatore | Forte | Fidati, un rapido controllo a campione |
| Avanzamento lento / ripresa in movimento | Forte | Ideale per scatti d'effetto |
| moderata rotazione della testa | Buone | Utilizzare un riferimento frontale nitido |
| I2V del primo e dell'ultimo fotogramma | Forte | La scatola si sposta verso entrambe le estremità |
| Orbita della telecamera veloce | Misto | Genera, quindi applica la patch con Face Swap |
| Dialogo intenso + espressione | più debole | Mantieni i segmenti brevi, rivedi attentamente |
| Foto di gruppo con più personaggi | più debole | Ancora un eroe, fai riferimento agli altri |
Risoluzione dei problemi di Face Lock: soluzioni rapide che hanno funzionato
Quando un video tornava con un'immagine sfocata, queste erano le mosse che effettivamente riuscivano a invertirne la tendenza, nell'ordine in cui le provavo:
- Scambia il riferimento prima di toccare il prompt. Nella maggior parte dei casi, un riferimento più nitido e frontale risolve il problema più rapidamente di qualsiasi modifica al prompt.
- Dimezzate l'azione. Se il soggetto stava facendo due cose, eliminatene una. Un battito pulito ogni cinque secondi è la soluzione ideale.
- Elimina i dialoghi superflui. Se non è necessario che la bocca si muova affinché l'inquadratura risulti efficace, rimuovete il brief audio e osservate l'espressione del viso.
- Rallenta la telecamera. Sostituendo l'orbita con una spinta in avanti, la maggior parte delle micro-derive scompare.
- Ripara, non rigenerare. Per correggere una piccola oscillazione localizzata, utilizzare Video Face Swap o Edit Video solo su quei secondi è meglio che rifare l'intera clip e rischiare un risultato peggiore.
Seedance 2.5 è in APOB AI Giusto per te?
Se stai costruendo un AI influencer, un ricorrente portavoce virtualeChe si tratti di una serie di breve formato con un personaggio coerente, o di clip di prodotto in cui un volto deve rimanere in linea con il marchio in decine di post, questa combinazione è perfetta.
Le funzionalità di sovrapposizione dei riferimenti, controllo del primo e dell'ultimo fotogramma, flusso Extend Video e strumenti di riparazione in loco sono pensate proprio per quel continuo ripetersi di personaggi, che è poi il motivo principale per cui Face-Lock è così importante.
Se il tuo lavoro consiste in clip d'azione singole e ricche di movimento, in cui nessuno distingue un volto dall'altro, Face-Lock è molto meno importante e puoi essere più spontaneo e veloce. Il vantaggio principale è la continuità dell'identità, quindi premia i creatori che hanno bisogno che la stessa persona, ripetutamente, mantenga la sua coerenza in un feed.
DOMANDE FREQUENTI
La funzione Face-Lock di Seedance 2.5 resiste ai movimenti rapidi?
Resiste bene ai movimenti ordinari, come camminare, carrellate e rotazioni moderate. Rotazioni rapide, occlusioni e bruschi cambiamenti di espressione sono invece i punti in cui l'identità può vacillare, quindi rivedete attentamente quei filmati e tenete a portata di mano uno strumento di riparazione.
Quale risoluzione e lunghezza ha Seedance 2.5 in APOB AI supporto?
Nella versione che ho testato, le modalità principali di conversione da testo a video e da immagine a video riproducevano clip di 5 secondi a 720p con i livelli Veloce, Ultra e UltraS. La modalità di modifica video gestiva caricamenti da 3 a 30 secondi. Le impostazioni possono cambiare con gli aggiornamenti della piattaforma.
Quanti crediti costa una clip di Seedance 2.5 su APOB AI?
Le configurazioni di conversione da testo a video e da immagine a video testate hanno mostrato 200 crediti al secondo, quindi una clip di 5 secondi ha richiesto 1,000 crediti. Le modalità di modifica ed estensione hanno mostrato velocità al secondo superiori nello stesso test.
Quali sono le caratteristiche di una buona immagine di riferimento per Face-Lock?
Un volto nitido, ad alta risoluzione, frontale, uniformemente illuminato e con un'espressione neutra. Riferimenti sfocati, laterali o poco luminosi costringono il modello a tirare a indovinare, ed è proprio da qui che iniziano gli errori. L'utilizzo di angolazioni multiple e coerenti è di ulteriore aiuto.
Posso mantenere lo stesso personaggio in più inquadrature ed estensioni?
Sì. Riutilizza la stessa identica descrizione del personaggio in ogni inquadratura, mantieni gli elementi di riferimento allegati e usa Extend Video per preservare l'identità. Più la formulazione cambia tra un round e l'altro, più velocemente l'identità si erode.
L'audio nativo influisce sulla stabilità del volto?
Può succedere. I dialoghi ridisegnano la zona della bocca a ogni fotogramma, quindi i segmenti di dialogo lunghi sono il punto in cui è più comune notare lo slittamento. Se una scena non necessita di dialoghi, è meglio ometterli per un aggancio più pulito.
Come si confronta Seedance 2.5 con Veo o Kling in termini di coerenza?
Ampi confronti con i modelli del 2026 mettono i modelli di classe Veo in vantaggio per il realismo dei primi piani e quelli di classe Kling in vantaggio per le sequenze cinematiche con più personaggi, mentre Seedance 2.5 viene ripetutamente elogiato per la rigorosa coerenza dei personaggi in un'unica generazione continua, caratteristica di cui beneficia esattamente Face-Lock.
Considerazioni finali su Seedance 2.5 in APOB AI
Blocco del volto in Seedance 2.5 su APOB AI Non è magia, ma è davvero valido dove conta. Con il movimento che la maggior parte dei creatori di contenuti utilizza effettivamente nelle riprese (soggetti in movimento, movimenti di macchina cinematografici, rotazioni moderate), l'identità del soggetto si è mantenuta stabile durante i miei test, e la clip ambientata nella città al neon lo ha confermato: soggetto stabile, illuminazione coerente, nessun cambio di personaggio a metà ripresa.
Spingendosi verso orbite veloci, occlusioni e lunghi dialoghi espressivi, si possono comunque riscontrare delle piccole imperfezioni, quindi la revisione rimane parte integrante del lavoro.
La mossa vincente è la disciplina della vecchia scuola: un riferimento frontale preciso, una descrizione del personaggio bloccata e riutilizzata parola per parola, un'azione pulita per inquadratura, movimenti di macchina delicati, controllo del primo e dell'ultimo fotogramma quando possibile, e Face Swap o Edit Video pronti a correggere i rari errori.
Fai così e otterrai la cosa AI il video ha continuato a promettere per anni: lo stesso volto, che si muove attraverso il movimento reale, ancora riconoscibile Your personaggio dalla prima all'ultima inquadratura.
AiMojo consiglia:


 BONUS: Ottieni i nostri 200$ "AI "Mastery Toolkit" GRATIS se ti registri!


