

La ricerca sui creator mi assorbe silenziosamente interi pomeriggi. Scorrere TikTok, YouTube e Instagram, copiare il numero di visualizzazioni in un foglio, per poi perdere di vista quel singolo post che contava davvero.
Una casella di posta elettronica settimanale dedicata alla ricerca di autori manda all'aria quella routine.
Apifica gli attori estrarre i post pubblici dei creatori e un flusso di lavoro di automazione n8n valuta ogni post, segnala i valori anomali e chiede un AI modello per individuare schemi di aggancio.
Poi, ogni settimana, lo stesso giorno, arriva in Gmail un riepilogo completo, pronto prima ancora di bere il primo caffè.
Di seguito è riportata la costruzione completa, nodo per nodo, dagli input dell'attore e logica di punteggio dell'impegno a AI riassunti dei contenuti e avvisi di errore. Nessuna teoria, solo un sistema che puoi copiare.
AIMOJO's Rapido verdetto
Cosa ricevi nella tua casella di posta ogni settimana
Prima di modificare un nodo, blocca l'output. Una casella di posta per la ricerca funziona solo quando ogni email risponde alle stesse domande nello stesso ordine.
| Sezione riassuntiva | Cosa mostra | Nodo sorgente |
|---|---|---|
| Valori anomali principali | Post con il maggior numero di visualizzazioni rispetto al creatore's mediana usuale | Nodo del codice di punteggio |
| Responsabili del coinvolgimento | Post con il maggior numero di like, commenti e condivisioni per visualizzazione | Nodo del codice di punteggio |
| Note sul modello | Elementi ricorrenti, formati e argomenti nei post di successo | Catena LLM di base |
| Idee di contenuto | Tre idee che il tuo team può testare questa settimana | Catena LLM di base |
| Link al registro disponibile | Foglio Google con tutti i post estratti per un successivo filtraggio | Nodo Fogli Google |
Le agenzie lo usano per dare istruzioni ai clienti, i team di brand per individuare potenziali partner e i creator indipendenti per monitorare la concorrenza senza dover aprire alcuna app.
Il flusso dei dati rimane semplice:
Scelta degli attori Apify per i dati dei creatori
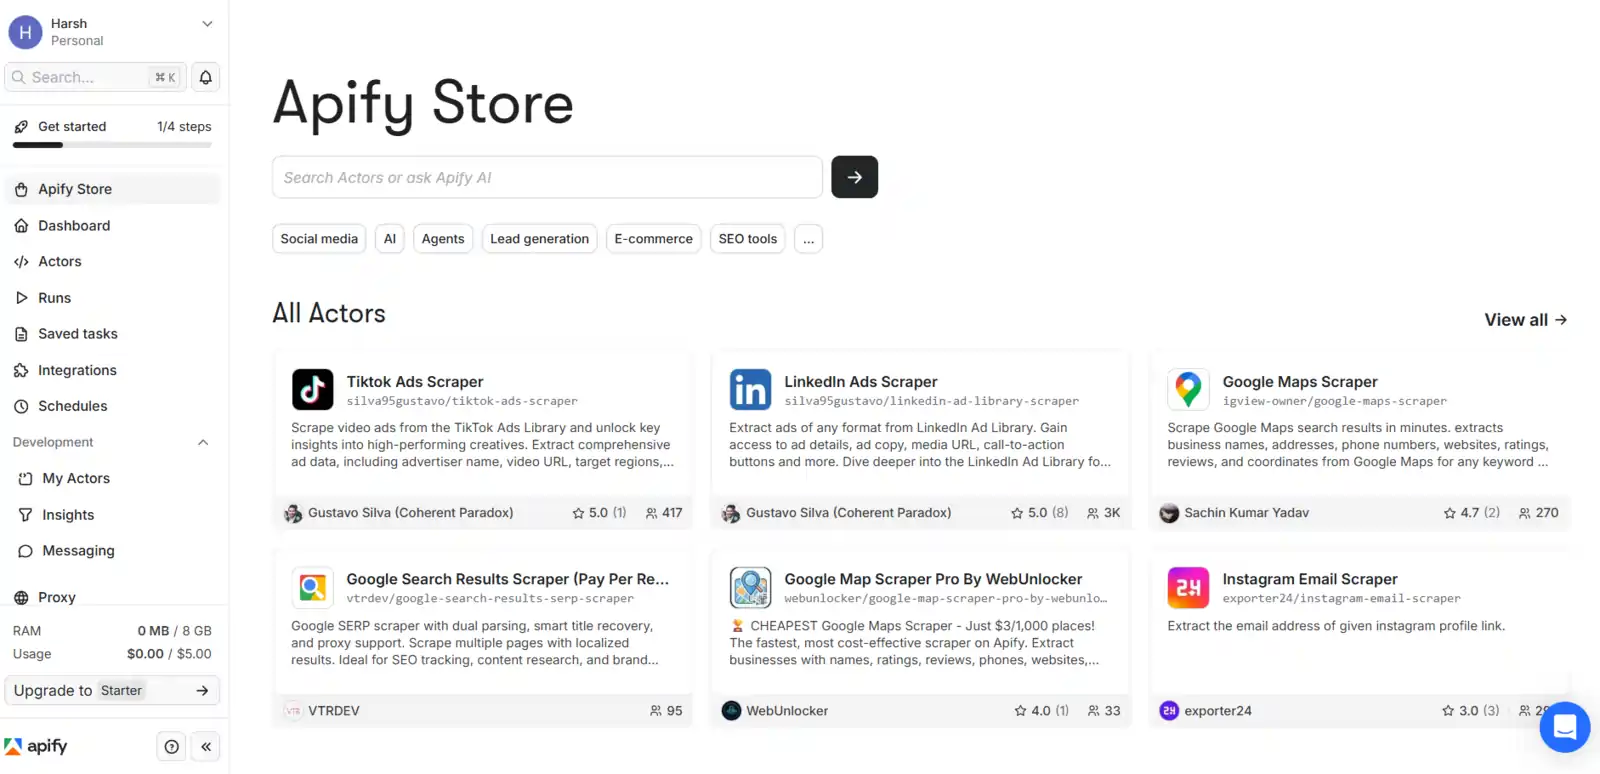
Apify Store offre scraper preconfigurati chiamati Actors. Tre di essi coprono la maggior parte delle esigenze di ricerca dei creatori e ognuno espone filtri per data che consentono di ottenere un flusso di dati settimanale efficiente.
| Attore | Campi di input principali | Campi di output che vale la pena conservare |
|---|---|---|
| YouTube Scraperstreamer/scraper di YouTube | startUrls, maxResults, maxResultsShorts, maxResultStreams, sortVideosBy, oldestPostDate | titolo, url, data, numero di visualizzazioni, like, numero di commenti, nome del canale, numero di iscritti |
| Raschietto TikTokClockworks/tiktok-scraper | profili, risultatiPerPagina, ordinamentoProfili, escludiPostAggiunti, dataPostUnificataPiùVecchia | testo, webVideoUrl, createTimeISO, playCount, diggCount, commentCount, shareCount, collectCount, authorMeta.fans |
| Raschietto Instagramapify/instagram-scraper | directUrls, resultsType, resultsLimit, onlyPostsNewerThan | didascalia, URL, shortCode, timestamp, numero di like, numero di commenti, numero di visualizzazioni video, nome utente del proprietario |
Alcuni dettagli contano qui. YouTube Scraper's L'intervallo di date si applica solo agli URL dei canali e l'impostazione di qualsiasi limite di tipo a 0 ignora completamente tale formato.
La funzione di ordinamento del profilo di TikTok Scraper accetta i profili più recenti, più popolari o più vecchi. I filtri per data sono contrassegnati come filtri a pagamento nella pagina dell'attore, quindi controlla questa informazione prima di attivarli.
Hai bisogno del numero di follower e delle biografie per Instagram? Aggiungi Instagram Profile Scraper (apify/instagram-profile-scraper) con un array di nomi utente. Restituisce il numero di follower, la biografia, lo stato di verifica e gli ultimi post.
Le trascrizioni sono un extra facoltativo. YouTube Scraper's TranscriptionAndSubtitle e TikTok Scraper's downloadSubtitlesOptions tira i ganci parlati, il che rende AI Le note del pattern sono molto più nitide.
All'interno del nodo Apify ufficiale per n8n
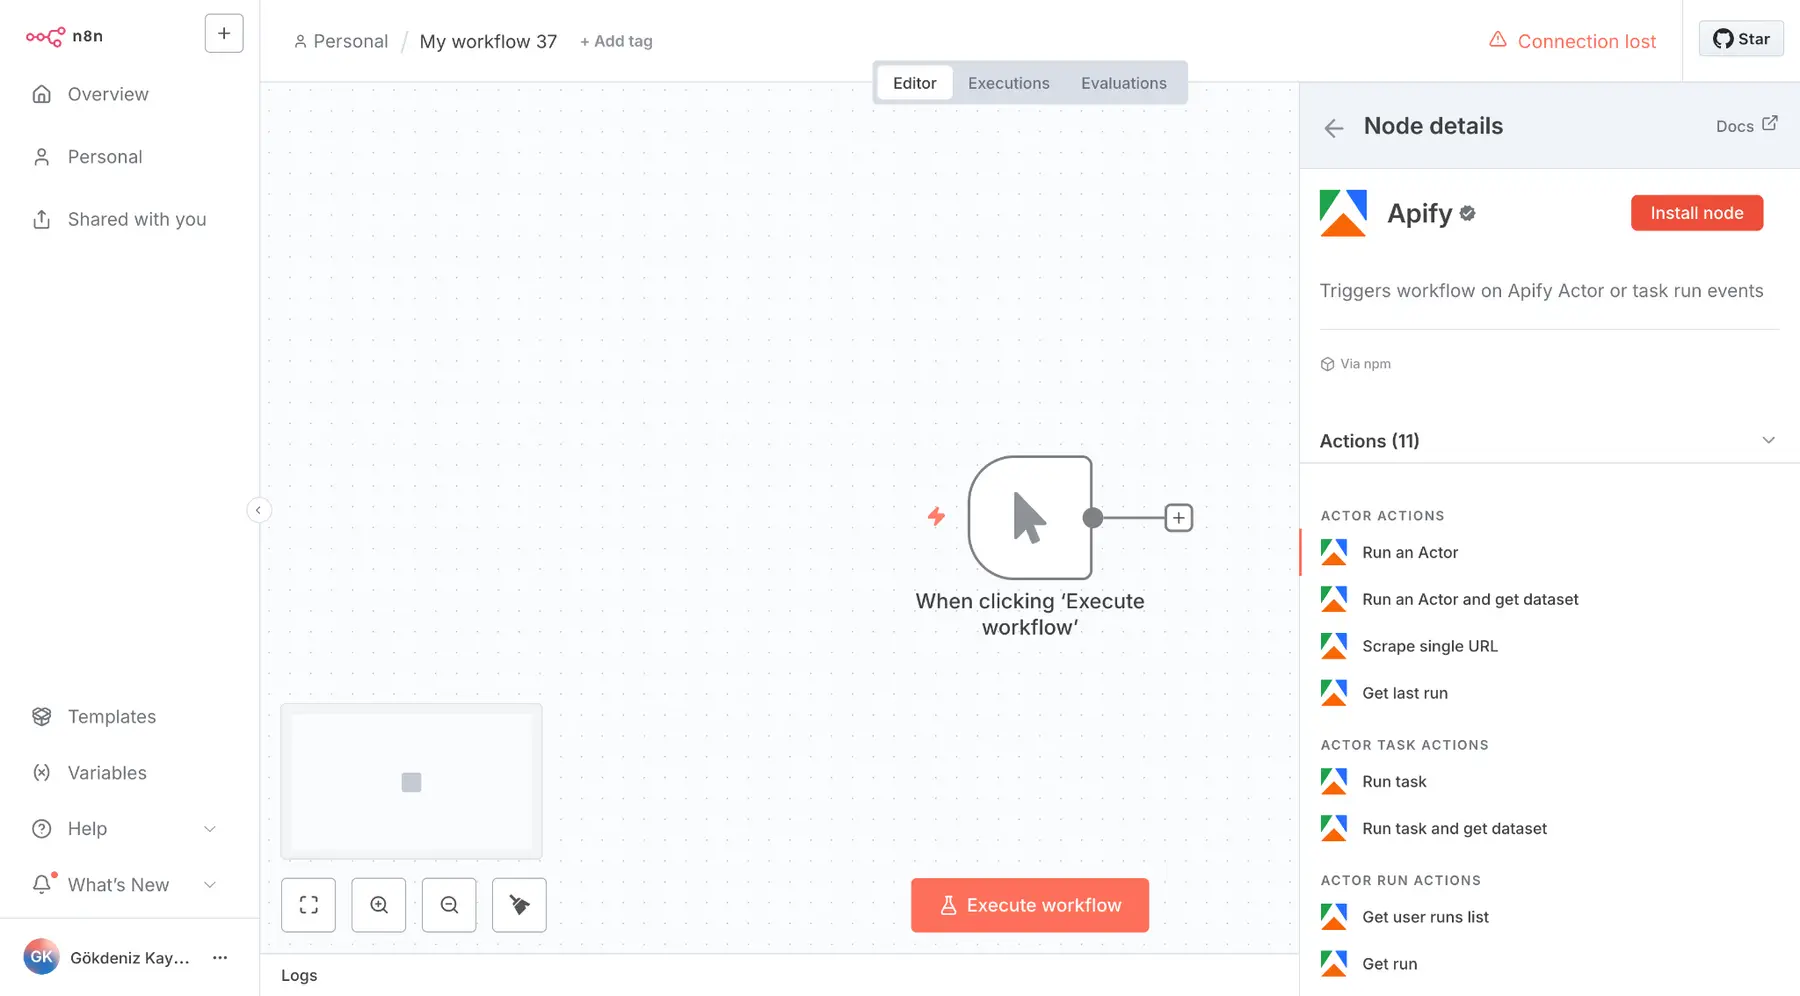
Apify distribuisce un nodo della community verificato, @apify/n8n-nodes-apify. Su n8n Cloud, cerca "Apify" nel pannello dei nodi e installalo, a condizione che i nodi della community verificati siano consentiti nel pannello di amministrazione.
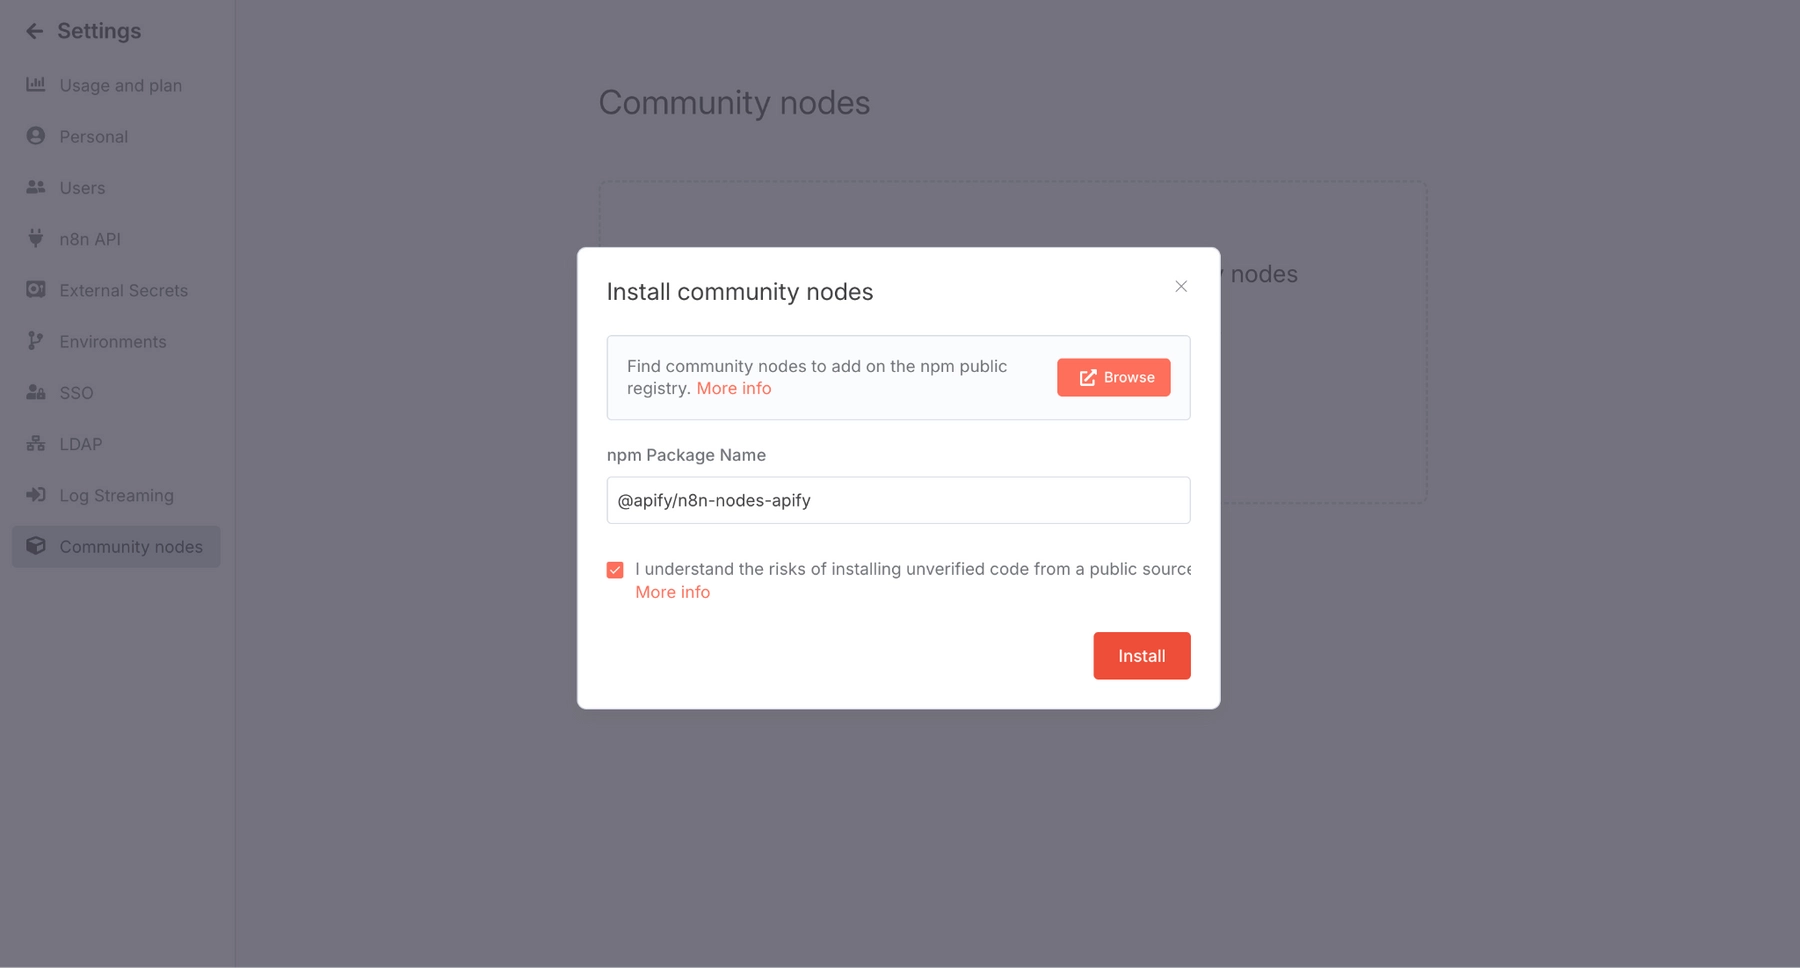
Su un'installazione self-hosted di n8n, apri Impostazioni > Nodi della community , incolla il nome del pacchetto e installalo. Il nodo richiede n8n 1.57.0 o versioni successive.
| Gestione | Operazioni disponibili | Da utilizzare in questa build |
|---|---|---|
| Alimentare | Esegui un attore, esegui un attore e ottieni il suo set di dati, Web Fetch, ottieni l'ultima esecuzione | Fase principale di raschiatura |
| Compiti dell'attore | Esegui un'attività, esegui un'attività e ottieni il suo set di dati | Input più puliti salvati in Apify |
| Esecuzioni di attori | Prendine uno, prendine molti, abortisci | Debug e pulizia |
| Archiviazione | Ottieni gli elementi del dataset, ottieni il record del key-value store | Recupera i risultati tramite defaultDatasetId |
| grilletto | Su un nuovo evento Apify (riuscito, non riuscito, interrotto, timeout, qualsiasi) | Versione divisa della casella di posta per grandi roster |
L'autenticazione funziona in due modi. Le credenziali API di Apify richiedono il token API dalla console di Apify, mentre l'API OAuth2 di Apify si connette con un solo clic esclusivamente su n8n Cloud.
L'operazione Actor espone anche input personalizzato (JSON), timeout in secondi, memoria in megabyte, tag di creazione e attesa del completamento.
Lasciando vuoto il campo di input personalizzato, l'attore utilizzerà il suo input predefinito salvato.
Guida passo passo al flusso di lavoro settimanale di ricerca per i creatori di contenuti
Passaggio 1: Configura l'elenco dei creatori in Fogli Google
Crea un foglio di calcolo chiamato "Creator Roster" con queste colonne. I membri del team potranno aggiungere o sospendere i creatori direttamente da Fogli Google, senza dover aprire n8n.
Aggiungi una seconda scheda chiamata " Registro post" . Ogni post valutato verrà registrato lì, fornendoti uno storico utile per definire parametri di riferimento più precisi nel tempo.
Passaggio 2: Salva ogni scraper come attività dell'attore Apify
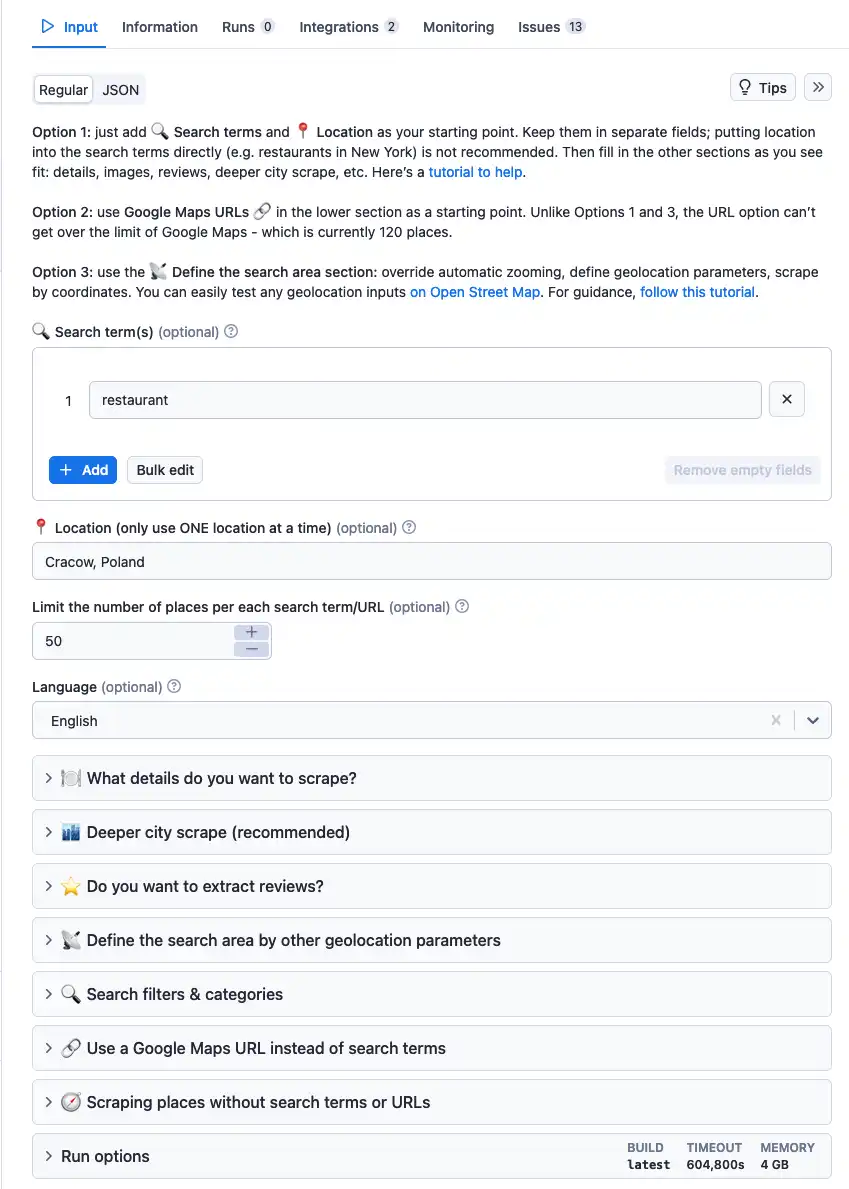
Apri ciascun attore nella console di Apify, imposta dei limiti appropriati e fai clic su Salva come nuova attività.
Le attività Apify Actor memorizzano l'input, il timeout e la memoria, in modo che il lato n8n rimanga ordinato.
Mantieni disattivate tutte le opzioni di download. File video , copertine e avatar aggiungono peso senza facilitare la ricerca.
Passaggio 3: collega Apify, Fogli Google e le credenziali di Gmail
Installa il nodo Apify, quindi aggiungi tre credenziali in n8n: Apify API , Google Sheets OAuth2 e Gmail OAuth2 . Testa ciascuna di esse prima di procedere con la configurazione.
Una credenziale non valida a metà di un flusso di lavoro spreca tempo e risorse per l'estrazione dei dati, quindi questo controllo si rivela fondamentale.
Passaggio 4: Configurare il trigger di pianificazione n8n
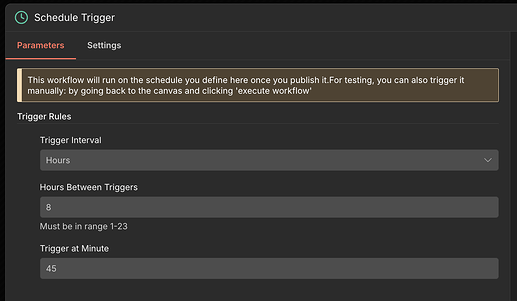
Inserisci un nodo Attivazione pianificazione con queste impostazioni:
| seld | Valore |
|---|---|
| Intervallo di trigger | Settimane |
| Settimane tra gli eventi scatenanti | 1 |
| Attivazione nei giorni feriali | lunedì |
| Attivazione all'ora | 7:XNUMX |
| Attivazione al minuto | 0 |
Imposta un fuso orario in Impostazioni flusso di lavoro . In caso contrario, n8n utilizzerà il fuso orario dell'istanza, mentre le installazioni self-hosted utilizzeranno per impostazione predefinita America/New_York.
Preferisci cron? Usa Personalizzato (Cron) con 0 7 * * 1. In entrambi i casi, il trigger di pianificazione n8n si attiva solo dopo che il flusso di lavoro è stato salvato e pubblicato.
Passaggio 5: Creare gli input della piattaforma con un nodo di codice
Aggiungi un nodo Fogli Google (Ottieni riga/e, scheda Elenco creatore), quindi un nodo Codice. Questo nodo Codice trasforma le righe dell'elenco in un oggetto di input per ciascuna piattaforma.
const rows = $input.all().map(i => i.json).filter(r => r.active === 'yes');

const since = $now.minus({ days: 7 }).toFormat('yyyy-MM-dd');

const pick = p => rows.filter(r => r.platform === p);

return [{ json: {

  youtube: {

    startUrls: pick('youtube').map(r => ({ url: r.profile_url })),

    maxResults: 15, maxResultsShorts: 15, maxResultStreams: 0,

    sortVideosBy: 'NEWEST', oldestPostDate: since

  },

  tiktok: {

    profiles: pick('tiktok').map(r => r.handle),

    resultsPerPage: 20, profileSorting: 'latest',

    excludePinnedPosts: true, oldestPostDateUnified: since

  },

  instagram: {

    directUrls: pick('instagram').map(r => r.profile_url),

    resultsType: 'posts', resultsLimit: 20, onlyPostsNewerThan: since

  }

}}];
$now è n8n's Funzione data integrata di Luxon, quindi la finestra di sette giorni avanza automaticamente ogni settimana. Nessuna modifica manuale della data, mai.
Passaggio 6: Eseguire tre attori Apify in parallelo
Suddividi il nodo Code in tre nodi Apify. Scegli la risorsa Actor Tasks con l'operazione che esegue un'attività e restituisce gli elementi del set di dati.
Nell'input personalizzato, passa l'oggetto corrispondente come espressione:
{{ JSON.stringify($json.youtube) }}Ripeti l'operazione con $json.tiktok e $json.instagram. L'input personalizzato sovrascrive l'input dell'attività salvata, mentre il timeout e la memoria provengono comunque dall'attività stessa.
Preferisci due nodi separati? Esegui l'Actor con l'opzione " Attendi il completamento " attiva, quindi aggiungi " Ottieni elementi del dataset utilizzando {{ $json.defaultDatasetId }}". Entrambi i percorsi restituiscono dati identici.
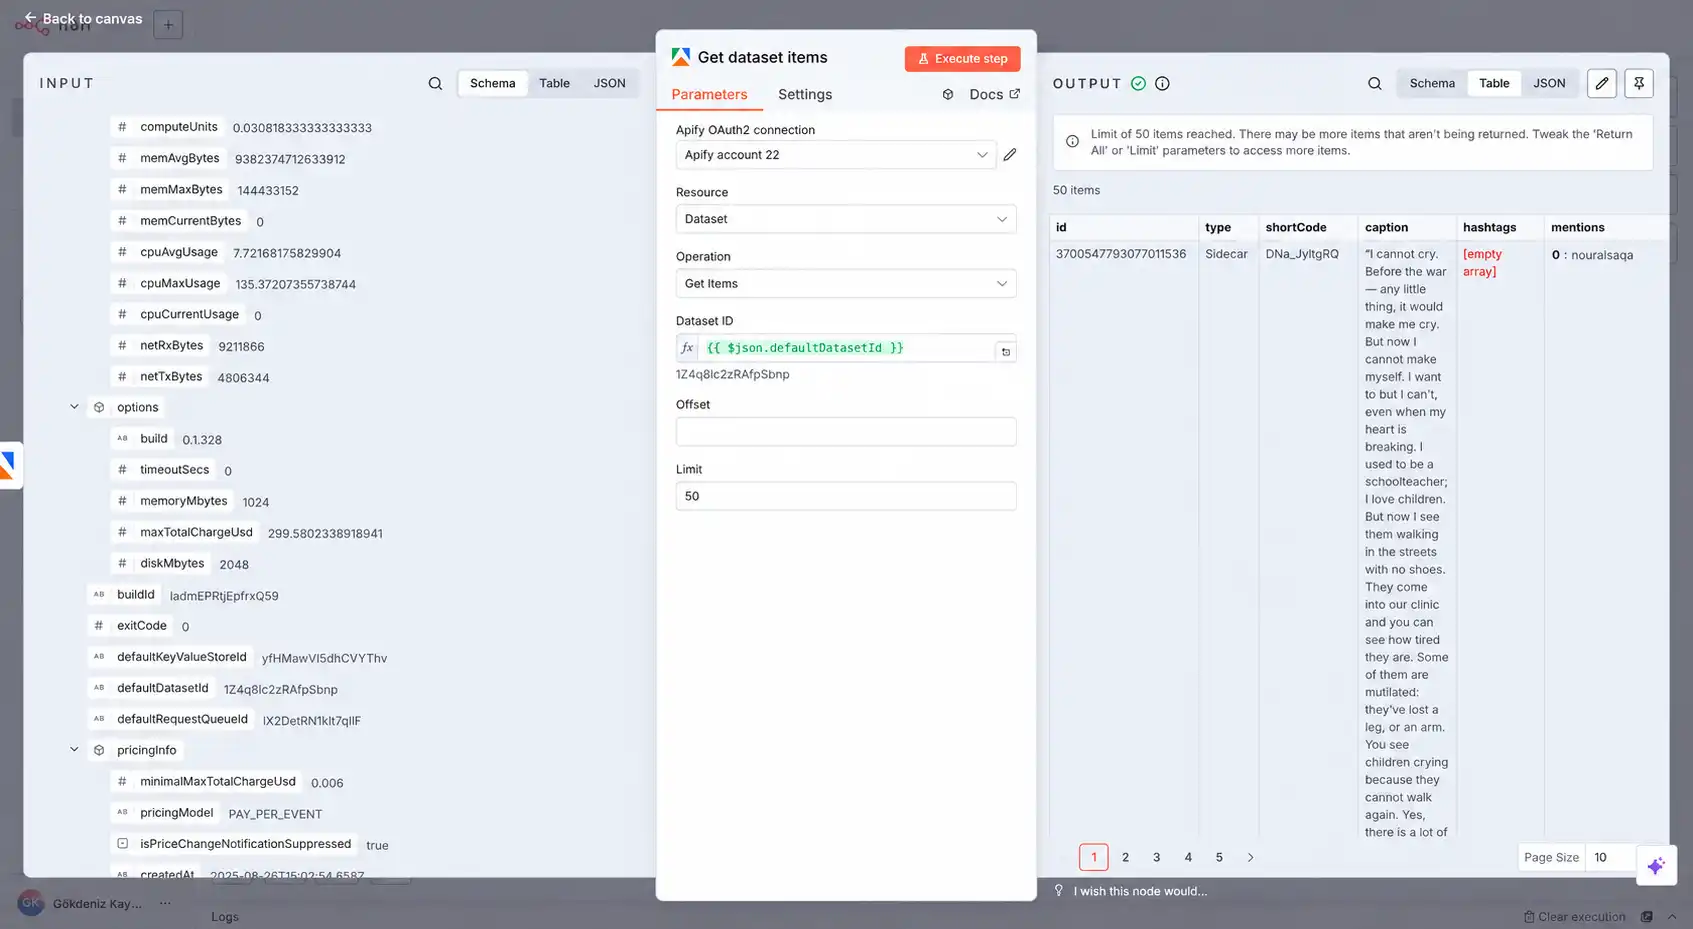
Passaggio 7: Unire e normalizzare in un unico schema
Collega tutti e tre i nodi Apify a un nodo Merge impostato su Append. Ogni piattaforma assegna nomi diversi ai campi, quindi un nodo Code li mappa in un formato condiviso.
const out = [];

for (const { json: p } of $input.all()) {

  if (p.error) continue; // skip failed inputs

  if (p.webVideoUrl) {

    out.push({ platform: 'tiktok', post_id: p.id, creator: p.authorMeta?.name,

      url: p.webVideoUrl, caption: p.text, published: p.createTimeISO,

      views: p.playCount, likes: p.diggCount, comments: p.commentCount,

      shares: p.shareCount });

  } else if (p.shortCode) {

    out.push({ platform: 'instagram', post_id: p.shortCode, creator: p.ownerUsername,

      url: p.url, caption: p.caption, published: p.timestamp,

      views: p.videoViewCount ?? null, likes: p.likesCount,

      comments: p.commentsCount, shares: null });

  } else if (p.viewCount !== undefined) {

    out.push({ platform: 'youtube', post_id: p.id, creator: p.channelName,

      url: p.url, caption: p.title, published: p.date,

      views: p.viewCount, likes: p.likes, comments: p.commentsCount,

      shares: null });

  }

}

return out.map(json => ({ json }));
YouTube Scraper scrive voci di errore per i video eliminati o i canali mancanti. Il controllo p.err li elimina prima che possano falsare il punteggio.
Passaggio 8: Valuta ogni post con i valori anomali e l'analisi del coinvolgimento.
Le visualizzazioni grezze tendono a lusingare i grandi account. Il punteggio di un creatore con un valore anomalo confronta ogni post con la mediana del creatore stesso, quindi il successo di un piccolo canale risalta.
| Metrico | Formula | Quello che ti dice |
|---|---|---|
| Punteggio anomalo | visualizzazioni del post ÷ visualizzazioni mediane del creatore | Quanto un post ha superato il proprio limite di base |
| Engagement Rate | (mi piace + commenti + condivisioni) ÷ visualizzazioni × 100 | Quanto duramente hanno reagito gli spettatori |
| Instagram Fallback | Mi piace al post ÷ Mi piace media del creatore | Funziona per i post con immagini senza conteggio delle visualizzazioni |
const items = $input.all().map(i => i.json);

const base = it => it.views || it.likes || 0;

const groups = {};

for (const it of items) (groups[it.creator] ??= []).push(base(it));

const median = a => { const s = [...a].sort((x, y) => x - y), m = Math.floor(s.length / 2);

  return s.length % 2 ? s[m] : (s[m - 1] + s[m]) / 2; };

return items.map(it => {

  const med = median(groups[it.creator]) || 1;

  const eng = it.views ? ((it.likes || 0) + (it.comments || 0) + (it.shares || 0)) / it.views * 100 : null;

  return { json: { ...it, outlier: +(base(it) / med).toFixed(2),

    engagement: eng === null ? null : +eng.toFixed(2) } };

}).sort((a, b) => b.json.outlier - a.json.outlier);
Una settimana di post fornisce una base di riferimento approssimativa. Dopo alcune settimane, consulta la scheda "Registro post" e calcola le mediane dai dati storici.
Passaggio 9: Blocca le ripetizioni con il nodo Rimuovi duplicati
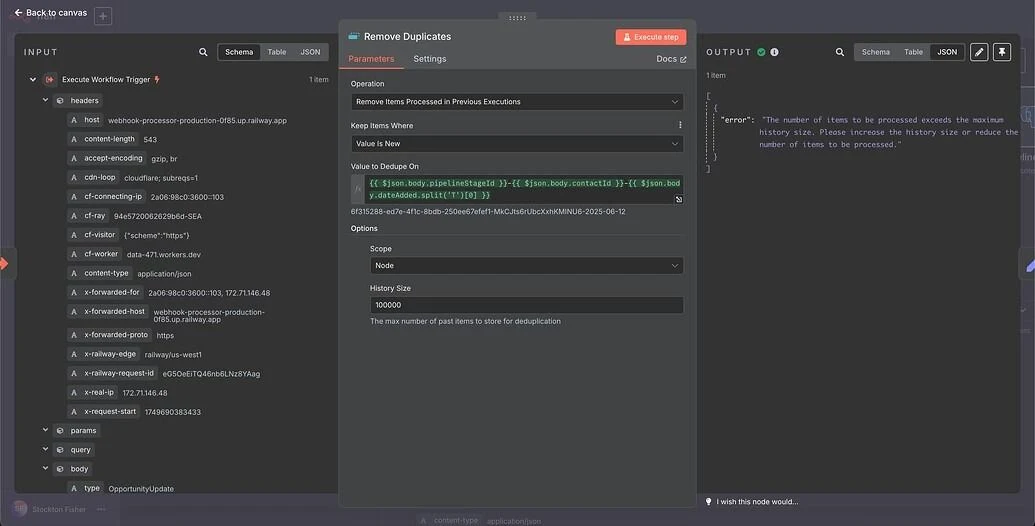
Aggiungi un nodo Rimuovi duplicati dopo il punteggio. Imposta l'operazione su Rimuovi elementi elaborati nelle esecuzioni precedenti e mantieni gli elementi in cui il valore è nuovo.
Questa funzione di deduplicazione permanente impedisce l'invio ripetuto dello stesso post tramite email, anche in caso di attivazione manuale. La funzione "Cancella cronologia deduplicazione" la reimposta durante la fase di test.
Passaggio 10: aggiungi il AI Livello di analisi dei modelli
Utilizza un nodo Limit per mantenere i primi 15 post, quindi un nodo Aggregate impostato su Tutti i dati degli elementi. Questo passa l'intero batch a AI come un unico elemento.
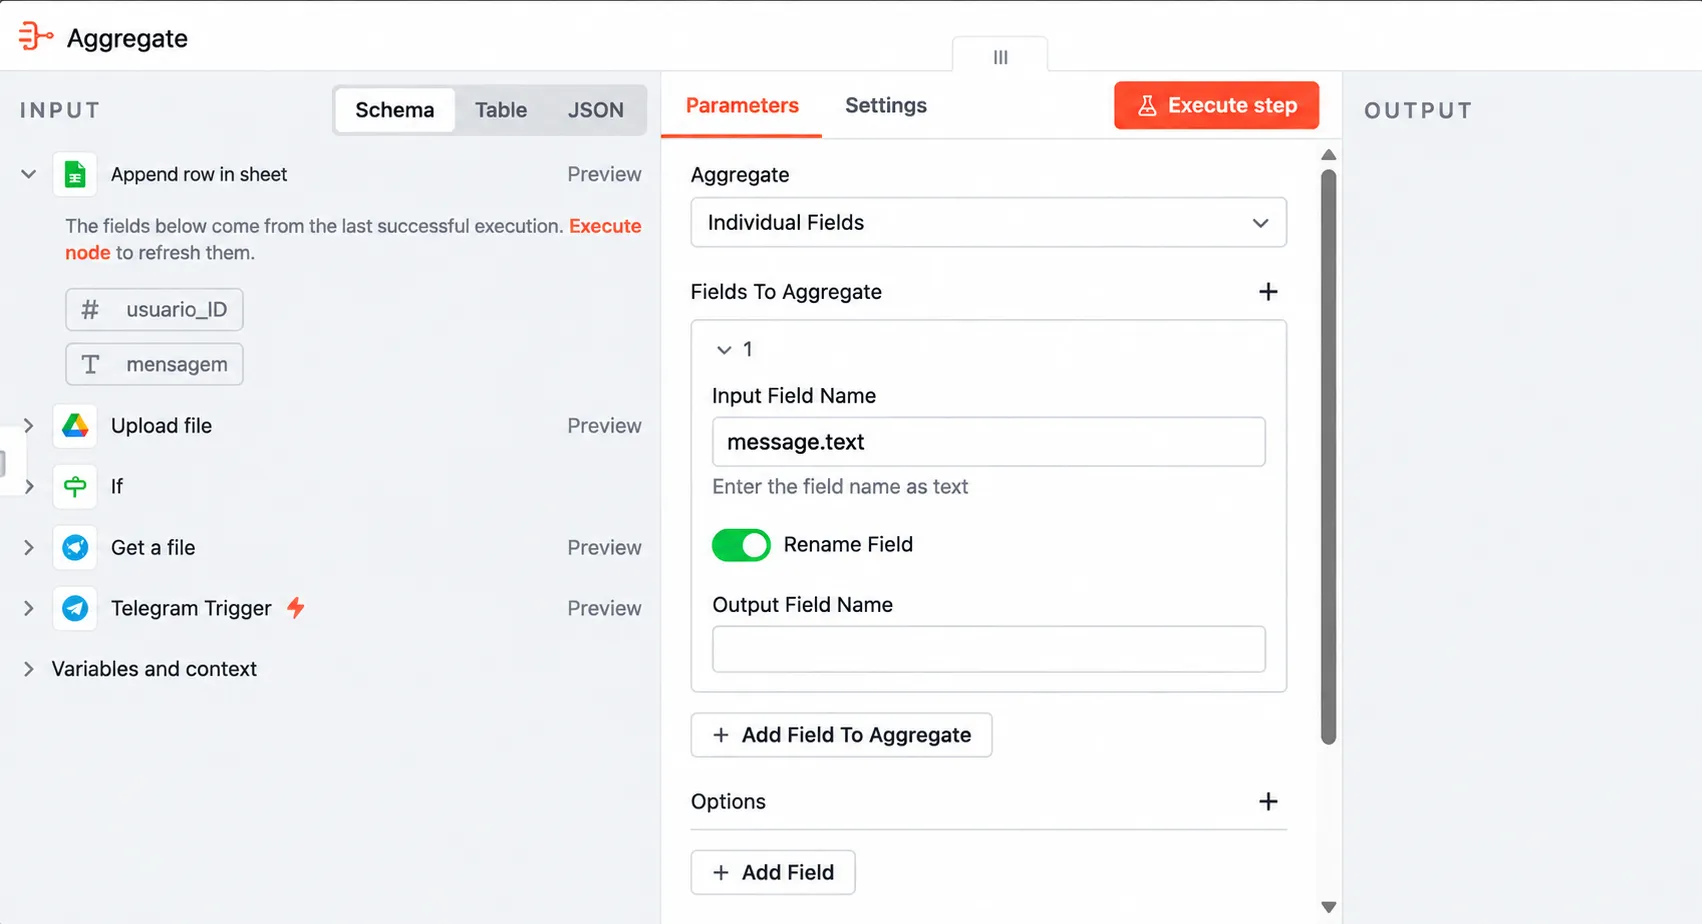
Successivamente, aggiungi una catena LLM di base con un qualsiasi modello di chat che già utilizzi, come OpenAI, Anthropic o Gemini.
Attiva l'opzione "Richiedi formato di output specifico" e collega un analizzatore di output strutturato.
Sei uno stratega di contenuti brevi.
Di seguito i dati di questa settimana's Post dei creatori più popolari in formato JSON, classificati in base al punteggio di anomalia.
Restituisci il JSON con:
– “modelli”: 3 ganci o formati ricorrenti, ciascuno dei quali cita gli URL dei post
– “argomenti”: argomenti presenti in almeno 2 articoli vincenti
– “Idee”: 3 idee di contenuti che il nostro team può girare questa settimana
Utilizza solo prove tratte dai dati. Se uno schema è debole, dillo.
{{ JSON.stringify($json.data) }}I sottotitoli da soli non riescono a catturare l'attenzione con la voce, elemento che di solito rende efficace un breve video.'s destino.
Con la trascrizione attivata nell'attività di YouTube o TikTok, riporta le righe iniziali del testo dei sottotitoli nell'elemento normalizzato.
Riduci quel testo a circa i primi 300 caratteri. Il modello confronta quindi le vere linee di apertura tra i vincitori e l'utilizzo dei token rimane basso.
La frase “usa solo le prove” è importante. Mantiene AI contenuto Analisi dei modelli basata su post reali anziché su chiacchiere generiche sulle tendenze.
Passaggio 11: Assembla il riepilogo HTML e invialo tramite Gmail
Un nodo di codice finale accoppia i post con punteggio AI genera l'output e costruisce il corpo dell'e-mail:
const posts = $('Limit').all().map(i => i.json);

const ai = ('BasicLLMChain').first().json.output;constrows=posts.map(p=>`<tr><td>{p.platform}</td><td>p.creator</td><td><ahref="{p.url}">(p.caption||'').slice(0,70)</a></td><td>{p.outlier}x</td><td>p.engagement??'–'%</td></tr>`).join('');consthtml=`<h2>TopOutliers</h2><tableborder="1"cellpadding="6">{rows}</table>

  <h2>Patterns</h2><ul>${ai.patterns.map(x => `<li>${x}</li>`).join('')}</ul>

  <h2>Ideas</h2><ul>${ai.ideas.map(x => `<li>${x}</li>`).join('')}</ul>`;

return [{ json: { html } }];const items = $input.all().map(i => i.json);

const base = it => it.views || it.likes || 0;

const groups = {};

for (const it of items) (groups[it.creator] ??= []).push(base(it));

const median = a => { const s = [...a].sort((x, y) => x - y), m = Math.floor(s.length / 2);

  return s.length % 2 ? s[m] : (s[m - 1] + s[m]) / 2; };

return items.map(it => {

  const med = median(groups[it.creator]) || 1;

  const eng = it.views ? ((it.likes || 0) + (it.comments || 0) + (it.shares || 0)) / it.views * 100 : null;

  return { json: { ...it, outlier: +(base(it) / med).toFixed(2),

    engagement: eng === null ? null : +eng.toFixed(2) } };

}).sort((a, b) => b.json.outlier - a.json.outlier);
Aggiungi quindi un nodo Gmail con queste impostazioni:
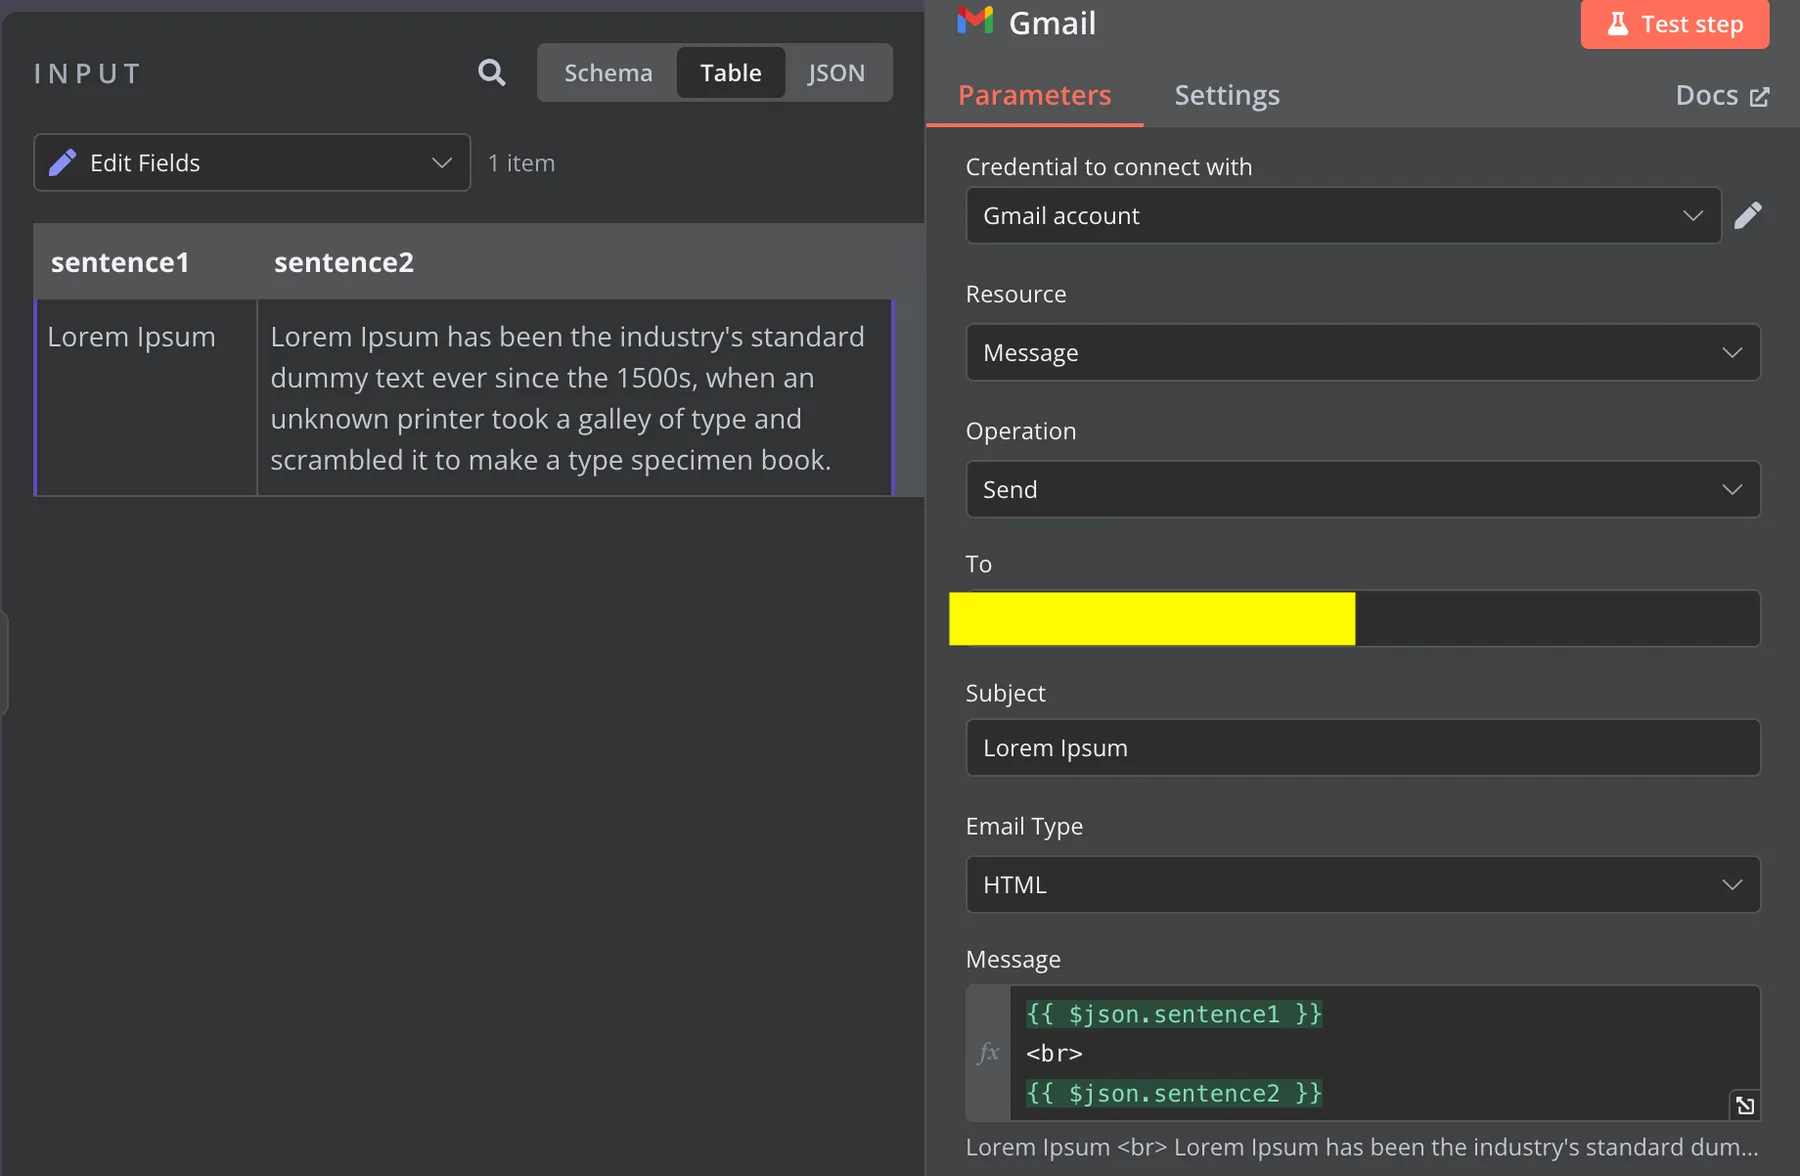
Passaggio 12: Registra i post su Fogli Google e pubblicali
Dal nodo "Rimuovi duplicati", crea un collegamento a un nodo Fogli Google utilizzando "Aggiungi riga" o "Aggiorna riga" nella scheda "Registro post". Applica la corrispondenza all'ID del post in modo che le statistiche aggiornate sovrascrivano le righe precedenti.
Imposta la mappatura su "Mappa automaticamente" , poiché i nomi dei campi normalizzati corrispondono già alle colonne. Esegui manualmente una volta, controlla l'e-mail, quindi pubblica il flusso di lavoro.
Scalabilità con Apify: pianificazioni e trigger di eventi
Un singolo flusso di lavoro programmato è adatto a gruppi di poche decine di creatori. Oltre tale limite, i processi di scraping di lunga durata mantengono le esecuzioni di n8n aperte per minuti e una piattaforma lenta blocca tutte le altre.
La correzione suddivide il lavoro tra le due piattaforme:
| Fattore | Flusso di lavoro singolo | Flusso di lavoro suddiviso |
|---|---|---|
| Tempo di preparazione | Faster | Leggermente più lungo |
| Lavori di raschiatura lunghi | L'esecuzione attende per tutto il tempo | Nessuna attesa all'interno di n8n |
| Una piattaforma fallisce | Può bloccare la digestione | Altri atterrano ancora |
| Esigenze di self-hosting | Niente di extra | URL WEBHOOK pubblico per il trigger |
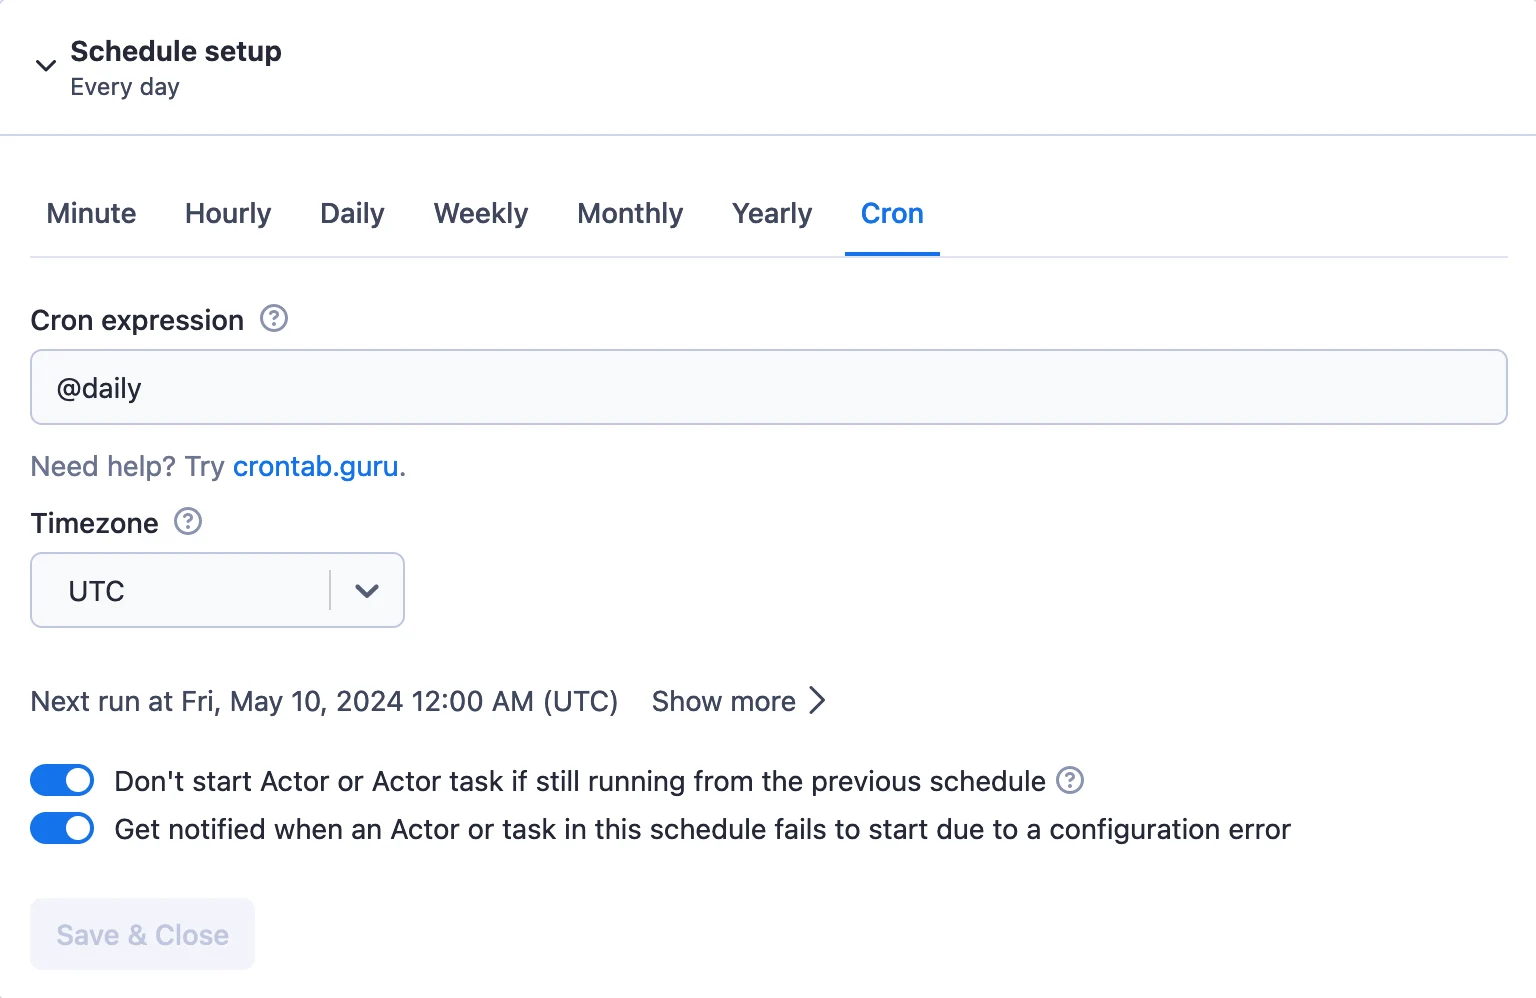
Le nuove pianificazioni di Apify sono inizialmente disabilitate, quindi abilitale dopo averle salvate. Apify ti invia anche un'email quando un'attività pianificata non si avvia.
Mantenere la pipeline in salute settimana dopo settimana
I fallimenti silenziosi sono il vero nemico. Una casella di posta vuota è sinonimo di una settimana tranquilla, quindi imposta gli avvisi fin dal primo giorno.
L'utilizzo rimane contenuto grazie ai soli limiti di input. Finestre temporali ristrette, risultati limitati per profilo e trascrizioni disponibili solo quando necessario mantengono ogni richiesta settimanale di dimensioni ridotte.
Dove lo scraping dei creatori raggiunge i veri limiti
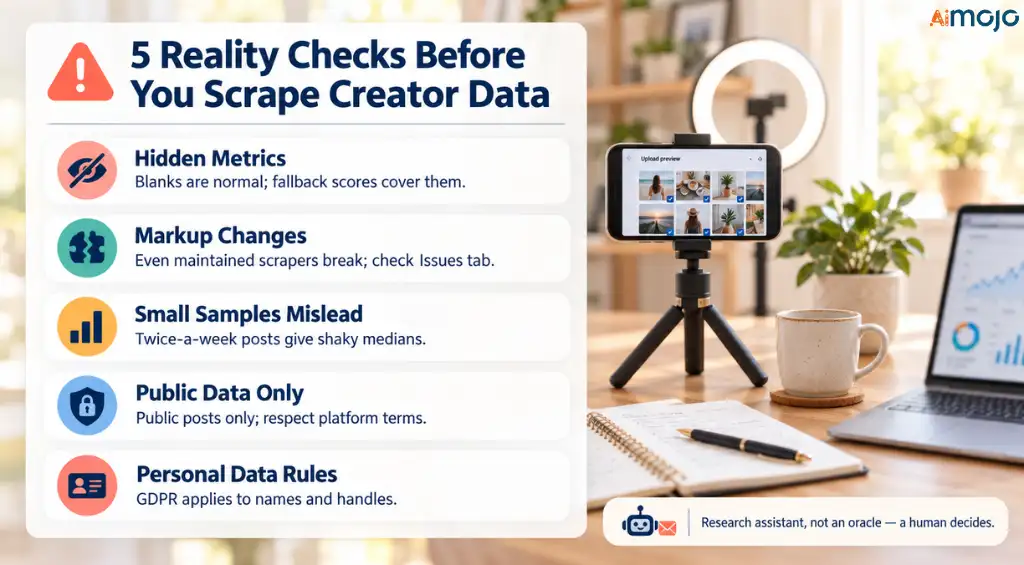
Tutte le presentazioni sull'automazione tralasciano questa parte, quindi eccola qui, in modo chiaro e conciso.
Considera la casella di posta come un assistente di ricerca , non come un oracolo. È pur sempre un essere umano a decidere quale modello merita di essere fotografato.
Risposte rapide su Apify e n8n Creator Research
È possibile attivare gli Apify Actors tramite n8n senza codice?
Il nodo Apify ufficiale esegue attori o attività, attende i risultati e restituisce gli elementi del dataset, il tutto configurato tramite campi in n8n.
Quali creatori può tracciare questo flusso di lavoro?
Qualsiasi canale YouTube pubblico, profilo TikTok o account Instagram. Sostituisci con altri Apify Store Actors per aggiungere altre piattaforme.
Il nodo Apify funziona come un AI Strumento per agenti?
Aggiungere il Strumento Apify sotto un AI Agente's strumenti che consentono a un modello di attivare scraping su richiesta da una chat.
Conclusione
La ricerca dei creatori premia chi individua per primo uno schema. Lo scorrimento manuale lo trasforma in un lavoro a tempo pieno, e la maggior parte dei team si arrende silenziosamente dopo poche settimane.
Apify e n8n affidano quel compito a un sistema.
Gli attori dello store estraggono i nuovi post pubblici, i nodi del codice li valutano rispetto a ciascun creatore's la propria linea di base e un AI strato trasforma i numeri in brevi sintesi.
Inizia con un singolo flusso di lavoro programmato e cinque creatori che già segui. Una volta che il riepilogo si sarà rivelato utile, amplia l'elenco e passa alla configurazione suddivisa con Apify Schedules.
Dagli tre o quattro settimane di cronologia registrata.'s quando i punteggi anomali si fanno più nitidi e la tua casella di posta del lunedì inizia a superare qualsiasi report sulle tendenze tu possa acquistare.
AiMojo consiglia:


 BONUS: Ottieni i nostri 200$ "AI "Mastery Toolkit" GRATIS se ti registri!






