

A legtöbb ember a Hugging Face -re csap le , modellnevek falára mered, és 30 másodpercen belül el is kattan. Nagy hiba.
Miközben mindenki azon vitatkozik, hogy melyik AI eszközért érdemes fizetni, több tízezer építőmester használja csendben a Hugging Face-t futtatáshoz, finomhangoláshoz és hajó AI-alapú alkalmazások — teljesen ingyenes. Ez's nem csak egy modellkönyvtár. Ez's a platform, ahol a Google, a Meta, a Mistral és az egyéni fejlesztők egy helyen dolgoznak.
Több mint 1 millió modell, 500 ezernél is több adathalmaz és ingyenes alkalmazástárhely – egyetlen fiók alatt. Íme a teljes leírás arról, hogy mi is ez valójában, és hogyan kell használni.
Mi is valójában az ölelő arc (a legtöbb ember félreérti)
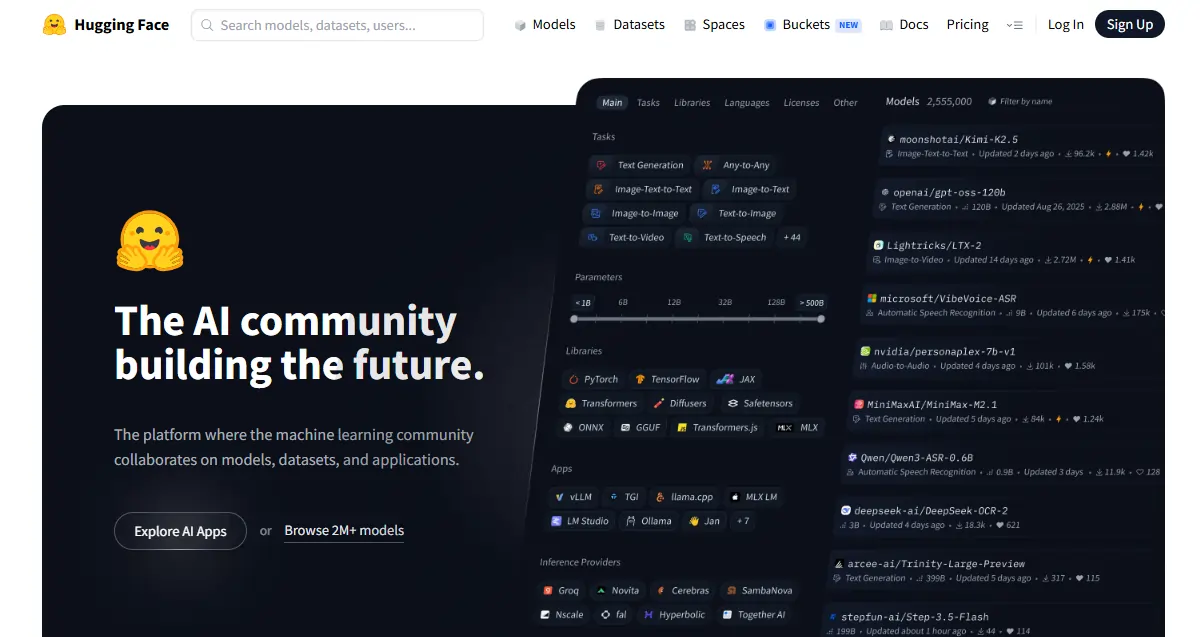
A „ gépi tanulás GitHubja ” címkét sokat használják. Egy irányban érvényes – nyilvános adattárak, verziókövetés, közösségi hozzájárulások. De gyorsan szétesik. A Hugging Face élő következtetéseket is futtat, mesterséges intelligenciával vezérelt alkalmazásokat üzemeltet, és teljes körű képzési infrastruktúrát biztosít. A GitHub mindezek közül semmit sem tesz.
Maga a cég NLP chatbot startupként indult, majd nyílt forráskódúvá vált. AI szerszámozás, és soha nem nézett vissza. A nyilvános platform is fszabad és közösségvezérelt; a vállalati termékekkel keresnek pénzt. Kezdőknek az ingyenes csomag mindent lefed, amire szükségük van. A modellek itt kerülnek közzétételre. előtt címlapokra kerülnek – ha valami új jelenik meg a mesterséges intelligenciában, az először a Hugging Face-en jelenik meg.
A három pillér – Ismerd meg ezeket mindenekelőtt
A Hugging Face minden eleme három fő részből áll:
| Pillér | Ami | Miért számít? |
|---|---|---|
| Modellek | 1 millió+ előre betanított AI modellek | Teljesen hagyd ki az edzést a nulláról |
| Datasets | Nyers adatok betanításhoz és teszteléshez | Szabványosított, betöltésre kész adatok |
| Spaces | Ingyenesen tárhelyen AI alkalmazások | Modellek tesztelése a telepítési kód megérintése nélkül |
Ismerkedj meg mindhárommal – folyamatosan összekapcsolódnak az építés során.
A Modellközpont – Ahol a legtöbb idődet töltöd
A szűrőpanel a legjobb barátod itt: feladattípus, keretrendszer (PyTorch, TensorFlow, JAX), nyelv, licenc és modellméret. Rendezd a leggyakrabban letöltöttek szerint a csatatérben tesztelt opciókat; rendezd a legutóbbi frissítések szerint , ha friss lehetőségekre van szükséged.
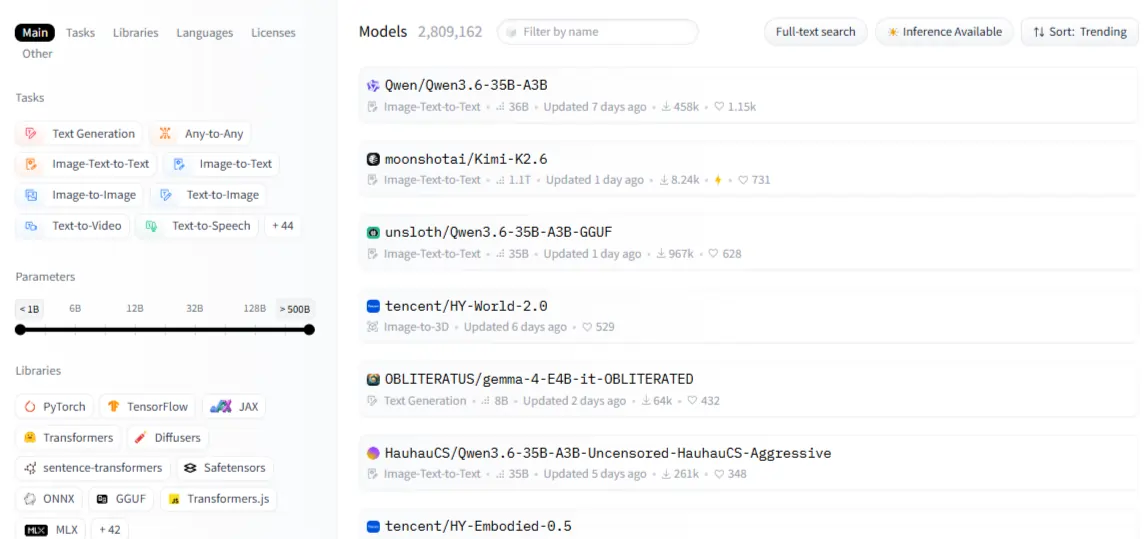
Minden modellhez tartozik egy kártya – olvasd el. A rendeltetésszerű használat rész megmondja, hogy mire készült a modell; a korlátok rész pedig azt, hogy hol hibás. Ez a második rész értékesebb, mint bármely referenciaérték. A modellkategóriák közé tartozik az NLP (szövegosztályozás, összefoglalás, fordítás, kérdésmegválaszolás), a látás (képosztályozás, objektumfelismerés, generálás), az audio (ASR, TTS) és a multimodális feladatok , mint például a vizuális kérdésmegválaszolás.
Egy dolgot a kezdők nem vesznek figyelembe: nem minden modell tölthető le szabadon. A zárt modellek, mint például a Meta Llamája, hozzáférés előtt jóváhagyást igényelnek. A jóváhagyás után egy hozzáférési tokennel kell hitelesíteni őket. Mindig ellenőrizd a licencet építés előtt – egyes modellek teljesen tiltják a kereskedelmi felhasználást.
A Transformers Könyvtár — A kód, ami a Transformers felét futtatja AI Világ
Az transformers a könyvtár egy egységes Piton csomag amely szabványosítja a modellek betöltését és futtatását a hubon PyTorch, TensorFlow és JAX rendszereken ugyanazzal az API-val.

Az pipeline() A függvény az, ahol a legtöbb kezdőnek érdemes kezdenie – egyetlen hívásba sűríti a tokenizálást, a modell betöltését és az utófeldolgozást. Hangulatelemzés, szöveggenerálás, képosztályozás – mind ugyanazt a mintát követik. Abban a pillanatban, amikor a kimenetek feletti részletes kontrollra van szükség, ugorjon az egyéni következtetési kód írására. Addig a folyamatok mindent kezelnek.
Ne hagyd ki a tokenizálást. Nyers szöveg nem kerülhet közvetlenül a modellbe. AutoTokenizer kezeli az átalakítást, és mindig automatikusan illeszti a megfelelő tokenizert a megfelelő ellenőrzőponthoz. A nem egyező tokenizerek okozzák a legzavarba ejtőbb hibákat, amelyekkel a kezdők találkozhatnak – és ezek 100%-ban elkerülhetők.
| Feladat | Csővezeték neve | Példamodell |
|---|---|---|
| Érzelmi elemzés | text-classification | distilbert-alap-burkolat nélküli |
| Szöveggenerálás | text-generation | Mistral-7B |
| összefoglalás | summarization | facebook/bart-large-cnn |
| Speech Recognition | automatic-speech-recognition | openai/suttogásbázis |
| Képosztályozás | image-classification | google/vit-base-patch16 |
Adatkészletek és adatterületek – A két funkció, amit senki sem használ eleget
Az datasets A könyvtár Apache Arrow formátumban tölti be az adatokat – gyors, memóriahatékony, és olyan adathalmazok kezelésére is alkalmas, amelyek nem férnek el a RAM-ban. load_dataset("name", split="train") ennyi az egész az induláshoz. Mielőtt bármilyen adathalmazhoz hozzárendelnéd a betanítási futtatást, használd a következőt: Adatstúdió a böngészőben az előnézethez és szűréshez egyetlen sor kód írása nélkül.
A terek azok a helyek, ahol AI A demók ingyenesen elérhetők. Az alkalmazásod perceken belül megosztható URL-t kap, nulla DevOps munkával. Az ingyenes CPU-csomag a könnyű demókat kezeli; a fizetős, GPU-alapú Spaces csomagok a nehezebb modelleket kezelik.
Használd a Gradio-t a gyors modelldemókhoz minimális kóddal; használd a Streamlit-et , ha az alkalmazásodnak adat-intenzívebb irányítópult-elrendezésre van szüksége. Egy trendi Space klónozása a leggyorsabb módja a kezdésnek – válassz egyet a kategóriádból, ágazd szét, és szabd testre.
Fiók beállítása a helyes módon
Az ingyenes csomag tartalmazza a modellböngészést, a CPU Spaces-t, a sebességkorlátozott API-hívásokat és a teljes közösségi hozzáférést. A Pro csomag prioritást élvező GPU Spaces-t, kibővített következtetést és privát adattárakat biztosít. A legtöbb kezdő számára az ingyenes is elegendő.
Hozzáférési token létrehozása a következő alatt: beállítások → Hozzáférési tokenekAz olvasási tokenek letöltéshez működnek; az írási tokenek modellek vagy adathalmazok küldéséhez szükségesek. Hitelesítés Pythonban a következővel: huggingface_hub.login()A telepítéshez:

horpadás
pip install transformers datasets huggingface_hubhozzáad accelerate, peftés trl ha a finomhangolás tervben van. A Google Colab a leggyorsabb környezet a teljesen kezdők számára – ingyenesen GPU, nincs semmi helyi beállítás.
Az első modell futtatása, majd a sajátoddá tétele
Az érzelemelemzéshez: hívás pipeline("text-classification"), adj át egy karakterláncot, olvasd el a label és a score vissza. Szöveggeneráláshoz: használja max_new_tokens, temperatureés do_sample hogy szabályozza a kimenet kreatív és következetességét. Ugyanaz pipeline() A minta működik fordításnál, beszédfelismerésnél és képosztályozásnál – az API nem változik, csak a feladat neve.
Amikor a dolgok elromlanak:
Miután az alapok beépültek, a finomhangolás a következő lépés. Az előre betanított modellek általánosak; a finomhangolt modellek precízek. A finomhangolás megelőzi a figyelmeztetéseket, ha tartományspecifikus adatokkal dolgozik, konzisztens viselkedésre van szüksége, vagy egy kisebb, specializált modell futtatásával szeretné csökkenteni a következtetési költségeket.
A PEFT a modell nagy részét lefagyasztja, és csak könnyű adaptereket tanít be – nincs szükség 10 000 dolláros GPU-ra. A QLoRA a kvantálással továbbmegy, lehetővé téve a 7 milliárd paraméteres modell finomhangolását egyetlen felhasználói GPU-n.
Az Trainer Az API kezeli a teljes ciklust – kötegelést, kiértékelést, ellenőrzőpontozást –, és a hub-nak történő visszaküldés egyetlen sort vesz igénybe, ha kész vagy.
Következtetés saját szerver nélkül
A hosztolt Inference API azonnal REST végpontot biztosít bármely nyilvános modellhez. Az ingyenes csomag sebességkorlátozott – tesztelésre alkalmas, éles környezetben nem. Valós alkalmazásokhoz az Inference Endpoints egy dedikált, privát API-t biztosít, amely automatikusan nullára skálázódik tétlenség esetén, így a változó forgalom esetén is kezelhetőek a költségek.
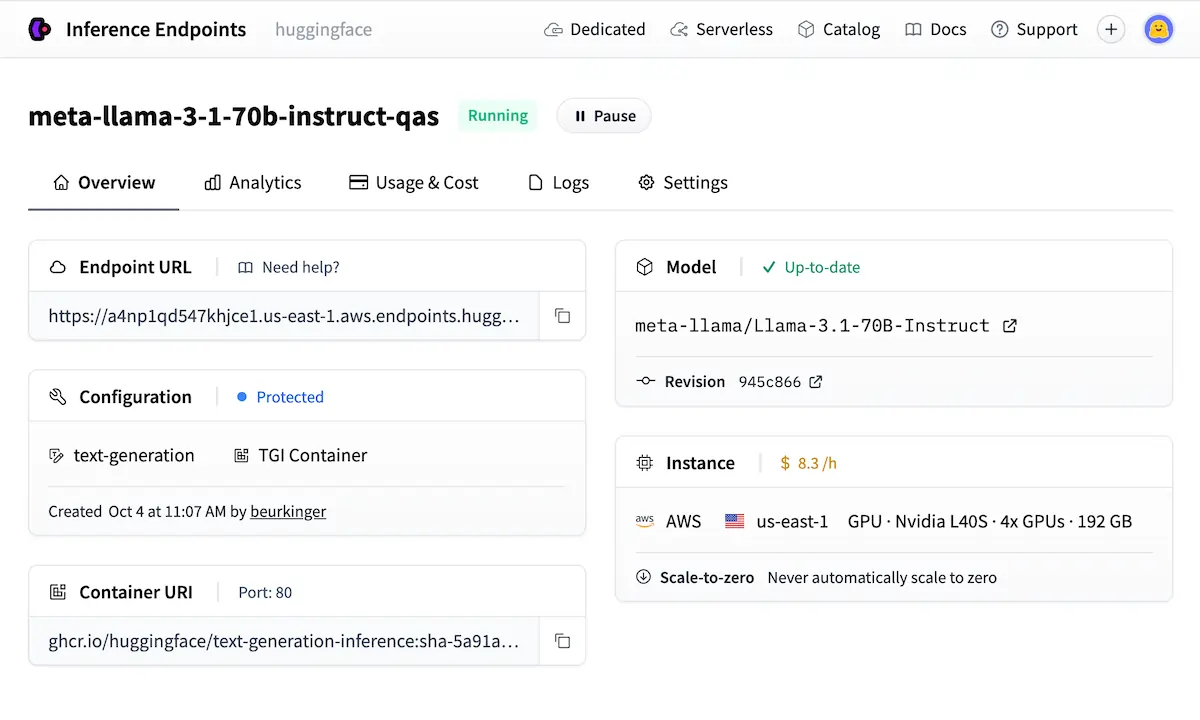
Amikor az adatvédelem vagy a késleltetés nem képezheti vita tárgyát, a TGI (Text Generation Inference) vagy a vLLM használatával történő saját tárhelyszolgáltatás a megfelelő választás éles üzembe helyezésre.
A közösség, a ranglisták, és miért veri a többit
Az Nyissa meg az LLM ranglistát benchmark alapján rangsorolja a modelleket – hasznos a rövid listázáshoz, de a pontszámok megbízása előtt mindig ellenőrizze a tényleges felhasználási esetet. A szervezeti fiókok lehetővé teszik a csapatok számára a megosztott modellgyűjtemények kezelését ellenőrzött hozzáféréssel; Meta AI, Google és EleutherAI minden futtatószervezeti fiók közvetlenül a központon található.
A kutatók és szervezetek követésével valós idejű hírfolyamot kaphatsz az új modellbemutatókról anélkül, hogy figyelned kellene a közösségi médiát.
| Emelvény | Open Source | Modell változatosság | Ingyenes szint | Finomhangoló eszközök |
|---|---|---|---|---|
| Átölelő arc | ✅ Tele | ✅ 1 hónapos kortól | ✅ Nagylelkű | ✅ Teljes készlet |
| TensorFlow Hub | Igen | 🔶 Korlátozott | Igen | ❌ Alapvető |
| Google Modellkert | ❌ Részleges | 🔶 Válogatott | 🔶 Csak GCP | 🔶 Csak GCP |
| Nyisd kiAI API | ❌ Nem | ❌ Zárva | ❌ Csak fizetős | 🔶 Korlátozott |
Órákba kerülő hibák
- A legnagyobb modell megragadása, amikor egy kisebb, feladatspecifikus modell gyorsabban és olcsóbban fut
- A modellkártya kihagyása's korlátozások szakasz, mielőtt bármit is ráépítenél
- Nincsenek modellváltozatok rögzítve – a modellek csendben frissülnek, és a kimenetek figyelmeztetés nélkül eltolódnak
- Az ingyenes Inference API használata minden olyan feladathoz, amelyhez konzisztens éles üzemidőre van szükség
- Nyers szöveg közvetlen átadása egy modellnek anélkül, hogy először egy tokenizeren futtatná át
Az AiMojo ajánlása:
Hová menjünk innen
A Hugging Face ingyenes kurzusai a hf.co/learn oldalon az NLP-t, az audiovizuális anyagokat és a mélyreható megerősítéses tanulást fedik le, kifejezetten ehhez a platformhoz létrehozott strukturált útvonalakon. A legjobb első projekt: finomhangolj egy szövegosztályozót egy egyéni adathalmazon, csomagold be a Gradio-ba, és telepítsd Space-ként.
Ez az egyetlen build egyetlen lépésben érinti a modelleket, az adathalmazokat, a finomhangolást és a Spaces-t. Amint ez megtörtént's élőben töltsd fel a modellt, és írj egy megfelelő modellkártyát – amely tartalmazza a tervezett felhasználást, a betanítási adatokat és a korlátozásokat.
Így születnek hasznos nyilvános hozzájárulások, és így lehet valódi jelenlétet kiépíteni a nyílt forráskódú mesterséges intelligencia világában.


 BÓNUSZ: Szerezd meg a 200 dolláros "AI „Mastery Toolkit” INGYENES regisztrációval!





