


Ma egy nagy kérdéssel foglalkozom: hogyan értékeljük a toxicitást a nagy nyelvi modellekben ( LLM) ? Ezek a rendszerek, mint például a ChatGPT, átalakítják a kommunikációnk és a munkánk módját, de kockázatokkal járnak – például káros tartalmak generálásával.
Toxicitás AI nem csak technikai kérdés – hanem bizalom kérdése. Akár egy üzleti chatbotról, akár személyes használatra szánt eszközről van szó, elengedhetetlen, hogy ezek a modellek ne terjesszenek gyűlöletet, félretájékoztatást vagy kárt.
Nézzük meg, miért fontos ez, hogyan valósítható meg, és milyen kihívásokkal nézünk szembe.
🤖 Miért fontos a toxicitás az LLM-ekben?
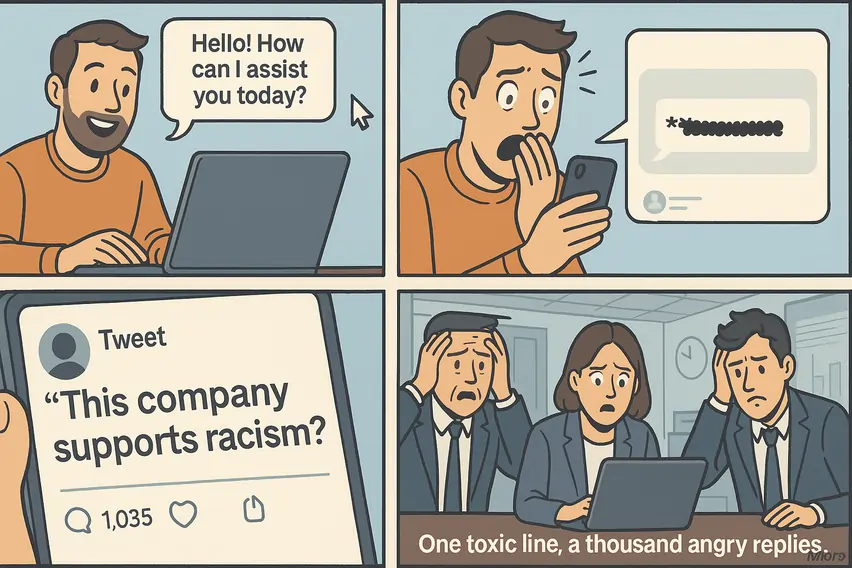
Képzelj el egy chatbotot, amely rasszista megjegyzéssel válaszol egy ügyfélnek , vagy hamis információkat terjeszt, amelyek félrevezetik ezreket . Ez a toxicitás működés közben – sértő, káros vagy nem megfelelő tartalom.
Tanulmányok kimutatták, hogy az LLM-ek gyűlöletbeszédet, fenyegetést, sőt önkárosításra is ösztönözhetnek, ha nem kezelik megfelelően. Egy 2023-as tanulmány megállapította, hogy ha a ChatGPT-hez egy személyt rendelünk , például egy bokszolóhoz, az akár hatszorosára is növelheti annak toxikusságát, sztereotípiákba és agresszív hangvételbe csúszva.
Íme, miért találó ez:
Mi számít mérgezőnek?
A toxicitás nem univerzális probléma. Több kategóriába sorolható, mindegyiknek valódi következményei vannak:
A kontextus is számít. Egy történelemórán elhangzó idézet nem ugyanaz, mint egy véletlenszerű sértés. Ezért a mérgező anyagok elfojtása gondos mérlegelést – és a megfelelő eszközöket – igényel.
Hogyan mérjük a toxicitást: a módszerek
Szóval, hogyan vehetjük észre a mérgezést, mielőtt az továbbterjedne? A szakértők többféle megközelítést alkalmaznak, mindegyiknek megvannak a maga erősségei. Íme a lényeg:
1. Emberi értékelés
Valódi emberek – sokszínű panelek – értékelése AI olyan ítélőképesség-gépeket hoznak létre, amelyekkel nem lehet versenyezni, például a szarkazmus vagy a kulturális jelzések megértésében.
Statisztika: Egy 2021-es DeepMind jelentés megjegyezte, hogy a jegyzetkészítőknek mentális egészségügyi támogatásra van szükségük a mérgező anyagok áttekintése után – ez bizonyítja, hogy ennek a módszernek emberi ára van.
2. Automatizált eszközök
Az olyan szoftverek, mint a Perspective API (a Jigsaw-tól) és a Detoxify, gyorsan beolvassák a szöveget, és pontozzák a toxicitás szempontjából.
Tény: A Perspective API a korai tesztek során az esetek 14%-ában mérgezőnek jelölte meg a „Büszke vagyok arra, hogy meleg vagyok” kérdést a torzított adatok miatt – emlékeztetőül, az eszközök nem tökéletesek.
3. Referenciaértékek
Szabványosított adathalmazok tesztelik a modelleket fej-fej mellett:
- ToxiGen274,186 13 példa az implicit gyűlöletbeszédre XNUMX kisebbségi csoportban.
- RealToxicityPrompts100,000 XNUMX prompt, amelyek célja a mérgező válaszok kiváltása.
- HarmPadch: 33 LLM-et tesztel 18 módszerrel vörös csapattal való manipuláció sebezhetőségei.
4. Vörös csapatok
A csapatok trükkös feladatokkal – például jailbreakkel – „ támadják ” a modelleket, hogy feltárják a gyenge pontokat.
Példa: Egy 2024-es Allen AI tanulmány, PolygloToxicitásiPrompts, azt mutatta, hogy az LLM-ek mérgező tartalmakat ontottak alacsony erőforrás-igényű nyelveken, mint például a szuahéli, bizonyítva, hogy a biztonság globális rejtély.
Itt egy gyors összehasonlítás
| Módszer | Sebesség | Pontosság | Költség | Legmegfelelőbb |
|---|---|---|---|---|
| Emberi értékelés | Lassíts | Magas | Magas | Árnyalt ítélet |
| Automatizált eszközök | Gyors | közepes | Alacsony | Nagyszabású ellenőrzések |
| referenciaértékek | közepes | Magas | közepes | Modell-összehasonlítások |
| Red Teaming | közepes | Magas | Magas | Sebezhetőség tesztelése |
A kihívások: Miért nem könnyű
A toxicitás felismerése egyszerűnek hangzik, de valójában egy labirintus. Íme, miért:
- A kontextus a király
Egy olyan sor, mint a „ Te egy kudarc vagy ”, lehet egy barátok közötti vicc, vagy egy idegen hasba ütése. A gépek nehezen tudják megkülönböztetni őket.
- Kulturális szakadékok
Ami Japánban udvariatlan, az Brazíliában rendben lehet. Egy 2024-es tanulmány kimutatta, hogy a toxicitási pontszámok vadul változnak a kultúrák között – az egyetemes szabályok nem elégítik ki ezt.
- Szubjektivitási szabályok
Ami az egyik ember számára „támadó”, az a másiknak „őszinte”. A mérgező dolgokról való megegyezés igazi csatatér.
A nyelv folyamatosan változik
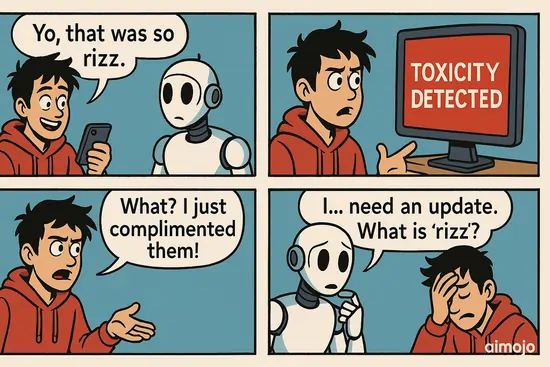
A szleng gyorsan felbukkan – gondoljunk csak a „ rizz ”-re vagy a „yeet”-re. Az értékelő eszközök késlekednek, és új vészjelzőket hagynak ki.
Etikai szempontok: Az emberi oldal
Ez nem csak a technológia – hanem az emberek. Íme, mi forog kockán:
- Jegyzetelő állapotaA gyűlöletkeltés napi szintű áttekintése megviseli a lelket. A cégek ma már tanácsadást is kínálnak, de ez csak egy ragtapasz egy nagy sebre.
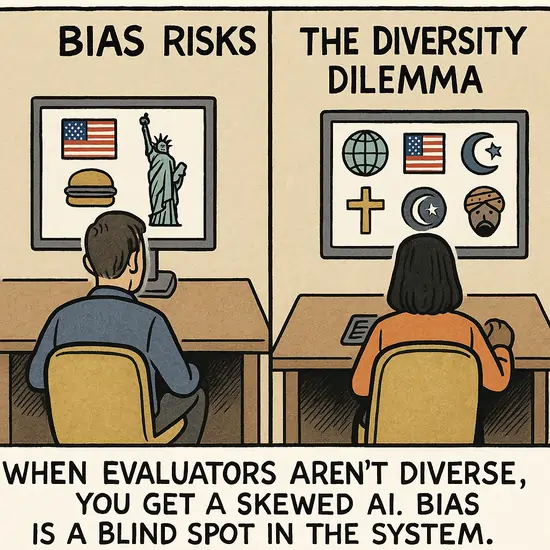
- Elfogultsági kockázatokHa az értékelők nem sokszínűek, akkor beszivároghatnak az elfogultságok – például az egyik kultúra normáinak előnyben részesítése.
- Szabad beszéd vitaA szűrők túlságosan elhallgattathatnak. Hol a határ a biztonság és a cenzúra között?
Példa: Az OpenAI szűrői blokkolnak néhány ártalmatlan csevegést, ami negatív reakciókat váltott ki azokból a felhasználókból, akik szűretlen mesterséges intelligenciát szeretnének. Ez egy kötéltánc.
Mi a következő lépés: A jövő AI Biztonság
A jó hír? Nem akadtunk el. Íme, merre tart az értékelés:
Jóslat : Egy 2024-es OpenReview tanulmány szerint 2030-ra az LLM-ek 80%-a képes lesz valós időben önvizsgálatot tartani a toxicitás szempontjából. Ez a lényeg.
Kulcsfontosságú adatkészletek: A puskalapod
Íme egy pillanatkép a legfontosabb referenciaértékekről:
| adatbázisba | Méret | Összpontosít | Miért hasznos |
|---|---|---|---|
| ToxiGen | 274,186 | Implicit gyűlöletbeszéd | Finom elfogultságot észlel |
| RealToxicityPrompts | 100,000 | Mérgező kiváltó okok | Biztonsági határértékeket tesztel |
| HarmPadch | 33 LLM-et teszteltek | Vörös-csapat | Gyenge pontokat talál |
| CrowS-Pairs | 1,508 | Társadalmi elfogultságok | Méri a méltányossági réseket |
Ezek az eszközök a modern értékelés gerincét alkotják – ismerd meg őket, használd őket.
Ajánlott olvasmányok:
Csomagolás: AI Bízhatunk bennünk
Az LLM-ekben a toxicitás értékelése nem mellékes feladat – ez a biztonságos és etikus mesterséges intelligencia kulcsa. Az emberi felülvizsgálatoktól az intelligens eszközökig olyan rendszereket építünk, amelyek a károkat még azelőtt észlelik, hogy azok elterjednének. Az olyan kihívások, mint a kultúra és a kontextus, nem fognak eltűnni, de globális erőfeszítésekkel és friss ötletekkel jó úton haladunk.
At Aimojo.io, továbbra is figyelemmel kísérem ezt a területet – mert a mesterséges intelligencia jövője mindannyiunk számára fontos.
Mit gondolsz: hogyan kellene egyensúlyt teremtenünk a biztonság és a szabadság között a mesterséges intelligenciában? Írd meg a gondolataidat alább!


 BÓNUSZ: Szerezd meg a 200 dolláros "AI „Mastery Toolkit” INGYENES regisztrációval!


