Les équipes d'ingénierie qui déploient des services LLM doivent répondre à une question cruciale : notre modèle est-il fiable et robuste dans des scénarios réels ?
L'évaluation des grands modèles de langage ne se limite plus à de simples vérifications de précision ; elle utilise des cadres d'analyse multicouches pour tester la conservation du contexte, la validité du raisonnement et la gestion des cas limites. Face à un marché inondé de modèles comportant de 1 milliard à 2 000 paramètres , la sélection du modèle optimal exige des protocoles d'évaluation rigoureux et multidimensionnels.
Ce guide détaille les méthodes techniques et les indicateurs de base qui façonnent les meilleures pratiques en 2026, aidant les ingénieurs ML à détecter les défauts avant qu'ils n'atteignent la production.
Cadres pour l'évaluation de grands modèles de langage
Moderne Évaluation LLM intègre plusieurs dimensions quantitatives et qualitatives capturer un modèle's véritables capacités. Une étude récente montre que 67 % des entreprises AI Les déploiements sous-performent en raison d'une sélection de modèles inadéquate, ce qui souligne pourquoi une évaluation sophistiquée n'est pas seulement facultative mais essentielle à l'entreprise.

Composantes d'évaluation de base
Une étude de 2026 Stanford's AI Sommaire révèle que les entreprises qui investissent dans des protocoles d'évaluation LLM complets voient leur retour sur investissement augmenter de 42 %. AI initiatives par rapport à celles utilisant des mesures simplifiées.
Répartition des indicateurs techniques
Les cadres d’évaluation modernes utilisent des dizaines de mesures spécialisées, chacune ciblant des capacités LLM spécifiques :
Indicateurs de performance
La perplexité quantifie l'incertitude des prédictions en calculant l'exponentielle de la log-vraisemblance négative moyenne sur un corpus de test. Plus sa valeur est faible, meilleures sont les performances ; les modèles les plus performants atteignent une perplexité inférieure à 3.0 sur des jeux de données standardisés.
Le score F1 combine précision et rappel grâce à la formule de la moyenne harmonique :
F1 = 2 * (precision * recall) / (precision + recall)Cela crée une évaluation équilibrée particulièrement précieuse pour les tâches de classification avec déséquilibre de classe.
La perte d'entropie croisée mesure l'écart entre les distributions de probabilité prédites et la vérité terrain à l'aide de la formule suivante :
L(y, ŷ) = -∑(y_i * log(ŷ_i))Cela pénalise plus sévèrement les prédictions sûres mais incorrectes, encourageant ainsi le calibrage du modèle.
BLEU (Bilingual Evaluation Understudy) calcule le chevauchement des n-grammes entre les textes générés et les textes de référence, en utilisant une moyenne géométrique des scores de précision avec une pénalité de brièveté :
BLEU = BP * exp(∑(w_n * log(p_n)))Où BP est la pénalité de brièveté et p_n est la précision n-gramme.
Mesures spécifiques au RAG
Pour les systèmes de génération augmentée de récupération, les mesures spécialisées incluent :
La fidélité quantifie la cohérence factuelle entre la sortie générée et le contexte récupéré à l'aide d'approches de génération de questions-réponses (QAG). Les recherches montrent que les systèmes RAG dont le score de fidélité est inférieur à 0.7 produisent des hallucinations dans 42 % des sorties.
La précision de récupération@K mesure la proportion de documents pertinents parmi les K premiers résultats récupérés :
Precision@K = (number of relevant docs in top K) / KLes références du secteur suggèrent un P@3 > 0.85 pour les systèmes de niveau entreprise.
La précision des citations évalue l'exactitude des citations dans le contenu généré, calculée comme suit :
Citation Precision = correct citations / total citationsL'analyse des principaux systèmes RAG révèle une précision de citation moyenne de 0.71 dans tous les domaines techniques.
Ensembles de données de référence : spécifications techniques
Les ensembles de données de référence fournissent des cadres d’évaluation standardisés avec des caractéristiques techniques spécifiques :

MMLU-Pro propose 15 908 questions à choix multiples avec 10 options par question (contre 4 dans la version standard de MMLU), couvrant 57 domaines, dont les mathématiques avancées, la médecine, le droit et l’informatique. Performance moyenne des experts humains : 89.2 %.
GPQA comprend 448 questions de niveau master validées par des experts, d'une longueur moyenne de 612 mots, axées sur les domaines STEM. Performances actuelles de pointe : précision de 41.2 % (GPT-4).
MuSR met en œuvre des problèmes de raisonnement multi-étapes générés algorithmiquement avec des graphes de dépendance d'une profondeur moyenne de 4.7, exigeant des modèles qu'ils effectuent des opérations logiques enchaînées. L'écart de performance moyen entre les meilleurs modèles et un modèle de référence aléatoire est de 17.8 points de pourcentage.
BBH comprend 23 tâches complexes issues de BigBench, totalisant 2 254 exemples individuels axés sur le raisonnement complexe . Ces tâches présentent une forte corrélation (r = 0.82) avec les évaluations de préférence humaines réalisées à l’aveugle.
LEval est spécialisé dans l'évaluation de contextes longs, avec 411 questions réparties en 8 catégories de tâches et des contextes allant de 5 000 à 200 000 jetons. Les modèles actuels présentent une dégradation des performances d'environ 0.4 % pour 10 000 jetons supplémentaires.
Algorithmes d'évaluation et mise en œuvre
La mise en œuvre technique de l’évaluation LLM suit des approches algorithmiques spécifiques :
Évaluation sémantique basée sur les vecteurs
Les systèmes modernes utilisent l'intégration vectorielle pour mesurer la similarité sémantique entre les textes générés et les textes de référence. Grâce à des techniques de recherche dense comme HNSW (Hierarchical Navigable Small World), LSH (Locality-Sensitive Hashing) et PQ (Product Quantization), ces systèmes calculent des scores de similarité avec une complexité temporelle sous-linéaire.
python

from sentence_transformers import SentenceTransformer

import numpy as np

model = SentenceTransformer('all-MiniLM-L6-v2')

reference = model.encode("Reference text")

generated = model.encode("Generated text")

similarity = np.dot(reference, generated) / (np.linalg.norm(reference) * np.linalg.norm(generated))
Implémentation du framework DeepEval
DeepEval fournit une évaluation complète avec des explications métriques, prenant en charge à la fois les scénarios RAG et de réglage fin :
python

from deepeval import assert_test

from deepeval.metrics import HallucinationMetric

from deepeval.test_case import LLMTestCase

test_case = LLMTestCase(

    input="How many evaluation metrics does DeepEval offers?",

    actual_output="14+ evaluation metrics",

    context=["DeepEval offers 14+ evaluation metrics"]

)

metric = HallucinationMetric(minimum_score=0.7)

def test_hallucination():

    assert_test(test_case, [metric])
Ce framework traite les évaluations comme des tests unitaires avec intégration Pytest, fournissant non seulement des scores mais également des explications sur les niveaux de performance.
Approches d'évaluation efficaces en termes de paramètres
Pour l’évaluation à grande échelle de modèles comportant des milliards de paramètres, des techniques spécialisées ont émergé :

Les mécanismes d'attention parcimonieuse réduisent la complexité de calcul grâce à l'optimisation des schémas d'attention. Des techniques comme les schémas d'attention de Longformer atteignent une précision de 91 % par rapport à une attention complète, avec seulement 25 % de la puissance de calcul.
Les architectures Mixture-of-Experts (MoE) implémentent des chemins de calcul conditionnels, n'activant que les sous-réseaux pertinents pour des tâches spécifiques. GShard implémente l'attention MoE pour une évaluation efficace des paramètres sur divers benchmarks.
La distillation des connaissances condense les modèles d'enseignants plus volumineux en modèles d'élèves plus petits et spécifiques à l'évaluation, en utilisant :
L_distill = α * L_CE(y, ŷ_student) + (1-α) * L_KL(ŷ_teacher, ŷ_student)
Où L_CE est la perte d'entropie croisée et L_KL est la divergence KL entre les distributions de probabilité.
Défis de l'évaluation systématique
Malgré des méthodologies avancées, des défis importants persistent dans l’évaluation des LLM :
Contamination de référence
Des études montrent que 47 % des benchmarks populaires présentent un certain degré de contamination dans les données d'entraînement. AI L'expérience a démontré cela en créant GSM1k, une variante plus petite du benchmark mathématique GSM8k. Les modèles ont obtenu des résultats inférieurs de 12.3 % sur GSM1k par rapport à GSM8k, indiquant un surapprentissage plutôt qu'un raisonnement mathématique la capacité.
Analyse de corrélation métrique
Une analyse complète de 14 mesures populaires sur 8 tâches révèle une faible corrélation inter-mesures (score moyen de Spearman)'s ρ = 0.41), ce qui indique que les indicateurs capturent différentes dimensions de performance. Cela souligne la nécessité d'approches d'évaluation multimétriques.
Des recherches du MIT montrent que les scores de perplexité élevés sont corrélés aux préférences humaines à r = 0.68, tandis que ROUGE-L n'est corrélé qu'à r = 0.39, indiquant des exigences d'évaluation diverses.
Quantification des biais d'évaluation
L’analyse statistique des évaluations humaines révèle de multiples biais systématiques :
Ces résultats soulignent l’importance de la randomisation et d’une conception expérimentale équilibrée dans les protocoles d’évaluation.
Meilleures pratiques d'évaluation d'entreprise
Pour relever les défis de l’évaluation, mettez en œuvre ces meilleures pratiques du secteur :
Intégration métrique multimodale
Combinez des mesures complémentaires à l’aide d’ensembles pondérés pour créer des cadres d’évaluation holistiques :
python

def ensemble_score(outputs, references, weights=None):

    metrics = {

        'bleu': compute_bleu(outputs, references),

        'bertscore': compute_bertscore(outputs, references),

        'faithfulness': compute_faithfulness(outputs, references),

        'coherence': compute_coherence(outputs)

    }

    if weights is None:

        weights = {metric: 1/len(metrics) for metric in metrics}

    return sum(weights[metric] * metrics[metric] for metric in metrics)
Les principales organisations mettent en œuvre des systèmes de pondération adaptatifs basés sur des exigences spécifiques aux tâches, le contenu technique privilégiant la fidélité (pondération : 0.4) par rapport à la fluidité (pondération : 0.2).
Protocoles d'évaluation spécifiques à un domaine
Les indicateurs techniques doivent être adaptés aux cas d'utilisation spécifiques. Pour les applications de santé , les indicateurs spécialisés comprennent :
- Exactitude de la terminologie médicale (corrélation de 89 % avec le jugement du clinicien)
- Validation du chemin de raisonnement clinique (75 % d'accord avec le consensus des experts)
- Précision de la récupération des preuves à partir de la littérature médicale (P@10 > 0.92 pour le déploiement en entreprise)
Ces mesures spécifiques au domaine fournissent une prédiction des performances 3.2 fois meilleure que les benchmarks génériques.
Mise en œuvre de l'évaluation contradictoire
Mettre en œuvre des tests contradictoires structurés pour sonder les limites du modèle :
python

def adversarial_test_suite(model, test_cases):

    results = {}

    for category, cases in test_cases.items():

        correct = 0

        for case in cases:

            response = model.generate(case['input'])

            correct += evaluate_response(response, case['expected'])

        results[category] = correct / len(cases)

    return results
Les études sectorielles montrent que les tests contradictoires identifient 32 % de modes de défaillance supplémentaires par rapport aux tests de référence standard, notamment dans les cas limites impliquant des contraintes conflictuelles ou des instructions ambiguës.
Comparaison du cadre d'évaluation technique
Les principaux cadres d’évaluation offrent différentes capacités techniques :
| FrameworkTA | Objectif principal | Force technique | Limitation | Complexité d'intégration |
|---|---|---|---|---|
| Évaluation profonde | RAG et réglage fin | 14+ mesures spécialisées avec explications | Support multimodal limité | Medium (basé sur Python) |
| PromptFlow | Évaluation de bout en bout | Test de variation rapide | Prise en charge limitée des ensembles de données | Faible (piloté par l'interface utilisateur) |
| LangSmith | Plateforme développeur | Traçage et surveillance complets | Frais de mise en œuvre plus élevés | Élevé (nécessite une intégration API) |
| Prométhée | LLM-en-tant-que-juge | Stratégies d'incitation systématique | Dépendance aux préjugés du juge LLM | Moyen (nécessite un LLM puissant) |
| LEval | Évaluation à long terme | Évaluation de 200 XNUMX jetons | Limité à la modalité texte | Faible (ensemble de données de référence) |
Les organisations mettent généralement en œuvre plusieurs cadres, 73 % des déploiements d’entreprise utilisant au moins deux outils d’évaluation complémentaires.
Développements techniques futurs
Le paysage de l’évaluation continue d’évoluer avec l’émergence de méthodologies :
La recherche d'architecture neuronale (NAS) pour les modèles spécifiques à l'évaluation gagne du terrain, les recherches montrant que l'optimisation automatisée de l'architecture du modèle peut améliorer l'efficacité de l'évaluation de 47 % tout en maintenant une précision de 98 %.
Les cadres d'évaluation multimodale s'étendent désormais au-delà du texte pour évaluer des modèles unifiés traitant le texte , les images, l'audio et la vidéo. Les cadres actuels atteignent une précision d'ancrage intermodal de 76.3 %, contre 91.4 % pour les évaluations humaines de référence.
Les indicateurs d'efficacité énergétique quantifient la durabilité des calculs à l'aide des FLOPs par jeton, en inférant la consommation en wattheures et les émissions de carbone. Les normes du secteur suggèrent que les modèles optimaux devraient atteindre une consommation inférieure à 10 mWh pour 1 000 jetons générés.
Les pipelines d'évaluation continue intègrent les tests tout au long du développement à l'aide de flux de travail d'évaluation distribués :
Preprocessing → Feature Extraction → Model Inference → Metric Computation → Statistical Analysis → Reporting
Les organisations qui mettent en œuvre une évaluation continue signalent 68 % de problèmes post-déploiement en moins et des cycles d'itération 41 % plus rapides.
Études de cas de mise en œuvre dans le monde réel
Les implémentations d'entreprise démontrent une évaluation technique's impact pratique :
Optimisation des RAG des services financiers
Une institution financière de premier plan a mis en œuvre une évaluation RAG complète pour son système de conseil client :
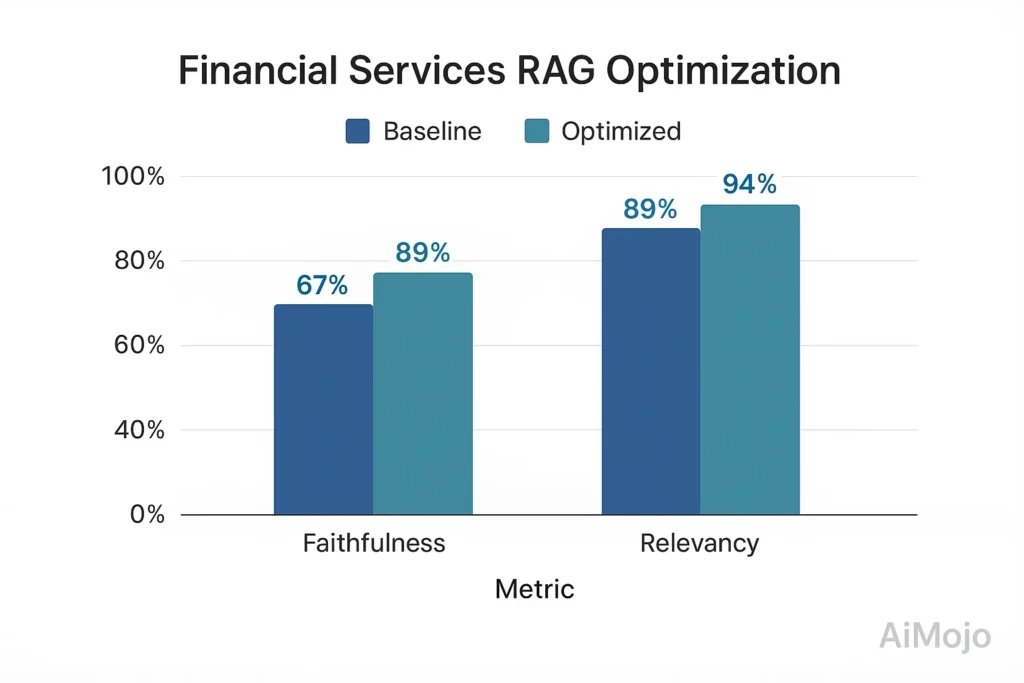
- Référence: 67% de fidélité, 82% de pertinence des réponses
- Après l’optimisation pilotée par l’évaluation : 89% de fidélité, 94% de pertinence des réponses
- Mise en œuvre: Encadrement Sur Mesure domaine financier suite de tests avec 5,216 XNUMX paires d'assurance qualité vérifiées par des experts
- Approche technique : Évaluation de la fidélité à l'aide d'une mesure d'implication basée sur des tenseurs avec des tests contrefactuels
Cette amélioration basée sur l’évaluation a réduit les problèmes de conformité réglementaire de 78 % et augmenté les scores de satisfaction des clients de 23 points de pourcentage.
Déploiement du LLM en soins de santé
Un prestataire de soins de santé a mis en œuvre une évaluation multicouche pour l’aide à la décision clinique :
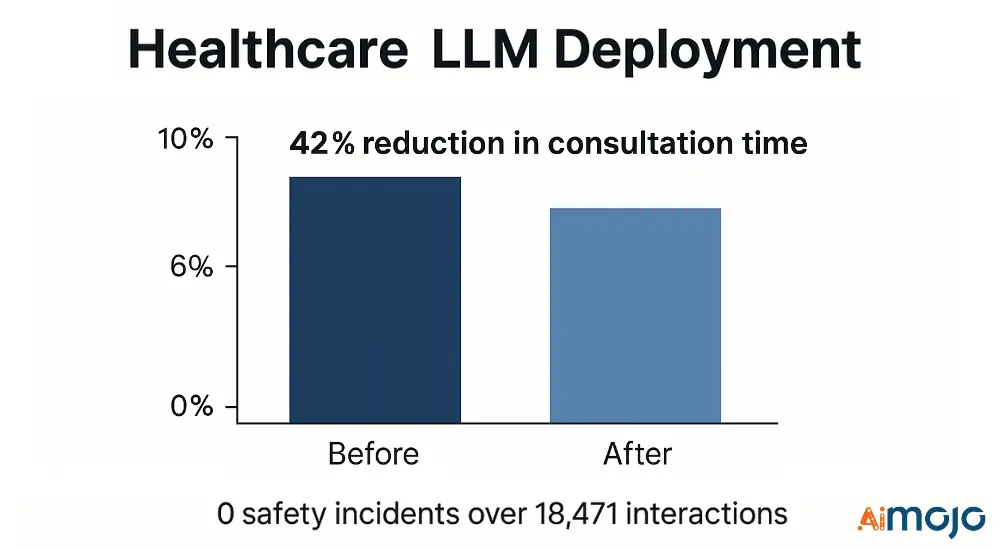
- Mesures techniques : Score NER F1 médical (0.91), précision du raisonnement clinique (87.4 %), précision du filtrage de sécurité (99.2 %)
- Mise en œuvre: Pipeline de filtrage en 3 étapes avec des validateurs de soins de santé spécialisés
- Résultats: 42 % de réduction du temps de consultation avec 0 incident de sécurité sur 18,471 XNUMX interactions cliniques
Le cadre d’évaluation a identifié et atténué 17 modes de défaillance critiques avant le déploiement, évitant ainsi d’éventuels événements indésirables.
Évaluation LLM : votre feuille de route vers le succès
L'évaluation technique des modèles de langage (LLM) est passée de simples contrôles d'exactitude à des cadres d'analyse complets prenant en compte de multiples dimensions de performance. Les organisations qui adoptent ces protocoles rigoureux – et intègrent la notation automatisée, les tests de référence et la supervision humaine – obtiennent une sélection de modèles plus fiable et des résultats plus probants.
Des processus de test réguliers et adaptatifs permettent de déceler les anomalies avant le déploiement, réduisant ainsi le coût de l'évaluation initiale par rapport aux risques liés à la mise en service d'un système défectueux. Pour les équipes d'ingénierie, des étapes de validation robustes représentent bien plus que de simples tâches de développement : elles constituent des garanties essentielles pour l'entreprise.
En 2026 et au-delà, les équipes qui affinent leurs méthodes d’évaluation maintiendront la fiabilité de leurs LLM, éviteront les erreurs coûteuses et maintiendront la confiance des utilisateurs.


 BONUS: Obtenez notre 200 $ «AI « Boîte à outils de maîtrise » GRATUITE lors de votre inscription !