
váš AI Agent má problém. Ví o světě všechno, až do dne, kdy skončilo jeho školení. Zeptejte se ho na konkurenci.'s ceník, čerstvá zpráva nebo dokumenty knihovny, které byly odeslány minulý týden, a buď hádá, nebo se omlouvá.
Řešením jsou webová data v reálném čase. A v roce 2026 bude nejrychlejším způsobem, jak je přenést do jakéhokoli AI Systém je Firecrawl.
Firecrawl používáme v naší vlastní síti. Pomáhá scrapingu v našich produkčních aplikacích , poskytuje data našim výzkumným agentům a běží v rámci našich pracovních postupů WordPressu.
Tento tutoriál obsahuje vše, co bychom si přáli, aby nám někdo dal hned první den: nastavení jedním kliknutím bez nutnosti kódování, kód Pythonu a Node, strukturovanou extrakci, funkční RAG pipeline a cenové triky, které udrží účet na nízké úrovni.
Žádné zbytečnosti. Nechte's postavit. 🚀
Co si vytvoříme v tomto průvodci Firecrawlem
Na konci tohoto tutoriálu budete vědět, jak:
- Propojte Firecrawl s Claude, ChatGPT nebo Cursor jedním kliknutím (bez nutnosti kódu)
- Převeďte libovolnou URL adresu do čistého markdownu připraveného pro LLM pomocí Pythonu nebo Node.
- Procházení celého webu do datové sady
- Extrahujte strukturovaný JSON z chaotických stránek pomocí schématu
- Propojení živých webových dat do RAG kanálu pomocí LangChain nebo LlamaIndex
- Udržujte si nízké spotřeby úvěru
Jediným předpokladem je klíč Firecrawl API. Tato část je zdarma.
Krok 1: Získejte svůj API klíč (1 000 kreditů zdarma, bez karty) 🔑
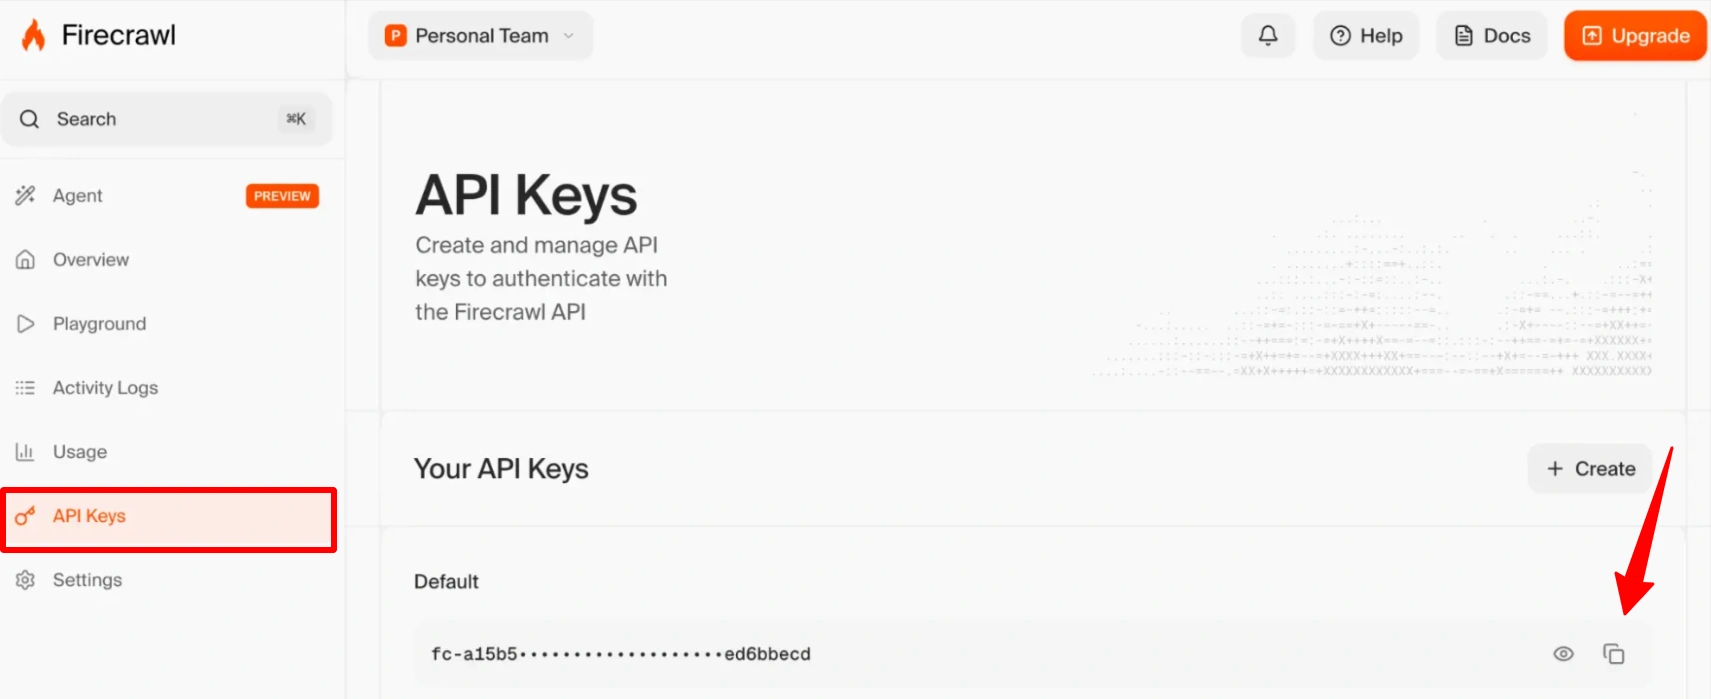
Bezplatný plán Firecrawlu vám dává 1 000 kreditů měsíčně . Jeden kredit se rovná jedné odstraněné stránce, takže to je 1 000 stránek měsíčně s trvalým obnovením bez nutnosti kreditní karty. To je více než dost na to, abyste celý tento tutoriál absolvovali mnohokrát.
|
Jakmile se dostanete do řídicího panelu, zkopírujte si klíč API. Začíná na fc-. Tento řetězec je vaší vstupenkou ke všemu, co je níže.
Krok 2: Trasa jedním kliknutím (bez nutnosti zadávání kódu) ⚡
Než napíšeme jediný řádek kódu, vězte toto: možná žádný nebudete potřebovat.
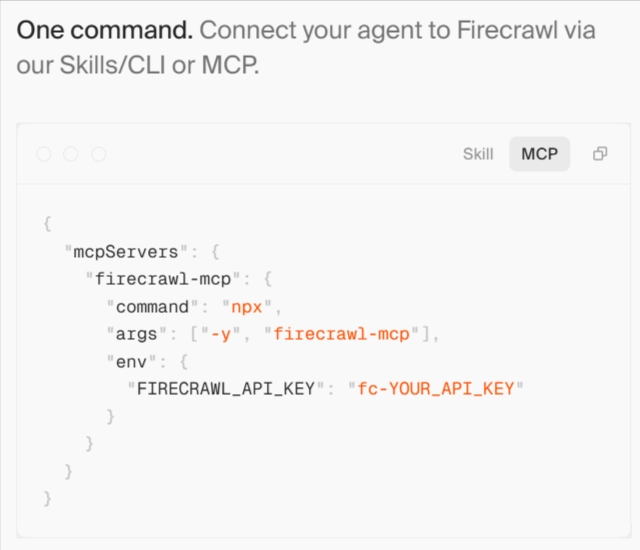
Firecrawl provozuje oficiální server MCP (Model Context Protocol) a připojuje se k vašemu oblíbenému AI nástroje stejným způsobem, jako byste připojili účet Gmail. Hostovaný server se nachází na adrese:
https://mcp.firecrawl.dev/v2/mcpPřidejte svůj klíč API do adresy URL a jakýkoli nástroj kompatibilní s MCP jej bude moci použít:
https://mcp.firecrawl.dev/fc-YOUR_API_KEY/v2/mcpV Claude (web nebo desktop): přidejte Firecrawl jako konektor nebo jej vložte do claude_desktop_config.json:
{
  "mcpServers": {
    "firecrawl": {
      "command": "npx",
      "args": ["-y", "firecrawl-mcp"],
      "env": {
        "FIRECRAWL_API_KEY": "fc-YOUR_API_KEY"
      }
    }
  }
}Po připojení vaše AI asistent získává deset nových schopností: scraping, vyhledávání, procházení, mapování, extrakci, interakci, monitorování, parsování, výzkum a plně autonomního agenta. A to vše ovládáte srozumitelnou angličtinou.
Zkuste takovéto výzvy:
- Projděte si https://competitor.com/pricing a shrňte všechny tarify do tabulky.
- Projděte si dokumentaci na adrese docs.example.com, maximálně 50 stránek, a vysvětlete, jak funguje jejich autorizace.
- Hledejte na webu „nejlepší“ AI generátory videa 2026“ a porovnejte 5 nejlepších výsledků.
Toto je nastavení, které naši netechničtí členové týmu používají denně. Žádný terminál, žádný kód, skutečná živá webová data v každé konverzaci. Pokud je to vše, co potřebujete, můžete tady opravdu skončit. Ale pokud vytváříte aplikace, API je to, kde si Firecrawl užívá zábavu.
Krok 3: Scraping první stránky pomocí API 🐍
Čas na kód. Nainstalujte SDK:
# Python
pip install firecrawl
# Node.js
npm install firecrawl
Získání URL adresy trvá tři řádky. Zde je Python:
z importu Firecrawl Firecrawl
firecrawl = Firecrawl(api_key="fc-YOUR_API_KEY")
doc = firecrawl.scrape("https://firecrawl.dev", formats=["markdown"])
print(doc.markdown)
A uzel:
import { Firecrawl } from 'firecrawl';
const firecrawl = new Firecrawl({ apiKey: 'fc-YOUR_API_KEY' });
const doc = await firecrawl.scrape('https://firecrawl.dev', { formats: ['markdown'] });
console.log(doc.markdown);
Spusťte to a podívejte se na výstup. To je celý trik, díky kterému je Firecrawl výjimečný: to, co se vrátí, není syrová HTML polévka. Je to čistý markdown s řádnými nadpisy, seznamy a odkazy, bez navigačních lišt, cookies bannerů, skriptů a nepotřebných prvků v patičce.
Proč na tom tolik záleží? Dva důvody. Tokeny a přesnost. Nezpracovaný HTML kód z typické stránky může být 10krát větší než skutečný obsah a každý nepotřebný token stojí peníze a oslabuje váš model.'s pozornost. Čisté markdowny znamenají menší zadání, nižší náklady na LLM a odpovědi založené na obsahu, nikoli na zbytečnosti.
Ve stejném volání můžete také požadovat další formáty: html, screenshot, odkazy nebo strukturovaný json. V případě potřeby je můžete naskládat na sebe:
doc = firecrawl.scrape(
    "https://example.com/blog/post",
    formats=["markdown", "links"]
)
Firecrawl ve výchozím nastavení vykresluje JavaScript , takže weby React, dynamické stránky a obsah vykreslený klientem se vracejí kompletní. Žádné hlídání bezhlavého prohlížeče na vaší straně.
Krok 4: Procházení celého webu 🕸️
Jedna stránka je demo. Celý web je datová sada.
Koncový bod procházení sleduje odkazy z počáteční adresy URL a prohledává vše, co najde, s ovládacími prvky pro hloubku, limity stránek a filtry cest:
from firecrawl import Firecrawl
from firecrawl.types import ScrapeOptions
firecrawl = Firecrawl(api_key="fc-YOUR_API_KEY")
crawl_status = firecrawl.crawl(
    'https://docs.example.com',
    limit=100,
    scrape_options=ScrapeOptions(formats=['markdown']),
    poll_interval=30
)
for page in crawl_status.data:
    print(page.metadata.url)
Verze uzlu:
const crawlResponse = await firecrawl.crawl('https://docs.example.com', {
  limit: 100,
  scrapeOptions: { formats: ['markdown'] }
});
console.log(`Crawled ${crawlResponse.data.length} pages`);
Sada SDK za vás zpracovává dotazování úloh a stránkování a vrací každou stránku jako čistý markdown. Tři parametry, které stojí za to si zapamatovat:
- limit Celkový počet stránek. Vždy si to nastavte. Toto je váš kreditní bezpečnostní pás.
- includePaths / vyloučitCesty Filtrujte URL pomocí regulárních výrazů. Procházíte web s dokumenty? Vylučte /blog/.* a /careers/.* a přestaňte platit za stránky, které nikdy nepoužijete.
- maximální hloubka objevování určuje, kolik odkazů z počáteční adresy URL prohledávač sleduje.
Profesionální tah: před jakýmkoli velkým procházením se nejprve pokuste o procházení pomocí endpointu Map . Vrátí každou URL adresu na webu během několika sekund téměř bez nutnosti připisovat kredity. Určete rozsah úlohy, spočítejte stránky a poté procházejte přesně to, co potřebujete.
result = firecrawl.map("https://docs.example.com")
print(f"{len(result.links)} URLs found")
Krok 5: Extrahujte strukturovaná data pomocí schématu 📊
Markdown je pro RAG perfektní. Někdy ale potřebujete pole, ne text: názvy produktů, ceny, hodnocení. To je koncový bod pro extrakci.'s úkol. Popisuješ tvar dat, Firecrawl's AI vytáhne to ze stránky:
schema = {
    "type": "object",
    "properties": {
        "product_name": {"type": "string"},
        "price": {"type": "string"},
        "rating": {"type": "number"},
        "in_stock": {"type": "boolean"}
    },
    "required": ["product_name", "price"]
}
result = firecrawl.extract(
    urls=["https://example-store.com/product/xyz"],
    prompt="Extract the product details from this page",
    schema=schema
)
print(result.data)
Žádné CSS selektory. Žádný XPath. Žádný parser, který se zhroutí v okamžiku, kdy se změní rozvržení webu. Definujete, co chcete, a extrakce přežije i redesign, protože rozumí obsahu, ne značkovacímu kódu.
Přesně tento vzorec běží v produkčním prostředí naší sítě: jedna z našich aplikací používá Extract k automatickému a dle plánu přeměně chaotických stránek poskytovatelů na jednotnou cenovou databázi. Stejné schéma funguje na desítkách různě navržených webů. Zkuste to vytvořit pomocí regulárních výrazů a nahlaste to. 😅
Krok 6: Dejte svému agentovi možnost Vyhledat na webu 🔎
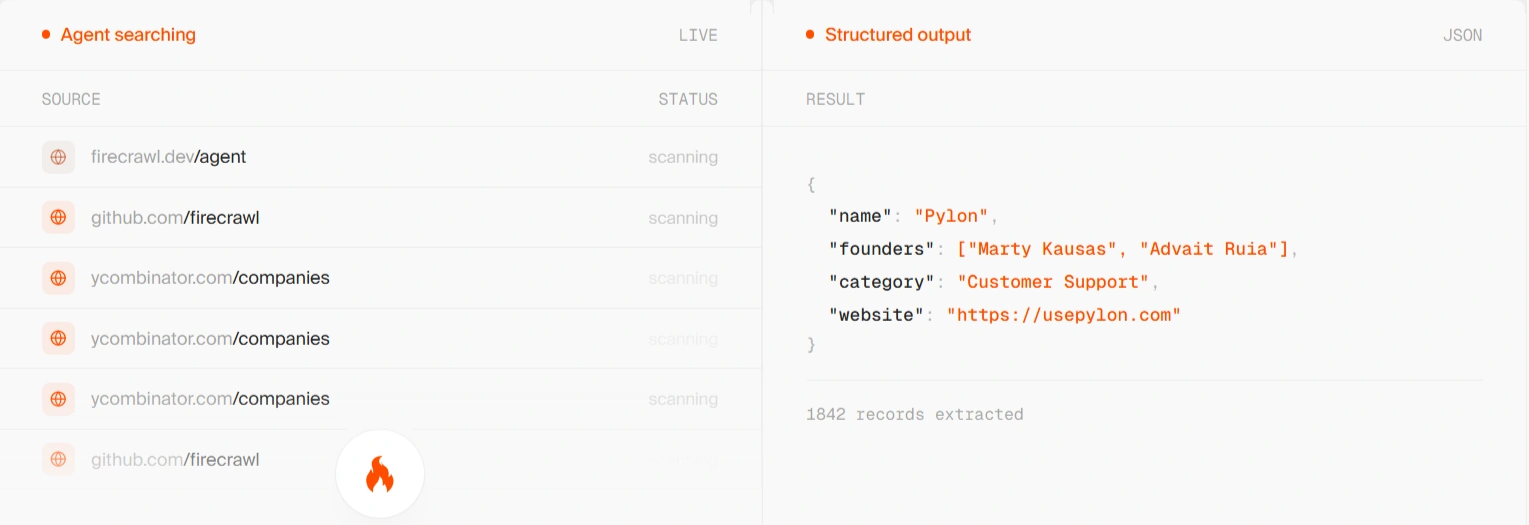
Scraping zpracovává URL adresy, které již znáte. Vyhledávání zpracovává ty, které neznáte.
Firecrawlův vyhledávací endpoint je spícím prvkem celé platformy. Většina vyhledávacích API vrací odkazy a úryvek kódu a poté vám nechává načíst a vyčistit každý výsledek sami. Firecrawl vrací výsledky včetně kompletního extrahovaného obsahu v jednom volání:
results = firecrawl.search(
    query="best open source LLMs 2026",
    limit=5
)
pro položku ve výsledcích vyhledávání.web:
print(item.title, item.url)Uzel s povoleným scrapingem obsahu pro každý výsledek:
const results = await firecrawl.search('best open source LLMs 2026', {
  limit: 5,
  scrapeOptions: { formats: ['markdown'] }
});
Toto je stavební kámen pro výzkumné agenty . Smyčka je jednoduchá: váš agent vytvoří dotaz, Firecrawl vrátí čitelný obsah z prvních výsledků a váš LLM syntetizuje odpověď se zdroji. To je hloubkový výzkum a vy jste ho právě sestavili v tuctu řádků.
Poznámka k ceně: Vyhledávání účtuje 2 kredity za každých 10 výsledků plus běžné kredity za scrape při načtení celého obsahu. Stále je to výrazně levnější než jakékoli specializované API pro odpovědi, které jsme testovali.
Krok 7: Zapojte to do potrubí RAG 🧠
A teď hlavní událost: krmení AI živé webové znalosti agentů. Oba hlavní frameworky dodávají prvotřídní zavaděče Firecrawl.
LangChain:
- z langchain_community.document_loaders import FireCrawlLoader
- z importu RecursiveCharacterTextSplitter z langchain_text_splitters
- z langchain_openai importovat OpenAIEmbeddings
- z importu FAISS z langchain_community.vectorstores
# 1. Načtěte celý web jako čisté dokumenty
loader = FireCrawlLoader(
    api_key="fc-YOUR_API_KEY",
    url="https://docs.example.com",
    mode="crawl"
)
docs = loader.load()
# 2. Nakrájejte je na kousky
splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=100)
chunks = splitter.split_documents(docs)
# 3. Vložení a indexování
vectorstore = FAISS.from_documents(chunks, OpenAIEmbeddings())# 4. Ptejte se na základě živých webových dat
retriever = vectorstore.as_retriever()
relevant = retriever.invoke("How do I authenticate API requests?")
Index lamy:
- z llama_index.readers.web import FireCrawlWebReader
- z llama_index.core import VectorStoreIndex
reader = FireCrawlWebReader(
    api_key="fc-YOUR_API_KEY",
    mode="crawl",
    url="https://docs.example.com"
)
documents = reader.load_data()
index = VectorStoreIndex.from_documents(documents)
response = index.as_query_engine().query("How does their pricing work?")
print(response)
To je kompletní proces „chatu s jakýmkoli webem“ na méně než 25 řádcích. Protože Firecrawl předává zavaděči čistý markdown namísto HTML, vaše chunky jsou koherentní, vaše vkládání smysluplné a kvalita načítání je vyšší než u naivního scrapingu. To je hlavní důvod, proč si tvůrci RAGů vybírají Firecrawl.
Stejné nakladače fungují s CrewAI, Dify, Flowise a n8n, pokud jsou pro vás bližší vizuální pracovní postupy.
Bonus: Architektura šetřící náklady, o které nikdo nemluví 💡
Zde je vzorec, který našim aplikacím každý měsíc šetří skutečné peníze.
Pokud vaše aplikace potřebuje webové odpovědi, zřejmou cestou je LLM s vestavěným webovým vyhledáváním . Poskytovatelé však webové vyhledávání účtují jako prémiový doplněk a specializovaná API pro odpovědi se ve velkém měřítku rychle prodraží.
Chytřejší rozdělení:
Firecrawl (načtení, ~0.001 USD/stránka) → levné LLM (důvod, není potřeba přístup k webu)
Firecrawl vyhledává a scrapinguje za jeden nebo dva kredity za požadavek. Pak jakýkoli levný model, DeepSeek, malý GPT nebo Claude tier, nebo jakýkoli otevřený model, který provozujete na svém vlastním VPS, provede shrnutí a přepsání tohoto čistého obsahu. Stejná kvalita odpovědi. Zlomek ceny.
To také krásně funguje pro samoobslužná nastaveníPoužíváte Open WebUI nebo jiné open source chatovací rozhraní na VPS? Propojte Firecrawl jako vrstvu pro webové vyhledávání a procházení a váš vlastní hostovaný server. AI najednou prožívá hluboký výzkum jako velké komerční produkty.
Tipy pro výdaje: Využijte 1 000 kreditů zdarma 🪙
Stručný návod pro udržení nízké spotřeby:
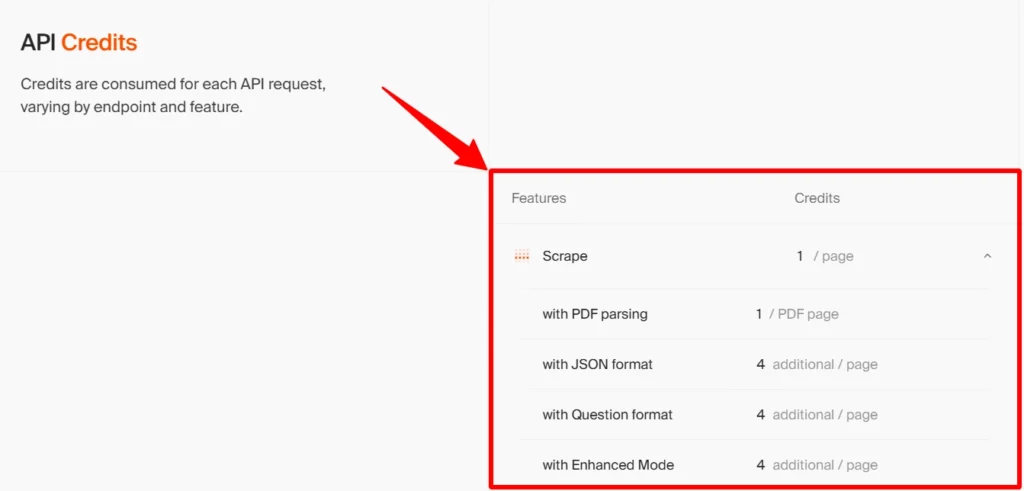
| Akce | Úvěrové náklady |
|---|---|
| Scrape / Procházení / Mapa / Monitorování | 1 kredit za stránku |
| Hledat | 2 kredity za každých 10 výsledků |
| Interakce (akce prohlížeče) | 1 500 kreditů za minutu |
| Neviditelný režim (chráněné lokality) | 5 kreditů na stránku |
Pět návyků, na kterých záleží:
- Prohlédněte si mapu, než se vydáte na plazení. Než zaplatíte, zjistěte si počet stran.
- Vždy nastaveno limit při procházení. Výchozí nastavení je 10 000 stránek. Vaše bezplatná úroveň je 1 000. Spočítejte si to jednou, ne poté.
- Použijte vyloučitCesty agresivně. Archivy blogů, stránky s tagy a stránky s kariérními příležitostmi jsou skládkami kreditů.
- Ukládejte si stažené soubory do mezipaměti. Dokumenty se mění týdně, nikoli každou hodinu. Ukládejte výsledky a znovu procházejte podle plánu, nikoli na požadavek.
- Kredity se nepřevádějí, takže pokud upgradujete, upravte si tarif podle skutečného měsíčního objemu. Placené tarify začínají na 16 dolarech měsíčně za 5 000 kreditů a standardní tarif za 83 dolarů vám poskytne 100 000 stran.
Časté chyby (a rychlé opravy) 🛠️
Pět problémů, které vysvětlují v podstatě každou zprávu „Firecrawl nefunguje“, kterou dostáváme:
A jedna neomylná věc, kterou stojí za to vědět: pokud požadavek na Firecrawlu selže's straně, za to se neplatí.
Rychlé odpovědi 🎯
Jak funguje Firecrawl?
Odešlete URL adresu (nebo vyhledávací dotaz) do jeho API a ono vrátí obsah jako čistý markdown, JSON nebo snímky obrazovky, přičemž vykreslování JavaScriptu a odstranění nepotřebných prvků se provede automaticky. Jeden kredit za stránku.
Je Firecrawl dobrý pro RAG?
Je to výchozí volba v roce 2026. Čistý výstup markdownu znamená lepší segmenty, lepší vkládání a lepší načítání, s oficiálními zavaděči pro LangChain a LlamaIndex.
Můžu používat Firecrawl bez kódování?
Ano. Konektor MCP s jedním kliknutím umožňuje scrape, crawl, search a extraction uvnitř Claude, ChatGPT, Perplexity a Cursor, a to pomocí jednoduchých anglických pokynů.
Existuje bezplatná úroveň?
1 000 kreditů měsíčně s možností obnovení, karta není potřeba. Získejte je zde s 10% slevou na první upgrade.
Závěr: Váš agent, nyní s očima 👀
Shrnutí toho, co jste se právě dozvěděli:
Mezera mezi AI agent, který hádá a AI Agent, který zná jeden klíč API. Firecrawl vám dává 1 000 kreditů zdarma měsíčně k jeho uzavření a každý příklad v této příručce se pohodlně vejde do tohoto limitu.
Máte sestavení poháněné Firecrawlem?
Dejte nám vědět v komentářích. Nejlepší čtenářské projekty nakonec uvedeme v našem newsletteru. ✌️


 BONUS: Získejte našich 200 dolarůAI „Sada nástrojů pro mistrovství“ ZDARMA při registraci!


