
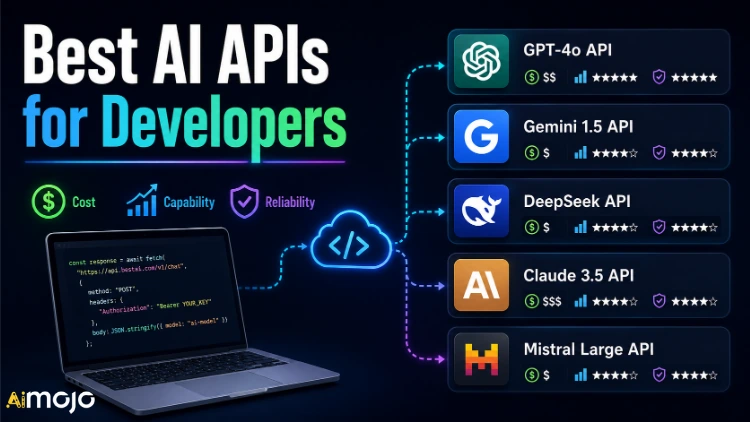
Ceny LLM API se v roce 2026 pohybují od 0.10 do 30 dolarů za milion tokenů. Tento rozdíl není zaokrouhlovací chybou – je…'s rozdíl mezi účtem 200 dolarů měsíčně a účtem 9 000 dolarů měsíčně za stejnou pracovní zátěž. Tato příručka se zabývá AI API pro vývojáře kteří vytvářejí skutečné produkční aplikace, ne víkendové prototypy. Žádné volně dostupné nástroje pro hobby – pokud vůbec nějaké.'s co potřebujete, podívejte se na bezplatnou AI Nejprve průvodce API.
Co zde získáte: podrobný pohled na náklady, možnosti a spolehlivost napříč API, na kterých skutečně záleží, když uživatelé ve 3 hodiny ráno narážejí na vaše koncové body.
Průvodce rychlým výběrem – Nejlepší AI API podle typu vývojáře
| Typ vývojáře | Nejlepší výběr | Proč |
|---|---|---|
| Sólový / nezávislý hacker | Gemini Flash + DeepSeek V3.2 | Nízké náklady, štědré limity |
| Spuštění SaaS | GPT-5.4 mini nebo Claude Sonnet 4.6 | Rovnováha mezi kvalitou a spolehlivostí |
| Podnik / regulovaný | AWS Bedrock / Azure OpenAI | SLA, dodržování předpisů, uchovávání dat |
| Vysokoobjemové potrubí | DeepSeek V3.2 přes OpenRouter | Nejlevnější ve velkém měřítku |
| Nástroje pro kódování / vývoj | Claude Sonnet 4.6 | Nejlepší benchmark kódování v roce 2026 |
| Multimodální aplikace | Gemini 2.5 Pro | Sjednocená vize + textový koncový bod |
Třífaktorový rámec, než si jakýkoli vyberete AI API
Než se zavážete k určitému poskytovateli, prověřte každou možnost těmito třemi filtry:
| Faktor | Co měřit | Červená vlajka |
|---|---|---|
| Stát | Vstupní/výstupní sazby tokenů, kontextové cenové úrovně, dávkové slevy | Nebyla zveřejněna stránka s cenami |
| Schopnost | Skóre benchmarků, kontextové okno, multimodální podpora | Nejasné funkce „brzy k dispozici“ |
| Spolehlivost | SLA pro dobu provozuschopnosti, latence p99, transparentnost limitů rychlosti | Žádná veřejná stránka se stavem |
Pokud poskytovatel nedokáže splnit všechny tři požadavky, nepatří do vašeho produkčního stacku – bez ohledu na to, jak dobře dema vypadají.
2026 AI Rozpis cen API – kolik skutečně platíte za milion tokenů
Tady je většina vývojářů překvapena. Zde's Jak se trh rozdělí v roce 2026:
Úroveň 1 – Frontier Models (prémiové ceny)
Tyto jsou nejschopnější, ale nejvíce zasáhnou váš rozpočet:
Úroveň 2 – Modely střední třídy (nejlepší poměr cena/výkon)
Ideální prostředí pro většinu SaaS produktů:
Úroveň 3 – Rozpočtová a otevřená API
Zde se nacházejí velkoobjemové potrubí:
Kompletní referenční tabulka cen:
| Provider | Model | Vstup (na 1M) | Výstup (na 1M) | Kontextové okno | Úroveň zdarma |
|---|---|---|---|---|---|
| OpenAI | GPT-5.4 | $2.50 | $15.00 | 128 | Ne |
| OpenAI | GPT-5.4 mini | $0.75 | $3.00 | 128 | Omezený |
| Antropický | Claude Sonnet 4.6 | $3.00 | $15.00 | 200 | Ne |
| Gemini 2.5 Pro | $ 1.25- $ 2.50 | $10.00 | 1M | Ano | |
| Blíženci Flash | $0.15 | $0.60 | 1M | Ano | |
| DeepSeek | V3.2 | $0.28 | $1.10 | 64 | Omezený |
| Groq | Flame 4 Maverick | $0.20 | $0.60 | 128 | Ano |
| Společně AI | Různý | od $ 0.90 | od $ 0.90 | Různé | Ano |
Porovnání schopností – které API skutečně funguje
Ne každý model je určen pro stejný úkol. Výběr nesprávného modelu pro váš případ použití znamená, že zaplatíte více za horší výsledky.
Nejlepší pro všeobecné použití / chat
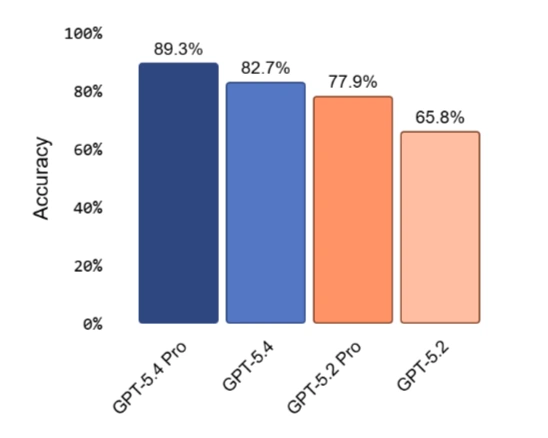
???? OtevřenáAI GPT-5.4 — Stále nejsilnější celkový výkon v benchmarku v roce 2026. Pokud vaše aplikace vyžaduje konzistentní kvalitu napříč různými výzvami, je to výchozí nastavení.
Nejlepší pro kódovací úkoly
👉 Claude Sonnet 4.6 — Překonává GPT v úlohách generování kódu a vícekrokového uvažování. Kontextové okno o velikosti 200K znamená, že dokáže zpracovat celé kódové základny bez jejich rozdělování na bloky.
Nejlepší pro zpracování dokumentů s dlouhým kontextem
👉 Gemini Flash — Nejlevnější cena za token pro čtení s dlouhým kontextem. Pokud zpracováváte právní dokumenty, přepisy nebo rozsáhlé znalostní báze, je to v daném měřítku jediná rozumná možnost.
Nejlepší pro velkoobjemové / agentní kanály
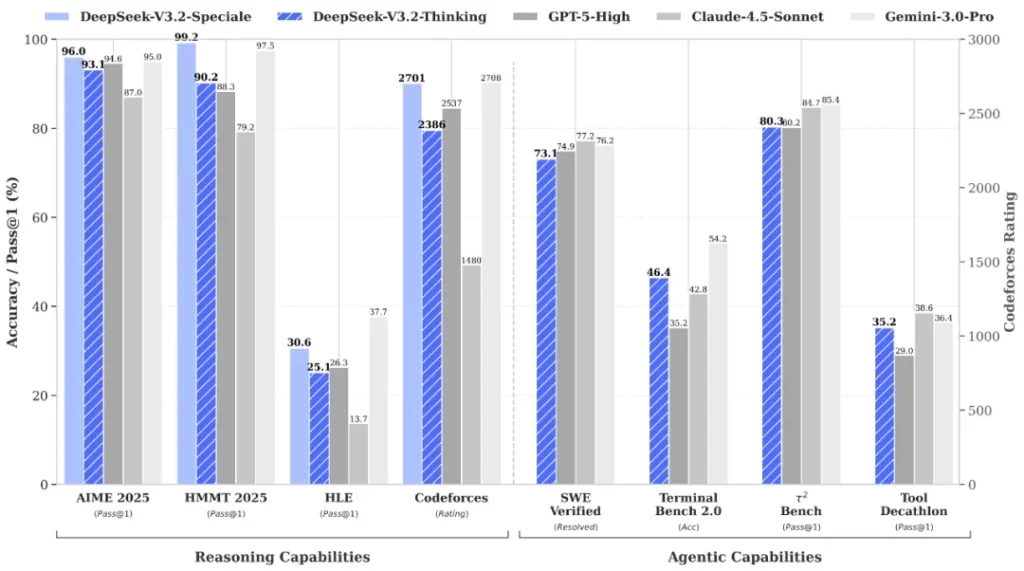
👉 DeepSeek V3.2 + MiniMax M2.5 jako levné výchozí řešení s prémiovým záložním vzorem. Pro kanály s více než 50 000 hovory denně toto nastavení směrování snižuje náklady 10x–50x.
Nejlepší pro multimodální (text + obraz + zvuk)
👉 Gemini 2.5 Pro přes Google Vertex AI – Jeden sjednocený koncový bod pro text, obraz a zvuk. Žádné spojování samostatných API.
Referenční příručka pro směrování případů užití:
| Použijte pouzdro | Doporučené API | Proč |
|---|---|---|
| Obecný chat/asistent | GPT-5.4 | Nejlepší celková kvalita |
| Generování kódu | Claude Sonnet 4.6 | Nejlepší kódovací benchmarky, široký kontext |
| Dlouhé zpracování dokumentů | Blíženci Flash | Nejlevnější v kontextu 1 milionu tokenů |
| Potrubí s vysokým objemem | DeepSeek V3.2 | O 90 % levnější ve velkém měřítku |
| Multimodální aplikace | Gemini 2.5 Pro | Sjednocený text + vizuální obsah + zvuk |
Spolehlivost v roce 2026 – Čísla provozuschopnosti, na kterých skutečně záleží
Procenta dostupnosti zní nudně, dokud se vaše aplikace během špičky nerozpadne. Zde's co tato čísla znamenají v reálném čase:
Pro produkční SaaS se skutečnými uživateli jsou i 4 hodiny výpadku noční můrou zákaznické podpory. Ale samotná dostupnost není celý příběh.
Latence p99 je metrika, na které většina vývojářů zapomíná. Pokud je vaše latence p50 400 ms, ale p99 4 000 ms – znamená to, že 1 ze 100 požadavků trvá 10 sekund. Uživatelům je váš průměr jedno. Všímají si těch pomalých.
Benchmark pro zdravého poskytovatele:
Před spuštěním jakéhokoli poskytovatele do produkčního prostředí spusťte 24hodinový zátěžový test. Co se v 5minutovém testu jeví stabilní, se může při trvalém provozu zhroutit.
Stručný přehled spolehlivosti:
| Provider | Uptime SLA | Transparentnost limitů sazeb | Veřejná stránka se stavem |
|---|---|---|---|
| OpenAI | 99.9% | zdokumentovány | Ano |
| Antropický | 99.9% | zdokumentovány | Ano |
| Google Vertex | 99.95% | zdokumentovány | Ano |
| DeepSeek | ~ 99.5% | Částečný | Ano |
| Groq | 99.9% | zdokumentovány | Ano |
| Společně AI | 99.5% | Částečný | Ano |
Jak špičkoví vývojáři používají 2–3 API, ne jedno
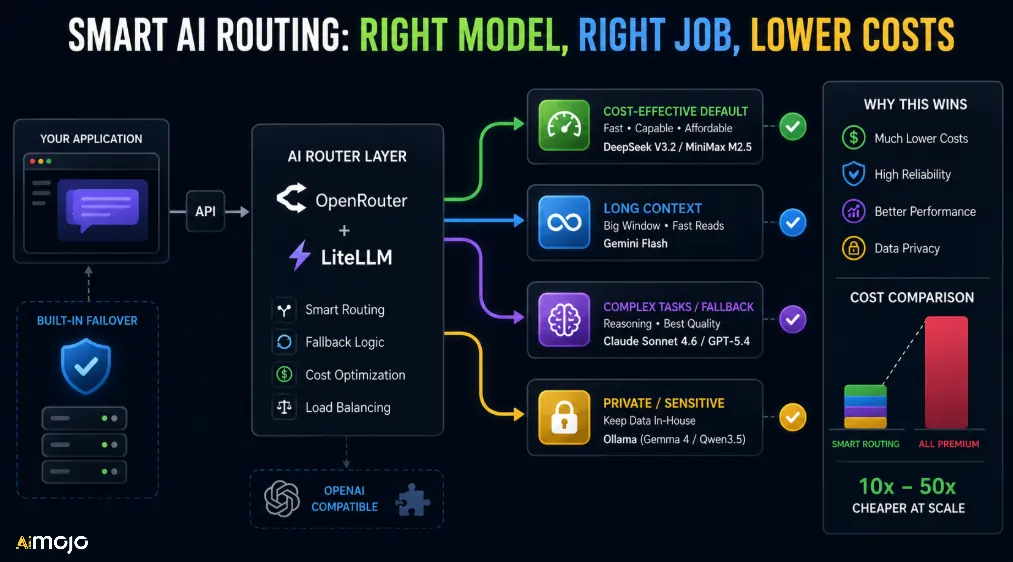
Uzamčení do jednoho AI Poskytovatel API v roce 2026 je jako mít jeden server bez možnosti failoveru. Zde's směrovací vzorec, který's stává se výrobním standardem:
- Výchozí provoz → DeepSeek V3.2 nebo MiniMax M2.5 (nejlevnější model s touto funkcí)
- Dlouhokontextové čtení → Blíženci
- Složité úkoly / záložní řešení → Claude Sonnet 4.6 nebo GPT-5.4
- Soukromé nebo citlivé úlohy → Lokální inference pomocí Ollamy (Gemma 4 / Qwen3.5)
Nástroje, které to usnadňují: OpenRouter pro sjednocený přístup k modelu, LiteLLM pro samostatně hostovanou směrovací vrstvu s nouzovou logikou. Oba podporují přidané koncové body kompatibilní s OpenAI, takže nemusíte přepisovat volání API.
Rozdíl v nákladech mezi nastavením „levný výchozí + prémiový záložní“ a směrováním všeho přes GPT-5.4 může být ve velkém měřítku 10x–50x měsíčně.
Skryté náklady, které většina vývojářů ignoruje
Cena za token na stránce s cenami nikdy neuvádí celý příběh.
Často kladené otázky týkající se vývojářů AI API
Co je nejlevnější AI API pro produkční použití v roce 2026?
DeepSeek V3.2 s cenou 0.28 USD/1 milion vstupních tokenů je v současné době nejlevnější možností pro produkci. Groq s Llama 4 Maverick je těsně za ním s cenou 0.20 USD/1 milion a rychlejšími inferencemi.
Který AI Má API SLA s nejvyšší dostupností?
Google Vertex AI nabízí SLA s 99.95% dostupností, což ji řadí před OpenAI a antropické's 99.9% závazky pro podnikové úlohy.
Jak si mám vypočítat měsíční AI Cena API před spuštěním?
Odhadněte průměrnou délku výzvy + délku odezvy v tokenech, vynásobte očekávaným denním objemem hovorů a poté použijte poskytovatele.'s vstupní/výstupní sazby tokenů. Většina poskytovatelů nyní nabízí kalkulačky nákladů – použijte je před provedením závazku.
Je DeepSeek API dostatečně spolehlivé pro produkční prostředí?
Funguje dobře pro nekritický nebo velkoobjemový výchozí provoz v nastavení směrování s více poskytovateli. Pro kritické úlohy, kde jsou výpadky nepřijatelné, jej použijte jako primární protokol se spolehlivějším záložním protokolem, jako je GPT-5.4 nebo Claude.
Co's rozdíl mezi AI Limity rychlosti API a kontextové limity?
Limity rychlosti omezují počet požadavků, které můžete odeslat za minutu nebo den. Limity kontextu omezují množství textu, který může jeden požadavek obsahovat. Oba faktory ovlivňují způsob, jakým navrhujete svou aplikaci – nezaměňujte je.
Mohu použít více AI API pohromadě v jedné aplikaci?
Ano, a většina produkčních systémů v roce 2026 přesně tohle dělá. Nástroje jako OpenRouter a LiteLLM usnadňují routing s více poskytovateli s minimálními změnami kódu.
Který AI Je API nejlepší pro vytvoření kódovacího asistenta?
Claude Sonnet 4.6 vede v kódovacích benchmarkech v roce 2026 s kontextovým oknem o velikosti 200 tisíc, které zpracovává reálné kódové základny bez rozdělování na bloky.
AiMojo doporučuje:


 BONUS: Získejte našich 200 dolarůAI „Sada nástrojů pro mistrovství“ ZDARMA při registraci!


