
ของคุณ AI ตัวแทนคนนี้มีปัญหา มันรู้ทุกอย่างเกี่ยวกับโลกจนถึงวันที่การฝึกอบรมสิ้นสุดลง ลองถามมันเกี่ยวกับคู่แข่งดูสิ's ไม่ว่าจะเป็นหน้าแสดงราคา ข่าวสารล่าสุด หรือเอกสารของห้องสมุดที่เพิ่งจัดส่งไปเมื่อสัปดาห์ที่แล้ว ระบบก็จะคาดเดาหรือขอโทษไปพร้อมกัน
วิธีแก้ปัญหาคือข้อมูลเว็บแบบเรียลไทม์ และในปี 2026 วิธีที่เร็วที่สุดในการส่งข้อมูลนี้ไปยังระบบใดๆ ก็ตาม AI ระบบที่ใช้คือ Firecrawl
เราใช้ Firecrawl ทั่วทั้งเครือข่ายของเราเอง มันช่วยในการดึงข้อมูลในแอปพลิเคชันที่ใช้งานจริง ของเรา ป้อนข้อมูลให้กับเอเจนต์วิจัยของเรา และทำงานภายในเวิร์กโฟลว์ WordPress ของเรา
คู่มือนี้มีทุกอย่างที่เราอยากให้ใครสักคนมอบให้เราตั้งแต่วันแรก: การตั้งค่าแบบไม่ต้องเขียนโค้ดด้วยการคลิกเพียงครั้งเดียว โค้ด Python และ Node การดึงข้อมูลแบบมีโครงสร้าง ไปป์ไลน์ RAG ที่ใช้งานได้จริง และเคล็ดลับด้านต้นทุนที่ทำให้ค่าใช้จ่ายน้อยที่สุด
ไม่มีเนื้อหาไร้สาระเลย ปล่อยให้...'s สร้าง. 🚀
สิ่งที่เราจะสร้างในคู่มือการปีนป่ายไฟนี้
เมื่อจบบทเรียนนี้ คุณจะสามารถ:
- เชื่อมต่อ Firecrawl กับ Claude, ChatGPT หรือ Cursor ได้ในคลิกเดียว (ไม่ต้องเขียนโค้ดเลย)
- แปลง URL ใดๆ ให้เป็นไฟล์ Markdown ที่สะอาดและพร้อมใช้งานสำหรับ LLM ด้วย Python หรือ Node
- รวบรวมข้อมูลจากเว็บไซต์ทั้งหมดลงในชุดข้อมูล
- แยกโครงสร้าง JSON จากหน้าเว็บที่ไม่เป็นระเบียบโดยใช้ Schema
- เชื่อมต่อข้อมูลเว็บแบบเรียลไทม์เข้ากับไปป์ไลน์ RAG ด้วย LangChain หรือ LlamaIndex
- ควบคุมการใช้เครดิตของคุณให้ประหยัด
ข้อกำหนดเบื้องต้นเพียงอย่างเดียวคือต้องมีคีย์ API ของ Firecrawl ซึ่งส่วนนี้ไม่มีค่าใช้จ่าย
ขั้นตอนที่ 1: รับคีย์ API ของคุณ (เครดิตฟรี 1,000 หน่วย ไม่ต้องใช้บัตร) 🔑
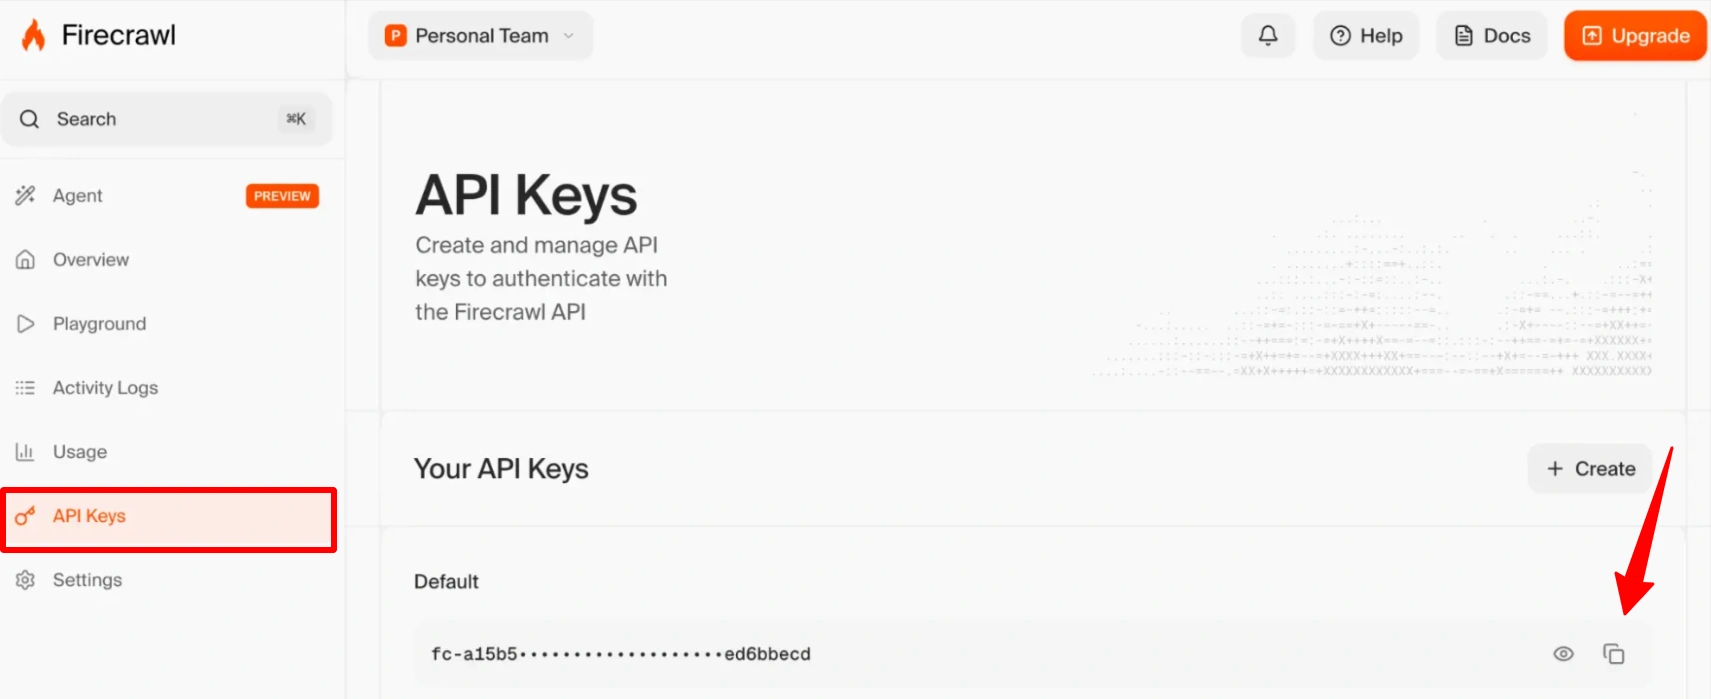
แพ็กเกจฟรีของ Firecrawl ให้คุณ1,000 เครดิตทุกเดือนหนึ่งเครดิตเท่ากับหนึ่งหน้าเว็บที่ดึงข้อมูลมา ดังนั้นคุณจะได้ 1,000 หน้าต่อเดือน โดยจะต่ออายุอัตโนมัติไปเรื่อยๆ และไม่ต้องใช้บัตรเครดิต ซึ่งมากเกินพอที่จะทำตามบทช่วยสอนนี้ได้หลายครั้งเลยทีเดียว
|
เมื่อคุณเข้าสู่แดชบอร์ดแล้ว ให้คัดลอกคีย์ API ของคุณ คีย์จะขึ้นต้นด้วย fc- สตริงนั้นคือรหัสลับของคุณสำหรับทุกอย่างด้านล่าง
ขั้นตอนที่ 2: เส้นทางคลิกเดียว (ไม่ต้องเขียนโค้ด) ⚡
ก่อนที่เราจะเขียนโค้ดแม้แต่บรรทัดเดียว โปรดทราบว่า คุณอาจไม่จำเป็นต้องใช้โค้ดเลยก็ได้
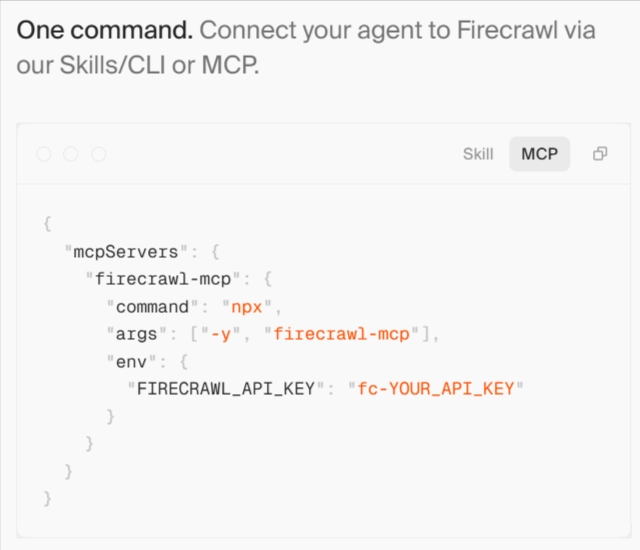
Firecrawl รันเซิร์ฟเวอร์ MCP (Model Context Protocol) อย่างเป็นทางการ และเชื่อมต่อกับเว็บไซต์ที่คุณชื่นชอบ AI คุณสามารถเชื่อมต่อเครื่องมือต่างๆ ได้ในลักษณะเดียวกับการเชื่อมต่อบัญชี Gmail เซิร์ฟเวอร์ที่ให้บริการอยู่ที่:
https://mcp.firecrawl.dev/v2/mcpเพิ่มคีย์ API ของคุณลงใน URL แล้วเครื่องมือใดๆ ที่ใช้งานร่วมกับ MCP ได้ก็จะสามารถใช้งานได้:
https://mcp.firecrawl.dev/fc-YOUR_API_KEY/v2/mcpใน Claude (เวอร์ชันเว็บหรือเดสก์ท็อป):เพิ่ม Firecrawl เป็นตัวเชื่อมต่อ หรือคัดลอกโค้ดนี้ลงในไฟล์ claude_desktop_config.json:
{
  "mcpServers": {
    "firecrawl": {
      "command": "npx",
      "args": ["-y", "firecrawl-mcp"],
      "env": {
        "FIRECRAWL_API_KEY": "fc-YOUR_API_KEY"
      }
    }
  }
}เมื่อเชื่อมต่อแล้ว ของคุณ AI ผู้ช่วย ได้รับความสามารถใหม่สิบอย่าง ได้แก่ การดึงข้อมูล การค้นหา การรวบรวมข้อมูล การสร้างแผนที่ การสกัด การโต้ตอบ การตรวจสอบ การวิเคราะห์ การวิจัย และตัวแทนอัตโนมัติเต็มรูปแบบ และคุณสามารถควบคุมทุกอย่างได้ด้วยภาษาอังกฤษธรรมดา
ลองใช้คำแนะนำแบบนี้ดู:
- คัดลอกข้อมูลจาก https://competitor.com/pricing และสรุปแผนทั้งหมดลงในตาราง
- ศึกษาเอกสารที่ docs.example.com จำนวนไม่เกิน 50 หน้า และอธิบายวิธีการทำงานของระบบตรวจสอบสิทธิ์ (authentication)
- ค้นหาคำว่า “ดีที่สุด” บนเว็บ AI ค้นหา "โปรแกรมสร้างวิดีโอปี 2026" และเปรียบเทียบผลลัพธ์ 5 อันดับแรก
นี่คือการตั้งค่าที่สมาชิกทีมที่ไม่เชี่ยวชาญด้านเทคนิคของเราใช้เป็นประจำทุกวัน ไม่ต้องใช้เทอร์มินัล ไม่ต้องเขียนโค้ด มีข้อมูลเว็บจริง ๆ อยู่ในทุกการสนทนา หากนี่คือทั้งหมดที่คุณต้องการ คุณสามารถหยุดตรงนี้ได้เลย แต่ถ้าคุณกำลังสร้างแอปพลิเคชัน API คือส่วนที่ทำให้ Firecrawl สนุกยิ่งขึ้น
ขั้นตอนที่ 3: ดึงข้อมูลหน้าแรกของคุณด้วย API 🐍
ถึงเวลาเขียนโค้ดแล้ว ติดตั้ง SDK:
# Python
pip install firecrawl
# Node.js
npm install firecrawl
การดึงข้อมูลจาก URL ใช้เพียงสามบรรทัด นี่คือโค้ด Python:
จาก firecrawl นำเข้า Firecrawl
firecrawl = Firecrawl(api_key="fc-YOUR_API_KEY")
doc = firecrawl.scrape("https://firecrawl.dev", formats=["markdown"])
print(doc.markdown)
และโหนด:
import { Firecrawl } from 'firecrawl';
const firecrawl = new Firecrawl({ apiKey: 'fc-YOUR_API_KEY' });
const doc = await firecrawl.scrape('https://firecrawl.dev', { formats: ['markdown'] });
console.log(doc.markdown);
ลองรันโปรแกรมแล้วดูผลลัพธ์ นั่นแหละคือเคล็ดลับทั้งหมดที่ทำให้ Firecrawl พิเศษ: สิ่งที่ได้กลับมาไม่ใช่โค้ด HTML ดิบๆ แต่เป็นมาร์กดาวน์ที่สะอาดตา มีหัวข้อ รายการ และลิงก์ที่ถูกต้อง พร้อมแถบนำทาง แบนเนอร์คุกกี้ สคริปต์ และส่วนท้ายที่ไม่จำเป็นถูกตัดออกไปแล้ว
ทำไมเรื่องนี้ถึงสำคัญมาก? มีสองเหตุผลครับ คือ โทเค็นและความถูกต้อง โค้ด HTML ดิบจากหน้าเว็บทั่วไปอาจมีขนาดใหญ่กว่าเนื้อหาจริงถึง 10 เท่า และโทเค็นที่ไม่ถูกต้องทุกตัวล้วนมีค่าใช้จ่ายและทำให้โมเดลของคุณด้อยคุณภาพลง's โปรดทราบ การจัดรูปแบบ Markdown ที่เรียบร้อยหมายถึงคำถามที่สั้นลง ค่าใช้จ่ายในการเรียน LLM ที่ต่ำลง และคำตอบที่อิงตามเนื้อหาแทนที่จะเป็นความยุ่งเหยิง
คุณยังสามารถขอรูปแบบอื่นๆ ในการเรียกใช้เดียวกันได้ เช่น HTML, ภาพหน้าจอ, ลิงก์ หรือ JSON ที่มีโครงสร้าง เรียงลำดับตามต้องการ:
doc = firecrawl.scrape(
    "https://example.com/blog/post",
    formats=["markdown", "links"]
)
โดยค่าเริ่มต้น Firecrawl จะแสดงผล JavaScriptดังนั้นเว็บไซต์ React หน้าเว็บแบบไดนามิก และเนื้อหาที่แสดงผลฝั่งไคลเอนต์จึงแสดงผลได้อย่างสมบูรณ์ ไม่จำเป็นต้องมีการดูแลจากฝั่งเบราว์เซอร์แบบ Headless อีกต่อไป
ขั้นตอนที่ 4: รวบรวมข้อมูลเว็บไซต์ทั้งหมด 🕸️
หนึ่งหน้าเป็นเพียงตัวอย่าง ส่วนเว็บไซต์ทั้งหมดคือชุดข้อมูล
จุดรวบรวมข้อมูลจะติดตามลิงก์จาก URL เริ่มต้นและดึงข้อมูลทุกอย่างที่พบ โดยมีตัวควบคุมสำหรับความลึก ขีดจำกัดจำนวนหน้า และตัวกรองเส้นทาง:
from firecrawl import Firecrawl
from firecrawl.types import ScrapeOptions
firecrawl = Firecrawl(api_key="fc-YOUR_API_KEY")
crawl_status = firecrawl.crawl(
    'https://docs.example.com',
    limit=100,
    scrape_options=ScrapeOptions(formats=['markdown']),
    poll_interval=30
)
for page in crawl_status.data:
    print(page.metadata.url)
เวอร์ชัน Node:
const crawlResponse = await firecrawl.crawl('https://docs.example.com', {
  limit: 100,
  scrapeOptions: { formats: ['markdown'] }
});
console.log(`Crawled ${crawlResponse.data.length} pages`);
SDK จะจัดการการตรวจสอบสถานะงานและการแบ่งหน้าให้คุณโดยอัตโนมัติ และส่งคืนทุกหน้าในรูปแบบ Markdown ที่สะอาดตา มีพารามิเตอร์สามอย่างที่ควรจดจำ:
- จำกัด จำกัดจำนวนหน้าทั้งหมด ตั้งค่านี้เสมอ นี่คือเข็มขัดนิรภัยสำหรับเครดิตของคุณ
- รวมเส้นทาง / ยกเว้นเส้นทาง กรอง URL ด้วยรูปแบบ regex กำลังรวบรวมข้อมูลจากเว็บไซต์เอกสารใช่ไหม? ยกเว้น /blog/.* และ /careers/.* เพื่อหยุดจ่ายเงินสำหรับหน้าเว็บที่คุณจะไม่มีวันใช้
- ความลึกการค้นพบสูงสุด ควบคุมจำนวนลิงก์ที่โปรแกรมรวบรวมข้อมูลจะติดตามจาก URL เริ่มต้น
เทคนิคขั้นสูง:ก่อนทำการรวบรวมข้อมูลเว็บไซต์จำนวนมาก ให้ลองใช้ เอนด์พอยต์ Mapก่อน มันจะส่งคืน URL ทั้งหมดของเว็บไซต์ในเวลาไม่กี่วินาทีโดยแทบไม่ต้องเสียค่าใช้จ่ายใดๆ กำหนดขอบเขตงาน นับจำนวนหน้า แล้วจึงรวบรวมข้อมูลเฉพาะส่วนที่คุณต้องการ
result = firecrawl.map("https://docs.example.com")
print(f"{len(result.links)} URLs found")
ขั้นตอนที่ 5: ดึงข้อมูลที่มีโครงสร้างด้วย Schema 📊
Markdown เหมาะอย่างยิ่งสำหรับ RAG แต่บางครั้งคุณอาจต้องการฟิลด์ ไม่ใช่ข้อความ เช่น ชื่อสินค้า ราคา คะแนนรีวิว นั่นคือจุดที่เอนด์พอยต์ Extract เข้ามามีบทบาท's งาน คุณอธิบายลักษณะของข้อมูล Firecrawl's AI ดึงมันออกมาจากหน้ากระดาษ:
schema = {
    "type": "object",
    "properties": {
        "product_name": {"type": "string"},
        "price": {"type": "string"},
        "rating": {"type": "number"},
        "in_stock": {"type": "boolean"}
    },
    "required": ["product_name", "price"]
}
result = firecrawl.extract(
    urls=["https://example-store.com/product/xyz"],
    prompt="Extract the product details from this page",
    schema=schema
)
print(result.data)
ไม่มีตัวเลือก CSS ไม่มี XPath ไม่มีตัวแยกวิเคราะห์ที่พังทลายเมื่อเว็บไซต์เปลี่ยนเค้าโครง คุณกำหนดสิ่งที่คุณต้องการ และการดึงข้อมูลจะยังคงใช้งานได้แม้จะมีการออกแบบใหม่ เพราะมันเข้าใจเนื้อหา ไม่ใช่มาร์กอัป
รูปแบบนี้ใช้งานจริงบนเครือข่ายของเราเลยครับ: แอปตัวหนึ่งของเราใช้ Extract ในการแปลงหน้าข้อมูลผู้ให้บริการที่ยุ่งเหยิงให้เป็นฐานข้อมูลราคาที่เป็นมาตรฐานเดียวกันโดยอัตโนมัติ ตามกำหนดเวลา โครงสร้างข้อมูลเดียวกันนี้ใช้งานได้กับเว็บไซต์ที่มีการออกแบบแตกต่างกันหลายสิบแห่ง ลองสร้างแบบนั้นด้วย regex แล้วมารายงานผลให้ฟังด้วยนะครับ 😅
ขั้นตอนที่ 6: มอบการค้นหาเว็บให้กับตัวแทนของคุณ 🔎
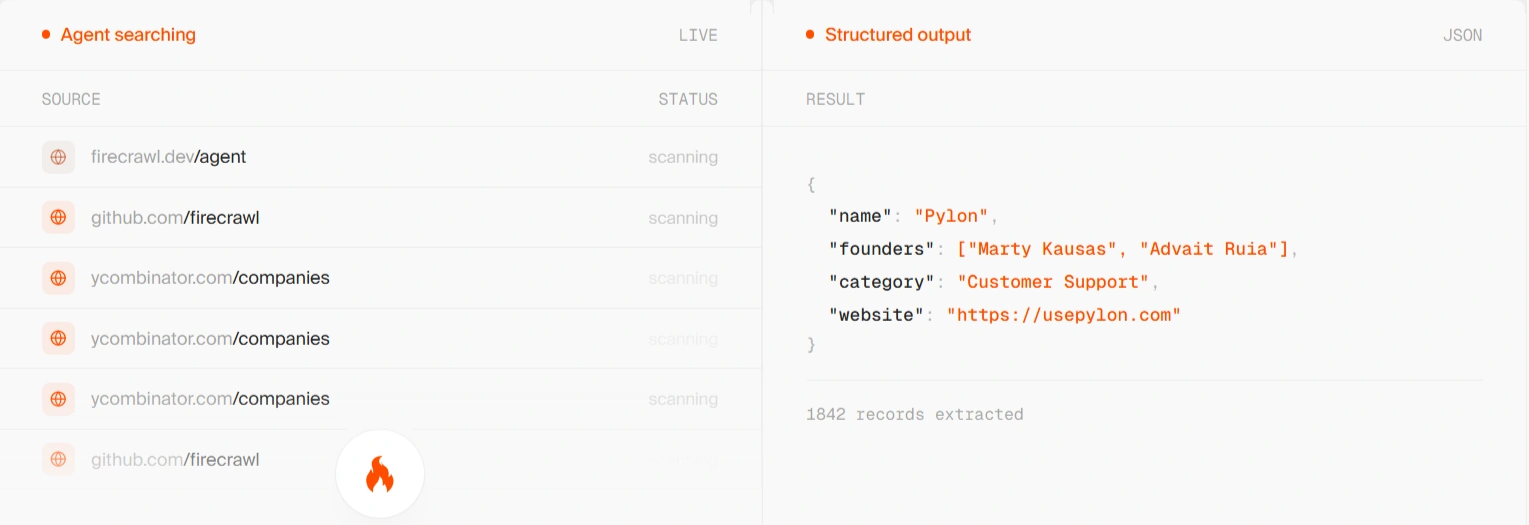
การดึงข้อมูล (Scraping) จะจัดการกับ URL ที่คุณรู้จักอยู่แล้ว ส่วนการค้นหา (Search) จะจัดการกับ URL ที่คุณไม่รู้จัก
ฟีเจอร์ที่สำคัญที่สุดของแพลตฟอร์ม Firecrawl คือ Search endpoint API ค้นหาส่วนใหญ่จะส่งคืนลิงก์และข้อความย่อ จากนั้นปล่อยให้คุณไปดึงและทำความสะอาดผลลัพธ์แต่ละรายการด้วยตัวเอง แต่ Firecrawl จะส่งคืนผลลัพธ์พร้อมเนื้อหาที่ดึงมาทั้งหมดในการเรียกใช้เพียงครั้งเดียว:
results = firecrawl.search(
    query="best open source LLMs 2026",
    limit=5
)
สำหรับรายการใน results.web:
print(item.title, item.url)Node.js ที่เปิดใช้งานการดึงข้อมูลเนื้อหาตามผลลัพธ์แต่ละรายการ:
const results = await firecrawl.search('best open source LLMs 2026', {
  limit: 5,
  scrapeOptions: { formats: ['markdown'] }
});นี่คือส่วนประกอบพื้นฐานสำหรับตัวแทนวิจัย วงจรการทำงานนั้นง่ายมาก: ตัวแทนของคุณสร้างคำค้นหา Firecrawl ส่งคืนเนื้อหาที่อ่านได้จากผลลัพธ์อันดับต้น ๆ LLM ของคุณสังเคราะห์คำตอบพร้อมแหล่งที่มา นั่นคือการวิจัยเชิงลึก และคุณสร้างมันขึ้นมาได้ในเวลาเพียงไม่กี่บรรทัด
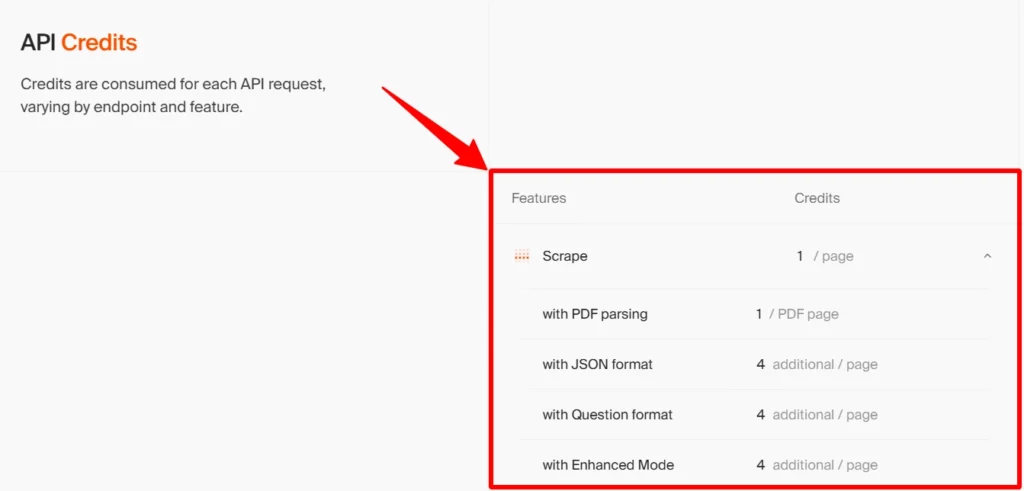
หมายเหตุเกี่ยวกับค่าใช้จ่าย:การค้นหาใช้ 2 เครดิตต่อ 10 ผลลัพธ์ บวกกับเครดิตการดึงข้อมูลตามปกติเมื่อคุณดึงเนื้อหาทั้งหมด อย่างไรก็ตาม ยังคงถูกกว่า API ตอบคำถามเฉพาะทางใดๆ ที่เราเคยทดสอบมาอย่างมาก
ขั้นตอนที่ 7: เชื่อมต่อเข้ากับท่อ RAG 🧠
ถึงเวลาสำคัญแล้ว: การให้อาหาร AI ตัวแทนมีความรู้เกี่ยวกับเว็บแบบเรียลไทม์ ทั้งสองเฟรมเวิร์กหลักมีตัวโหลด Firecrawl ระดับพรีเมียม
แลงเชน:
- จาก langchain_community.document_loaders นำเข้า FireCrawlLoader
- จาก langchain_text_splitters นำเข้า RecursiveCharacterTextSplitter
- จาก langchain_openai import OpenAIEmbeddings
- จาก langchain_community.vectorstores นำเข้า FAISS
# 1. โหลดทั้งเว็บไซต์เป็นเอกสารสะอาด
loader = FireCrawlLoader(
    api_key="fc-YOUR_API_KEY",
    url="https://docs.example.com",
    mode="crawl"
)
docs = loader.load()
# 2. หั่นเป็นชิ้นๆ
splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=100)
chunks = splitter.split_documents(docs)
# 3. ฝังและจัดทำดัชนี
vectorstore = FAISS.from_documents(chunks, OpenAIEmbeddings())# 4. ตั้งคำถามโดยใช้ข้อมูลเว็บจริงเป็นเกณฑ์
retriever = vectorstore.as_retriever()
relevant = retriever.invoke("How do I authenticate API requests?")
ลามะอินด็อกซ์:
- จาก llama_index.readers.web นำเข้า FireCrawlWebReader
- จาก llama_index.core นำเข้า VectorStoreIndex
reader = FireCrawlWebReader(
    api_key="fc-YOUR_API_KEY",
    mode="crawl",
    url="https://docs.example.com"
)
documents = reader.load_data()
index = VectorStoreIndex.from_documents(documents)
response = index.as_query_engine().query("How does their pricing work?")
print(response)
นี่คือกระบวนการ "แชทกับเว็บไซต์ใดก็ได้" ที่สมบูรณ์แบบในบรรทัดไม่ถึง 25 บรรทัด เนื่องจาก Firecrawl ส่งข้อมูล Markdown ที่สะอาดให้กับตัวโหลดแทนที่จะเป็น HTML ทำให้ข้อมูลของคุณมีความสอดคล้องกัน การฝังข้อมูลมีความหมาย และคุณภาพการดึงข้อมูลดีขึ้นอย่างมากเมื่อเทียบกับการดึงข้อมูลแบบธรรมดา นี่คือเหตุผลสำคัญที่สุดที่ผู้สร้าง RAG เลือกใช้ Firecrawl
ตัวโหลดเดียวกันนี้สามารถใช้งานได้กับ CrewAI, Dify, Flowise และ n8n หากคุณถนัดการทำงานแบบเห็นภาพมากกว่า
เคล็ดลับเพิ่มเติม: สถาปัตยกรรมประหยัดต้นทุนที่ไม่มีใครพูดถึง 💡
นี่คือรูปแบบที่จะช่วยประหยัดเงินให้กับแอปของเราได้จริง ๆ ทุกเดือน
เมื่อแอปของคุณต้องการคำตอบที่เชื่อมโยงกับเว็บ วิธีที่ชัดเจนที่สุดคือการใช้ LLM ที่มีระบบค้นหาเว็บในตัวแต่ผู้ให้บริการมักคิดค่าบริการค้นหาเว็บเป็นส่วนเสริม และ API สำหรับตอบคำถามโดยเฉพาะก็จะมีราคาแพงขึ้นอย่างรวดเร็วเมื่อใช้งานในระดับใหญ่
การแบ่งแยกที่ชาญฉลาดกว่า:
Firecrawl (ดึงข้อมูล, ประมาณ 0.001 ดอลลาร์สหรัฐฯ ต่อหน้า) → LLM ราคาถูก (เหตุผล: ไม่จำเป็นต้องเข้าถึงเว็บ)
Firecrawl ค้นหาและดึงข้อมูลโดยคิดค่าบริการเพียงหนึ่งหรือสองเครดิตต่อคำขอ จากนั้นโมเดลราคาประหยัดใดๆ ก็ได้ เช่น DeepSeek, GPT หรือ Claude tier ขนาดเล็ก หรือโมเดลโอเพนซอร์สใดๆ ที่คุณใช้งานบน VPS ของคุณเอง จะทำการสรุปและเขียนทับเนื้อหาที่สะอาดแล้วนั้น คุณภาพของคำตอบก็เหมือนกัน แต่ต้นทุนต่ำกว่ามาก
วิธีนี้ก็ใช้ได้ผลดีเยี่ยมเช่นกันสำหรับ การตั้งค่าแบบโฮสต์เองกำลังใช้งาน Open WebUI หรือ UI แชทโอเพนซอร์สอื่นๆ บน VPS อยู่ใช่ไหม? เชื่อมต่อ Firecrawl เป็นเลเยอร์สำหรับการค้นหาและรวบรวมข้อมูลเว็บ และโฮสต์เซิร์ฟเวอร์ของคุณเอง AI จู่ๆ การวิจัยเชิงลึกแบบเรียลไทม์ก็กลายเป็นเหมือนผลิตภัณฑ์เชิงพาณิชย์ขนาดใหญ่
เคล็ดลับประหยัดค่าใช้จ่าย: ใช้เครดิตฟรี 1,000 หน่วยให้คุ้มค่าที่สุด 🪙
คู่มือฉบับย่อสำหรับการลดการใช้ทรัพยากรให้เหลือน้อยที่สุด:
| การกระทำ | ต้นทุนเครดิต |
|---|---|
| สแกน / ค้นหา / สร้างแผนที่ / ตรวจสอบ | 1 หน่วยกิตต่อหน้า |
| ค้นหา | 2 หน่วยกิตต่อผลลัพธ์ 10 รายการ |
| โต้ตอบ (การกระทำของเบราว์เซอร์) | 2 เครดิตต่อนาที |
| โหมดซ่อนตัว (เว็บไซต์ที่ได้รับการปกป้อง) | 5 หน่วยกิตต่อหน้า |
5 นิสัยสำคัญ:
- สำรวจแผนที่ก่อนเริ่มลงมือปฏิบัติ ตรวจสอบจำนวนหน้าก่อนชำระเงิน
- ตั้งเสมอ จำกัด ในการรวบรวมข้อมูล ค่าเริ่มต้นคือ 10,000 หน้า แพ็กเกจฟรีของคุณจำกัดไว้ที่ 1,000 หน้า คำนวณครั้งเดียวก็พอ อย่าคำนวณทีหลัง
- ใช้ ยกเว้นเส้นทาง อย่างดุดัน คลังบทความในบล็อก หน้าแท็ก และหน้าสมัครงาน ล้วนเป็นแหล่งทิ้งเครดิตอย่างไร้ประโยชน์
- บันทึกข้อมูลที่ดึงมาได้ลงในแคช เว็บไซต์เอกสารมีการเปลี่ยนแปลงทุกสัปดาห์ ไม่ใช่ทุกชั่วโมง บันทึกผลลัพธ์และทำการรวบรวมข้อมูลใหม่ตามกำหนดเวลา แทนที่จะทำตามคำขอแต่ละครั้ง
- เครดิตไม่สามารถสะสมไปใช้ในปีถัดไปได้ดังนั้น หากคุณต้องการอัปเกรด โปรดเลือกแพ็กเกจให้เหมาะสมกับปริมาณการใช้งานรายเดือนของคุณ แพ็กเกจแบบชำระเงินเริ่มต้นที่ 16 ดอลลาร์ต่อเดือน สำหรับ 5,000 เครดิต และแพ็กเกจมาตรฐานราคา 83 ดอลลาร์ ให้คุณใช้งานได้ 100,000 หน้า
ข้อผิดพลาดที่พบบ่อย (และวิธีแก้ไขอย่างรวดเร็ว) 🛠️
ห้าประเด็นหลักที่เป็นสาเหตุให้เราได้รับข้อความ "Firecrawl ใช้งานไม่ได้" แทบทุกครั้ง:
และอีกหนึ่งสิ่งที่ไม่ควรละเลยแต่ควรรู้ไว้คือ: หากการร้องขอไม่สำเร็จบน Firecrawl's ในส่วนนี้ คุณจะไม่ถูกเรียกเก็บเงิน
คำตอบด่วน 🎯
Firecrawl ทำงานอย่างไร?
คุณส่ง URL (หรือคำค้นหา) ไปยัง API ของระบบ แล้วระบบจะส่งเนื้อหาคืนมาในรูปแบบ Markdown, JSON หรือภาพหน้าจอที่เรียบร้อย โดยระบบจะจัดการการแสดงผล JavaScript และการลบสิ่งที่ไม่จำเป็นออกโดยอัตโนมัติ หนึ่งเครดิตต่อหน้า
Firecrawl เหมาะกับ RAG หรือไม่?
เป็นตัวเลือกเริ่มต้นในปี 2026 การส่งออกข้อมูล Markdown ที่สะอาดหมายถึงการแบ่งส่วนข้อมูลที่ดีขึ้น การฝังข้อมูลที่ดีขึ้น และการดึงข้อมูลที่ดีขึ้น พร้อมด้วยตัวโหลดอย่างเป็นทางการสำหรับ LangChain และ LlamaIndex
ฉันสามารถใช้ Firecrawl โดยไม่ต้องเขียนโค้ดได้หรือไม่?
ใช่แล้ว ตัวเชื่อมต่อ MCP แบบคลิกเดียวช่วยให้สามารถสแกน ค้นหา และแยกข้อมูลได้ภายใน Claude, ChatGPT, Perplexity และ Cursor โดยใช้คำแนะนำเป็นภาษาอังกฤษที่เข้าใจง่าย
มีบริการแบบฟรีไหม?
รับเครดิต 1,000 หน่วยทุกเดือน ต่ออายุอัตโนมัติ ไม่ต้องใช้บัตรสมัครได้ที่นี่ พร้อมส่วนลด 10% สำหรับการอัปเกรดครั้งแรก
สรุป: เอเยนต์ของคุณ ตอนนี้มีดวงตาแล้ว 👀
สรุปสิ่งที่คุณเพิ่งเรียนรู้:
ช่องว่างระหว่าง AI ตัวแทนที่คาดเดาและ AI เอเจนต์ที่รู้คือคีย์ API หนึ่งตัว Firecrawl ให้เครดิตฟรี 1,000 หน่วยต่อเดือนเพื่อใช้ในการปิดงาน และตัวอย่างทั้งหมดในคู่มือนี้ทำงานได้อย่างราบรื่นภายในโควต้าดังกล่าว
มีคอมพิวเตอร์ที่ใช้ Firecrawl อยู่หรือเปล่า?
บอกเราได้ในช่องแสดงความคิดเห็นเลยนะคะ โครงการจากผู้อ่านที่ดีที่สุดจะได้รับการนำเสนอในจดหมายข่าวของเราค่ะ ✌️


 โบนัส: รับ $200 ของเรา”AI Mastery Toolkit” ฟรีเมื่อคุณสมัคร!