
Fyrverkeri AI Viktiga insikter
Vad är Fireworks AI?
Fireworks AI är en högpresterande inferensplattform specialbyggd för utvecklare och företag som behöver köra, finjustera och skala öppen källkod. AI modeller i produktionshastighet. Plattformen grundades av tidigare medlemmar i PyTorch-teamet på Meta och erbjuder en öppenAI kompatibelt API som ger åtkomst till över 100 populära stora språkmodeller, visionsmodeller och bildgenereringsmodeller.
Fyrverkeri AI eliminerar den operativa bördan av att hantera GPU-infrastruktur genom att erbjuda både serverlösa och on-demand-distributionsalternativ. Företag använder Fireworks AI för att driva chatbotar, kodningsassistenter, sökmotorer och agenter AI arbetsflöden. Dess specialbyggda inferensmotor ger upp till 4 gånger högre dataflöde och 50 % lägre latens än vanliga serverstackar med öppen källkod, vilket gör den till en av de snabbaste AI API-leverantörer tillgängliga idag för generativa AI produktionsarbetsbelastningar.
Fireworks AI:s egenutvecklade inferensmotor är byggd från grunden för hastighet. Den levererar konsekvent en latens för första token på under 100 millisekunder över en mängd olika modellstorlekar. För alla applikationer som kräver realtidsrespons, såsom kundnära chattrobotar eller agentiska kodningsassistenter , är denna prestandafördel mätbar och betydande. Företag som Sourcegraph och Notion har offentligt noterat dataflödesökningar efter att ha migrerat till plattformen.
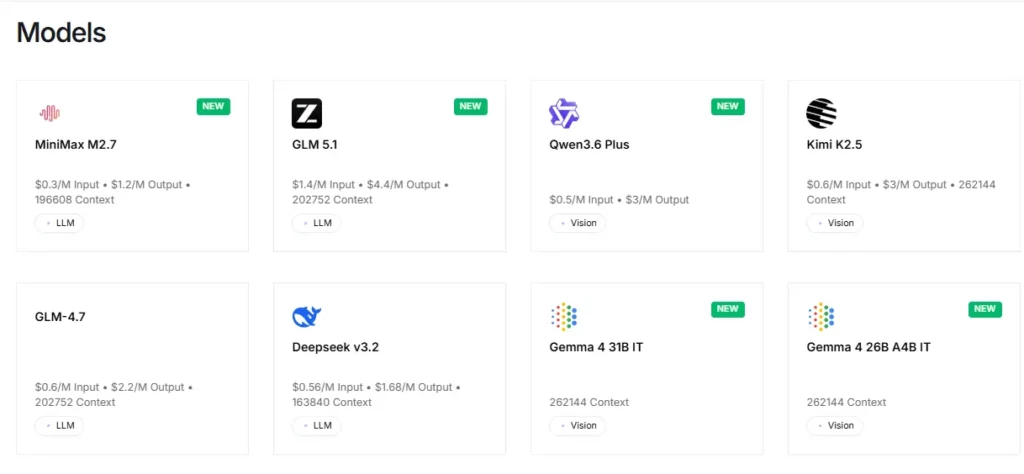
Plattformen ger omedelbar åtkomst till fler än 100 modeller med öppen källkod, inklusive bildgeneratorer som Llama, Qwen, DeepSeek, Kimi K2.5, GLM 5, Mixtral och FLUX . Utvecklare kan testa och växla mellan modeller via en enda API-slutpunkt utan konfigurationsändringar. Detta gör snabb prototypframställning och A/B-testning över modellfamiljer extremt effektiva.
Fyrverkeri AI stöder hela utbudet av finjusteringsmetoder, inklusive LoRA, fullständig parameterövervakad finjustering, DPO (preferensjustering) och förstärkningsfinjustering. Avgörande är att finjusterade modeller levereras till samma pris som basmodeller, vilket eliminerar den kostnadsböter som många konkurrenter ålägger. Finjustering av visionspråksmodeller stöds också, vilket gör det möjligt för team att anpassa multimodala modeller med sina egna bild- och textdataset.
För arbetsbelastningar som kräver dedikerade resurser, Fireworks AI erbjudanden på begäran GPU-distributioner faktureras per sekund. Hårdvaruutbudet inkluderar nu NVIDIA A100-, H100-, H200-, B200- och B300-grafikprocessorer. Detta ger ingenjörsteam flexibiliteten att köra privata, isolerade modellinstanser med garanterad kapacitet och utan problem med bullriga grannar.
Fire Pass är ett nyligen tillskott, en prenumeration som kostar 7 dollar per vecka och ger obegränsad tokenåtkomst till Kimi K2.5 Turbo-modellen med hastigheter runt 200 till 250 tokens per sekund. Den är specifikt utformad för utvecklare som använder agentiska kodningsverktyg som Claude Code och OpenCode, och erbjuder ett fast prisalternativ till oförutsägbar fakturering per token.
Fyrverkeri AI Prissättning planer
| Plan Namn | Pris | nyckel Detaljer |
|---|---|---|
| Serverlös (små modeller) | 0.10 USD per 1 miljon tokens | Modeller under 4B-parametrar |
| Serverlös (mellannivå) | 0.20 USD per 1 miljon tokens | Parametrar för modell 4B till 16B |
| Serverlös (stora modeller) | 0.90 USD per 1 miljon tokens | Modeller över 16B parametrar |
| Serverlös (MoE-modeller) | 0.50 till 1.20 dollar per 1 miljon tokens | Mixtral klass blandning av expertmodeller |
| Brandpass | $ 7 per vecka | Obegränsade Kimi K2.5 Turbo-tokens |
| På begäran (H100) | 6.00 USD per GPU-timme | Faktureras per sekund, dedikerad instans |
| På begäran (B200) | 9.00 USD per GPU-timme | Senaste generationens GPU, fakturerad per sekund |
| Företag | Custom | Årliga rabatter, servicenivåavtal och privata driftsättningar |
Komma igång med Fireworks AI
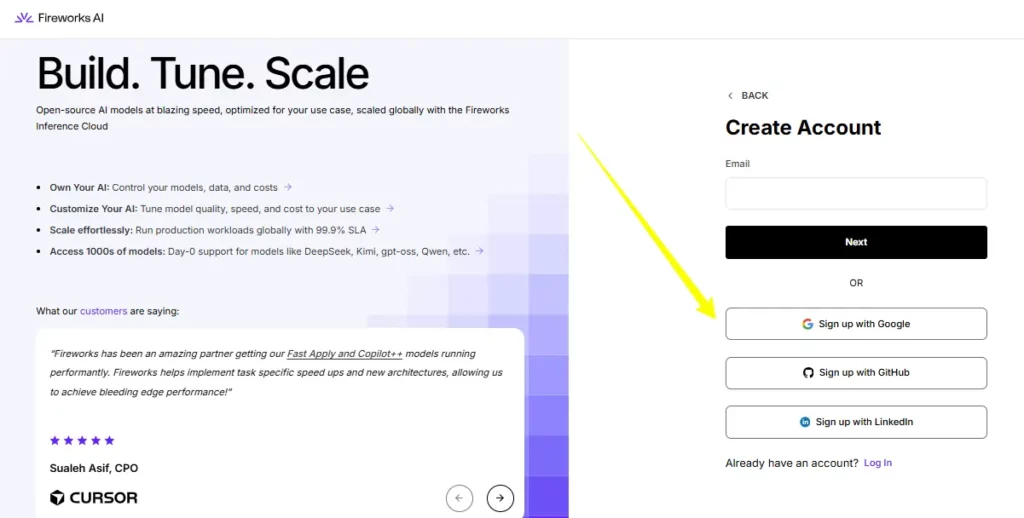
- Steg 1: Skapa ett konto på fyrverkerier.aiDu får automatiskt 1 USD i gratiskrediter när du registrerar dig.
- Steg 2: Navigera till avsnittet API-nycklar i din instrumentpanel och generera en ny API-nyckel.
- Steg 3: Installera Fireworks Python-klienten eller använd valfri öppen programvara.AI kompatibelt SDK. Peka din bas-URL till Fireworks API-slutpunkten.
- Steg 4: Välj en modell från modellbiblioteket, gör ditt första API-anrop och övervaka användning och fakturering från konsolen.
För-och nackdelar
- Branschledande inferenshastighet.
- 100+ modeller med öppen källkod tillgängliga.
- Fullständig finjusteringspipeline ingår.
- Fire Pass erbjuder obegränsat antal tokens.
- Senaste generationens GPU-hårdvara (B300).
- Endast utvecklare, ingen kodfri instrumentpanel.
- Inga inbyggda verktyg för affärsarbetsflöden.
- Kundsupporten kan vara långsam.
Bästa fyrverkerier AI alternativ
| AI Inferens- och modellserverplattform | Inferensgenomströmning | Kostnadseffektivitet |
|---|---|---|
| Tillsammans AI | 917 TPS, högre latens (0.78 s) | Liknande priser per token, mindre GPU-variation |
| Groq | 456 TPS via anpassade LPU:er, 0.19s latens | Lägre ingångspris, begränsat modellutbud |
| Återskapa | Medelhastighet, containerbaserad | Enkel fakturering per prediktion, mindre finjustering |
| Baseten | Anpassningsbar infrastruktur, måttlig hastighet | Flexibel men kräver mer konfiguration |


