
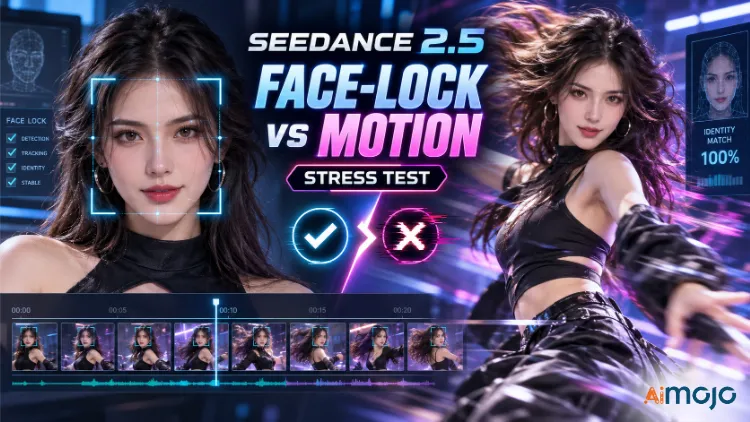
Du vet exakt vilket ögonblick jag menar. Bild ett, din AI Karaktären ser perfekt ut. Sedan vrider de på huvudet, tar två steg, öppnar munnen för att prata – och plötsligt är det någon annans ansikte som är fastsytt på samma outfit. Kindbenen förskjuts, näsan ordnar om sig, den där lilla födelsemärket du älskade har försvunnit.
Identitetsförskjutning är det som i tysthet förstör de flesta AI video, och det är anledningen till att jag slutade beundra demo-rullar och faktiskt satte mig ner för att testa Seedance 2.5 i APOB AI mig själv.
Frågan jag brydde mig om var rakt på sak: kan Face-Lock hålla en karaktärs identitet fast när saker och ting rör sig ? Ett snyggt ansikte som sitter stilla är trivialt. Ett ansikte som överlever en gångcykel, ett långsamt intryck, en huvudvändning och en dialograd utan att vingla – det är den verkliga ribban.
Så jag sprang flera generationer i sträck från APOB AI instrumentpanelen, tittade på dem bildruta för bildruta och hämtade resten av detaljerna från de officiella produktsidorna så att detta tydligt stämmer överens med vad du ser på din egen skärm. Här är exakt vad som hände.
Seedance 2.5 i APOB AI: Vad du faktiskt arbetar med
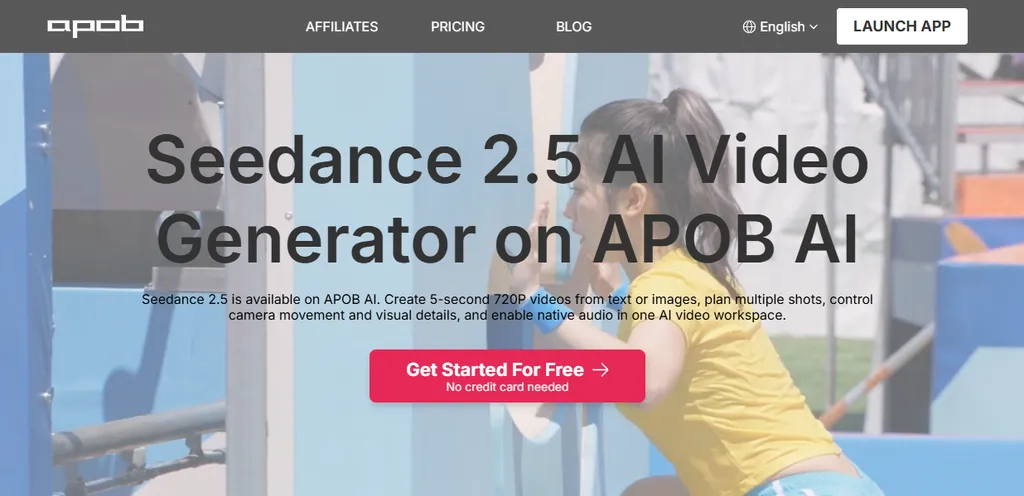
Snabb förberedelse innan resultaten. Seedance 2.5 är ByteDances nyare videogenereringsmodell, byggd på samma ljud-video-arkitektur som Seedance 2.0 men med fokus på längre berättande, multimodala referenser och exakt redigering på tidsstämpelnivå.
APOB AI är plattformen som omsluter den modellen i en skaparvänlig arbetsyta – samma verktyg som många redan använder för att SLUTRESULTAT AI påverkare, virtuella talespersoner och återkommande varumärkeskaraktärer.
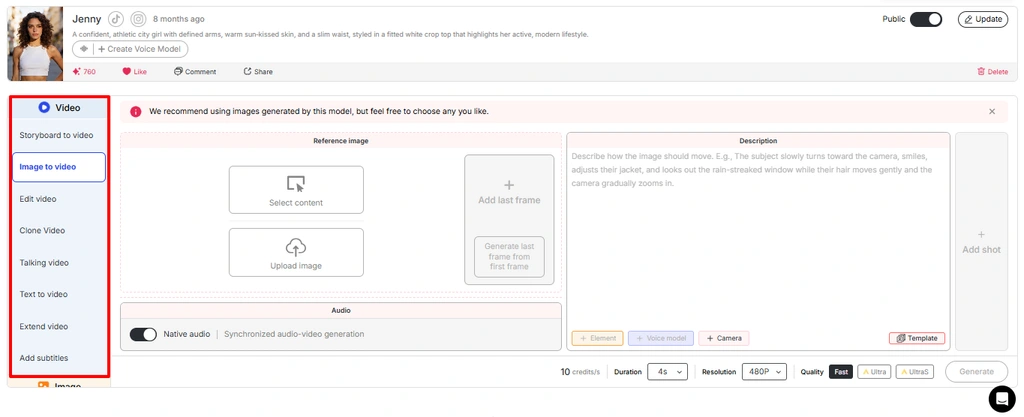
Inuti APOB AI videopanelen får du en komplett meny med lägen: Text till video, Bild till video, Talande avatar, Läppsynk, Videoansiktsbyte, Förläng video, Lägg till undertexter och Redigera video (ReVideo).
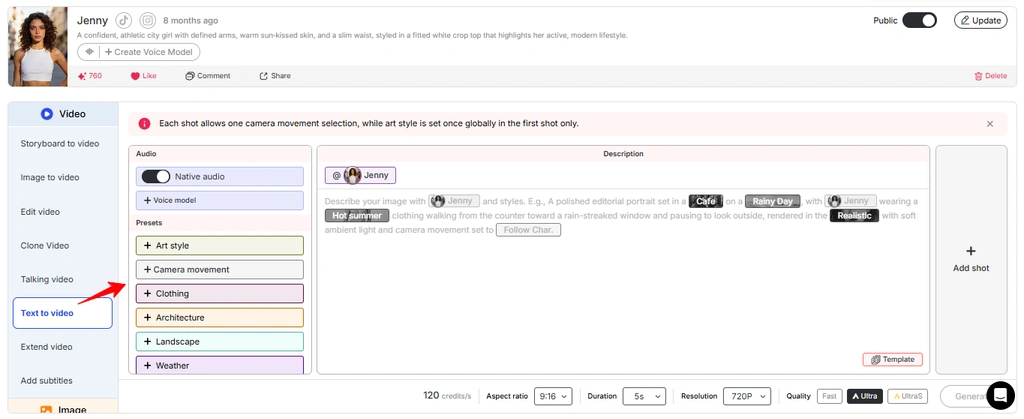
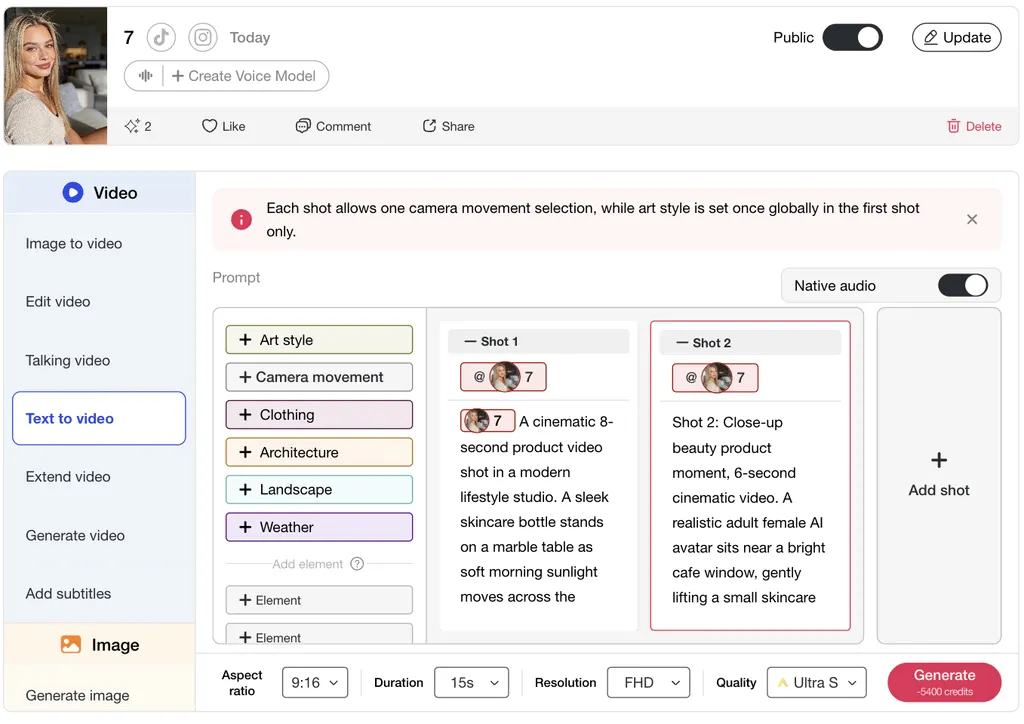
Mer specifikt på Seedance 2.5-arbetsytan körde den version jag testade 5 sekunders 720P-utmatning med kvalitetsnivåerna Fast, Ultra och UltraS, en inbyggd ljudväxling och en stapel referenselement som du kan koppla för att förankra en karaktär. Det är den miljön som allt nedan bedöms mot, och det är lagret där Face-Lock lever eller dör.

Vad Face-Lock egentligen betyder i Seedance 2.5
APOB AI marknadsför "Advanced Face-Lock" som ett premiumförsäljningsargument – möjligheten att ha en enhetlig identitet över hundratals inlägg. Ta bort marknadsföringen och Ansiktslås behandlar modellen din karaktärs identitet som ett fast ankare istället för en ny gissning i varje bildruta.
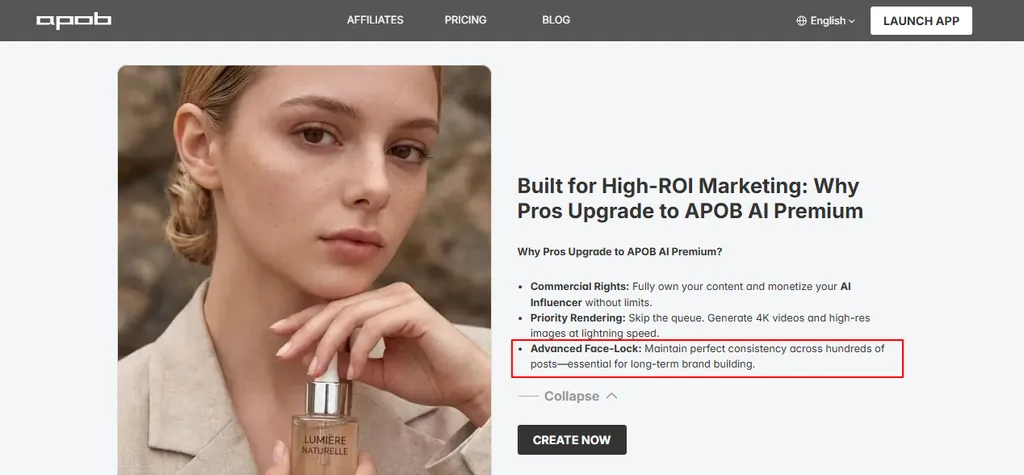
När det fungerar är personen i bildruta ett samma person i bildruta 120: samma käke, samma ögonavstånd, samma hudstruktur, samma fräknar, samma allting.
Rörelse är det som gör detta verkligen svårt, och det är värt att förstå varför innan du skyller på verktyget. AI Videomodeller har inget inbyggt minne av ett ansikte – de bygger om det från referensen och prompten i varje bildruta.
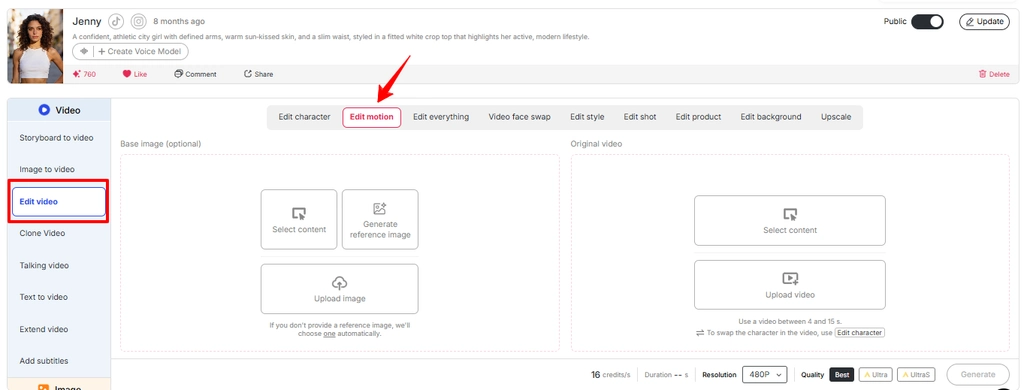
En huvudvändning tvingar modellen att uppfinna vinklar den aldrig såg i din källbild. En kamerabåge rekonstruerar ansiktet från nya positioner. Dialog målar om munnen, hakan och kinderna kontinuerligt. Var och en av dessa är en chans för identiteten att glida, och glidningen dyker vanligtvis upp i de bilder där modellen hade minst information att arbeta utifrån.
Ett fälttrick som räddade mig från en massa bortkastade poänger: se de små detaljerna som ditt tidiga varningssystem. Om en logotyp på tröjan mjuknar eller vänder mitt i klippet, vinglar ansiktet nästan alltid också. Fräknar, fräknar, tatueringar och asymmetriska drag är kanariefåglarna – stabil logotyp, stabilt ansikte, och de tenderar att brytas ihop. Om de håller sig över klippet, håller identiteten vanligtvis med dem.
Mitt Seedance 2.5-test: Håller träffytan sig genom rörelse?
Jag ville inte ha ett talande huvud i en stol. Det är den softbollen som varje demo använder. Jag ville ha rörelse som faktiskt skulle sätta press på identiteten.
Upplägget, direkt från text-till-video-panelen: en vertikal neonstadsscen i 9:16-läge, ett motiv som går på våt asfalt med reflektioner, och en långsam filmisk inmatning. Inställningarna var 720P, UltraS-kvalitet, 5 sekunder. Det slutfördes på ungefär två minuter till den visade kostnaden på 1 000 krediter, eller 200 krediter per sekund. Jag körde variationer av samma brief några gånger för att se till att det första resultatet inte var en lyckosam rullning.
Det som höll måttet överraskade mig verkligen. Under hela gångcykeln och intryckningen förblev motivet visuellt stabilt – det smälte inte samman med en främling, silhuetten behöll sin form och identiteten lästes som en enda sammanhängande person från början till slut.
Reflektionerna från den våta marken och neonljuset följdes också övertygande, vilket vanligtvis signalerar att modellen förstår scenen tillräckligt väl för att hålla motivet jordat snarare än att sväva i en soppa av pixlar. För ett rörligt motiv med ett varierande avstånd till kameran är det ett legitimt godkännande, inte en deltagandetrofé.
Där det blev skakigt var precis där man skulle förvänta sig. Snabb rotation, ocklusion (något som kort korsar ansiktet) och stora ansiktsuttryckssvängningar är fortfarande farozonerna.
På de bildrutor där modellen var tvungen att hitta på en vinkel den aldrig hade någon referens för, drev mikrofunktionerna lite – en något annorlunda panna, en mjukare käke i ett slag innan den återhämtade sig. Och när jag skickade dialog genom det ursprungliga ljudet, bar munregionen den största belastningen, vilket är där du först märker av glidning om den alls dyker upp.
Ärlig dom: Ansiktslåsning i Seedance 2.5 på APOB AI överlever vanliga rörelser — gång, filmiska kamerarörelser, måttliga vändningar — klart bättre än den äldre AI videoverktyg Jag har använt den. Den är inte skottsäker under aggressiv rotation eller långa, uttrycksfulla dialoger. Den praktiska hållningen är: lita på den för de flesta skott, stickprovskontrollera de riskfyllda och ha ett reparationsverktyg till hands för de sällsynta missarna.
Din referensbild avgör om ansiktslåset överlever
Nästan varje gång Face-Lock misslyckades för mig var det referensbilden som var den verkliga boven i dramat, inte modellen. Ge den en mjuk, sidovinklad, svagt upplyst selfie och du ber den att gissa större delen av ansiktet – och det är just gissningen som börjar. Som det råder enighet bland skapare av karaktärskonsekvens är lösningen ett identitetsankare, inte bättre att bara uppmana.
Referensreglerna som verkligen påverkade mina resultat, ungefär i effektordning:
Det är gränsen mellan ett hobbyklipp och något du faktiskt skulle parkera på ett varumärkeskonto och publicera dagligen.
Prompting Seedance 2.5 så att identiteten stannar kvar
Prompten är den andra halvan av ekvationen. Lösa prompter inbjuder modellen att improvisera, och improvisation är hur ansikten glider. Strikta prompter ger den en räls att springa på.
Strukturen som konsekvent gav mig starkare Face-Lock var denna ordning: motiv → en huvudhandling → miljö → kamerarörelse → ljussättning → stil → ljud → begränsningar.
Det sista blocket – begränsningar – är det som de flesta hoppar över. Att lägga till "ingen text, inga logotyper, ingen dialog" när de inte hör hemma i bilden tar bort de slumpmässiga element som destabiliserar en bildruta. Om du inte behöver att munnen rör sig, bjud inte in till dialog alls; en stilla mun är en stabil mun, punkt.
Håll varje tagning till en tydlig handling. ”Hon går och vänder sig och skrattar och vinkar” är fyra separata chanser att glida in i fem sekunder. ”Hon går mot kameran, lugnt uttryck” är ett rent taktslag som modellen faktiskt kan hålla. Kedja sedan ihop dessa rena taktslag med hjälp av kontrollen Lägg till tagning eller verktyget Utöka video, och behåll identisk karaktärsbeskrivning på var och en.
När det gäller kameraarbete slår mjukhet alltid flashigt – en långsam inskjutning eller en stadig spårningsbild bevarar ett ansikte mycket bättre än en snabb omloppsbana som piskar det genom vinklar som modellen aldrig sett. Om en hjälteomloppsbana inte är förhandlingsbar, generera den och lappa sedan de glidande bildrutorna efteråt istället för att hoppas.
Hur bild-till-video och kontroll av sista bildrutan hjälper till med ansiktslåsning
En funktion som är värd att nämna i sin helhet: Bild till video med kontroll över första och sista bildrutan. Seedance 2.5 behandlar den sista bildrutan mindre som en lös ledtråd och mer som en destination den måste nå. För identitetsarbete är det en tyst superkraft.
Arbetsflödet jag gillade: generera en stark hjältebild först – karaktär, outfit, bakgrund, stämning allt inställt – och för sedan in den bilden i Image to Video som din öppningsbild.
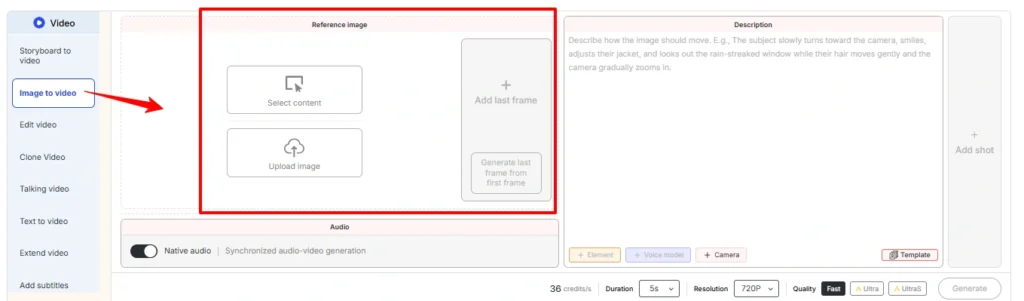
Om du har en ren slutposition, ställ in den som sista bildrutan också. Eftersom modellen nu interpolerar mellan två fasta, identitetskorrekta bilder snarare än att uppfinna ett slut från grunden, finns det mycket mindre utrymme för ansiktet att vandra i mitten.
Hålla Face-Lock över skott och förlängningar
Ett klipp är enkelt läge. Det verkliga testet är en sekvens – samma karaktär över fem tagningar, eller ett kort klipp utsträckt till något längre, som ändå läses som en person hela vägen igenom.
Det är här arbetsflödesdisciplinen förtjänar sin plats. Extend Video för ett referensklipp vidare och syftar, enligt ByteDances egna modellanteckningar, till att bibehålla huvudkaraktär, miljö och tempokonsekvens genom varje extension-runda.
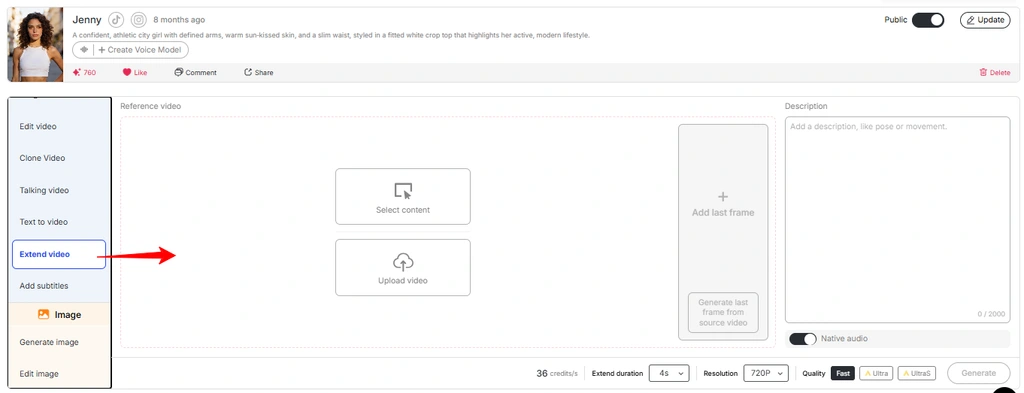
I praktiken, ju mer beskrivningen glider mellan omgångarna, desto snabbare urholkar identiteten. Behandla ditt karaktärsblad som en låst produktionstillgång: samma ord, samma referens, varje gång.
För flertagningsbyggen, strukturera tagningslistan kring kontinuitet, inte variation – återanvänd ämnesbeskrivningen ordagrant, behåll garderobsreferenserna bifogade och ändra endast handlingen och miljön mellan tagningarna.
När ett ansikte trots allt detta ändå glider, låter Video Face Swap och Edit Video ( ReVideo ) dig reparera specifika segment istället för att återskapa hela grejen och slå om identitetstärningarna. I den version jag testade accepterade Edit Video uppladdningar på 3–30 sekunder i 720P, så du kan kirurgiskt fixa en två sekunders vinkling utan att röra vid det bra filmmaterialet runtomkring.
Hur Seedance 2.5 Face-Lock jämförs med andra AI Videomodeller
Sammanhanget hjälper här, eftersom "bra" bara betyder något mot fältet. I de breda jämförelserna från 2026 ser bilden ut ungefär så här:
Veo-klassmodeller tenderar att leda på närbildsfotorealism och läppsynkroniserat ljud, Kling-klassmodeller är starka på filmisk färg och dialog med flera karaktärer men lutar sig ofta mot att sy ihop flera korta klipp, och Seedance 2.5 efterfrågas upprepade gånger för strikt karaktärskonsekvens och rumslig koherens över en enda kontinuerlig generation.
Specifikt för Face-Lock spelar egenskapen "enda kontinuerlig generation" roll. När en modell håller en karaktär genom en obruten tagning istället för att be dig att sy och be, finns det helt enkelt färre sömmar där identiteten kan brytas.
Det är den praktiska anledningen till att Seedance 2.5 finns i APOB. AI känns pålitlig för upprepade karaktärsarbete – modellen är byggd för att hålla ett motiv stabilt genom rörelse, och APOB AI:s referensstaplings- och reparationsverktyg ligger precis ovanpå den styrkan.
Där Seedance 2.5 i APOB AI Kämpar fortfarande
Ingen försköning – några svaga punkter kvarstod under mina löprundor, och att känna till dem sparar pengar.
Scener med flera motiv är svårare. När flera karaktärer delar en bildruta delar modellen sin uppmärksamhet och de sekundära ansiktena driver före din hjälte. Aggressiva fysiska rörelser – volter, snabba snurrningar, snabb koreografi – pressar fortfarande den fysiska trovärdigheten till sina gränser, och ansikten kan betala skatten på dessa bildrutor.
Lång dialog med stora uttryckssvängningar är fortfarande det enskilt mest pålitliga sättet att ytbehandla glidning, eftersom munregionen kontinuerligt byggs om och de omgivande dragen följer med på resan.
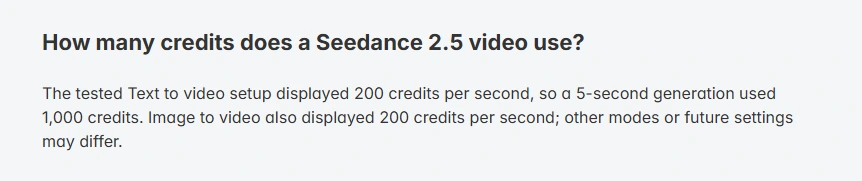
T kostar det praktiska. Generation bränner eftertexter (200 per sekund på den där text-till-video-körningen), de grundläggande Seedance 2.5-lägena jag testade var begränsade till 5 sekunder och 720P, och varje klipp får en granskning innan det publiceras. Gränssnitt, begränsningar och prissättning ändras med produktuppdateringar, så behandla de exakta siffrorna här som en daterad ögonblicksbild snarare än ett permanent specifikationsblad.
Ansiktslåsning efter rörelsetyp: Snabbreferens
| Rörelsetyp | Tillförlitlighet med ansiktslås | Spela smart |
|---|---|---|
| Gående / långsam rörelse på motivet | Starkt | Lita på det, snabb stickprovskontroll |
| Långsamt inskjutet / spårningsskott | Starkt | Perfekt för hjältebilder |
| Måttlig huvudvridning | bra | Använd en skarp frontal referens |
| Första och sista ram I2V | Starkt | Lådan glider in i båda ändar |
| Snabb kameraomloppsbana | Blandad | Generera, sedan lappa med Face Swap |
| Tung dialog + uttryck | svagare | Håll segmenten korta, granska noggrant |
| Gruppbilder med flera karaktärer | svagare | Förankra en hjälte, referera till resten |
Felsökning av Face-Lock: Snabba lösningar som fungerade
När ett klipp kom tillbaka med ett drivande ansikte, var det dessa rörelser som faktiskt vände det, i den ordning jag skulle prova dem:
- Byt referens innan du trycker på prompten. Nio gånger av tio fixar en skarpare, mer frontal referens det snabbare än någon snabb justering.
- Halvera handlingen. Om subjektet gjorde två saker, ta bort en. Ett rent slag per fem sekunder är den optimala punkten.
- Döda onödig dialog. Om munnen inte behöver röra sig för att bilden ska fungera, ta bort ljudbriefen och se hur ansiktet står stadigt.
- Sakta ner kameran. Byt ut omloppsbanan mot en push-in så försvinner det mesta av mikrodriften.
- Reparera, regenerera inte. För en liten lokal vinkling är det bättre att byta videoansikte eller redigera video på bara de sekunderna än att spela om hela klippet och riskera ett sämre resultat.
Är Seedance 2.5 i APOB AI Rätt för dig?
Om du bygger en AI influencer, en återkommande virtuell talesperson, en kort serie med en konsekvent karaktär, eller produktklipp där ett ansikte måste hålla sig till varumärket över dussintals inlägg, den här kombinationen sitter perfekt i fickan.
Referensstaplingen, kontrollen för första och sista bildrutan, flödet för utökat videoflöde och reparationsverktygen för redigering på plats är byggda för just den där upprepningsbara teckenslipningen – vilket är hela anledningen till att Face-Lock är viktigt från första början.
Om ditt arbete är enstaka, rörelsetunga actionklipp där ingen klockar ett ansikte mot ett annat, spelar Face-Lock mycket mindre roll och du kan uppmana lösare och röra dig snabbare. Hela utdelningen här är identitetskontinuitet, så det belönar kreatörer som behöver samma person, om och om igen, hålla samman över ett flöde.
Vanliga frågor
Överlever Face-Lock i Seedance 2.5 fast motion?
Den klarar vanliga rörelser – gång, spårningsskott, måttliga svängar – bra. Snabb rotation, ocklusion och kraftiga ansiktsuttrycksförändringar är fortfarande där identiteten kan glida, så granska dessa klipp noggrant och ha ett reparationsverktyg redo.
Vilken upplösning och längd har Seedance 2.5 i APOB AI Stöd?
I den version jag testade körde de centrala lägena Text till video och Bild till video 5-sekundersklipp i 720P med nivåerna Fast, Ultra och UltraS. Redigera video hanterade uppladdningar på 3–30 sekunder. Inställningarna kan ändras allt eftersom plattformen uppdateras.
Hur många krediter kostar ett Seedance 2.5-klipp på APOB AI?
De testade text-till-video- och bild-till-video-inställningarna visade 200 kreditpoäng per sekund, så ett 5-sekundersklipp körde 1 000 kreditpoäng. Redigerings- och utökningslägena visade högre hastigheter per sekund i samma kontroll.
Vad gör en referensbild bra för Face-Lock?
En skarp, högupplöst, frontal, jämnt belyst yta med ett neutralt uttryck. Mjuka, sidovinklade eller svaga referenser tvingar modellen att gissa, och det är gissningen som avviker. Flera konsekventa vinklar hjälper ännu mer.
Kan jag behålla samma karaktär i flera skott och tillägg?
Ja. Återanvänd exakt samma karaktärsbeskrivning i varje tagning, behåll referenselementen och använd Extend Video för att föra identiteten vidare. Ju mer formuleringarna ändras mellan omgångarna, desto snabbare försämras identiteten.
Påverkar inbyggt ljud ansiktsstabilitet?
Det kan det. Dialogen målar om munregionen i varje bildruta, så långa talsegment är det vanligaste stället att upptäcka glidningar. Om en tagning inte behöver tal, lämna den åt sidan för ett renare slut.
Hur står sig Seedance 2.5 jämfört med Veo eller Kling vad gäller konsekvens?
Breda jämförelser från 2026 ger Veo-klassmodeller ett försprång på närbildsrealism och Kling-klassmodeller ett försprång på filmisk inspelning med flera karaktärer, medan Seedance 2.5 upprepade gånger hyllas för strikt karaktärskonsekvens i en enda kontinuerlig generation – vilket är precis vad Face-Lock drar nytta av.
Slutgiltig tolkning av Seedance 2.5 i APOB AI
Ansiktslåsning i Seedance 2.5 på APOB AI är inte magi, men det är genuint bra där det räknas. Under rörelsen filmar de flesta skapare faktiskt – gående motiv, filmiska kamerarörelser, måttliga vändningar – höll identiteten sig i mina tester, och det där neonstadsklippet stödde det: stabilt motiv, sammanhängande belysning, ingen främling byter halvvägs.
Tryck in i snabba banor, ocklusion och långa uttrycksfulla dialoger så kommer du fortfarande att upptäcka enstaka vinglar, så granskning är fortfarande en del av jobbet.
Det vinnande draget är gammaldags disciplin: en skarp frontalreferens, en låst karaktärsbeskrivning återanvänd ord för ord, en ren action per tagning, varsamt kameraarbete, kontroll över första och sista bildrutan när du kan använda den, och ansiktsbyte eller redigering av video redo att laga den sällsynta missen.
Gör det, så får du grejen AI videon fortsatte att vara lovande i åratal — samma ansikte, som rör sig genom verklig rörelse, fortfarande igenkännbart ditt karaktär från första till sista bildrutan.
AiMojo rekommenderar:


 BONUS: Få våra 200 dollarAI ”Mastery Toolkit” GRATIS när du registrerar dig!


