

Forskning om kreatörer äter i tysthet upp hela eftermiddagar. Scrollar på TikTok, YouTube och Instagram, kopierar visningsantal till ett ark och tappar sedan bort det enda inlägget som faktiskt betydde något.
En veckovis inkorg för kreatörsforskning förstör den rutinen.
Apify skådespelare skrapa offentliga skaparinlägg, och en n8n automatiseringsarbetsflöde poängsätter varje inlägg, flaggar avvikande värden och frågar en AI modell för att upptäcka krokmönster.
Sedan landar en ren sammanfattning i Gmail samma dag varje vecka, redo före din första kaffe.
Nedan följer den fullständiga versionen, nod för nod, från aktörsinmatningar och logik för engagemangspoängsättning till AI innehållssammanfattningar och felmeddelanden. Ingen teori, bara ett system du kan kopiera.
AIMOJO's Snabb dom
Vad som hamnar i din inkorg varje vecka
Innan du rör vid en nod, lås utdata. En forskningsinkorg fungerar bara när varje e-postmeddelande besvarar samma frågor i samma ordning.
| Digest-avsnitt | Vad den visar | Källnod |
|---|---|---|
| Toppavvikare | Inlägg med högst antal visningar jämfört med skaparen's vanlig median | Poängkodsnod |
| Engagemangsledare | Inlägg med flest gilla-markeringar, kommentarer och delningar per visning | Poängkodsnod |
| Mönsternoteringar | Återkommande krokar, format och ämnen i vinnande inlägg | Grundläggande LLM-kedja |
| Innehållsidéer | Tre idéer som ditt team kan testa den här veckan | Grundläggande LLM-kedja |
| Rå logglänk | Google Sheet med varje skrapat inlägg för senare filtrering | Google Sheets-noden |
Byråer använder detta för att informera kunder, varumärkesteam använder det för scouting av influencer-partnerskap och solo-kreatörer använder det för att spåra konkurrenter utan att öppna en enda app.
Dataflödet förblir enkelt:
Välja Apify-aktörer för skapardata
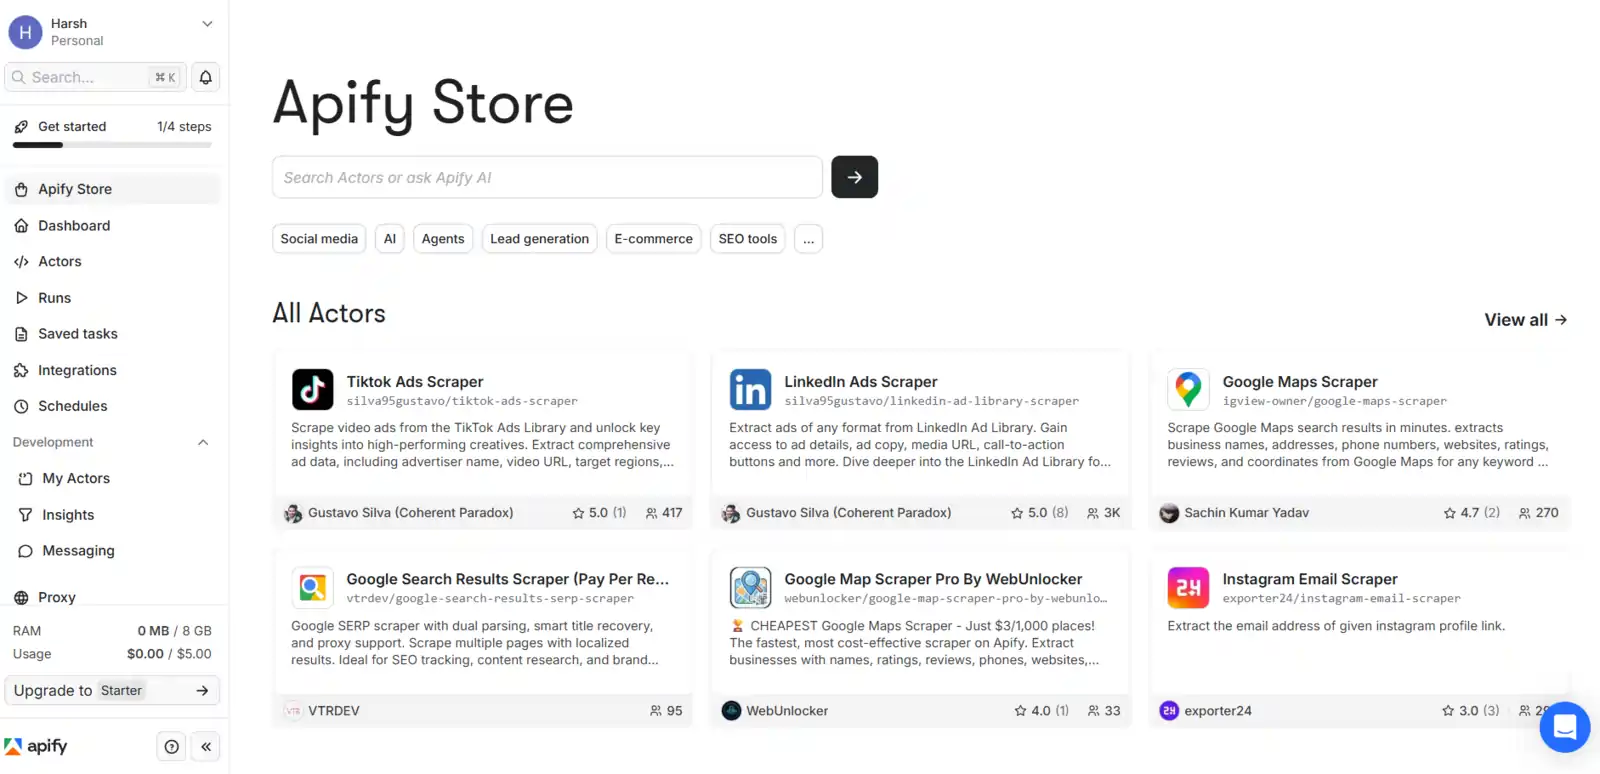
Apify Store har färdiga scrapers som kallas Actors. Tre av dem täcker de flesta behoven för kreatörers research , och var och en har datumfilter som håller en veckovis pull-slank.
| Skådespelare | Viktiga inmatningsfält | Utdatafält värda att behålla |
|---|---|---|
| YouTube-skrapastreamers/youtube-skrapa | startUrls, maxResults, maxResultsShorts, maxResultStreams, sorteraVideorEfter, äldstaInläggsdatum | titel, url, datum, visningsantal, gilla-markeringar, kommentarsantal, kanalnamn, antal prenumeranter |
| TikTok-skrapaClockworks/Tiktok-skrapa | profiler, resultatPerSida, profilSortering, exkluderaFästaInlägg, äldstaInläggsdatumEnhetlig | text, webVideoUrl, createTimeISO, playCount, diggCount, commentCount, shareCount, collectCount, authorMeta.fans |
| Instagram Skrapaapify/instagram-skrapa | direktaURL:er, resultatTyp, resultatGräns, endastInläggNyareÄn | bildtext, url, kortkod, tidsstämpel, antal gilla-markeringar, antal kommentarer, antal videovisningar, ägareAnvändarnamn |
Några detaljer är viktiga här. YouTube-skrapa's Datumintervallet gäller endast för kanal-URL:er, och om du ställer in en typgräns på 0 hoppas det formatet över helt.
TikTok Scrapers profileSorting accepterar senaste, populära eller äldsta. Dess datumfilter är markerade som debiterade filter på sidan Aktörer, så kontrollera det innan du aktiverar dem.
Behöver du följarantal och biografier för Instagram? Lägg till Instagram Profile Scraper (apify/instagram-profile-scraper) med en array med användarnamn. Den returnerar followersCount, biografi, verifierad och senaste inlägg.
Transkriptioner är valfria tillbehör. YouTube Scraper's transcriptionAndSubtitle och TikTok-skrapa's downloadSubtitlesOptions drar talade krokar, vilket gör AI mönsternoterna är mycket skarpare.
Inuti den officiella Apify-noden för n8n
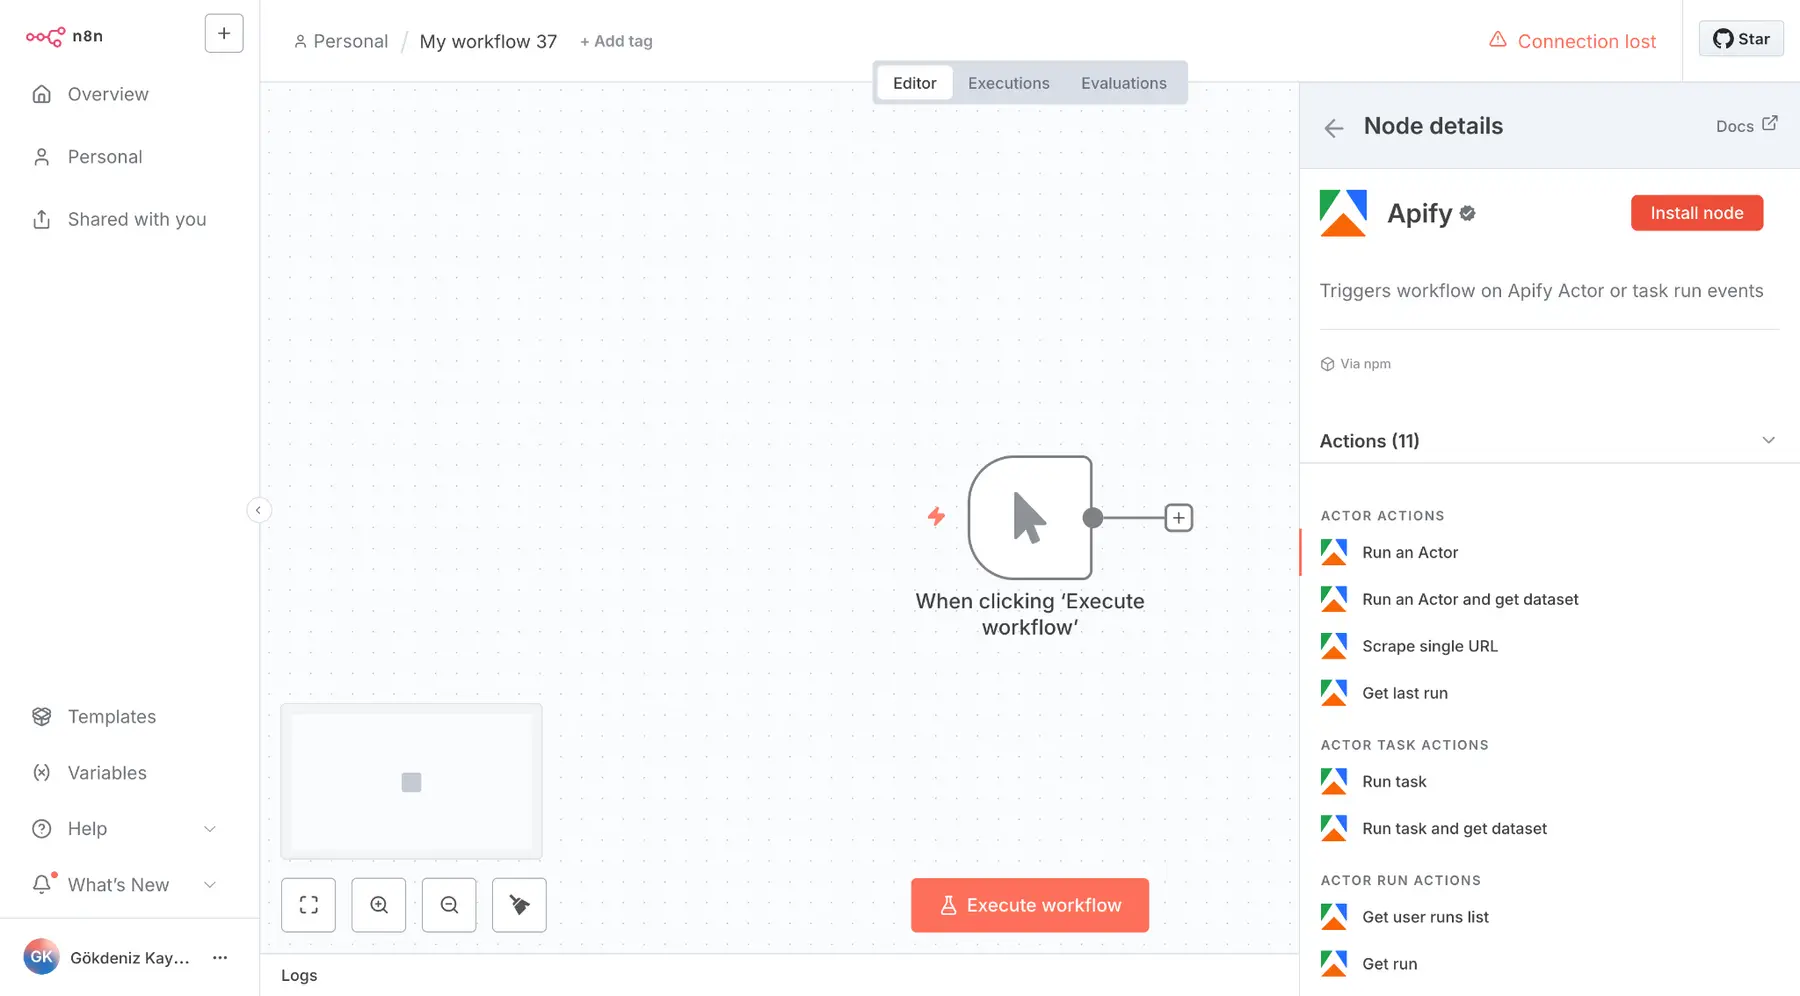
Apify levererar en verifierad communitynod, @apify/n8n-nodes-apify. På n8n Cloud, sök efter "Apify" i nodpanelen och installera den, förutsatt att verifierade communitynoder är tillåtna i administratörspanelen.
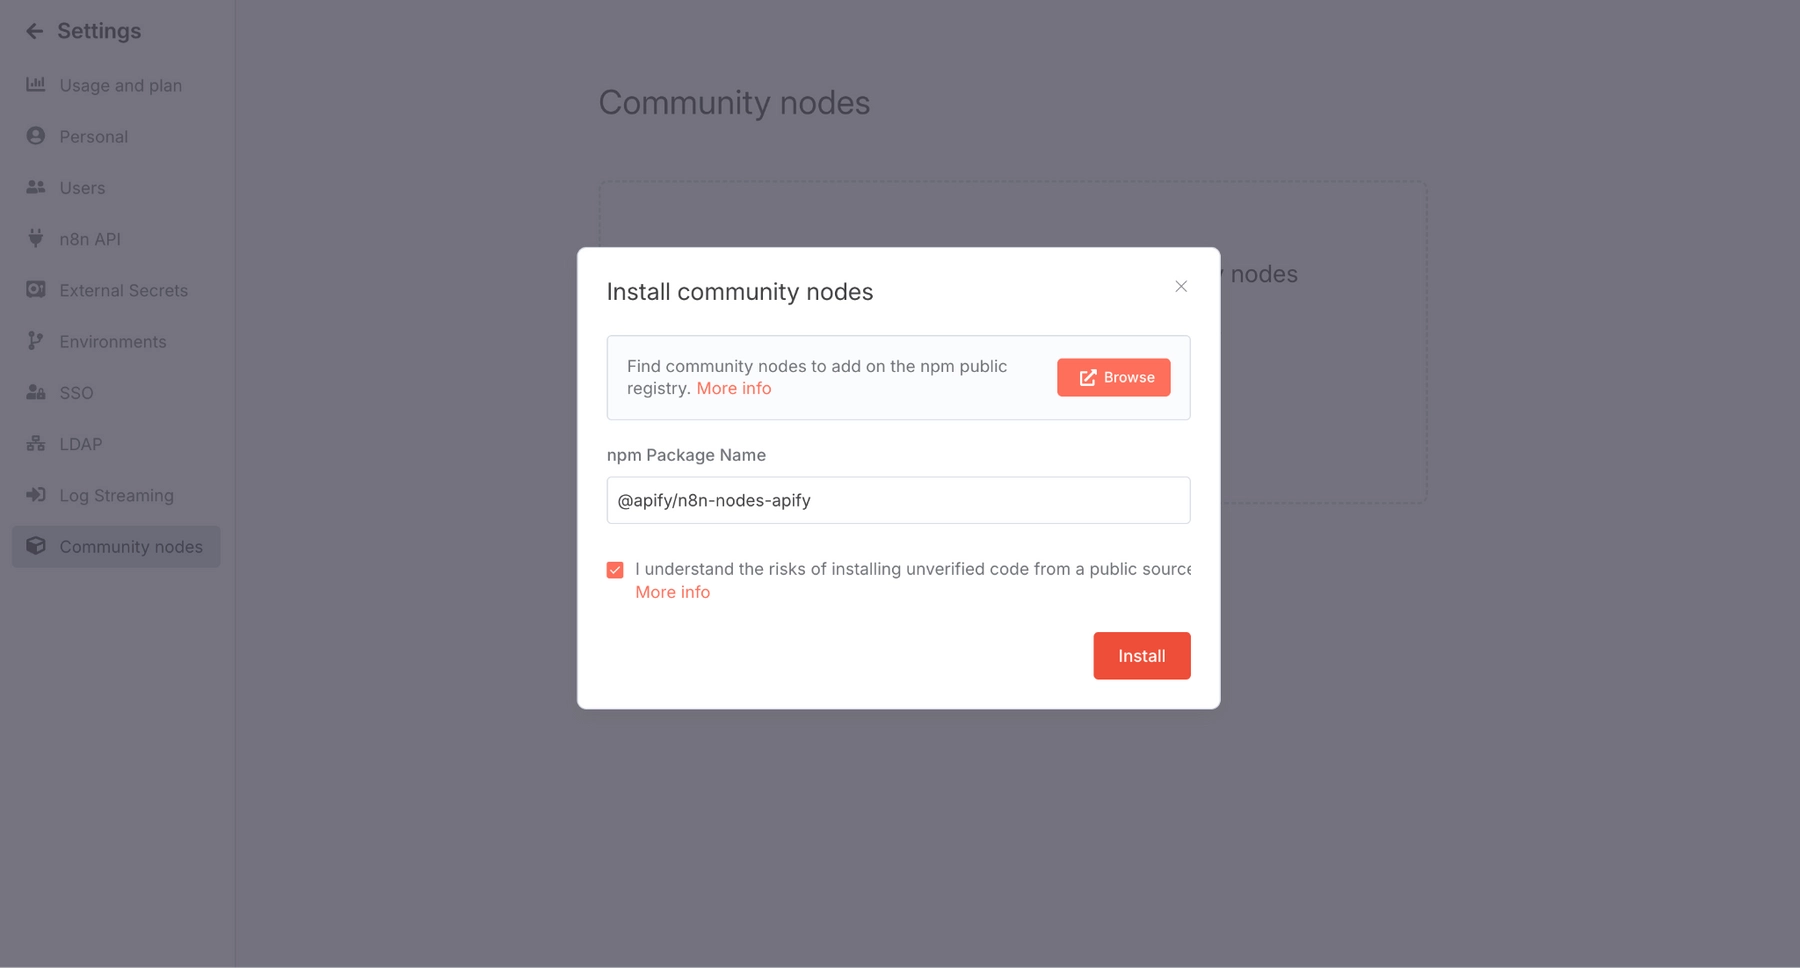
På den självhostade n8n, öppna Inställningar > Community Nodes , klistra in paketnamnet och installera. Noden behöver n8n 1.57.0 eller senare.
| Resurs | Tillgängliga funktioner | Använd i den här versionen |
|---|---|---|
| Skådespelare | Kör en aktör, kör en aktör och hämta dess dataset, Web Fetch, hämta senaste körning | Huvudskrapningssteg |
| Skådespelarens uppgifter | Kör en uppgift, kör en uppgift och hämta dess dataset | Rengöringsinmatningar sparade i Apify |
| Avrättningar av skådespelare | Hämta en, hämta många, avbryt | Felsökning och rensning |
| lagring | Hämta datasetobjekt, hämta nyckel-värde-lagringspost | Hämta resultat som standardDatasetId |
| Trigger | Vid ny Apify-händelse (Lyckades, Misslyckades, Avbröts, Timeout, Valfri) | Delad version av inkorgen för stora laguppställningar |
Autentisering fungerar på två sätt. Apify API- inloggningsuppgifter hämtar din API-token från Apify Console, medan Apify OAuth2 API ansluter med ett enda klick endast i n8n Cloud.
Aktörsåtgärden exponerar även anpassad inmatning (JSON), timeout i sekunder, minne i megabyte, Build-tagg och vänta tills det är klart.
Lämna anpassad inmatning tom så använder aktören sin sparade standardinmatning.
Steg-för-steg-guide till det veckovisa arbetsflödet för skaparforskning
Steg 1: Konfigurera kreatörslistan i Google Sheets
Skapa ett ark med namnet Skaparlista med dessa kolumner. Lagkamrater kan lägga till eller pausa skapare direkt från Ark utan att någonsin öppna n8n.
Lägg till en andra flik som heter Inläggslogg . Varje poängsatt inlägg skrivs där, vilket ger dig historik för bättre baslinjer över tid.
Steg 2: Spara varje skrapa som en Apify Actor-uppgift
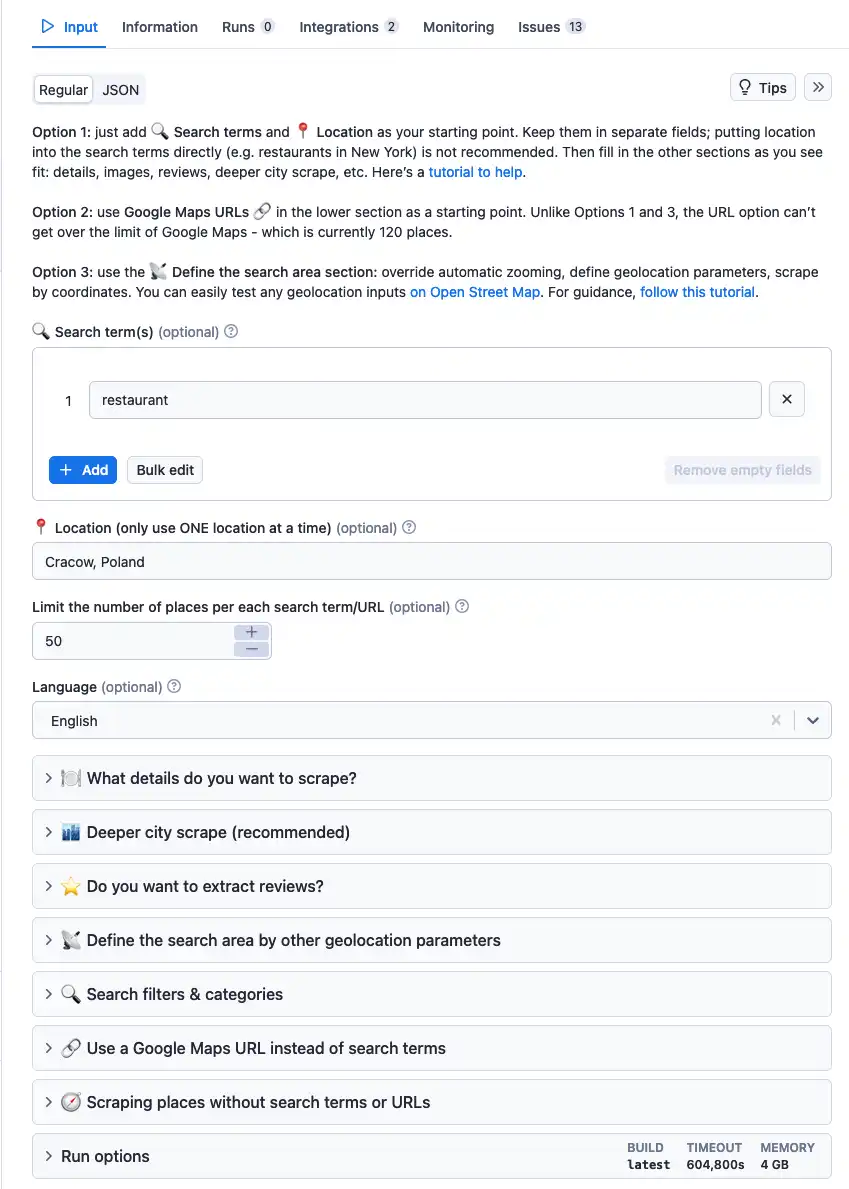
Öppna varje aktör i Apify Console, ange rimliga gränser och klicka på Spara som ny uppgift.
Apify Actor-uppgifter lagrar indata plus timeout och minne, så att n8n-sidan förblir snygg.
Håll alla nedladdningar avstängda. Videofiler , omslag och avatarer ger mer tyngd utan att hjälpa forskningen.
Steg 3: Anslut Apify, Google Sheets och Gmail-uppgifter
Installera Apify-noden och lägg sedan till tre inloggningsuppgifter i n8n: Apify API , Google Sheets OAuth2 och Gmail OAuth2 . Testa var och en innan du bygger vidare.
En trasig autentiseringsuppgift halvvägs genom ett arbetsflöde slösar bort scraping-ansträngning, så den här kontrollen lönar sig.
Steg 4: Konfigurera n8n-schemautlösaren
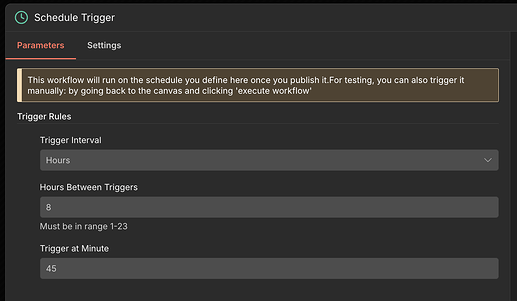
Släpp in en Schedule Trigger-nod med dessa inställningar:
| FYld | Värderar |
|---|---|
| Triggerintervall | veckor |
| Veckor mellan triggers | 1 |
| Utlöses på vardagar | Måndag |
| Utlösare vid timmen | 7am |
| Utlösare vid minut | 0 |
Ange en tidszon under Arbetsflödesinställningar . Utan en sådan återgår n8n till instansens tidszon, och självhostade installationer har som standard Amerika/New_York.
Föredrar du cron? Använd anpassad (Cron) med 0 7 * * 1. Hur som helst utlöses n8n Schedule Trigger endast efter att arbetsflödet har sparats och publicerats.
Steg 5: Bygg plattformsingångar med en kodnod
Lägg till en Google Sheets-nod (Hämta rad(er), fliken Skaparlista), sedan en kodnod. Den kodnoden omvandlar listar till ett indataobjekt per plattform.
const rows = $input.all().map(i => i.json).filter(r => r.active === 'yes');

const since = $now.minus({ days: 7 }).toFormat('yyyy-MM-dd');

const pick = p => rows.filter(r => r.platform === p);

return [{ json: {

  youtube: {

    startUrls: pick('youtube').map(r => ({ url: r.profile_url })),

    maxResults: 15, maxResultsShorts: 15, maxResultStreams: 0,

    sortVideosBy: 'NEWEST', oldestPostDate: since

  },

  tiktok: {

    profiles: pick('tiktok').map(r => r.handle),

    resultsPerPage: 20, profileSorting: 'latest',

    excludePinnedPosts: true, oldestPostDateUnified: since

  },

  instagram: {

    directUrls: pick('instagram').map(r => r.profile_url),

    resultsType: 'posts', resultsLimit: 20, onlyPostsNewerThan: since

  }

}}];
$nu är n8n's inbyggt Luxon-datum, så fönstret på sju dagar rullar fram automatiskt varje vecka. Inga manuella datumredigeringar någonsin.
Steg 6: Kör tre Apify-aktörer parallellt
Förgrena noden Code till tre Apify-noder. Välj resursen Actor Tasks med den operation som kör en uppgift och returnerar dess datasetobjekt.
I Anpassad inmatning, skicka det matchande objektet som ett uttryck:
{{ JSON.stringify($json.youtube) }}Upprepa med $json.tiktok och $json.instagram. Anpassad inmatning åsidosätter den sparade uppgiftsinmatningen, medan timeout och minne fortfarande kommer från uppgiften.
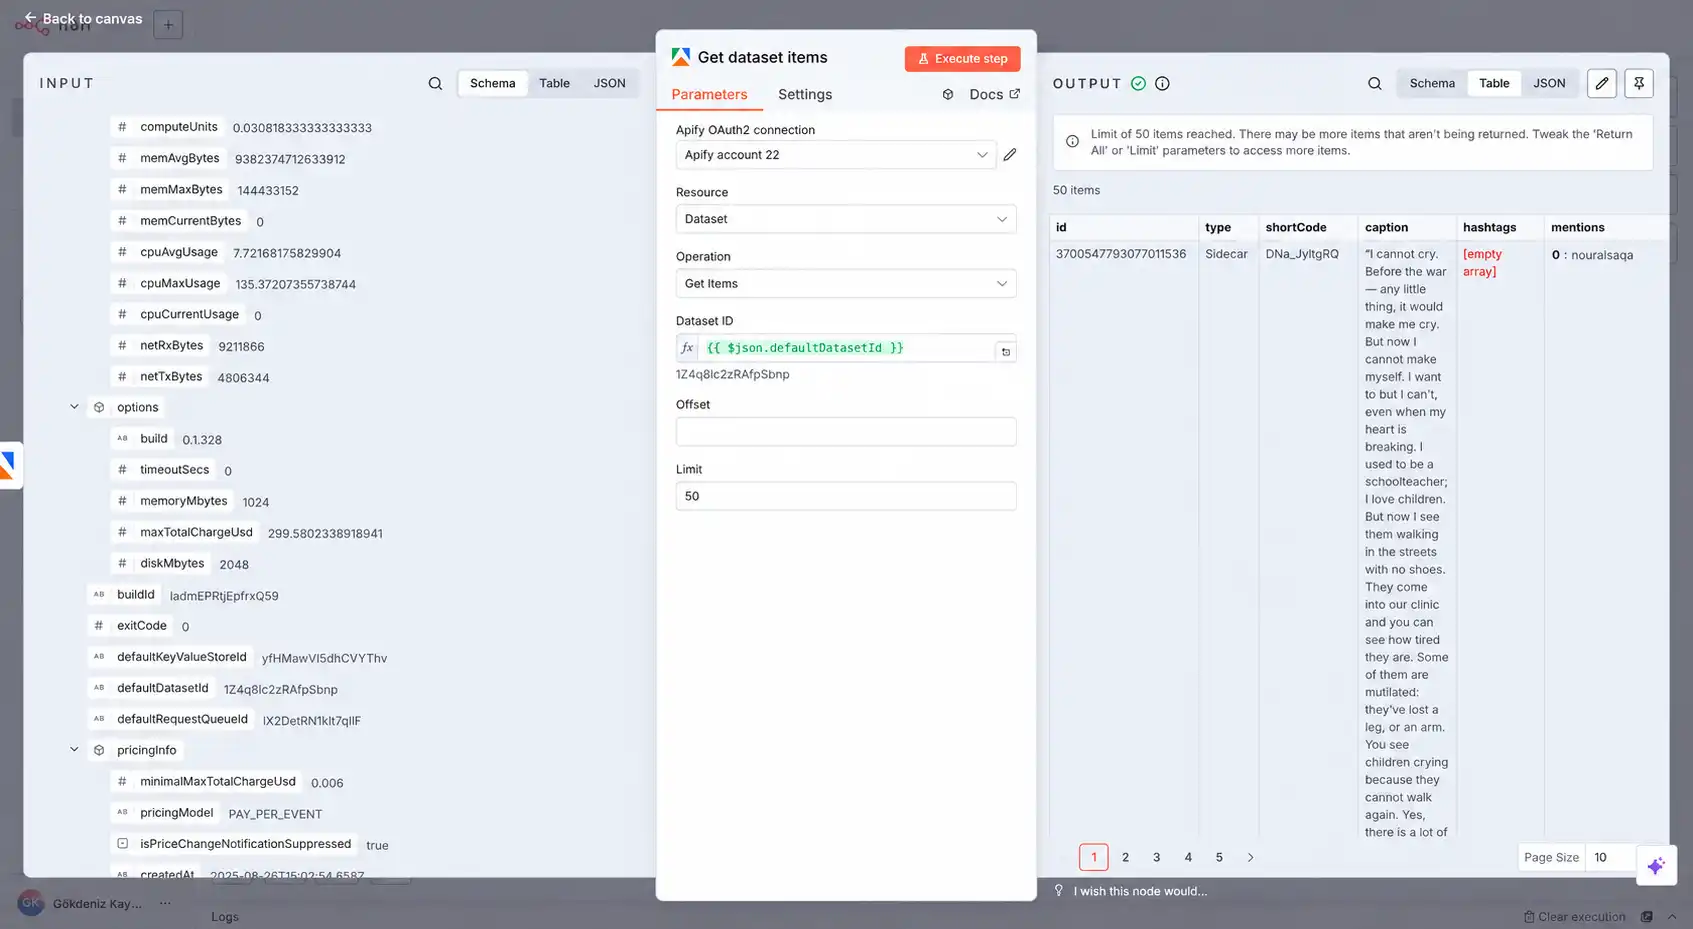
Föredrar du två separata noder? Kör aktören med " Vänta tills det är klart" aktiverat och lägg sedan till "Hämta datasetobjekt med {{ $json.defaultDatasetId }}". Båda sökvägarna returnerar identiska data.
Steg 7: Sammanfoga och normalisera till ett schema
Anslut alla tre Apify-noder till en Merge- nod som är inställd på Append. Varje plattform namnger fält olika, så en Code-nod mappar dem till en delad form.
const out = [];

for (const { json: p } of $input.all()) {

  if (p.error) continue; // skip failed inputs

  if (p.webVideoUrl) {

    out.push({ platform: 'tiktok', post_id: p.id, creator: p.authorMeta?.name,

      url: p.webVideoUrl, caption: p.text, published: p.createTimeISO,

      views: p.playCount, likes: p.diggCount, comments: p.commentCount,

      shares: p.shareCount });

  } else if (p.shortCode) {

    out.push({ platform: 'instagram', post_id: p.shortCode, creator: p.ownerUsername,

      url: p.url, caption: p.caption, published: p.timestamp,

      views: p.videoViewCount ?? null, likes: p.likesCount,

      comments: p.commentsCount, shares: null });

  } else if (p.viewCount !== undefined) {

    out.push({ platform: 'youtube', post_id: p.id, creator: p.channelName,

      url: p.url, caption: p.title, published: p.date,

      views: p.viewCount, likes: p.likes, comments: p.commentsCount,

      shares: null });

  }

}

return out.map(json => ({ json }));
YouTube Scraper skriver felmeddelanden för borttagna videor eller saknade kanaler. p.error-kontrollen tar bort dessa innan de förvränger någon poäng.
Steg 8: Poängsätt varje inlägg med avvikande och engagemangsmatematik
Råa visningar är mer fördelaktiga för stora konton. Ett outlier-poängvärde för kreatörer jämför varje inlägg med kreatörens eget medianvärde, så en liten kanals genombrott sticker ut.
| metrisk | Formel | Vad det säger dig |
|---|---|---|
| Avvikande poäng | inläggsvisningar ÷ medianvisningar för skapare | Hur långt ett inlägg överträffade sin egen baslinje |
| Förlovningsgrad | (gilla-markeringar + kommentarer + delningar) ÷ visningar × 100 | Hur hårt tittarna reagerade |
| Instagram-reserv | inlägg gilla-markeringar ÷ skaparens median gilla-markeringar | Fungerar för bildinlägg utan visningsantal |
const items = $input.all().map(i => i.json);

const base = it => it.views || it.likes || 0;

const groups = {};

for (const it of items) (groups[it.creator] ??= []).push(base(it));

const median = a => { const s = [...a].sort((x, y) => x - y), m = Math.floor(s.length / 2);

  return s.length % 2 ? s[m] : (s[m - 1] + s[m]) / 2; };

return items.map(it => {

  const med = median(groups[it.creator]) || 1;

  const eng = it.views ? ((it.likes || 0) + (it.comments || 0) + (it.shares || 0)) / it.views * 100 : null;

  return { json: { ...it, outlier: +(base(it) / med).toFixed(2),

    engagement: eng === null ? null : +eng.toFixed(2) } };

}).sort((a, b) => b.json.outlier - a.json.outlier);
En veckas inlägg ger en tunn baslinje. Efter några veckor, läs fliken Inläggslogg och beräkna medianvärden från efterföljande historik istället.
Steg 9: Blockera upprepningar med noden Ta bort dubbletter
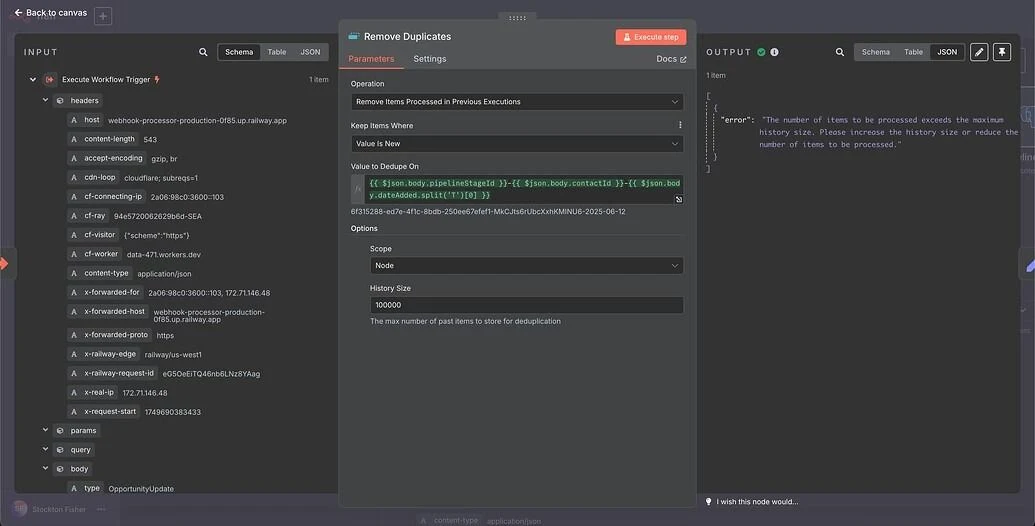
Lägg till en nod för att ta bort dubbletter efter poängsättning. Ställ in åtgärden på att ta bort objekt som bearbetats i tidigare körningar och behålla objekt där värdet är nytt.
Denna ihållande deduplicering hindrar en manuell retrigger från att skicka samma inlägg två gånger via e-post. Rensa dedupliceringshistorik återställer den under testning.
Steg 10: Lägg till AI Mönsteranalyslager
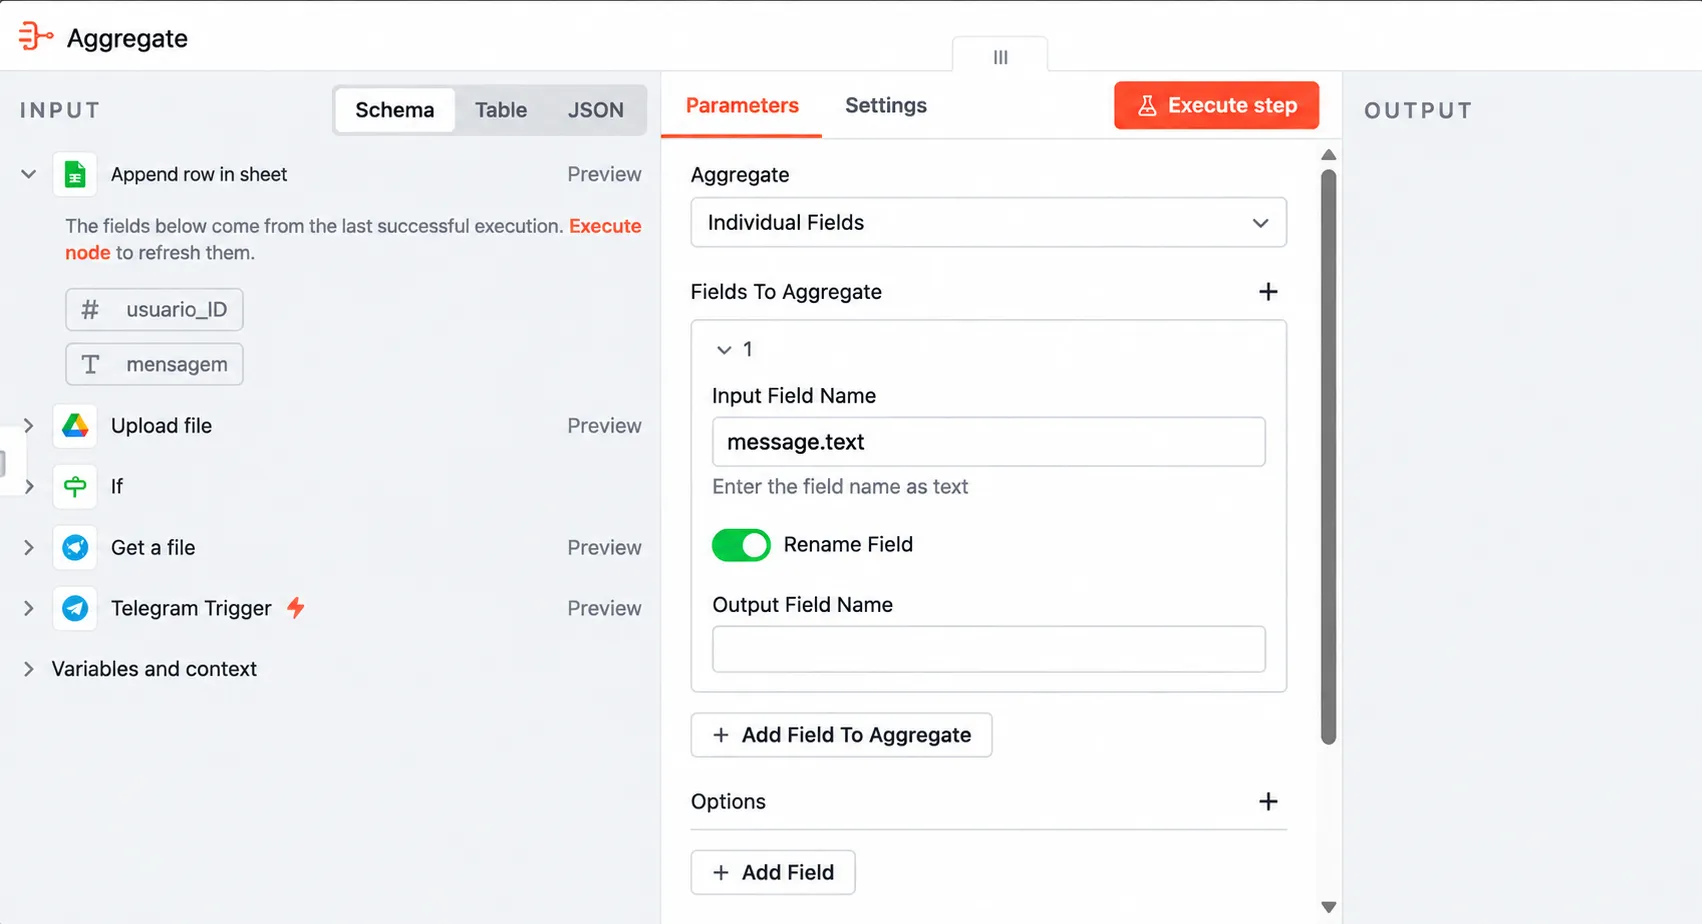
Använd en Limit-nod för att behålla de 15 översta inläggen, sedan en Aggreger-nod inställd på All Item Data. Det ger hela batchen till AI som ett enda föremål.
Lägg sedan till en grundläggande LLM-kedja med valfri chattmodell du redan använder, till exempel OpenAI, Anthropic eller Gemini.
Aktivera Kräv specifikt utdataformat och anslut en strukturerad utdataparser.
Du är en innehållsstrateg för korta formuleringar.
Nedan följer denna vecka's toppskapares inlägg som JSON, rangordnade efter extrempoäng.
Returnera JSON med:
– ”mönster”: 3 återkommande krokar eller format, där varje mönster citerar inläggs-URL:er
– ”ämnen”: ämnen som förekommer i 2+ vinnande inlägg
– ”idéer”: 3 innehållsidéer som vårt team kan filma den här veckan
Använd endast bevis från data. Om ett mönster är svagt, säg det.
{{ JSON.stringify($json.data) }}Enbart textning missar den upplästa hooken, vilket vanligtvis avgör en kort video's öde.
Med transkriptioner aktiverade i YouTube- eller TikTok-uppgiften, överför de inledande raderna av undertexten till det normaliserade objektet.
Begränsa texten till ungefär de första 300 tecknen. Modellen jämför sedan verkliga inledande rader mellan vinnarna, och tokenanvändningen förblir liten.
"Använd endast bevis"-frasen spelar roll. Den håller AI innehåll mönsteranalys förankrad i riktiga inlägg istället för generiskt trendprat.
Steg 11: Sammanställ HTML-sammanfattningen och skicka den via Gmail
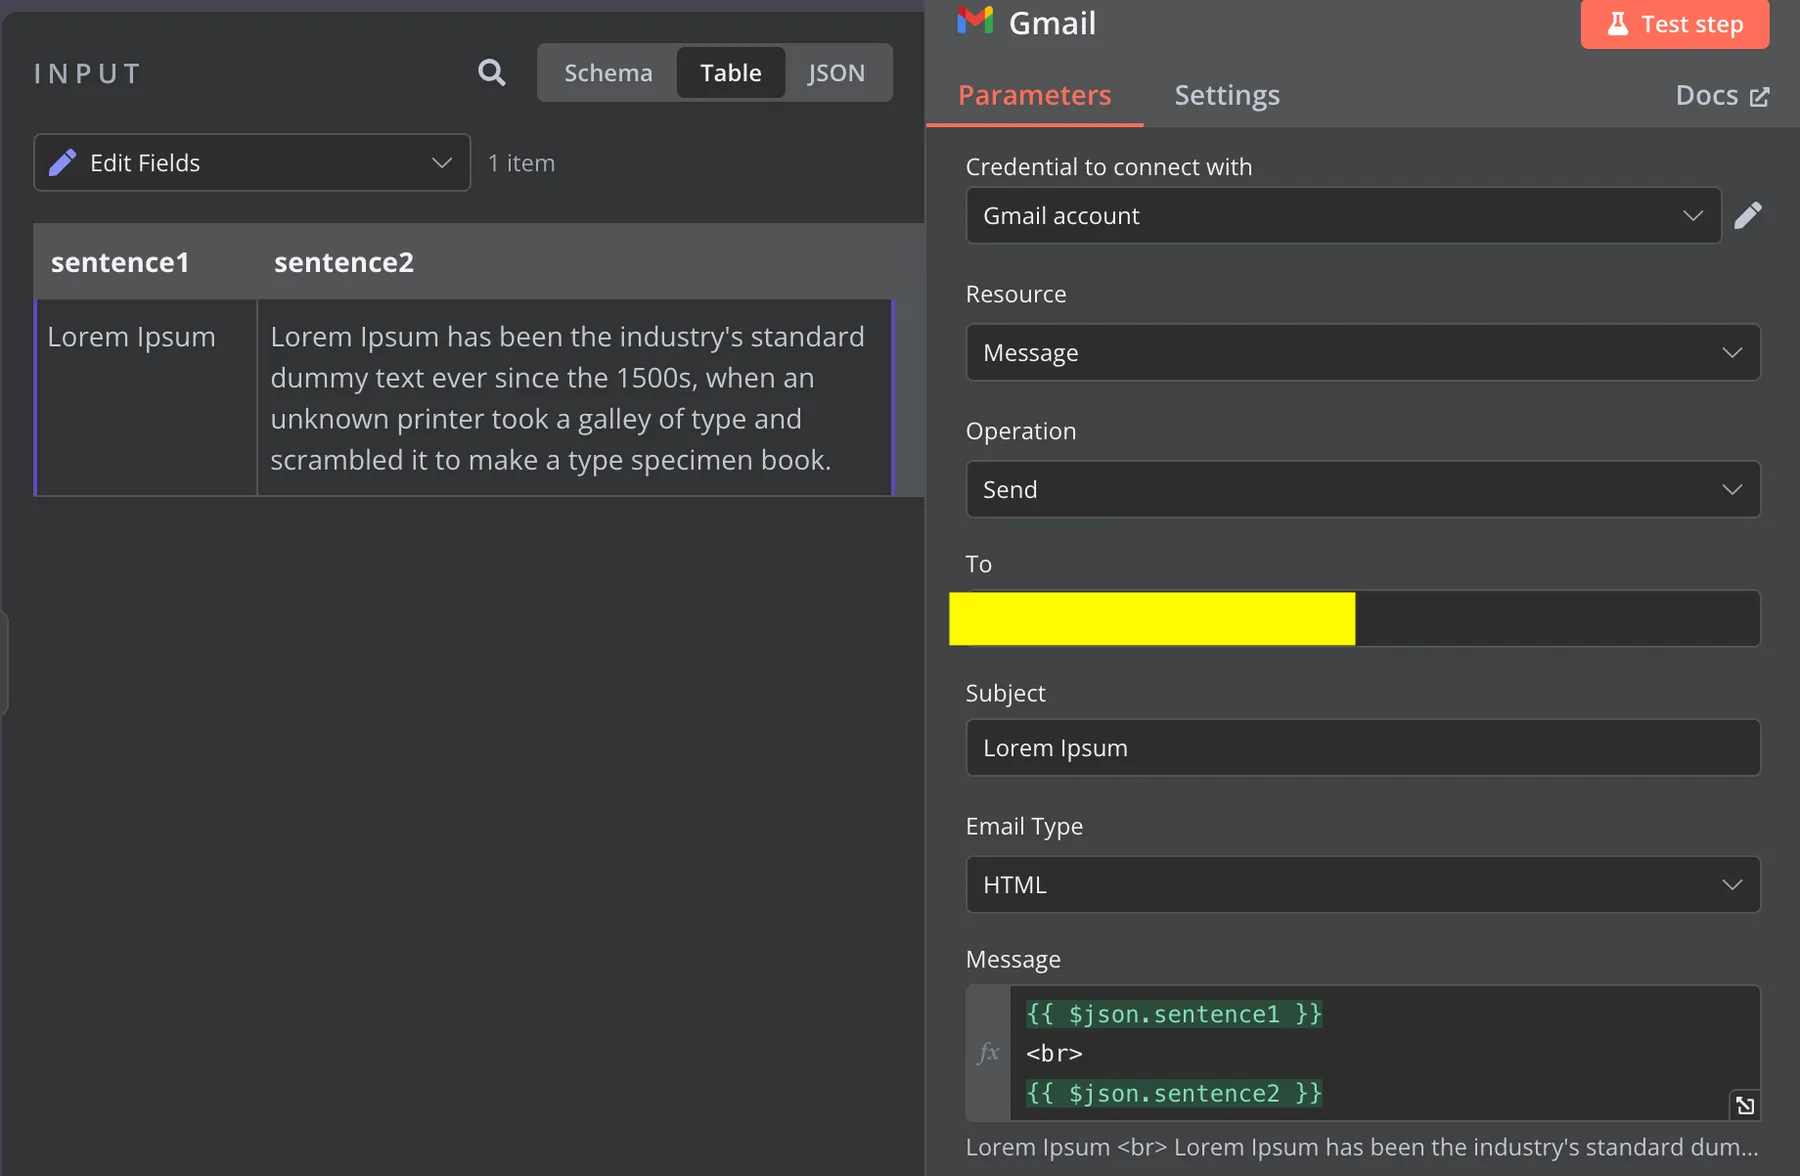
En slutlig kodnod parar ihop poängsatta inlägg med AI utdata och bygger e-postmeddelandets brödtext:
const posts = $('Limit').all().map(i => i.json);

const ai = ('BasicLLMChain').first().json.output;constrows=posts.map(p=>`<tr><td>{p.platform}</td><td>p.creator</td><td><ahref="{p.url}">(p.caption||'').slice(0,70)</a></td><td>{p.outlier}x</td><td>p.engagement??'–'%</td></tr>`).join('');consthtml=`<h2>TopOutliers</h2><tableborder="1"cellpadding="6">{rows}</table>

  <h2>Patterns</h2><ul>${ai.patterns.map(x => `<li>${x}</li>`).join('')}</ul>

  <h2>Ideas</h2><ul>${ai.ideas.map(x => `<li>${x}</li>`).join('')}</ul>`;

return [{ json: { html } }];const items = $input.all().map(i => i.json);

const base = it => it.views || it.likes || 0;

const groups = {};

for (const it of items) (groups[it.creator] ??= []).push(base(it));

const median = a => { const s = [...a].sort((x, y) => x - y), m = Math.floor(s.length / 2);

  return s.length % 2 ? s[m] : (s[m - 1] + s[m]) / 2; };

return items.map(it => {

  const med = median(groups[it.creator]) || 1;

  const eng = it.views ? ((it.likes || 0) + (it.comments || 0) + (it.shares || 0)) / it.views * 100 : null;

  return { json: { ...it, outlier: +(base(it) / med).toFixed(2),

    engagement: eng === null ? null : +eng.toFixed(2) } };

}).sort((a, b) => b.json.outlier - a.json.outlier);
Lägg sedan till en Gmail-nod med dessa inställningar:
Steg 12: Logga inlägg till Google Sheets och publicera
Förgrena dig från noden Ta bort dubbletter till en Google Sheets-nod med hjälp av Lägg till eller Uppdatera rad på fliken Inläggslogg. Matcha på post_id så att uppdaterad statistik skriver över äldre rader.
Ställ in mappningen på Mappa automatiskt , eftersom normaliserade fältnamn redan matchar kolumnerna. Kör en gång manuellt, kontrollera e-postmeddelandet och publicera sedan arbetsflödet.
Skala upp med Apify-scheman och händelseutlösare
Ett enda schemalagt arbetsflöde passar för grupper på några dussin skapare. Utöver det håller långa scraping-jobb n8n-körningar öppna i minuter och en långsam plattform stoppar resten.
Fix-splittringarna fungerar på båda plattformarna:
| Faktor | Enkelt arbetsflöde | Delat arbetsflöde |
|---|---|---|
| Inställningstid | Snabbare | Lite längre |
| Långa skrapningsjobb | Avrättningen väntar hela tiden | Ingen väntan inne n8n |
| En plattform misslyckas | Kan blockera digestionen | Andra landar fortfarande |
| Behov av egenhosting | Inget extra | Offentlig WEBHOOK_URL för utlösaren |
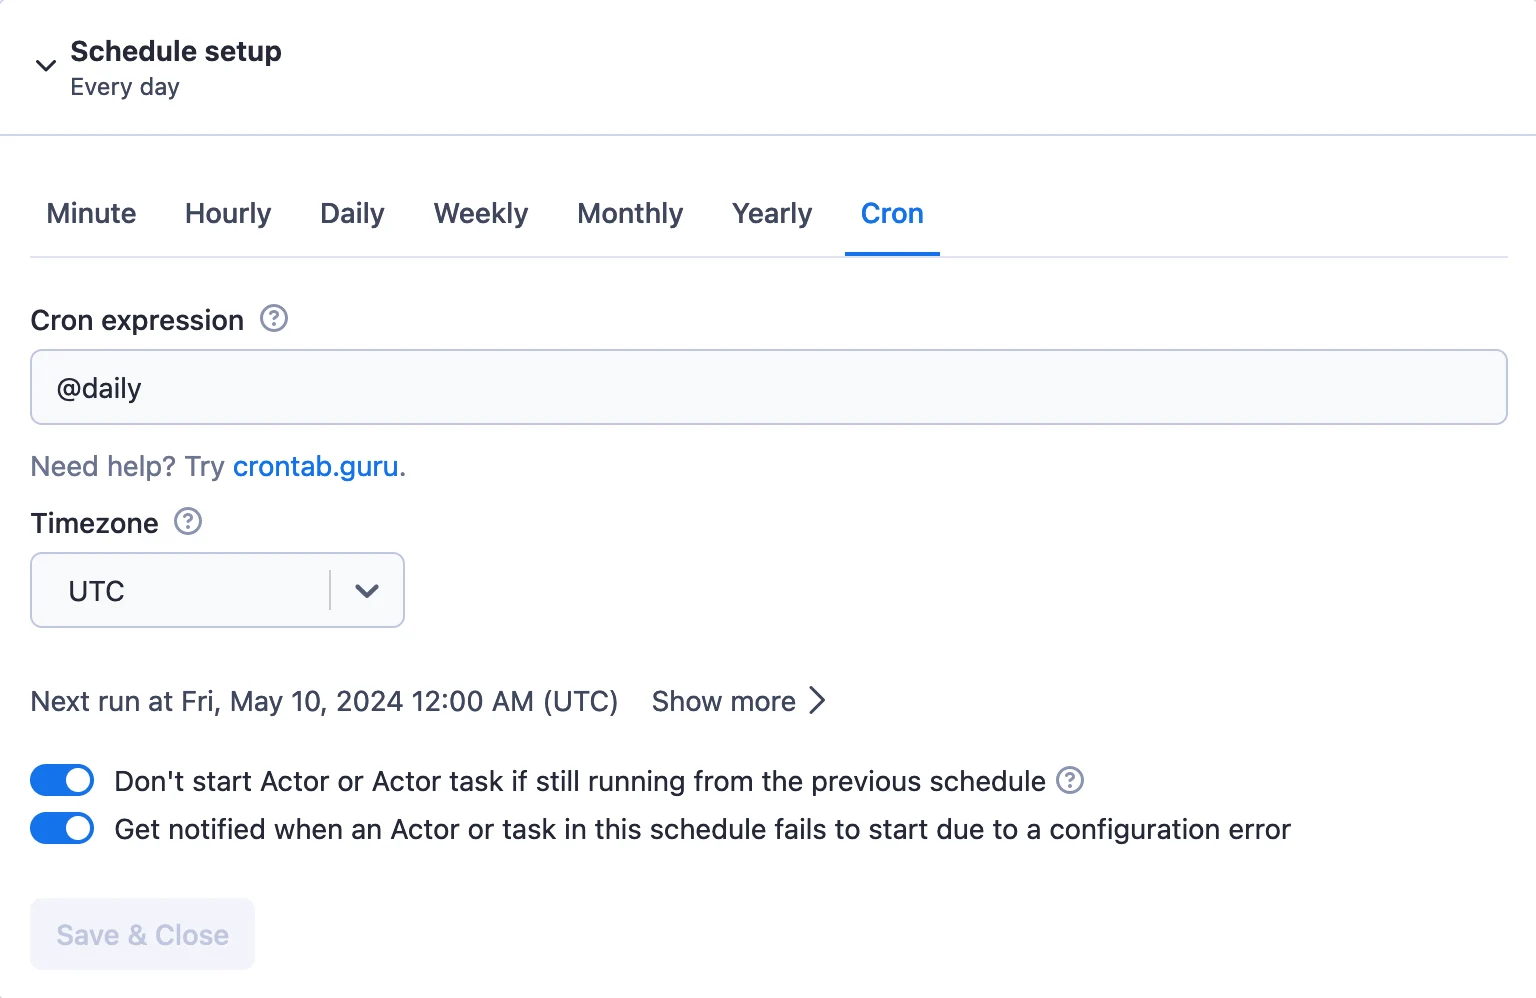
Nya Apify-scheman är inaktiverade, så aktivera dina efter att du har sparat. Apify skickar även ett e-postmeddelande till dig när en schemalagd uppgift inte startar.
Håller rörledningen frisk vecka efter vecka
Tysta misslyckanden är den verkliga fienden här. En tom inkorg ser precis ut som en lugn vecka, så bygg in aviseringar från dag ett.
Användningen förblir låg enbart genom inmatningsbegränsningar. Snäva datumfönster, begränsade resultat per profil och transkript endast där det behövs håller varje veckovis hämtning liten.
Där Creator Scraping når verkliga gränser
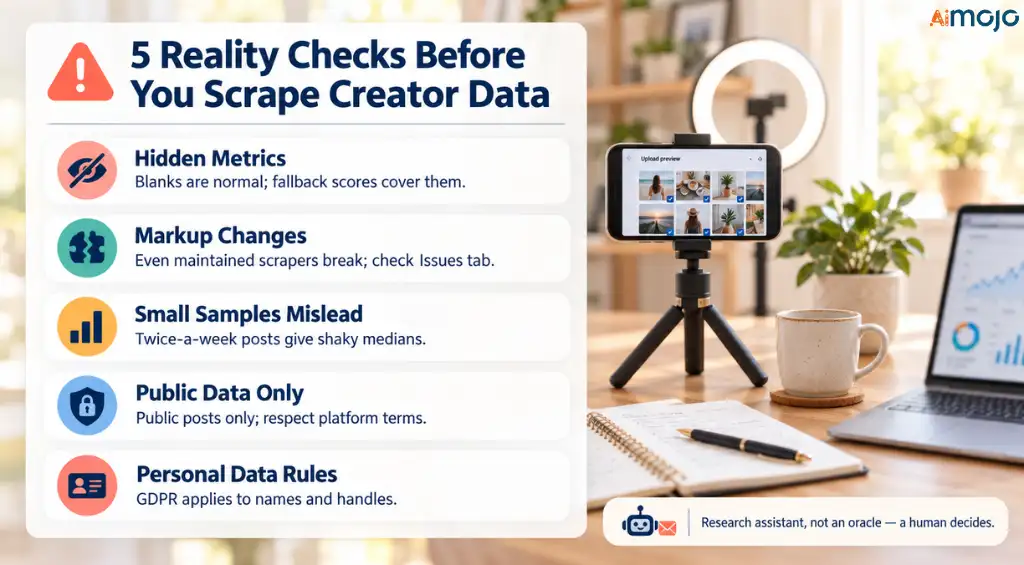
Varje automatiseringsförslag hoppar över den här delen, så här är det helt enkelt.
Behandla inkorgen som en forskningsassistent , inte ett orakel. En människa avgör fortfarande vilket mönster som förtjänar en fotograferingsdag.
Snabba svar om Apify och n8n Creator Research
Kan n8n utlösa Apify Actors utan kod?
Den officiella Apify-noden exekverar aktörer eller uppgifter, väntar på resultat och returnerar datasetobjekt, allt konfigurerat via fält i n8n.
Vilka skapare kan det här arbetsflödet spåra?
Valfri offentlig YouTube-kanal, TikTok-profil eller Instagram-konto. Byt till andra Apify Store-aktörer för att lägga till fler plattformar.
Fungerar Apify-noden som en AI Agentverktyg?
Lägg till Apify-verktyget under en AI Recensioner's verktyg så att en modell kan utlösa scrapes på begäran från en chatt.
Slutsats
Forskning bland skapare belönar den som först upptäcker ett mönster. Manuell scrollning gör det till ett heltidsjobb, och de flesta team ger tyst upp efter några veckor.
Apify och n8n överlämnar det jobbet till ett system.
Butiksaktörer publicerar nya offentliga inlägg, kodnoder poängsätter dem mot varje skapare's egen baslinje, och en AI lager förvandlar siffror till sammanfattningar.
Börja med det enda schemalagda arbetsflödet och fem kreatörer som du redan följer. När sammanfattningen visar sig användbar, utöka listan och gå vidare till den delade konfigurationen med Apify Schedules.
Ge det tre eller fyra veckors logghistorik.'s när extremvärden skärps och din måndagsinkorg börjar slå vilken trendrapport som helst du kan köpa.
AiMojo rekommenderar:


 BONUS: Få våra 200 dollarAI ”Mastery Toolkit” GRATIS när du registrerar dig!






