Informații cheie despre Ollama
Ce este Ollama?
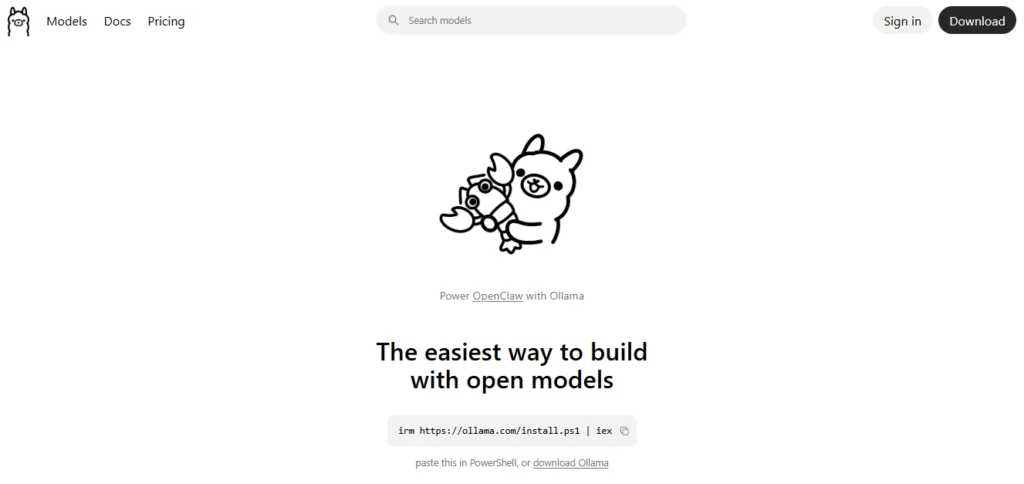
Ollama este o platformă de execuție LLM locală open-source care permite dezvoltatorilor, cercetătorilor și companiilor să descarce, să gestioneze și să ruleze modele lingvistice mari direct pe propriul hardware, fără a trimite niciun token către un server extern. Aceasta încapsulează ponderile modelului, fișierele de configurare și dependențele de execuție într-un singur pachet curat, expus printr-o interfață de linie de comandă și o API REST complet compatibilă cu OpenAI la localhost:11434.
Gândește-te la asta ca fiind personală AI server de inferență cu facturare zero per token. Acceptă peste 200 de modele open-weight, inclusiv Llama 3, Mistral, DeepSeek R1, Gemma 4 și Qwen, rulează pe macOS, Linux și Windows și se integrează cu peste 40,000 de instrumente comunitare, inclusiv LangChain, LlamaIndex și Open WebUI. Pentru orice echipă sau dezvoltator individual care are nevoie de spațiu privat, cu costuri controlate AI Prin deducție, Ollama este linia de bază a industriei.
Ollama expune un endpoint REST local la http://localhost:11434/v1 care oglindește Operatii DeschiseAI Conversație Structura API-ului Completions este exactă. Aceasta înseamnă că puteți construi și testa întreaga aplicație bazată pe LLM local folosind OpenAI SDK, apoi inversați două variabile de mediu pentru a le lansa în producție. Fără refactorizare, fără straturi de adaptor. Pentru dezvoltatorii care axează pe API-uri și care construiesc agenți sau conducte de automatizare, aceasta este cea mai mare economie de timp la nivel local. AI spațiu.
Ollama's Un fișier Modelfile este echivalentul unui fișier Dockerfile pentru LLM-uri. Definești modelul de bază, promptul de sistem, parametrii de inferență precum temperatura și top-p, precum și dimensiunea ferestrei de context într-un singur fișier declarativ. Apoi construiești și versionezi acea configurație ca model denumit. Acest lucru este esențial pentru echipele care au nevoie de un comportament reproductibil, specific proiectului, al modelului, fără inginerie de prompturi ad-hoc la momentul execuției.
Ollama detectează automat și utilizează backend-urile GPU NVIDIA CUDA, AMD ROCm și Apple Metal pentru a oferi inferențe accelerate pe hardware-ul de larg consum. Pe Apple Silicon, acest lucru este remarcabil în special, deoarece memoria unificată din seria M permite rularea unor modele mari de parametri, de la 7B la 13B, la viteze de generare practice, fără un GPU discret . Instrumentul descarcă automat straturile către VRAM-ul GPU și RAM-ul CPU în mod inteligent, maximizând debitul pe hardware mixt.
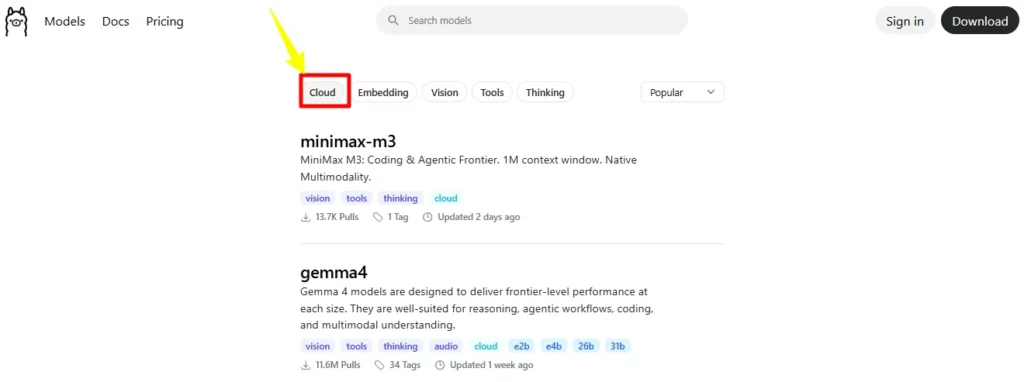
Dincolo de inferența locală, Ollama's Nivelul cloud servește modele găzduite pe infrastructura NVIDIA Cloud Provider folosind ponderi native și formate de date accelerate, inclusiv NVFP4 pe arhitectura Blackwell. Acest lucru oferă utilizatorilor acces la modele de nivel frontier, prea mari pentru hardware-ul de consum, cu garanția că nu se vor mai folosi înregistrări de prompturi și nu se va mai avea nevoie de antrenament pe datele utilizatorilor.
Ollama's Designul axat pe API a dus la o suprafață enormă de integrare. Se conectează direct la asistenții de codare, conductele RAG prin LangChain și LlamaIndex, interfețe grafice frontend precum Open WebUI și extensii IDE. Pentru orice dezvoltator care construiește produse native pentru inteligență artificială, această gamă largă de instrumente elimină problema integrării care afectează domeniile locale mai restrânse. AI platforme.
Planuri de prețuri Ollama
| Planifică | Costat | Limite și caracteristici cheie |
|---|---|---|
| Gratuit | $0 | Inferență locală nelimitată, 1 model cloud concurent, utilizare redusă a cloud-ului, acces CLI și API, peste 40,000 de integrări |
| Pro | $ 20 / luna | Totul în versiunea gratuită, 3 modele cloud simultane, utilizare cloud de 50 de ori mai mare decât în versiunea gratuită, încărcare și partajare privată a modelelor |
| max | $ 100 / luna | Totul în Pro, 10 modele cloud simultane, utilizare cloud de 5 ori mai mare decât Pro, potrivit pentru sarcini continue de agent |
| Echipa PGC | În curând | Utilizare partajată, facturare centralizată, SSO, controale de acces la model, instalare MDM, asistență prioritară |
Ollama pentru industrii critice pentru confidențialitate
Echipele din domeniul sănătății, juridic și financiar se confruntă cu cerințe stricte de rezidență a datelor și de conformitate care fac ca cloud-ul să fie... AI serviciile o răspundere. Ollama elimină complet acest risc. Toate inferențele au loc pe propria infrastructură, ceea ce înseamnă că dosarele pacienților, documentele legale și datele financiare nu părăsesc niciodată rețeaua.
Împreună cu modele de nivel enterprise precum Llama 3 sau DeepSeek R1, echipele beneficiază de capabilități LLM care satisfac auditurile interne de securitate fără a sacrifica calitatea rezultatelor. Acesta nu este un beneficiu teoretic. Este un model de implementare pregătit pentru producție.
Ollama pentru fluxuri de lucru Agentic și Automatizare
Ollama's Suportul pentru concurență pe nivelurile Pro și Max deblochează arhitecturi cu adevărat multi-agent. Rularea simultană a trei sau zece modele cloud înseamnă că framework-urile de orchestrare precum LangGraph sau AutoGen pot genera subagenți specializați pentru codare, cercetare și sumarizare în paralel.
Combinată cu API-ul compatibil cu OpenAI, puteți conecta logica de orchestrare scrisă în orice framework LLM major, fără modificări. Pentru dezvoltatorii care construiesc conducte autonome, aceasta este fundația infrastructurii care elimină costul cloud ca o constrângere.
Argumente pro şi contra
- Operatii DeschiseAI Înlocuire API drop-in.
- Peste 200 de modele deschise acceptate.
- Rulează complet offline.
- Autodetecție rapidă a GPU-ului.
- Ecosistem de integrare masivă.
- Zero înregistrare a datelor pe nivelul cloud.
- Fără interfață de chat încorporată nativă.
- Nu există suport pentru generarea nativă de imagini.
- Planul echipei nu este încă disponibil.
Cele mai bune alternative la Ollama
| Runtime LLM local | Dimensiunea bibliotecii de modele locale | API și integrare pentru dezvoltatori |
|---|---|---|
| LM Studio | Mai mare prin acces direct la Hugging Face | API limitat, fără opțiuni drop-in compatibile cu OpenAI |
| Jan.ai | Ecosistem moderat, în creștere | API de bază, concentrare puternică pe interfața utilizator |
| GPT4 | Modele mici, moderate și atent selecționate | Integrare externă limitată |


