
Você sabe exatamente a que momento me refiro. Primeiro frame, seu AI A personagem parece perfeita. Aí ela vira a cabeça, dá dois passos, abre a boca para falar — e de repente é o rosto de outra pessoa costurado na mesma roupa. As maçãs do rosto mudam, o nariz se rearranja, aquela pintinha que você adorava sumiu.
A deriva de identidade é o que silenciosamente arruína a maioria das pessoas. AI vídeo, e é por isso que parei de admirar vídeos de demonstração e finalmente me sentei para testar. Seedance 2.5 em APOB AI mim mesmo.
A questão que me interessava era direta: o Face-Lock consegue manter a identidade de um personagem nítida mesmo quando a cena começa a se mover ? Um rosto bonito parado é trivial. Um rosto que sobrevive a um ciclo de caminhada, um zoom lento, uma virada de cabeça e uma fala sem tremer — esse é o verdadeiro desafio.
Então, executei várias gerações diretamente do APOB. AI Analisei o painel de controle quadro a quadro e extraí o restante das informações específicas das páginas oficiais do produto, para que isso corresponda exatamente ao que você verá na sua tela. Veja exatamente o que aconteceu.
Seedance 2.5 no APOB AI: Com o que você está realmente trabalhando?
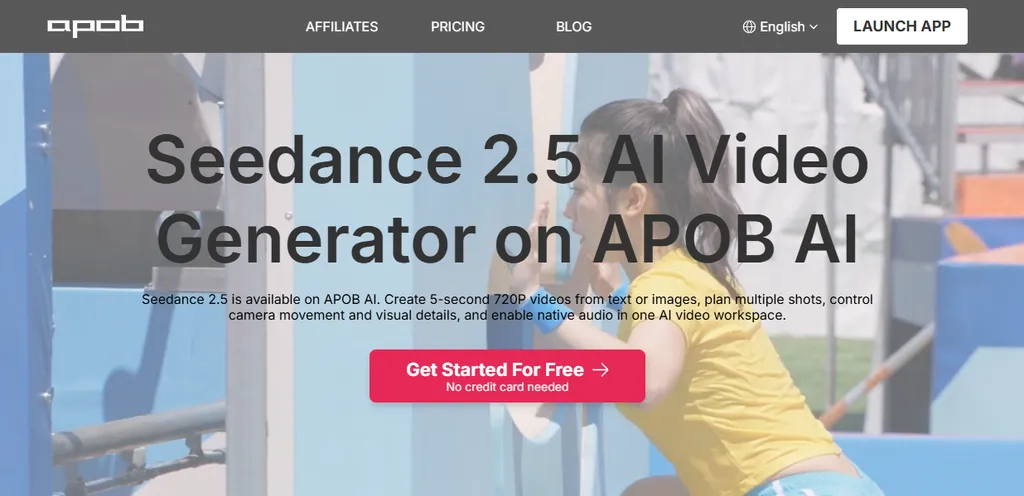
Uma breve contextualização antes dos resultados. O Seedance 2.5 é o modelo de geração de vídeo mais recente da ByteDance, construído sobre a mesma arquitetura conjunta de áudio e vídeo do Seedance 2.0, mas aprimorado para narrativas mais longas, referências multimodais e edição precisa em nível de marcação de tempo.
APOB AI é a plataforma que integra esse modelo em um espaço de trabalho amigável para criadores — a mesma ferramenta que muitas pessoas já usam para construir AI influenciadoresporta-vozes virtuais e personagens recorrentes da marca.
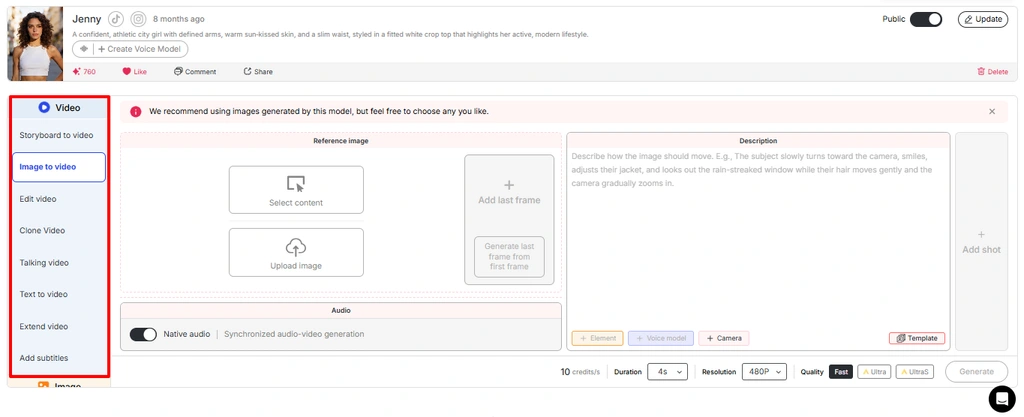
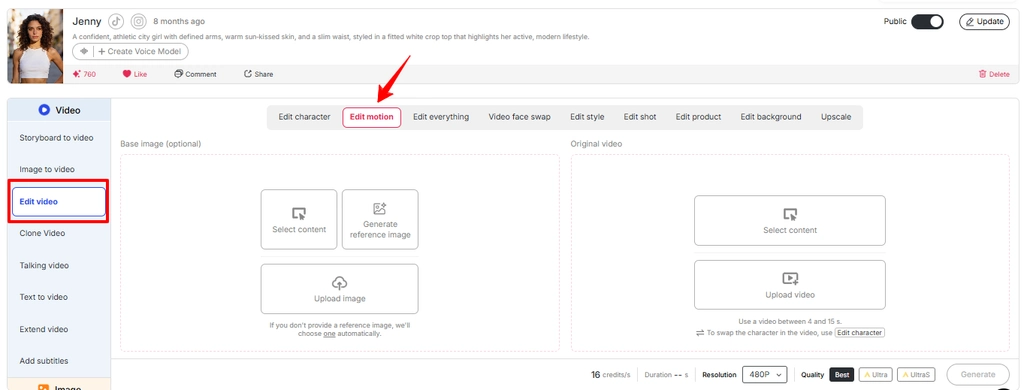
Dentro do APOB AI No painel de vídeo, você obtém um menu completo de modos: Texto para vídeo, Imagem para vídeo, Avatar falante, sincronia labialTroca de rostos em vídeo, extensão de vídeo, adição de legendas e edição de vídeo (ReVideo).
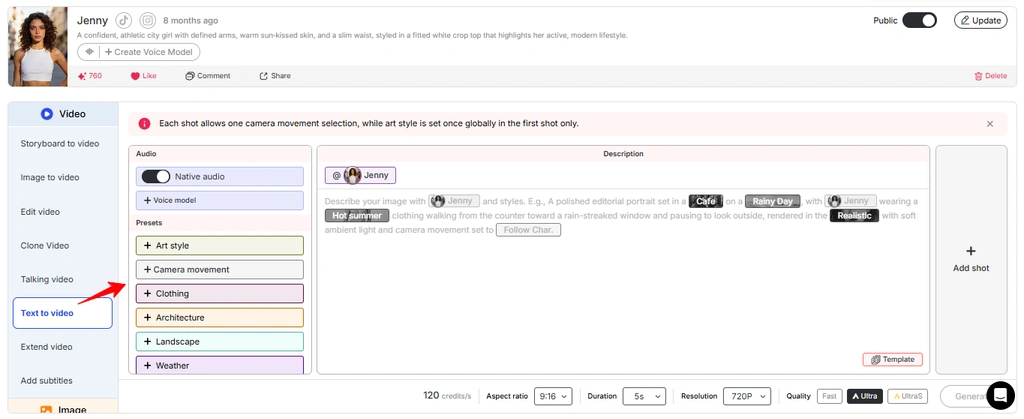
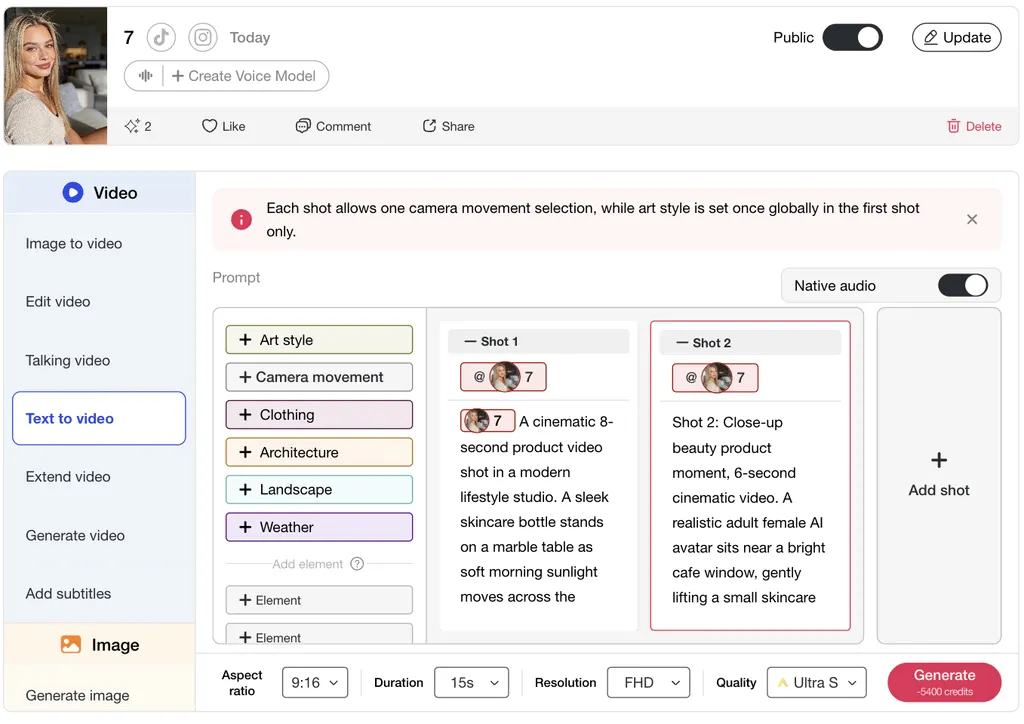
Especificamente no ambiente de trabalho Seedance 2.5, a versão que testei reproduziu vídeos de 5 segundos em 720p com níveis de qualidade Rápido, Ultra e UltraS, além de uma opção para ativar/desativar o áudio nativo e uma série de elementos de referência que podem ser anexados para ancorar um personagem. É nesse ambiente que tudo o que vem depois é avaliado, e é onde o Face-Lock se destaca ou fracassa.

O que significa realmente o "Face-Lock" no Seedance 2.5
APOB AI O marketing destaca o "Reconhecimento Facial Avançado" como um diferencial premium — a capacidade de manter uma identidade consistente em centenas de publicações. Remova o marketing e Bloqueio facial O modelo está tratando a identidade do seu personagem como uma âncora fixa em vez de uma nova estimativa a cada quadro?
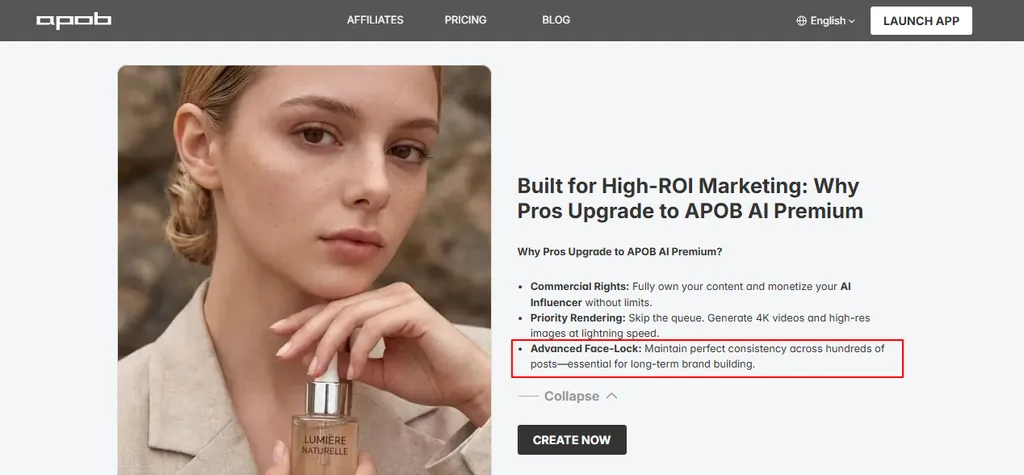
Quando funciona, a pessoa no quadro um é a mesma pessoa no quadro 120: mesmo queixo, mesmo espaçamento entre os olhos, mesma textura de pele, mesmas sardas, tudo igual.
O movimento é o que torna isso realmente difícil, e vale a pena entender o porquê antes de culpar a ferramenta. AI Os modelos de vídeo não possuem memória facial embutida — eles reconstroem o rosto a partir da referência e do estímulo em cada quadro.
Um movimento de cabeça força o modelo a inventar ângulos que nunca viu na imagem original. Um arco de câmera reconstrói o rosto a partir de novas posições. O diálogo redesenha continuamente a boca, o queixo e as bochechas. Cada um desses elementos representa uma oportunidade para a identidade se desviar, e esse desvio geralmente aparece nos frames em que o modelo tinha menos informações para trabalhar.
Um truque de campo que me poupou muitos créditos desperdiçados: observe os pequenos detalhes como um sistema de alerta precoce. Se um logotipo na camisa suaviza ou inverte no meio do clipe, o rosto quase sempre também treme. Pintas, sardas, tatuagens e traços assimétricos são os indicadores — logotipo estável, rosto estável, e eles tendem a se desfazer juntos. Se esses elementos se mantiverem estáveis ao longo do clipe, a identidade visual geralmente se mantém.
Meu teste com o Seedance 2.5: o rosto mantém a forma durante os movimentos?
Eu não queria uma pessoa sentada numa cadeira falando sem parar. Essa é a desculpa perfeita que toda demonstração usa. Eu queria movimento que realmente pressionasse a identidade.
A configuração, diretamente do painel de Texto para Vídeo: uma cena vertical de uma cidade iluminada por néon no formato 9:16, um sujeito caminhando em calçada molhada com reflexos e um lento movimento de aproximação cinematográfico. As configurações eram 720p, qualidade UltraS e 5 segundos. A gravação foi concluída em aproximadamente dois minutos, ao custo exibido de 1,000 créditos, ou 200 créditos por segundo. Executei variações do mesmo briefing algumas vezes para garantir que o primeiro resultado não fosse um acaso.
O que realmente me surpreendeu foi o que se manteve. Ao longo do ciclo de caminhada e do zoom, o sujeito permaneceu visualmente estável — sem se fundir com um estranho, a silhueta manteve sua forma e a identidade foi percebida como uma única pessoa do início ao fim.
Os reflexos no chão molhado e a iluminação neon também foram acompanhados de forma convincente, o que geralmente indica que a modelo entende bem a cena o suficiente para manter o sujeito firme no chão, em vez de flutuar em uma sopa de pixels. Para um sujeito em movimento com uma distância variável em relação à câmera, isso é uma aprovação legítima, não um troféu de participação.
Onde a imagem ficou instável foi exatamente onde você esperaria. Rotações rápidas, oclusão (algo que cruza brevemente na frente do rosto) e grandes mudanças de expressão continuam sendo as zonas de perigo.
Nos frames em que o modelo teve que inventar um ângulo para o qual não tinha nenhuma referência, microcaracterísticas sofreram pequenas alterações — uma sobrancelha ligeiramente diferente, um queixo suavizado por um instante antes de se recuperar. E quando reproduzi o diálogo em áudio nativo, a região da boca foi a que apresentou maior variação, que é onde você perceberá primeiro qualquer deslize, caso ele ocorra.
Veredito sincero: Face-Lock no Seedance 2.5 no APOB AI Sobrevive a movimentos comuns — caminhadas, movimentos de câmera cinematográficos, giros moderados — claramente melhor do que a versão anterior. AI ferramentas de vídeo Eu já usei. Não é à prova de falhas em rotações bruscas ou diálogos longos com muitas expressões. A recomendação prática é: confie nele para a maioria das cenas, verifique pontualmente aquelas em que há mais risco e mantenha uma ferramenta de reparo à mão para os raros casos de falha.
Sua imagem de referência decide se o FaceLock funciona ou não.
Quase sempre que o Face-Lock falhou comigo, a imagem de referência era a verdadeira culpada, não o modelo. Se você fornecer uma selfie suave, de perfil e com pouca luz, estará pedindo ao programa para adivinhar a maior parte do rosto — e é justamente aí que começam as tentativas de erro. Segundo o consenso entre os criadores de conteúdo que priorizam a consistência de personagens , a solução é uma âncora de identidade, e não apenas dicas mais precisas.
As regras de referência que realmente influenciaram meus resultados, aproximadamente em ordem de impacto:
Essa é a linha divisória entre um vídeo feito por hobby e algo que você realmente publicaria em uma conta de marca diariamente.
Estimulando a Semente 2.5 para que a Identidade Permaneça Inalterada
O estímulo é a outra metade da equação. Estímulos vagos convidam o modelo a improvisar, e a improvisação é como os rostos se desenvolvem. Estímulos rígidos oferecem um caminho a seguir.
A estrutura que consistentemente me proporcionou um Face-Lock mais forte foi esta ordem: sujeito → uma ação principal → ambiente → movimento de câmera → iluminação → estilo → áudio → restrições.
Esse último bloco — restrições — é o que a maioria das pessoas ignora. Adicionar “sem texto, sem logotipos, sem diálogos” quando eles não pertencem à cena remove os elementos aleatórios que desestabilizam o enquadramento. Se você não precisa que a boca se mova, não inclua diálogos; uma boca imóvel é uma boca estável, ponto final.
Mantenha cada tomada focada em uma única ação clara. "Ela caminha, se vira, ri e acena" são quatro oportunidades distintas para a modelo se movimentar, condensadas em cinco segundos. "Ela caminha em direção à câmera, com uma expressão calma" é uma única ação clara que a modelo consegue manter. Em seguida, encadeie essas ações claras usando o controle Adicionar Tomada ou a ferramenta Estender Vídeo, mantendo a mesma descrição da personagem em todas elas.
Em termos de trabalho de câmera, a sutileza sempre supera o exibicionismo — um movimento lento de aproximação ou um travelling estável preservam o rosto muito melhor do que uma órbita rápida que o move por ângulos que o modelo nunca viu. Se uma órbita principal for indispensável, gere-a e corrija os frames perdidos posteriormente, em vez de torcer para que tudo dê certo.
Como a conversão de imagem em vídeo e o controle do último quadro ajudam no reconhecimento facial.
Um recurso que merece destaque: a conversão de imagem em vídeo com controle do primeiro e do último quadro. O Seedance 2.5 trata o último quadro menos como uma dica vaga e mais como um destino final. Para identidade visual, isso é um superpoder discreto.
O fluxo de trabalho que eu gostei: primeiro, gere uma imagem principal impactante — personagem, roupa, fundo, atmosfera, tudo bem definido — e depois importe essa imagem para o Image to Video como seu quadro de abertura.
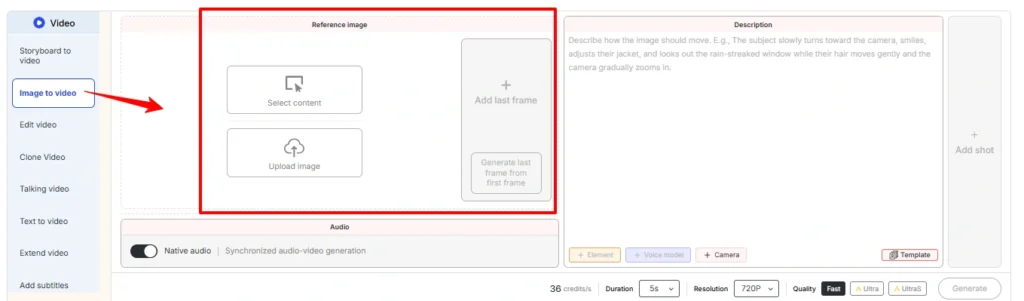
Se você tiver uma pose final definida, defina-a também como o último quadro. Como o modelo agora está interpolando entre duas imagens fixas e com identidade correta, em vez de inventar um final do zero, há muito menos espaço para o rosto se desviar no meio da transição.
Mantendo o contato visual durante as tomadas e extensões.
Um clipe é o modo fácil. O verdadeiro teste é uma sequência — o mesmo personagem em cinco tomadas, ou um clipe curto esticado para algo mais longo, mantendo a impressão de que se trata da mesma pessoa do começo ao fim.
É aqui que a disciplina do fluxo de trabalho mostra sua importância. O Extend Video carrega um clipe de referência adiante e, de acordo com as próprias notas do modelo da ByteDance, visa manter a consistência do personagem principal, do ambiente e do ritmo em cada rodada de extensão.
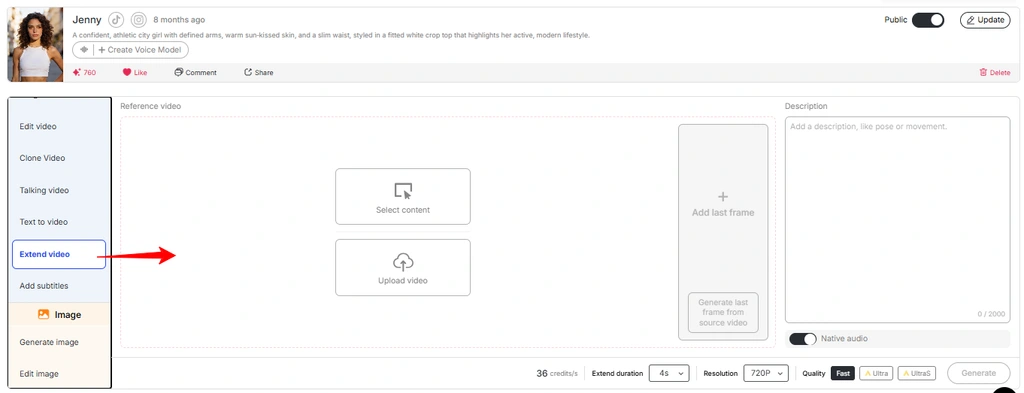
Na prática, quanto mais a descrição se altera entre as rodadas, mais rápido a identidade se deteriora. Trate sua ficha de personagem como um recurso de produção fixo: mesmas palavras, mesma referência, sempre.
Para filmagens com múltiplas tomadas, estruture a lista de tomadas em torno da continuidade, não da variedade — reutilize a descrição do assunto palavra por palavra, mantenha as referências de figurino anexadas e altere apenas a ação e o cenário entre as tomadas.
Quando um rosto fica desalinhado apesar de tudo isso, o Video Face Swap e o Edit Video ( ReVideo ) permitem corrigir segmentos específicos em vez de regenerar tudo e tentar novamente a identidade do personagem. Na versão que testei, o Edit Video aceitava uploads de 3 a 30 segundos em 720p, então você pode corrigir cirurgicamente uma oscilação de dois segundos sem afetar a filmagem original.
Como o Seedance 2.5 Face-Lock se compara a outros AI Modelos de vídeo
O contexto ajuda aqui, porque "bom" só significa algo em relação ao restante do campo. Nas comparações gerais para 2026, o cenário se apresenta mais ou menos assim:
Os modelos da classe Veo tendem a se destacar pelo fotorrealismo em close-up e áudio sincronizado com os lábios, os modelos da classe Kling são fortes em cores cinematográficas e diálogos com vários personagens, mas frequentemente dependem da junção de vários clipes curtos, e o Seedance 2.5 é repetidamente elogiado pela rigorosa consistência dos personagens e coerência espacial em uma única geração contínua.
Especificamente para o Face-Lock, essa característica de "geração contínua única" é importante. Quando um modelo mantém um personagem durante toda a cena, sem interrupções, em vez de exigir que você faça ajustes e torça para que tudo dê certo, simplesmente há menos pontos de ruptura na identidade.
Essa é a razão prática pela qual o Seedance 2.5 está no APOB. AI Parece confiável para trabalhos com personagens recorrentes — o modelo foi desenvolvido para manter o sujeito estável durante o movimento, e as ferramentas de empilhamento e reparo de referências do APOB AI complementam essa vantagem.
Onde Seedance 2.5 em APOB AI Ainda enfrenta dificuldades
Sem rodeios — alguns pontos fracos persistiram ao longo das minhas partidas, e conhecê-los economiza créditos.
Cenas com vários personagens são mais difíceis. Quando vários personagens compartilham o mesmo quadro, o modelo divide sua atenção e os rostos secundários se dispersam antes do protagonista. Movimentos físicos agressivos — cambalhotas, giros rápidos, coreografias frenéticas — ainda exigem muito da plausibilidade física, e os rostos podem sofrer as consequências nesses quadros.
Diálogos longos com grandes variações de expressão continuam sendo a maneira mais confiável de detectar o deslizamento da pele, porque a região da boca está sendo reconstruída continuamente e as características ao redor acompanham esse processo.
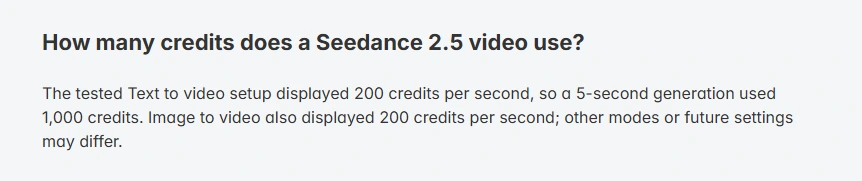
Em seguida, vamos aos detalhes práticos. A geração consome créditos (200 por segundo na conversão de texto em vídeo), os modos principais do Seedance 2.5 que testei tinham um limite de 5 segundos e resolução de 720p, e cada clipe passa por uma revisão antes de ser publicado. Interfaces, limitações e preços mudam com as atualizações do produto, portanto, considere os valores exatos aqui apresentados como um retrato desatualizado, e não como uma especificação definitiva.
Desbloqueio facial por tipo de movimento: Guia rápido
| Tipo de movimento | Confiabilidade do Face-Lock | Jogue com inteligência |
|---|---|---|
| Caminhando / movimento lento do sujeito | Forte | Confie nisso, verificação rápida. |
| Plano de aproximação lenta / travelling | Forte | Ideal para fotos de destaque. |
| Virada de cabeça moderada | Boa | Utilize uma referência frontal nítida. |
| I2V do primeiro e último quadro | Forte | A caixa se desloca para dentro em ambas as extremidades. |
| órbita rápida da câmera | Misto | Gere e, em seguida, aplique o Face Swap. |
| Diálogo denso + expressão | Mais Fraco | Mantenha os segmentos curtos e revise-os atentamente. |
| Fotos de grupo com vários personagens | Mais Fraco | Ancore um herói, use os demais como referência. |
Solução de problemas do FaceLock: correções rápidas que funcionaram
Quando um vídeo voltava com o rosto desorientado, esses eram os movimentos que realmente corrigiam a situação, na ordem em que eu os tentava:
- Troque a referência antes de tocar no prompt. Em nove de cada dez casos, uma referência mais nítida e frontal resolve o problema mais rapidamente do que qualquer ajuste rápido.
- Reduza a ação pela metade. Se o sujeito estivesse fazendo duas coisas, elimine uma. Uma batida limpa a cada cinco segundos é o ideal.
- Elimine diálogos desnecessários. Se a boca não precisar se mover para a tomada funcionar, remova o áudio e observe a expressão facial permanecer estável.
- Diminua a velocidade da câmera. Troque a órbita por uma aproximação e a maior parte da microderiva desaparece.
- Reparar, não regenerar. Para corrigir pequenas oscilações localizadas, usar a função Troca de Rosto no Vídeo ou Editar Vídeo apenas nesses segundos é melhor do que regravar o clipe inteiro e correr o risco de um resultado pior.
O Seedance 2.5 está em APOB? AI Certo para você?
Se você estiver construindo um AI influenciador, um recorrente porta-voz virtualSeja uma série de vídeos curtos com uma identidade consistente, ou vídeos de produtos onde o rosto da pessoa precisa manter a mesma imagem da marca em dezenas de publicações, essa combinação é perfeita.
O empilhamento de referência, o controle do primeiro e do último quadro, o fluxo Extend Video e as ferramentas de reparo com edição no local foram criados exatamente para lidar com a repetição de caracteres — que é o principal motivo pelo qual o Face-Lock é importante.
Se o seu trabalho consiste em clipes de ação únicos e com muito movimento, onde ninguém se concentra em diferenciar um rosto do outro, o Face-Lock importa muito menos e você pode dar instruções mais flexíveis e se movimentar mais rapidamente. A principal vantagem aqui é a continuidade da identidade, o que beneficia criadores que precisam da mesma pessoa repetidamente, mantendo a mesma consistência ao longo do feed.
Perguntas Frequentes
O recurso Face-Lock do Seedance 2.5 funciona mesmo com movimentos rápidos?
A imagem se mantém bem em movimentos comuns — caminhadas, planos de acompanhamento, giros moderados. Rotações rápidas, oclusões e mudanças bruscas de expressão ainda são pontos em que a identidade pode se perder, então revise esses trechos com atenção e tenha uma ferramenta de reparo à mão.
Qual a resolução e o comprimento do Seedance 2.5 em APOB? AI Apoio, suporte?
Na versão que testei, os modos principais de Texto para Vídeo e Imagem para Vídeo processaram clipes de 5 segundos em 720p com os planos Rápido, Ultra e UltraS. A opção Editar Vídeo lidou com uploads de 3 a 30 segundos. As configurações podem mudar conforme a plataforma é atualizada.
Quantos créditos custa um clipe Seedance 2.5 no APOB AI?
Os testes de conversão de texto em vídeo e de imagem em vídeo apresentaram 200 créditos por segundo, portanto, um clipe de 5 segundos consumiu 1,000 créditos. Os modos de edição e extensão mostraram taxas por segundo mais altas no mesmo teste.
O que torna uma imagem de referência para o Face-Lock boa?
Um rosto nítido, de alta resolução, frontal, uniformemente iluminado e com expressão neutra. Referências suaves, laterais ou pouco iluminadas obrigam o modelo a adivinhar, e é justamente nessa adivinhação que a distorção começa. Vários ângulos consistentes ajudam ainda mais.
Posso manter o mesmo personagem em várias tomadas e extensões?
Sim. Reutilize a mesma descrição de personagem em todas as cenas, mantenha os elementos de referência e use o recurso "Estender Vídeo" para preservar a identidade. Quanto mais a redação mudar entre as cenas, mais rápido a identidade se perde.
O áudio nativo afeta a estabilidade facial?
Sim, pode. Os diálogos redesenham a região da boca a cada fotograma, então longos trechos de conversa são os locais mais comuns para detectar deslizamentos. Se uma cena não precisa de fala, deixe-a de fora para uma estabilização mais limpa.
Como o Seedance 2.5 se compara ao Veo ou ao Kling em termos de consistência?
Comparações abrangentes para 2026 colocam os modelos da classe Veo à frente em realismo de close-up e os da classe Kling à frente em trabalhos cinematográficos com múltiplos personagens, enquanto o Seedance 2.5 é repetidamente elogiado pela estrita consistência dos personagens em uma única geração contínua — que é exatamente o que o Face-Lock oferece.
Análise final do Seedance 2.5 no APOB AI
Face-Lock no Seedance 2.5 no APOB AI Não é mágica, mas é realmente boa onde importa. Sob as condições de movimento que a maioria dos criadores filma — pessoas caminhando, movimentos de câmera cinematográficos, giros moderados — a identidade visual se manteve em todos os meus testes, e aquele clipe da cidade iluminada por neon comprovou isso: sujeito estável, iluminação coerente, sem troca de estranhos no meio da cena.
Ao explorar órbitas rápidas, oclusão e diálogos longos e expressivos, você ainda encontrará alguma oscilação ocasional, portanto, a revisão continua sendo parte do trabalho.
A estratégia vencedora é a disciplina à moda antiga: uma referência frontal precisa, uma descrição de personagem fixa e reutilizada palavra por palavra, uma ação limpa por tomada, movimentos de câmera suaves, controle do primeiro e do último quadro quando possível, e a função Troca de Rosto ou Editar Vídeo pronta para corrigir eventuais deslizes.
Faça isso e você conseguirá o que quer. AI O vídeo continuou prometendo por anos — o mesmo rosto, movendo-se em movimento real, ainda reconhecível. o seu personagem do primeiro ao último quadro.
AiMojo recomenda:


 BONUS: Receba nossos $ 200 “AI “Kit de ferramentas de domínio” GRÁTIS ao se inscrever!


