
Sua AI O agente tem um problema. Ele sabe tudo sobre o mundo, até o dia em que seu treinamento terminou. Pergunte a ele sobre um concorrente.'s A página de preços, uma notícia recente ou a documentação de uma biblioteca lançada na semana passada, e o sistema simplesmente adivinha ou pede desculpas.
A solução é usar dados da web em tempo real. E em 2026, a maneira mais rápida de transmiti-los para qualquer sistema será... AI O sistema é o Firecrawl.
Usamos o Firecrawl em toda a nossa rede. Ele viabiliza a coleta de dados em nossos aplicativos de produção , alimenta nossos agentes de pesquisa e é executado em nossos fluxos de trabalho do WordPress.
Este tutorial é tudo o que gostaríamos que alguém tivesse nos dado no primeiro dia: a configuração sem código com um clique, o código em Python e Node, a extração estruturada, um pipeline RAG funcional e os truques de custo que mantêm a conta bem pequena.
Sem enrolação. Deixe's construir. 🚀
O que vamos construir neste guia de Firecrawl
Ao final deste tutorial, você saberá como:
- Conecte o Firecrawl ao Claude, ChatGPT ou Cursor com um clique (sem precisar escrever nenhum código).
- Extraia qualquer URL e converta-a em Markdown limpo e pronto para LLM usando Python ou Node.
- Extrair dados de um site inteiro e transformá-lo em um conjunto de dados.
- Extraia JSON estruturado de páginas desorganizadas usando um esquema.
- Integre dados da web em tempo real a um pipeline RAG com LangChain ou LlamaIndex.
- Mantenha o uso do seu crédito moderado.
O único pré-requisito é uma chave de API do Firecrawl. Essa parte é gratuita.
Passo 1: Obtenha sua chave de API (1,000 créditos grátis, sem necessidade de cartão) 🔑
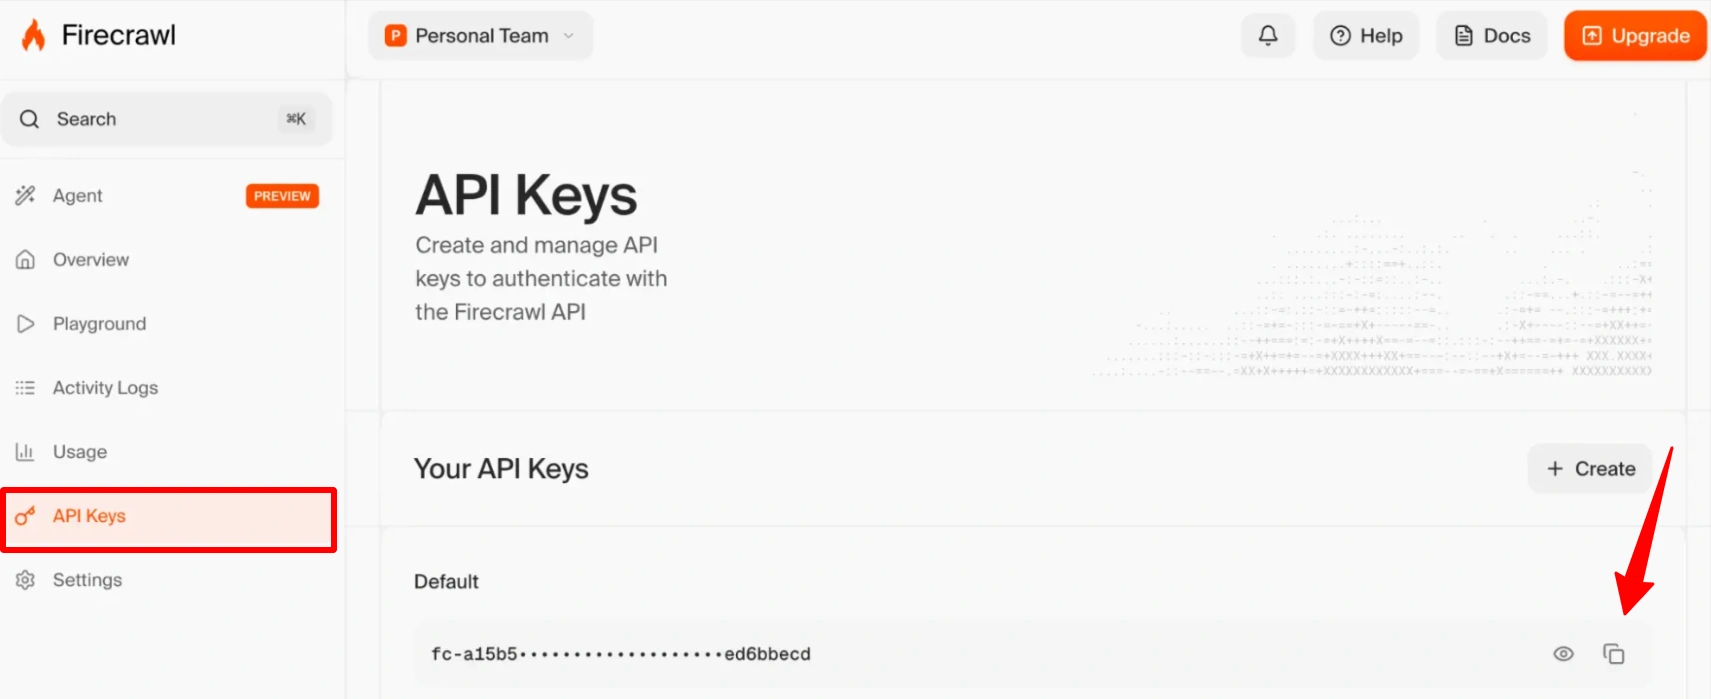
O plano gratuito do Firecrawl oferece 1,000 créditos por mês . Um crédito equivale a uma página extraída, o que significa 1,000 páginas mensais, com renovação automática, sem necessidade de cartão de crédito. Isso é mais do que suficiente para concluir este tutorial inteiro várias vezes.
|
Após acessar o painel de controle, copie sua chave de API. Ela começa com fc-. Essa sequência é a sua chave de acesso a tudo o que está descrito abaixo.
Passo 2: O Caminho de Um Clique (Sem Necessidade de Código) ⚡
Antes de escrevermos uma única linha de código, saiba disto: você pode não precisar de nenhuma.
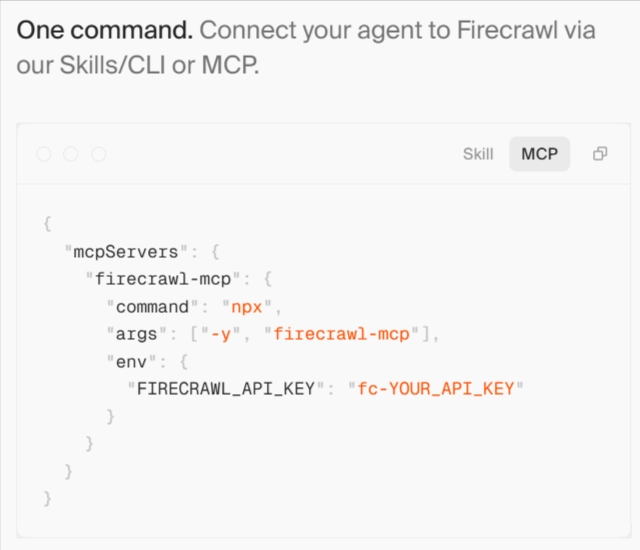
O Firecrawl utiliza um servidor MCP (Model Context Protocol) oficial e se conecta aos seus servidores favoritos. AI As ferramentas funcionam da mesma forma que você conectaria uma conta do Gmail. O servidor hospedado está localizado em:
https://mcp.firecrawl.dev/v2/mcpAdicione sua chave de API à URL e qualquer ferramenta compatível com MCP poderá usá-la:
https://mcp.firecrawl.dev/fc-YOUR_API_KEY/v2/mcpNo Claude (web ou desktop): adicione o Firecrawl como um conector ou insira o seguinte código no arquivo claude_desktop_config.json:
{
  "mcpServers": {
    "firecrawl": {
      "command": "npx",
      "args": ["-y", "firecrawl-mcp"],
      "env": {
        "FIRECRAWL_API_KEY": "fc-YOUR_API_KEY"
      }
    }
  }
}Uma vez conectado, seu AI assistente O sistema ganha dez novas funcionalidades: raspar, pesquisar, rastrear, mapear, extrair, interagir, monitorar, analisar, pesquisar e um agente totalmente autônomo. E você controla tudo isso em linguagem natural.
Experimente sugestões como estas:
- Extraia os dados de https://competitor.com/pricing e resuma todos os planos em uma tabela.
- Analise a documentação em docs.example.com, no máximo 50 páginas, e explique como funciona o sistema de autenticação.
- Pesquise na internet por “melhor” AI geradores de vídeo 2026” e compare os 5 melhores resultados.
Esta é a configuração que os membros não técnicos da nossa equipe usam diariamente. Sem terminal, sem código, dados da web reais e em tempo real em todas as conversas. Se isso é tudo o que você precisa, pode parar por aqui. Mas se você estiver desenvolvendo aplicativos, a API é onde o Firecrawl fica interessante.
Passo 3: Extraia os dados da sua primeira página com a API 🐍
Hora de programar. Instale o SDK:
# Python
pip install firecrawl
# Node.js
npm install firecrawl
Extrair dados de uma URL requer três linhas de código em Python. Aqui está o exemplo em Python:
from firecrawl import Firecrawl
firecrawl = Firecrawl(api_key="fc-YOUR_API_KEY")
doc = firecrawl.scrape("https://firecrawl.dev", formats=["markdown"])
print(doc.markdown)
E nó:
import { Firecrawl } from 'firecrawl';
const firecrawl = new Firecrawl({ apiKey: 'fc-YOUR_API_KEY' });
const doc = await firecrawl.scrape('https://firecrawl.dev', { formats: ['markdown'] });
console.log(doc.markdown);
Execute o comando e observe o resultado. Esse é o segredo que torna o Firecrawl especial: o que ele retorna não é um código HTML bruto e confuso. É um Markdown limpo, com títulos, listas e links adequados, sem barras de navegação, banners de cookies, scripts ou elementos desnecessários do rodapé.
Por que isso é tão importante? Dois motivos: tokens e precisão. O HTML bruto de uma página típica pode ter 10 vezes o tamanho do seu conteúdo real, e cada token inútil custa dinheiro e dilui seu modelo.'s Atenção. Markdown limpo significa prompts menores, custos de mestrado mais baixos e respostas baseadas em conteúdo, em vez de informações irrelevantes.
Você também pode solicitar outros formatos na mesma chamada: HTML, captura de tela, links ou JSON estruturado. Empilhe-os conforme necessário:
doc = firecrawl.scrape(
    "https://example.com/blog/post",
    formats=["markdown", "links"]
)
O Firecrawl renderiza JavaScript por padrão, então sites React, páginas dinâmicas e conteúdo renderizado no lado do cliente são exibidos completos. Sem necessidade de monitoramento constante do navegador (headless browser) do seu lado.
Etapa 4: Rastreie um site inteiro 🕸️
Uma página é uma demonstração. Um site inteiro é um conjunto de dados.
O endpoint de rastreamento segue links a partir de uma URL inicial e extrai tudo o que encontra, com controles para profundidade, limites de página e filtros de caminho:
from firecrawl import Firecrawl
from firecrawl.types import ScrapeOptions
firecrawl = Firecrawl(api_key="fc-YOUR_API_KEY")
crawl_status = firecrawl.crawl(
    'https://docs.example.com',
    limit=100,
    scrape_options=ScrapeOptions(formats=['markdown']),
    poll_interval=30
)
for page in crawl_status.data:
    print(page.metadata.url)
Versão do Node:
const crawlResponse = await firecrawl.crawl('https://docs.example.com', {
  limit: 100,
  scrapeOptions: { formats: ['markdown'] }
});
console.log(`Crawled ${crawlResponse.data.length} pages`);
O SDK gerencia a consulta de tarefas e a paginação para você, retornando cada página como um arquivo Markdown limpo. Três parâmetros que vale a pena memorizar:
- limitar Limite total de páginas. Sempre configure isso. É o seu cinto de segurança de crédito.
- incluirCaminhos / excluirCaminhos Filtre URLs com padrões de expressões regulares. Está rastreando um site de documentação? Exclua /blog/.* e /careers/.* e pare de pagar por páginas que você nunca usará.
- profundidade máxima de descoberta Controla quantos saltos de link o rastreador segue a partir da URL inicial.
Dica profissional: antes de qualquer rastreamento extenso, acesse primeiro o endpoint do Map . Ele retorna todos os URLs de um site em poucos segundos, praticamente sem custo em créditos. Defina o escopo da tarefa, conte as páginas e, em seguida, rastreie exatamente o que você precisa.
result = firecrawl.map("https://docs.example.com")
print(f"{len(result.links)} URLs found")
Etapa 5: Extrair dados estruturados com um esquema 📊
O Markdown é perfeito para RAG (Representação, Atribuição e Classificação). Mas, às vezes, você precisa de campos, não de texto: nomes de produtos, preços, avaliações. É para isso que serve o endpoint Extract.'s trabalho. Você descreve o formato dos dados, Firecrawl's AI retira-o da página:
schema = {
    "type": "object",
    "properties": {
        "product_name": {"type": "string"},
        "price": {"type": "string"},
        "rating": {"type": "number"},
        "in_stock": {"type": "boolean"}
    },
    "required": ["product_name", "price"]
}
result = firecrawl.extract(
    urls=["https://example-store.com/product/xyz"],
    prompt="Extract the product details from this page",
    schema=schema
)
print(result.data)
Sem seletores CSS. Sem XPath. Sem analisador sintático que falha assim que o site muda seu layout. Você define o que deseja, e a extração sobrevive a reformulações porque entende o conteúdo, não a marcação.
Esse mesmo padrão é executado em produção na nossa rede: um dos nossos aplicativos usa o Extract para transformar páginas de fornecedores desorganizadas em um banco de dados de preços uniforme, automaticamente e de acordo com um cronograma. O mesmo esquema funciona em dezenas de sites com designs diferentes. Tente criar algo parecido com expressões regulares e me conte o resultado. 😅
Passo 6: Forneça ao seu agente a pesquisa na Web 🔎
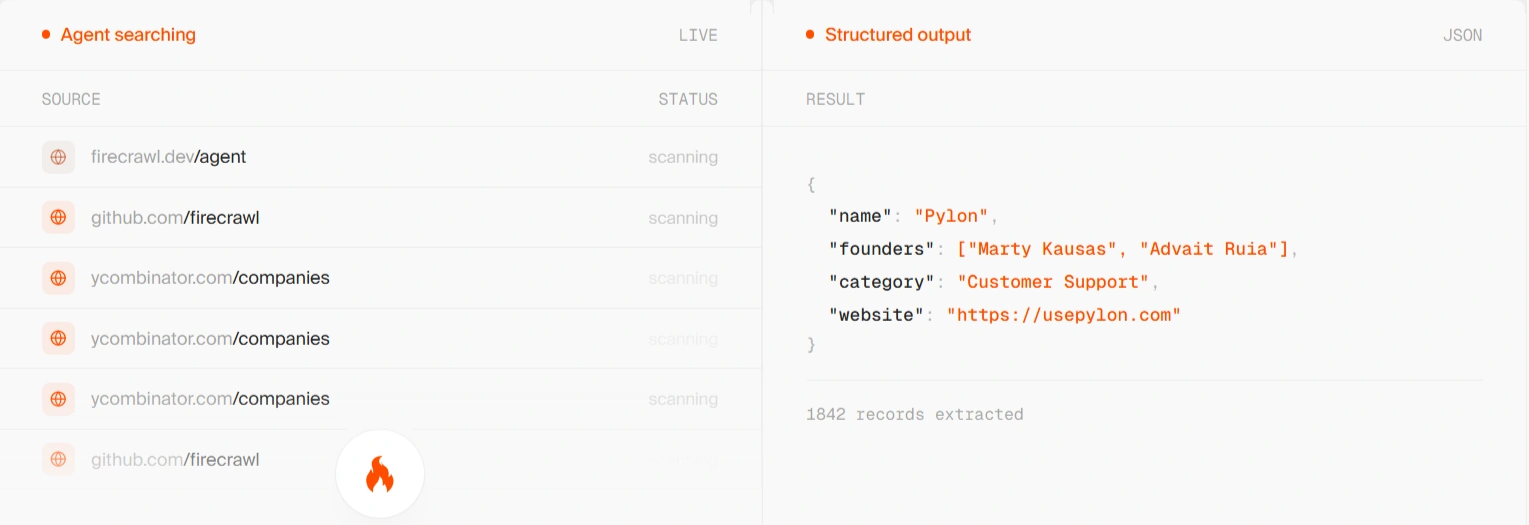
A raspagem de dados lida com URLs que você já conhece. A busca lida com aquelas que você não conhece.
O endpoint de busca do Firecrawl é o recurso mais surpreendente de toda a plataforma. A maioria das APIs de busca retorna links e um trecho de código, deixando para você a tarefa de buscar e limpar cada resultado manualmente. O Firecrawl retorna os resultados com todo o conteúdo extraído , em uma única chamada:
results = firecrawl.search(
    query="best open source LLMs 2026",
    limit=5
)
para cada item em results.web:
print(item.title, item.url)Node, com extração de conteúdo ativada por resultado:
const results = await firecrawl.search('best open source LLMs 2026', {
  limit: 5,
  scrapeOptions: { formats: ['markdown'] }
});
Este é o alicerce para agentes de pesquisa . O ciclo é simples: seu agente formula uma consulta, o Firecrawl retorna conteúdo legível dos principais resultados e seu LLM sintetiza uma resposta com fontes. Isso é pesquisa aprofundada, e você acabou de criá-la em apenas algumas linhas de código.
Observação sobre custos: a pesquisa consome 2 créditos a cada 10 resultados, além dos créditos normais de extração de conteúdo quando você obtém o conteúdo completo. Mesmo assim, é consideravelmente mais barato do que qualquer API de respostas dedicada que testamos.
Passo 7: Conecte-o a um oleoduto RAG 🧠
Agora, o evento principal: alimentar um AI agente com conhecimento da web ao vivo. Ambas as principais estruturas incluem carregadores Firecrawl de primeira classe.
LangChain:
- from langchain_community.document_loaders import FireCrawlLoader
- from langchain_text_splitters import RecursiveCharacterTextSplitter
- de langchain_openai importar OpenAIEmbeddings
- from langchain_community.vectorstores import FAISS
# 1. Carregue um site inteiro como documentos limpos
loader = FireCrawlLoader(
    api_key="fc-YOUR_API_KEY",
    url="https://docs.example.com",
    mode="crawl"
)
docs = loader.load()
# 2. Divida-os em pedaços.
splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=100)
chunks = splitter.split_documents(docs)
# 3. Incorporar e indexar
vectorstore = FAISS.from_documents(chunks, OpenAIEmbeddings())# 4. Faça perguntas com base em dados da web em tempo real.
retriever = vectorstore.as_retriever()
relevant = retriever.invoke("How do I authenticate API requests?")
Índice de Lhama:
- from llama_index.readers.web import FireCrawlWebReader
- from llama_index.core import VectorStoreIndex
reader = FireCrawlWebReader(
    api_key="fc-YOUR_API_KEY",
    mode="crawl",
    url="https://docs.example.com"
)
documents = reader.load_data()
index = VectorStoreIndex.from_documents(documents)
response = index.as_query_engine().query("How does their pricing work?")
print(response)
Trata-se de um fluxo completo de "bate-papo com qualquer site" em menos de 25 linhas. Como o Firecrawl entrega ao carregador um Markdown limpo em vez de HTML, seus trechos de código são coerentes, seus embeddings são significativos e a qualidade da recuperação de dados aumenta significativamente em comparação com a raspagem de dados ingênua. Essa é a principal razão pela qual os desenvolvedores de RAG escolhem o Firecrawl.
Os mesmos carregadores funcionam com CrewAI, Dify, Flowise e n8n, caso você prefira fluxos de trabalho visuais.
Bônus: A arquitetura econômica da qual ninguém fala 💡
Eis o padrão que economiza dinheiro de verdade para nossos aplicativos todos os meses.
Quando seu aplicativo precisa de respostas adaptadas à web, o caminho óbvio é um LLM com busca na web integrada . Mas os provedores cobram a busca na web como um recurso adicional premium, e APIs de resposta dedicadas ficam caras rapidamente em grande escala.
A divisão mais inteligente:
Firecrawl (busca, ~$0.001/página) → LLM barato (motivo: não requer acesso à web)
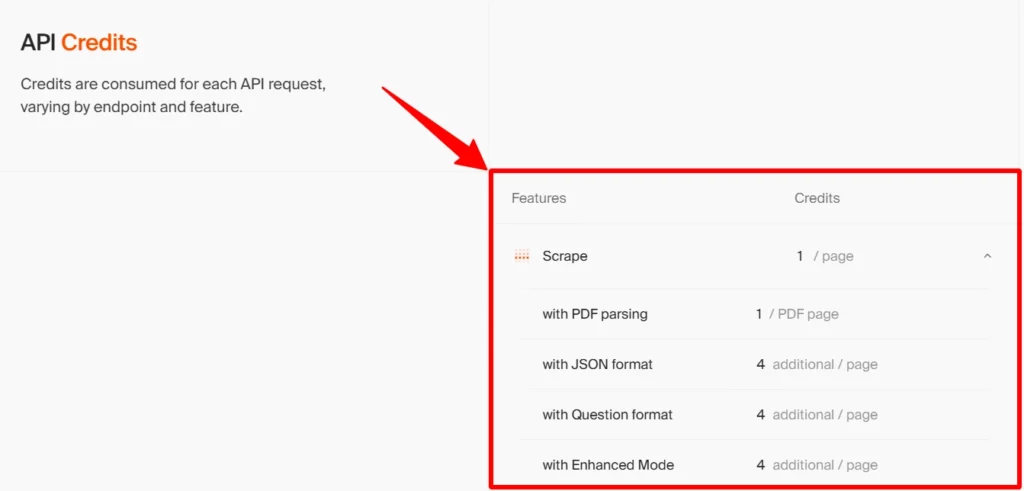
O Firecrawl realiza buscas e coleta dados em troca de um ou dois créditos por solicitação. Em seguida, qualquer modelo econômico, como DeepSeek, um serviço GPT de baixo custo ou Claude, ou qualquer modelo aberto que você execute em seu próprio VPS, faz o resumo e a redação desse conteúdo limpo. A qualidade da resposta é a mesma. Por uma fração do custo.
Isso também funciona maravilhosamente bem para configurações auto-hospedadasEstá usando o Open WebUI ou outra interface de chat de código aberto em um VPS? Conecte o Firecrawl como camada de busca e rastreamento da web e seu servidor auto-hospedado. AI De repente, pesquisas aprofundadas ao vivo se assemelham às dos grandes produtos comerciais.
Dicas de custo: Faça seus 1,000 créditos grátis renderem muito 🪙
Guia rápido para manter o uso enxuto:
| Ação | Custo de Crédito |
|---|---|
| Extrair / Rastrear / Mapear / Monitorar | 1 crédito por página |
| Pesquisar | 2 créditos por cada 10 resultados |
| Interagir (ações do navegador) | 2 créditos por minuto |
| Modo furtivo (locais protegidos) | 5 créditos por página |
Cinco hábitos que importam:
- Faça um esboço antes de começar a explorar. Saiba o número de páginas antes de efetuar o pagamento.
- Sempre definido limitar em rastreamentos. O padrão é de 10,000 páginas. Seu plano gratuito é de 1,000. Faça as contas uma vez, não depois.
- Uso excluirCaminhos Agressivamente. Arquivos de blogs, páginas de tags e páginas de carreiras são verdadeiros depósitos de créditos.
- Armazene em cache os dados que você extrair. Os sites de documentação são atualizados semanalmente, não a cada hora. Armazene os resultados e realize novas buscas de acordo com um cronograma, em vez de a cada solicitação.
- Os créditos não são acumulativos.Portanto, se você fizer um upgrade, escolha o plano de acordo com seu volume mensal real. Os planos pagos começam em US$ 16/mês para 5,000 créditos, e o plano Standard de US$ 83 oferece 100,000 páginas.
Erros comuns (e soluções rápidas) 🛠️
Cinco problemas que explicam praticamente todas as mensagens de "Firecrawl não está funcionando" que recebemos:
E um erro que vale a pena saber: se uma solicitação falhar no Firecrawl's Além disso, você não paga nada por isso.
Respostas rápidas 🎯
Como funciona o Firecrawl?
Você envia uma URL (ou consulta de pesquisa) para a API, e ela retorna o conteúdo em formato Markdown limpo, JSON ou capturas de tela, com renderização em JavaScript e remoção de código indesejado feitas automaticamente. Um crédito por página.
Firecrawl é bom para RAG?
Será a opção padrão em 2026. A saída em Markdown limpa significa blocos de código melhores, incorporações melhores e melhor recuperação de dados, com carregadores oficiais para LangChain e LlamaIndex.
Posso usar o Firecrawl sem programar?
Sim. O conector MCP de um clique integra as funções de raspagem, rastreamento, busca e extração de dados ao Claude, ChatGPT, Perplexity e Cursor, tudo isso controlado por comandos em linguagem natural.
Existe um plano gratuito?
1,000 créditos por mês, com renovação automática, sem necessidade de cartão. Aproveite aqui com 10% de desconto na sua primeira atualização.
Concluindo: Seu agente, agora com olhos 👀
Resumo do que você acabou de aprender:
A lacuna entre um AI agente que adivinha e um AI O agente que conhece a chave da API é um recurso importante. O Firecrawl oferece 1,000 créditos gratuitos por mês para fechá-la, e todos os exemplos deste guia funcionam confortavelmente dentro desse limite.
Você tem uma configuração que utiliza o Firecrawl?
Conte-nos nos comentários. Os melhores projetos dos leitores são apresentados em nossa newsletter. ✌️


 BONUS: Receba nossos $ 200 “AI “Kit de ferramentas de domínio” GRÁTIS ao se inscrever!