Belangrijkste inzichten van Ollama
Wat is Ollama?
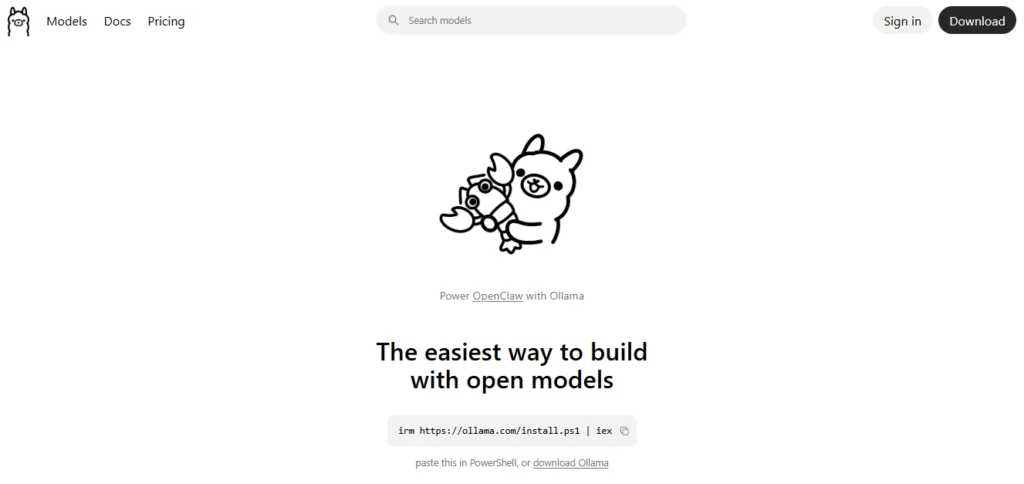
Ollama is een open-source, lokaal LLM-runtimeplatform waarmee ontwikkelaars, onderzoekers en bedrijven grote taalmodellen rechtstreeks op hun eigen hardware kunnen downloaden, beheren en uitvoeren zonder ook maar één token naar een externe server te hoeven sturen. Het bundelt modelgewichten, configuratiebestanden en runtimeafhankelijkheden in één overzichtelijk pakket dat beschikbaar is via een commandoregelinterface en een volledig OpenAI-compatibele REST API op localhost:11434.
Beschouw het als uw persoonlijke AI Inferentieserver zonder facturering per token. Het ondersteunt meer dan 200 open-weight modellen, waaronder Llama 3, Mistral, DeepSeek R1, Gemma 4 en Qwen, draait op macOS, Linux en Windows en integreert met meer dan 40,000 communitytools, waaronder LangChain, LlamaIndex en Open WebUI. Voor elk team of individuele ontwikkelaar die behoefte heeft aan een privéomgeving met beheersbare kosten. AI Hieruit kan worden afgeleid dat Ollama de maatstaf in de branche is.
Ollama biedt een lokaal REST-eindpunt aan op http://localhost:11434/v1 dat een spiegelbeeld is van de OpenAI Chat De structuur van de Completions API is exact hetzelfde. Dit betekent dat u uw volledige LLM-applicatie lokaal kunt bouwen en testen met behulp van de OpenAI SDK, en vervolgens twee omgevingsvariabelen omdraaien om live te gaan in productie. Geen refactoring, geen adapterlagen. Voor API-first ontwikkelaars die agents of automatiseringspipelines bouwen, is dit de grootste tijdsbesparing in de lokale omgeving. AI ruimte.
Ollama's Een modelbestand is het equivalent van een Dockerfile voor LLM's. Je definieert het basismodel, de systeemprompt, inferentieparameters zoals temperatuur en top-p, en de grootte van het contextvenster in één enkel declaratief bestand. Vervolgens bouw je die configuratie en beheer je de versie ervan als een benoemd model. Dit is cruciaal voor teams die reproduceerbaar, projectspecifiek modelgedrag nodig hebben zonder ad-hoc promptontwikkeling tijdens runtime.
Ollama detecteert en benut automatisch NVIDIA CUDA-, AMD ROCM- en Apple Metal GPU-backends om versnelde inferentie op consumentenhardware te leveren. Dit is met name opmerkelijk op Apple Silicon, omdat het uniforme geheugen van de M-serie het mogelijk maakt om grote modellen met 7 tot 13 miljard parameters op de gangbare snelheid van de generatie te draaien zonder een aparte GPU . De tool verplaatst lagen automatisch en intelligent naar GPU VRAM en CPU RAM, waardoor de doorvoer op gemengde hardware wordt gemaximaliseerd.
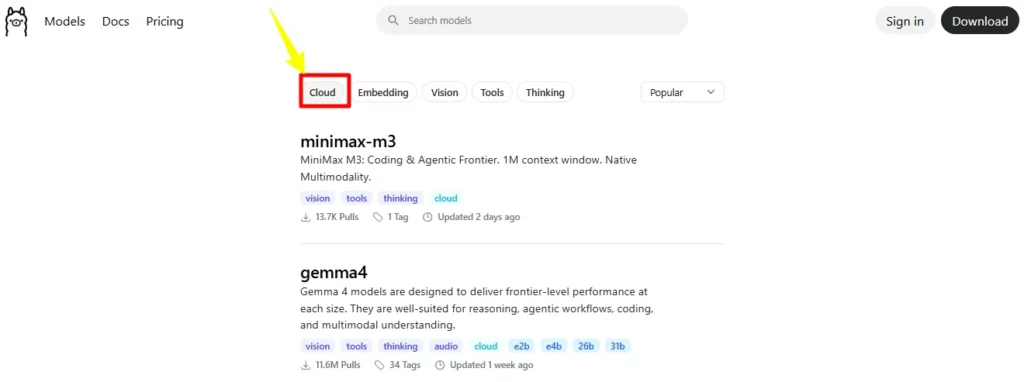
Afgezien van lokale gevolgtrekkingen, Ollama's De cloudlaag biedt ondersteuning voor modellen die worden gehost op de infrastructuur van NVIDIA Cloud Provider, waarbij gebruik wordt gemaakt van native gewichten en versnelde dataformaten, waaronder NVFP4 op de Blackwell-architectuur. Dit geeft gebruikers toegang tot baanbrekende modellen die te groot zijn voor consumentenhardware, met de garantie dat er geen logberichten worden gegenereerd en dat er geen training plaatsvindt met gebruikersgegevens.
Ollama's API-first design heeft geresulteerd in een enorm integratieoppervlak. Het kan direct worden gekoppeld aan code-assistenten, RAG-pipelines via LangChain en LlamaIndex, frontend-GUI's zoals Open WebUI en IDE-extensies. Voor elke ontwikkelaar die AI-native producten bouwt, elimineert deze brede reeks tools de integratiekosten die kleinere, lokale oplossingen met zich meebrengen. AI platforms.
Ollama-prijsplannen
| Plannen | Kosten | Belangrijkste beperkingen en kenmerken |
|---|---|---|
| Gratis | $0 | Onbeperkte lokale inferentie, 1 gelijktijdig cloudmodel, laag cloudgebruik, CLI- en API-toegang, meer dan 40,000 integraties |
| Pro | $ 20 / maand | Alles in de gratis versie, 3 gelijktijdige cloudmodellen, 50x meer cloudgebruik dan in de gratis versie, uploaden en delen via het privémodel. |
| Max | $ 100 / maand | Alles in Pro, 10 gelijktijdige cloudmodellen, 5x meer cloudgebruik dan Pro, geschikt voor continue agenttaken. |
| Team | Binnenkort Beschikbaar | Gedeeld gebruik, gecentraliseerde facturering, SSO, modeltoegangsbeheer, MDM-installatieprogramma, prioriteitsondersteuning |
Ollama voor privacygevoelige sectoren
Zorg-, juridische en financiële teams worden geconfronteerd met strenge eisen op het gebied van gegevensopslag en compliance, waardoor cloudcomputing een uitdaging vormt. AI Het leveren van diensten brengt risico's met zich mee. Ollama elimineert dit risico volledig. Alle gegevensverwerking vindt plaats op uw eigen infrastructuur, wat betekent dat patiëntendossiers, juridische documenten en financiële gegevens uw netwerk nooit verlaten.
In combinatie met bedrijfsbrede modellen zoals Llama 3 of DeepSeek R1, krijgen teams LLM-functionaliteit die voldoet aan interne beveiligingsaudits zonder in te leveren op de kwaliteit van de output. Dit is geen theoretisch voordeel, maar een implementatiemodel dat direct inzetbaar is in productieomgevingen.
Ollama voor agentische en automatiseringsworkflows
Ollama's De ondersteuning voor gelijktijdige uitvoering in de Pro- en Max-abonnementen maakt echte multi-agent-architecturen mogelijk. Door drie of tien cloudmodellen tegelijkertijd te draaien, kunnen orchestratie-frameworks zoals LangGraph of AutoGen gespecialiseerde subagents creëren voor coderen, onderzoek en samenvatting, allemaal parallel.
In combinatie met de OpenAI-compatibele API kunt u orkestratielogica die is geschreven voor elk belangrijk LLM-framework zonder aanpassingen koppelen. Voor ontwikkelaars die autonome pipelines bouwen, vormt dit de infrastructuur die de kosten van de cloud als beperking wegneemt.
Voors en tegens
- OpenAI Directe vervanging voor de API.
- Meer dan 200 open modellen worden ondersteund.
- Werkt volledig offline.
- Snelle automatische GPU-detectie.
- Enorm geïntegreerd ecosysteem.
- Geen gegevensregistratie op de cloudlaag.
- Geen ingebouwde chatinterface.
- Geen native ondersteuning voor het genereren van afbeeldingen.
- Het teamplan is nog niet actief.
Beste alternatieven voor Ollama
| Lokale LLM-runtime | Grootte van de lokale modelbibliotheek | Ontwikkelaars-API en -integratie |
|---|---|---|
| LM Studio | Groter via directe toegang tot Hugging Face | Beperkte API, geen OpenAI-compatibele drop-in. |
| Jan.ai | Gematigd, groeiend ecosysteem | Eenvoudige API, sterke focus op de gebruikersinterface. |
| GPT4 | Bescheiden, zorgvuldig geselecteerde kleine modellen | Beperkte externe integratie |


