
Cakes AI Belangrijkste inzichten
Wat is Fireworks AI?
Vuurwerk AI is een krachtig inferentieplatform dat speciaal is ontwikkeld voor ontwikkelaars en bedrijven die open source-applicaties willen uitvoeren, optimaliseren en schalen. AI modellen met productiesnelheid. Het platform is opgericht door voormalige leden van het PyTorch-team bij Meta en biedt een OpenAI Een compatibele API die toegang biedt tot meer dan 100 populaire, grootschalige taalmodellen, computervisiemodellen en beeldgeneratiemodellen.
Cakes AI Het verlicht de operationele last van het beheren van GPU-infrastructuur door zowel serverloze als on-demand implementatieopties aan te bieden. Bedrijven gebruiken Fireworks. AI om chatbots van stroom te voorzien, coderingsassistentenzoekmachines en agentische AI workflows. De speciaal ontwikkelde inferentie-engine levert tot 4x hogere doorvoer en 50% lagere latentie dan standaard open-source serverstacks, waardoor het een van de snelste is. AI API-aanbieders die vandaag beschikbaar zijn voor generatieve AI productiewerkbelasting.
De eigen inferentie-engine van Fireworks AI is van de grond af aan ontworpen voor snelheid. Deze levert consistent een first token latency van minder dan 100 milliseconden voor een breed scala aan modelgroottes. Voor elke toepassing die realtime respons vereist, zoals klantgerichte chatbots of agentische codeerassistenten , is dit prestatievoordeel meetbaar en significant. Bedrijven zoals Sourcegraph en Notion hebben publiekelijk melding gemaakt van hogere doorvoersnelheden na de migratie naar het platform.
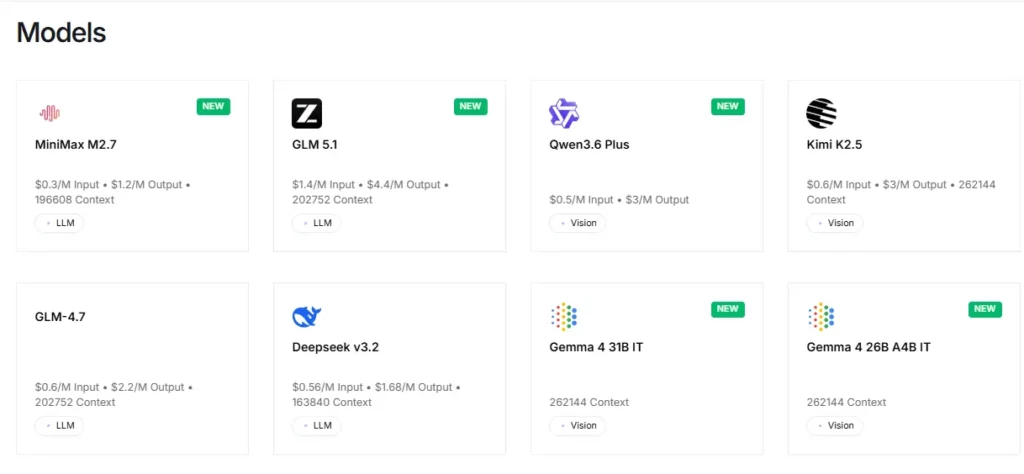
Het platform biedt directe toegang tot meer dan 100 open-source modellen, waaronder Llama, Qwen, DeepSeek, Kimi K2.5, GLM 5, Mixtral en FLUX- beeldgeneratoren . Ontwikkelaars kunnen modellen testen en ertussen wisselen via één API-endpoint, zonder dat er configuratiewijzigingen nodig zijn. Dit maakt snelle prototyping en A/B-testen met verschillende modelfamilies uiterst efficiënt.
Cakes AI Het ondersteunt het volledige scala aan finetuning-methoden, waaronder LoRA, full parameter supervised finetuning, DPO (preference alignment) en reinforcement finetuning. Cruciaal is dat finetuned modellen tegen dezelfde prijs worden aangeboden als basismodellen, waardoor de kostenverhoging die veel concurrenten hanteren, wordt weggenomen. Finetuning van visuele taalmodellen wordt ook ondersteund, waardoor teams multimodale modellen kunnen aanpassen met hun eigen beeld- en tekstdatasets.
Voor werkzaamheden die specifieke resources vereisen, is Fireworks een goede optie. AI aanbiedingen op aanvraag GPU-implementaties De facturering vindt per seconde plaats. Het hardwareaanbod omvat nu NVIDIA A100, H100, H200, B200 en B300 GPU's. Dit geeft engineeringteams de flexibiliteit om privé, geïsoleerde modelinstanties te draaien met gegarandeerde capaciteit en zonder problemen met 'noisy neighbours'.
Fire Pass is een recente toevoeging, een abonnement van $7 per week dat onbeperkte toegang biedt tot tokens voor het Kimi K2.5 Turbo-model met snelheden van ongeveer 200 tot 250 tokens per seconde. Het is speciaal ontworpen voor ontwikkelaars die agentische codeertools zoals Claude Code en OpenCode gebruiken, en biedt een vast tarief als alternatief voor de onvoorspelbare facturering per token.
Cakes AI Betaalbare prijzen
| plannen Naam | Kosten | Belangrijke details |
|---|---|---|
| Serverloos (kleine modellen) | $0.10 per 1 miljoen tokens | Modellen onder 4B-parameters |
| Serverloos (Middenklasse) | $0.20 per 1 miljoen tokens | Parameters van modellen 4B tot en met 16B |
| Serverloos (grote modellen) | $0.90 per 1 miljoen tokens | Modellen met meer dan 16 miljard parameters |
| Serverloos (MoE-modellen) | $0.50 tot $1.20 per 1 miljoen tokens | Mixtrale klasse mengsel van expertmodellen |
| Brandwacht | $ 7 per week | Onbeperkt Kimi K2.5 Turbo-tokens |
| Op aanvraag (H100) | $6.00 per GPU-uur | Facturering per seconde, dedicated instance |
| Op aanvraag (B200) | $9.00 per GPU-uur | GPU van de nieuwste generatie, gefactureerd per seconde. |
| Enterprise | Op Maat | Jaarlijkse kortingen, SLA's en private implementaties |
Aan de slag met Fireworks AI
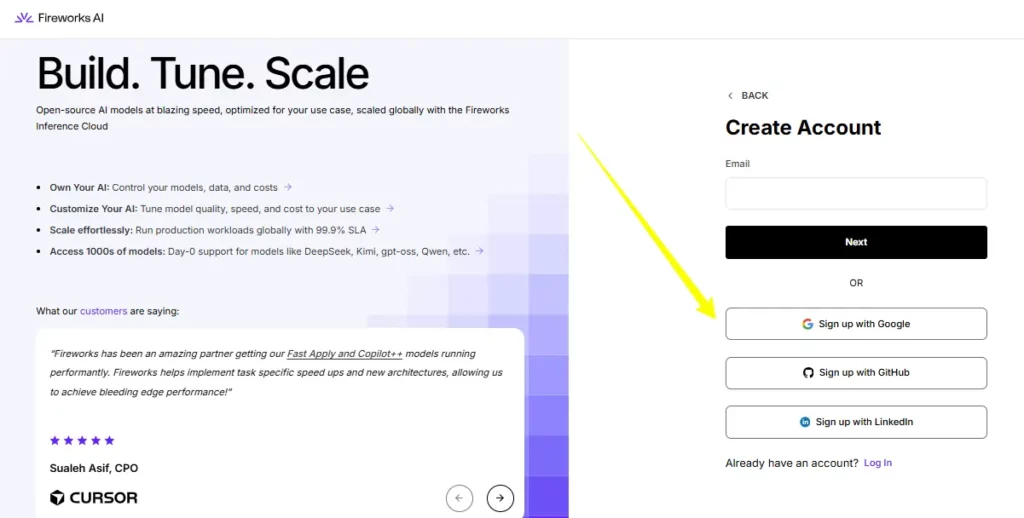
- Stap 1: Maak een account aan fireworks.aiBij aanmelding ontvang je automatisch $1 aan gratis tegoed.
- Stap 2: Ga naar het gedeelte 'API-sleutels' in je dashboard en genereer een nieuwe API-sleutel.
- Stap 3: Installeer de Fireworks Python-client of gebruik een OpenAI compatibele SDK. Stel uw basis-URL in op het Fireworks API-eindpunt.
- Stap 4: Kies een model uit de modelbibliotheek, doe je eerste API-aanroep en volg het gebruik en de facturering vanuit de console.
Voors en tegens
- Toonaangevende inferentiesnelheid in de branche.
- Meer dan 100 open source modellen beschikbaar.
- Een complete afstemmingsprocedure is inbegrepen.
- Fire Pass biedt onbeperkt tokens.
- GPU-hardware van de nieuwste generatie (B300).
- Alleen voor ontwikkelaars, geen codevrij dashboard.
- Geen ingebouwde tools voor bedrijfsworkflows.
- Klantenondersteuning kan traag zijn.
Beste vuurwerk AI Alternatieven
| AI Inferentie- en modelservingplatform | Inferentie-doorvoer | Kostenefficiënt toezicht |
|---|---|---|
| Samen AI | 917 TPS, hogere latentie (0.78s) | Vergelijkbare tarieven per token, minder variatie in GPU's. |
| Groq | 456 TPS via aangepaste LPU's, 0.19s latentie | Lagere instapprijzen, beperkte modelkeuze |
| repliceren | Gemiddelde snelheid, op containers gebaseerd | Eenvoudige facturering per voorspelling, minder fijnafstemming. |
| Baseten | Aanpasbare infrastructuur, gemiddelde snelheid | Flexibel, maar vereist meer configuratie. |


