

Sementara gergasi teknologi berjuang untuk AI penguasaan, Alibaba telah melancarkan gelombang kejutan: model Qwen3. Ini bukan sekadar peningkatan—ia adalah pentakrifan semula potensi AI sumber terbuka.
Dikeluarkan hanya minggu lepas, Qwen3 merangkumi lapan model, daripada versi 600M yang ringan (sesuai untuk komputer riba) kepada a 235B MoE raksasa mengatasi pesaing peringkat teratas seperti TerbukaAI dan Google. Tetapi apa yang membezakan Qwen3 adalah "pemikiran hibrid"—bertukar secara bijak antara penaakulan mendalam dan respons pantas bergantung pada tugasan.
Paling penting? Ia sumber terbuka sepenuhnya. Pembangun di seluruh dunia mendapati Qwen3 boleh menandingi atau mengatasi model premium—pada sebahagian kecil daripada kosnya.
Keluarga Model Qwen3: Saiz untuk Setiap Keperluan
Qwen3 mewakili lonjakan yang ketara ke hadapan AI reka bentuk model, menawarkan fleksibiliti yang tidak pernah berlaku sebelum ini dengan kedua-dua model padat dan Campuran-Pakar (KPM) varian. Di sini's barisan lengkap:
| Nama Model | Jumlah Parameter | Parameter Aktif | Jenis Model | Panjang Konteks |
|---|---|---|---|---|
| Qwen3-235B-A22B | 235 Bilion | 22 Bilion | KPM | 128K token |
| Qwen3-30B-A3B | 30 Bilion | 3 Bilion | KPM | 128K token |
| Qwen3-32B | 32 Bilion | Tidak Berkenaan | padat | 128K token |
| Qwen3-14B | 14 Bilion | Tidak Berkenaan | padat | 128K token |
| Qwen3-8B | 8 Bilion | Tidak Berkenaan | padat | 128K token |
| Qwen3-4B | 4 Bilion | Tidak Berkenaan | padat | 32K token |
| Qwen3-1.7B | 1.7 Bilion | Tidak Berkenaan | padat | 32K token |
| Qwen3-0.6B | 0.6 Bilion | Tidak Berkenaan | padat | 32K token |
Aspek yang paling menarik ialah bagaimana seni bina MoE membolehkan kecekapan yang mengagumkan. Contohnya, model Qwen3-30B-A3B hanya mengaktifkan parameter 3B semasa inferens namun mengatasi banyak model parameter 32B yang aktif sepenuhnya. Reka bentuk pintar ini menawarkan prestasi tinggi tanpa memerlukan sumber pengiraan yang berlebihan.
Penyelidikan mencadangkan model MoE seperti ini boleh memadankan keupayaan model 3-5x saiz aktifnya, menjadikannya sangat kos efektif untuk penggunaan.
Ciri-ciri yang membezakan Model Qwen3
🔄 Mod Pemikiran Hibrid: A First in AI reka bentuk
Qwen3's kebanyakan inovasi tercanggih ialah pendekatan pemikiran dwinya-sesuatu yang tidak ditawarkan oleh keluarga model sumber terbuka lain dengan fleksibiliti sedemikian.
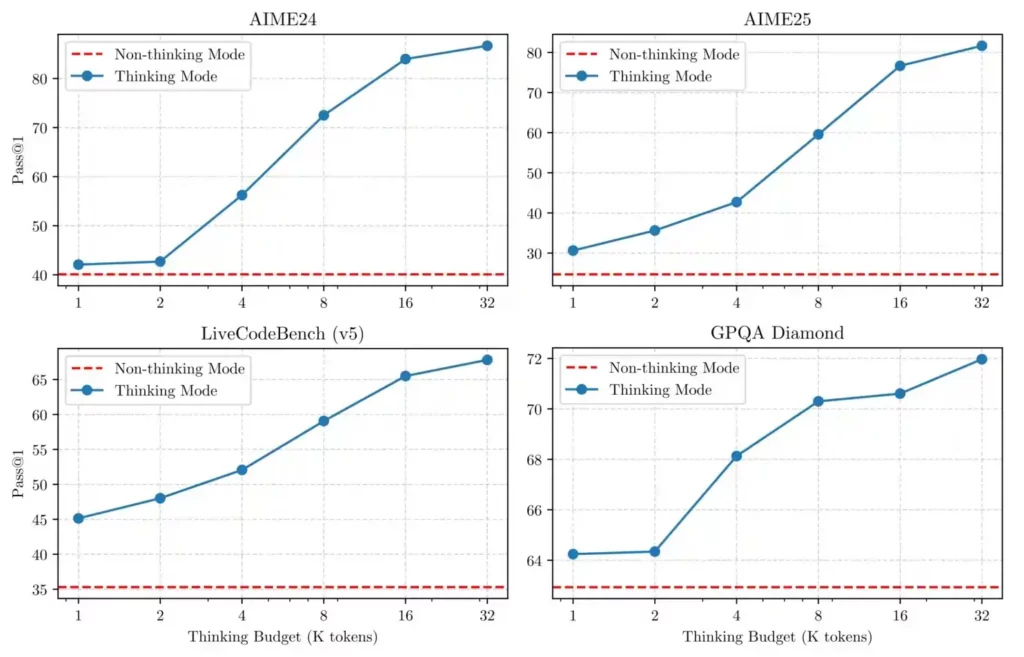
Mod Pemikiran: Apabila berhadapan dengan masalah kompleks yang memerlukan penaakulan berbilang langkah (seperti matematik, pengekodan atau teka-teki logik), Qwen3 mengaktifkan mod pemikirannya. Ini membolehkan penaakulan langkah demi langkah melalui tugasan yang mencabar sebelum memberikan jawapan akhir.
Mod Tanpa Pemikiran: Untuk pertanyaan mudah atau perbualan santai, Qwen3 bertukar kepada mod tanpa pemikiran, memberikan respons yang cepat dan ringkas tanpa overhed pengiraan yang tidak perlu.
Dengan "bajet pemikiran" yang boleh dikawal pengguna, pembangun boleh memperhalusi berapa banyak penaakulan Qwen3 yang digunakan—menghasilkan peningkatan prestasi sehingga 65% pada tugasan seperti matematik lanjutan.
🌍 Penguasaan Berbilang Bahasa Merentasi 119 Bahasa
Walaupun kebanyakan model peringkat teratas tertumpu terutamanya pada bahasa Inggeris, Qwen3 telah dilatih mengenai set data yang luas merangkumi 119 bahasa dan dialek. Sokongan bahasa yang meluas ini menjadikannya amat berharga untuk aplikasi global dan komuniti bahasa yang kurang mendapat perkhidmatan.
Penanda aras dalaman menunjukkan Qwen3-235B-A22B mencapai ketepatan 87% pada tugasan penaakulan kompleks dalam bahasa seperti Arab, Hindi dan Thai—mendekati ketepatan 92% pada tugasan Bahasa Inggeris. Jurang prestasi yang sempit merentasi bahasa ini tidak pernah berlaku sebelum ini dalam kalangan model sumber terbuka.
Keupayaan Agen dan Integrasi Alat
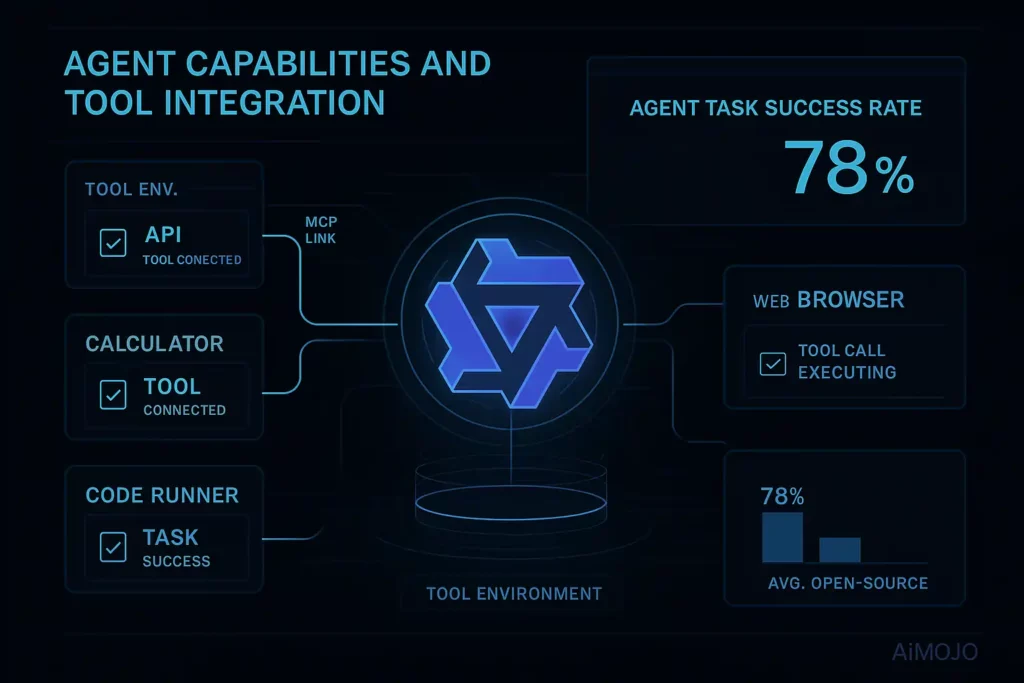
Moden AI aplikasi semakin memerlukan model untuk berinteraksi dengan alat dan sistem luaran. Qwen3 cemerlang dalam domain ini dengan sokongan yang dipertingkatkan untuk Protokol Konteks Model (MCP), kebolehan panggilan alat yang dipertingkatkan dan rangka kerja Qwen-Agent khusus untuk membina ejen pintar.
Ujian oleh pembangun bebas mendedahkan model Qwen3 mencapai 78% kadar kejayaan pada tugas ejen yang kompleks yang memerlukan interaksi alat berbilang-mengungguli banyak pesaing dalam ruang sumber terbuka dengan ketara.
Senibina Teknikal dan Metodologi Latihan
Qwen3's keupayaan mengagumkan berpunca daripada pendekatan latihan yang canggih yang merangkumi tiga fasa yang berbeza:
Proses Pra-Latihan Tiga Peringkat
- Pemerolehan Pengetahuan Asas: Latihan awal mengenai kira-kira 36 trilion token dengan panjang konteks 4K, mewujudkan pemahaman dan pengetahuan bahasa yang luas.
- Peningkatan Tugas Khusus: Latihan tertumpu pada topik STEM, cabaran pengekodan, dan penaakulan yang kompleks tugas untuk membangunkan keupayaan penyelesaian masalah lanjutan.
- Sambungan Konteks Panjang: Latihan akhir dengan data konteks lanjutan untuk membolehkan pengendalian dokumen sehingga 32K token (untuk model yang lebih kecil) atau 128K token (untuk varian yang lebih besar).
Pengoptimuman Selepas Latihan
Selepas pra-latihan awal, Qwen3 menjalani proses selepas latihan empat langkah:

- Permulaan Dingin Rantaian Pemikiran: Latihan dengan contoh penaakulan yang jelas untuk mewujudkan corak pemikiran logik asas.
- Pembelajaran Pengukuhan Berasaskan Penaakulan: Mengoptimumkan model's keupayaan untuk menggunakan penaakulan secara konsisten merentasi pelbagai tugas.
- Gabungan Mod Berfikir: Mengintegrasikan keupayaan untuk bertukar antara pendekatan berfikir dan tidak berfikir.
- Pembelajaran Pengukuhan Am: Penapisan akhir berdasarkan pilihan manusia dan teknik penjajaran.
Metodologi ini menerangkan sebab model Qwen3-4B yang kompak mengungguli banyak pesaing yang lebih besar-ia mendapat manfaat daripada pengetahuan yang disuling daripada model yang lebih besar dalam keluarga.
Penanda Aras Prestasi: Bagaimana Qwen3 Tersusun
Keputusan penanda aras baru-baru ini telah mengejutkan ramai pihak AI penyelidik, dengan model Qwen3 menunjukkan prestasi yang sangat baik terhadap pesaing yang jauh lebih besar.
Perbandingan Model Peringkat Atas
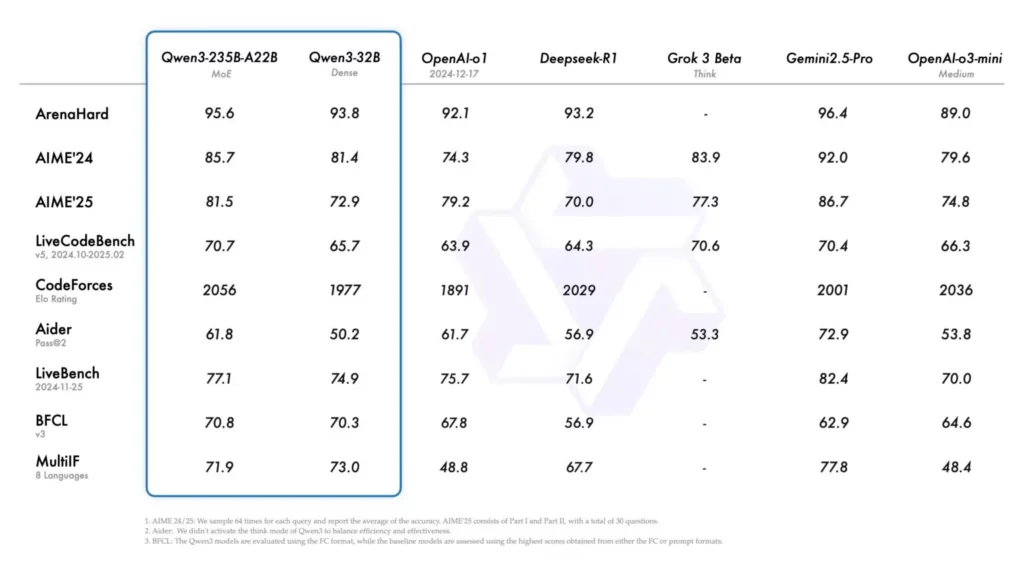
Model perdana Qwen3-235B-A22B menunjukkan hasil yang luar biasa jika dibandingkan dengan peneraju industri:
- Prestasi Pengekodan: Mengetuai penanda aras CodeForces Elo Rating, BFCL dan LiveCodeBench v5, mengatasi prestasi DeepSeek-R1 dan OpenAI sekalipun's o1.
- Matematik: Skor hanya 3.2% di bawah Gemini 2.5 Pro pada penanda aras ArenaHard dan AIME tetapi mencapai ini dengan parameter aktif yang jauh lebih sedikit.
- Penaakulan Umum: Berprestasi dalam 5% daripada GPT-4o pada penanda aras penaakulan kompleks sambil menjadi sumber terbuka sepenuhnya.
Kecekapan Saiz ke Prestasi
Mungkin yang paling mengagumkan ialah model Qwen3 yang lebih kecil berbanding generasi sebelumnya:

- Qwen3-30B-A3B (dengan hanya 3B parameter aktif) mengatasi model QwQ-32B sebelumnya (dengan semua parameter 32B aktif).
- Qwen3-4B memberikan hasil yang setanding dengan model 5× saiznya dari hanya setahun yang lalu.
Dalam ujian perbandingan langsung dengan DeepSeek-R1 , Qwen3 menunjukkan keputusan yang lebih baik dalam tugasan pengekodan dan penstrukturan teks, manakala DeepSeek-R1 mengekalkan sedikit kelebihan dalam masalah matematik yang kompleks.
Prestasi Dunia Sebenar: Melangkaui Penanda Aras
Penanda aras kuantitatif hanya menceritakan sebahagian daripada cerita. Di sini's cara Qwen3 melakukan tugas praktikal dunia sebenar:
Qwen3-30B-A3B mengendalikan masalah fizik lanjutan—seperti relativiti dan pelebaran masa—dengan penyelesaian berstruktur dan tepat. Model 235B-A22B menambah kedalaman, mengesan salah tanggapan dan mencadangkan kaedah alternatif, mempamerkan penaakulan analitikal yang kukuh.


Cara Mengakses dan Menggunakan Qwen3

Semua model Qwen3 adalah berat terbuka di bawah lesen Apache 2.0, menjadikannya boleh diakses untuk kegunaan peribadi dan komersial. Berikut ialah kaedah utama untuk mengakses model ini:
Akses Dalam Talian
- QwenChat: Cara paling mudah untuk mencuba model Qwen3 melalui Alibaba's antara muka web.
- Memeluk Muka: Semua model tersedia pada Muka Memeluk untuk kegunaan terus atau penalaan halus.
- ModelSkop: Menyediakan pilihan penempatan dan dokumentasi tambahan.
- Kaggle: Menawarkan persekitaran buku nota untuk bereksperimen dengan model.
Kerahan Tempatan
Untuk penggunaan tempatan, beberapa rangka kerja menyokong Qwen3:
- Ollama dan LMStudio: Alat mesra pengguna untuk menjalankan model secara tempatan.
- llama.cpp: Pelaksanaan C++ yang cekap untuk prestasi yang dioptimumkan.
- MLX: Pengerahan dioptimumkan Apple Silicon.
- KTransformers: Pilihan penggunaan khusus untuk kes penggunaan tertentu.
Penyerahan Pelayan
Untuk persekitaran pengeluaran, Qwen3 berfungsi dengan:
- SGLang: Dioptimumkan untuk penggunaan pelayan dengan daya pemprosesan yang tinggi.
- vLLM: Menyediakan penyajian yang cekap dengan ciri-ciri canggih seperti batching berterusan.
Aplikasi dan Kes Penggunaan
Qwen3's serba boleh menjadikannya sesuai untuk pelbagai aplikasi:
- Penciptaan Kandungan: Menjana artikel, salinan pemasaran, dan penulisan kreatif.
- Pembangunan perisian: Penjanaan kod, penyahpepijatan dan dokumentasi.
- pendidikan: Mencipta bahan pendidikan dan menjawab soalan yang kompleks.
- Penyelidikan: Membantu kajian literatur dan penjanaan hipotesis.
- Sokongan Pelanggan: Menguasakan chatbot pintar dengan keupayaan penaakulan yang kuat.
- Analisis data: Mentafsir data yang kompleks dan menjana cerapan.
- Penjanaan Pertambahan Pendapatan (RAG): Mencipta sistem pengetahuan yang canggih menggunakan Qwen3's tetingkap konteks dan kebolehan menaakul.
Had Semasa dan Perkembangan Masa Depan
Walaupun keupayaannya yang mengagumkan, Qwen3 mempunyai beberapa batasan:
- Mod berfikir kadangkala boleh menjadi terlalu bertele-tele untuk tugasan mudah.
- Walaupun berbilang bahasa, prestasi masih agak berbeza merentas bahasa.
- Model terbesar memerlukan sumber yang besar walaupun kecekapan MoE meningkat.
Memandang ke hadapan, Alibaba's pelan hala tuju pembangunan mencadangkan beberapa kemungkinan menarik:
- Penyepaduan lanjut dengan keupayaan Qwen3-VL (Visual Language).
- Keluaran model Qwen3-Audio khusus untuk pemprosesan pertuturan.
- Versi Qwen3-Math dipertingkat dioptimumkan untuk aplikasi teknikal dan saintifik.
Kesimpulan: Qwen3's Tempat di AI Landskap
Qwen3 adalah lebih daripada yang lain AI kejatuhan model—ia adalah lompatan strategik ke hadapan dalam AI sumber terbuka.
Dengan inovasi seperti penaakulan hibrid, seni bina MoE yang cekap dan liputan bahasa global, ia dibina untuk skalabiliti dunia sebenar.
Untuk pembangun, penyelidik, dan perniagaan yang mahukan keupayaan terkini tanpa kunci masuk vendor, Qwen3 menawarkan an terbuka, berkuasa dan praktikal alternatif—menguatkan kedudukannya sebagai salah satu daripada 2025's paling penting AI perkembangan.


 BONUS: Dapatkan $200 kamiAI Mastery Toolkit” PERCUMA apabila anda mendaftar!







