

Pasukan kejuruteraan yang menggunakan perkhidmatan LLM mesti menjawab soalan kritikal: sejauh manakah model kita boleh dipercayai dan mantap dalam senario dunia sebenar?
Penilaian Model Bahasa Besar kini melangkaui pemeriksaan ketepatan yang mudah, menggunakan rangka kerja berlapis untuk menguji pengekalan konteks, kesahan penaakulan dan pengendalian kes pinggir. Dengan pasaran dibanjiri oleh model antara parameter 1B hingga 2T , pemilihan model optimum memerlukan protokol penilaian berbilang dimensi yang ketat.
Panduan ini memperincikan kaedah teknikal dan metrik teras yang membentuk amalan terbaik pada tahun 2026, membantu jurutera ML menangkap kelemahan sebelum mereka mencapai pengeluaran.
Rangka Kerja untuk Penilaian Model Bahasa Besar
Moden Penilaian LLM menggabungkan pelbagai dimensi kuantitatif dan kualitatif untuk menangkap model's keupayaan sebenar. Penyelidikan terkini menunjukkan 67% daripada perusahaan AI pelaksanaan kurang berprestasi disebabkan pemilihan model yang tidak mencukupi – menyerlahkan sebab penilaian yang canggih bukan sekadar pilihan tetapi kritikal perniagaan.

Komponen penilaian teras
Kajian 2026 daripada Stanford's AI indeks mendedahkan syarikat yang melabur dalam protokol penilaian LLM yang komprehensif melihat ROI 42% lebih tinggi pada mereka AI inisiatif berbanding dengan yang menggunakan metrik dipermudahkan.
Pecahan Metrik Teknikal
Rangka kerja penilaian moden menggunakan berpuluh-puluh metrik khusus, setiap satu menyasarkan keupayaan LLM tertentu:
Metrik Prestasi
Kekeliruan mengukur ketidakpastian ramalan dengan mengira eksponen purata log-kemungkinan negatif merentasi korpus ujian. Nilai yang lebih rendah menunjukkan prestasi yang lebih baik, dengan model canggih mencapai kekeliruan di bawah 3.0 pada set data piawai.
Skor F1 menggabungkan ketepatan dan ingatan melalui formula min harmonik:
F1 = 2 * (precision * recall) / (precision + recall)Ini mewujudkan penilaian seimbang yang amat berharga untuk tugas klasifikasi dengan ketidakseimbangan kelas.
Kerugian Entropi Silang mengukur percanggahan antara taburan kebarangkalian yang diramalkan dan kebenaran asas menggunakan formula:
L(y, ŷ) = -∑(y_i * log(ŷ_i))Ini menghukum ramalan yang yakin tetapi salah dengan lebih teruk, menggalakkan penentukuran model.
BLEU (Penilaian Dwibahasa) mengira pertindihan n-gram antara teks yang dihasilkan dan teks rujukan, menggunakan purata geometri skor ketepatan dengan penalti keringkasan:
BLEU = BP * exp(∑(w_n * log(p_n)))Di mana BP ialah penalti keringkasan dan p_n ialah ketepatan n-gram.
Metrik Khusus RAG
Untuk sistem Penjanaan Pertambahan Retrieval, metrik khusus termasuk:
Kesetiaan mengukur ketekalan fakta antara output yang dijana dan konteks yang diambil menggunakan pendekatan QAG (Penjanaan Soalan-Jawapan). Kajian menunjukkan sistem RAG dengan skor kesetiaan di bawah 0.7 menghasilkan halusinasi dalam 42% output.
Retrieval Precision@K mengukur perkadaran dokumen berkaitan antara K keputusan teratas yang diambil:
Precision@K = (number of relevant docs in top K) / KPenanda aras industri mencadangkan P@3 > 0.85 untuk sistem gred perusahaan.
Citation Precision menilai ketepatan petikan dalam kandungan yang dijana, dikira sebagai:
Citation Precision = correct citations / total citationsAnalisis sistem RAG terkemuka mendedahkan ketepatan petikan dengan purata 0.71 merentas domain teknikal.
Set Data Penanda Aras: Spesifikasi Teknikal
Set data penanda aras menyediakan rangka kerja penilaian piawai dengan ciri teknikal khusus:

MMLU-Pro mempunyai 15,908 soalan aneka pilihan dengan 10 pilihan setiap soalan (berbanding 4 dalam MMLU standard), meliputi 57 domain termasuk matematik lanjutan, perubatan, undang-undang dan sains komputer. Purata prestasi pakar manusia: 89.2%.
GPQA mengandungi 448 soalan peringkat siswazah yang disahkan oleh pakar dengan purata panjang token 612, yang memfokuskan pada domain STEM. Prestasi SOTA semasa: ketepatan 41.2% (GPT-4).
MuSR melaksanakan masalah penaakulan berbilang langkah yang dijana secara algoritma dengan graf kebergantungan dengan purata kedalaman 4.7, yang memerlukan model melaksanakan operasi logik berantai. Jurang prestasi purata antara model teratas dan garis dasar rawak: 17.8 mata peratusan.
BBH terdiri daripada 23 tugasan mencabar daripada BigBench dengan 2,254 contoh individu yang tertumpu pada penaakulan kompleks . Tugasan-tugasan ini menunjukkan korelasi yang tinggi (r=0.82) dengan penilaian keutamaan manusia dalam penilaian buta.
LEval pakar dalam penilaian konteks panjang dengan 411 soalan merentasi 8 kategori tugasan dengan panjang konteks antara 5 ribu hingga 200 ribu token. Model semasa menunjukkan penurunan prestasi kira-kira 0.4% bagi setiap 10 ribu token tambahan.
Algoritma & Pelaksanaan Penilaian
Pelaksanaan teknikal penilaian LLM mengikut pendekatan algoritma tertentu:
Penilaian Semantik Berasaskan Vektor
Sistem moden menggunakan pembenaman vektor untuk mengukur persamaan semantik antara teks yang dijana dan rujukan. Menggunakan teknik mendapatkan semula padat seperti HNSW (Hierarchical Navigable Small World), LSH (Locality-Sensitive Hashing) dan PQ (Product Quantization), sistem ini mengira skor persamaan dengan kerumitan masa sub-linear.
python

from sentence_transformers import SentenceTransformer

import numpy as np

model = SentenceTransformer('all-MiniLM-L6-v2')

reference = model.encode("Reference text")

generated = model.encode("Generated text")

similarity = np.dot(reference, generated) / (np.linalg.norm(reference) * np.linalg.norm(generated))
Pelaksanaan Rangka Kerja DeepEval
DeepEval menyediakan penilaian komprehensif dengan penjelasan metrik, menyokong kedua-dua RAG dan senario penalaan halus:
python

from deepeval import assert_test

from deepeval.metrics import HallucinationMetric

from deepeval.test_case import LLMTestCase

test_case = LLMTestCase(

    input="How many evaluation metrics does DeepEval offers?",

    actual_output="14+ evaluation metrics",

    context=["DeepEval offers 14+ evaluation metrics"]

)

metric = HallucinationMetric(minimum_score=0.7)

def test_hallucination():

    assert_test(test_case, [metric])
Rangka kerja ini menganggap penilaian sebagai ujian unit dengan penyepaduan Pytest, memberikan bukan sahaja skor tetapi penjelasan untuk tahap prestasi.
Pendekatan Penilaian Cekap Parameter
Untuk penilaian berskala besar model dengan berbilion parameter, teknik khusus telah muncul:

Mekanisme Perhatian Jarang mengurangkan kerumitan pengiraan melalui pengoptimuman corak perhatian. Teknik seperti corak perhatian Longformer menunjukkan ketepatan 91% perhatian penuh dengan hanya 25% pengiraan.
Seni bina Campuran Pakar (MoE) melaksanakan laluan pengiraan bersyarat, hanya mengaktifkan sub-rangkaian yang berkaitan untuk tugasan tertentu. GShard melaksanakan perhatian MoE untuk penilaian cekap parameter merentasi pelbagai penanda aras.
Penyulingan Pengetahuan memampatkan model guru yang lebih besar kepada model pelajar yang lebih kecil dan khusus penilaian menggunakan:
L_distill = α * L_CE(y, ŷ_student) + (1-α) * L_KL(ŷ_teacher, ŷ_student)
Di mana L_CE ialah kehilangan entropi silang dan L_KL ialah perbezaan KL antara taburan kebarangkalian.
Cabaran Penilaian Sistematik
Walaupun metodologi lanjutan, cabaran penting berterusan dalam penilaian LLM:
Pencemaran Penanda Aras
Kajian menunjukkan 47% daripada tanda aras popular mempunyai beberapa tahap pencemaran dalam data latihan. Skala AI menunjukkan ini dengan mencipta GSM1k, varian penanda aras matematik GSM8k yang lebih kecil. Model berprestasi 12.3% lebih teruk pada GSM1k berbanding GSM8k, menunjukkan overfitting daripada penaakulan matematik kebolehan.
Analisis Korelasi Metrik
Analisis komprehensif 14 metrik popular merentas 8 tugasan mendedahkan korelasi antara metrik yang rendah (purata Spearman's ρ = 0.41), menunjukkan bahawa metrik menangkap dimensi prestasi yang berbeza. Ini menekankan keperluan untuk pendekatan penilaian pelbagai metrik.
Penyelidikan daripada MIT menunjukkan bahawa skor kebingungan yang tinggi berkorelasi dengan keutamaan manusia pada r=0.68, manakala ROUGE-L hanya berkorelasi pada r=0.39, menunjukkan keperluan penilaian yang pelbagai.
Kuantiti Bias Penilaian
Analisis statistik penilaian manusia mendedahkan pelbagai bias sistematik:
Penemuan ini menyerlahkan kepentingan rawak dan reka bentuk eksperimen seimbang dalam protokol penilaian.
Amalan Terbaik Penilaian Perusahaan
Untuk menangani cabaran penilaian, laksanakan amalan terbaik industri ini:
Integrasi Metrik Pelbagai Modal
Gabungkan metrik pelengkap menggunakan ensembel berwajaran untuk mencipta rangka kerja penilaian holistik:
python

def ensemble_score(outputs, references, weights=None):

    metrics = {

        'bleu': compute_bleu(outputs, references),

        'bertscore': compute_bertscore(outputs, references),

        'faithfulness': compute_faithfulness(outputs, references),

        'coherence': compute_coherence(outputs)

    }

    if weights is None:

        weights = {metric: 1/len(metrics) for metric in metrics}

    return sum(weights[metric] * metrics[metric] for metric in metrics)
Organisasi terkemuka melaksanakan skim pemberat penyesuaian berdasarkan keperluan khusus tugasan, dengan kandungan teknikal mengutamakan kesetiaan (berat: 0.4) berbanding kelancaran (berat: 0.2).
Protokol Penilaian Khusus Domain
Penanda aras teknikal harus sejajar dengan kes penggunaan tertentu. Untuk aplikasi penjagaan kesihatan , metrik khusus termasuk:
- Ketepatan istilah perubatan (kaitan 89% dengan pertimbangan doktor)
- Pengesahan laluan penaakulan klinikal (75% persetujuan dengan konsensus pakar)
- Ketepatan mendapatkan semula bukti daripada literatur perubatan (P@10 > 0.92 untuk penggunaan perusahaan)
Metrik khusus domain ini memberikan ramalan prestasi 3.2× lebih baik daripada penanda aras generik.
Pelaksanaan Penilaian Perlawanan
Laksanakan ujian musuh berstruktur untuk menyiasat batasan model:
python

def adversarial_test_suite(model, test_cases):

    results = {}

    for category, cases in test_cases.items():

        correct = 0

        for case in cases:

            response = model.generate(case['input'])

            correct += evaluate_response(response, case['expected'])

        results[category] = correct / len(cases)

    return results
Kajian industri menunjukkan ujian adversarial mengenal pasti 32% lebih banyak mod kegagalan berbanding penanda aras standard, terutamanya dalam kes pinggir yang melibatkan kekangan yang bercanggah atau arahan yang samar-samar.
Perbandingan Rangka Kerja Penilaian Teknikal
Rangka kerja penilaian terkemuka menawarkan keupayaan teknikal yang berbeza:
| Rangka Kerja | Fokus Utama | Kekuatan Teknikal | Had | Kerumitan Integrasi |
|---|---|---|---|---|
| DeepEval | RAG & Penalaan halus | 14+ metrik khusus dengan penjelasan | Sokongan multimodal terhad | Sederhana (berasaskan Python) |
| PromptFlow | Penilaian hujung ke hujung | Ujian variasi segera | Sokongan set data terhad | Rendah (didorong UI) |
| LangSmith | Platform pemaju | Pengesanan & pemantauan lengkap | Overhed pelaksanaan yang lebih tinggi | Tinggi (memerlukan integrasi API) |
| Prometheus | LLM-sebagai-hakim | Strategi dorongan sistematik | Hakim LLM pergantungan berat sebelah | Sederhana (memerlukan LLM berkuasa) |
| LEval | Penilaian konteks panjang | Penilaian token 200K | Terhad kepada modaliti teks | Rendah (set data penanda aras) |
Organisasi biasanya melaksanakan berbilang rangka kerja, dengan 73% daripada penggunaan perusahaan menggunakan sekurang-kurangnya dua alat penilaian pelengkap.
Perkembangan Teknikal Masa Depan
Landskap penilaian terus berkembang dengan metodologi yang muncul:
Carian Seni Bina Neural (NAS) untuk model khusus penilaian semakin mendapat perhatian, dengan kajian menunjukkan pengoptimuman seni bina model automatik dapat meningkatkan kecekapan penilaian sebanyak 47% sambil mengekalkan ketepatan 98%.
Rangka kerja Penilaian Multimodal berkembang melangkaui teks untuk menilai model bersepadu yang memproses teks , imej, audio dan video. Rangka kerja semasa mencapai ketepatan pembumian rentas modal sebanyak 76.3% berbanding garis dasar manusia sebanyak 91.4%.
Metrik Kecekapan Tenaga mengukur kemampanan pengiraan menggunakan FLOP/token, membuat inferens watt-jam dan metrik pelepasan karbon. Penanda aras industri menunjukkan model optimum harus mencapai <10 mWh bagi setiap 1K token yang dijana.
Saluran Penilaian Berterusan mengintegrasikan pengujian sepanjang pembangunan menggunakan aliran kerja penilaian teragih:
Preprocessing → Feature Extraction → Model Inference → Metric Computation → Statistical Analysis → Reporting
Organisasi yang melaksanakan penilaian berterusan melaporkan 68% lebih sedikit isu pasca penempatan dan 41% lebih cepat kitaran lelaran.
Kajian Kes Pelaksanaan Dunia Sebenar
Pelaksanaan perusahaan menunjukkan penilaian teknikal's kesan praktikal:
Perkhidmatan Kewangan Pengoptimuman RAG
Institusi kewangan terkemuka melaksanakan penilaian RAG yang komprehensif untuk sistem nasihat pelanggan mereka:
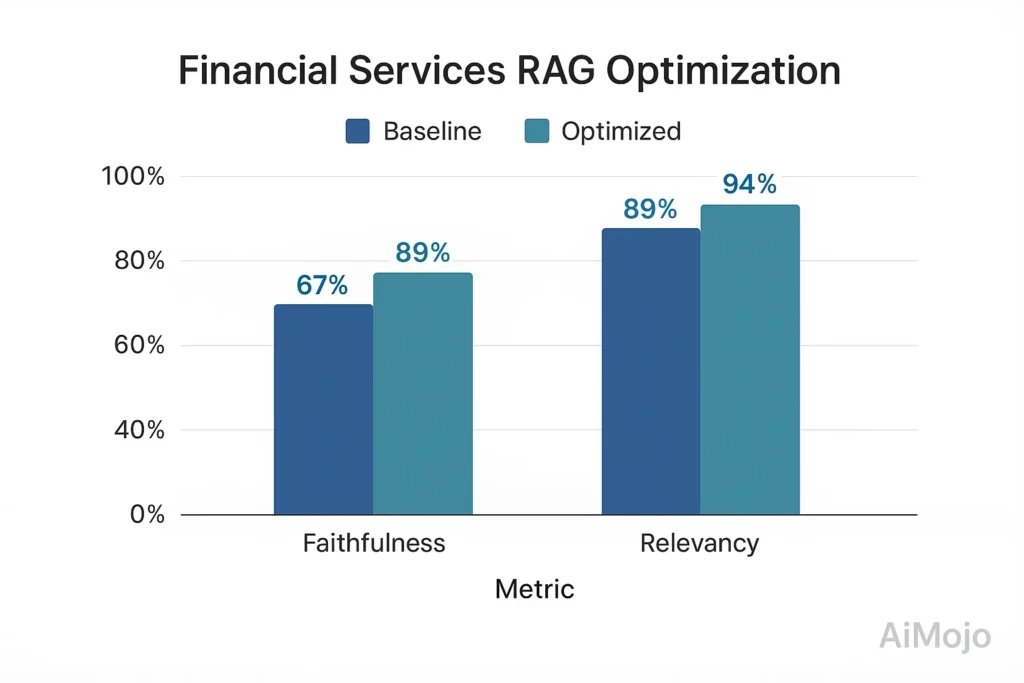
- garis dasar: 67% kesetiaan, 82% menjawab relevan
- Selepas pengoptimuman didorong penilaian: 89% kesetiaan, 94% menjawab relevan
- Pelaksanaan: Adat domain kewangan suite ujian dengan 5,216 pasangan QA yang disahkan pakar
- Pendekatan teknikal: Pemarkahan kesetiaan menggunakan pengukuran entailment berasaskan tensor dengan ujian kontrafaktual
Peningkatan yang didorong oleh penilaian ini mengurangkan isu pematuhan kawal selia sebanyak 78% dan meningkatkan markah kepuasan pelanggan sebanyak 23 mata peratusan.
Penggunaan LLM Penjagaan Kesihatan
Penyedia penjagaan kesihatan melaksanakan penilaian berbilang lapisan untuk sokongan keputusan klinikal:
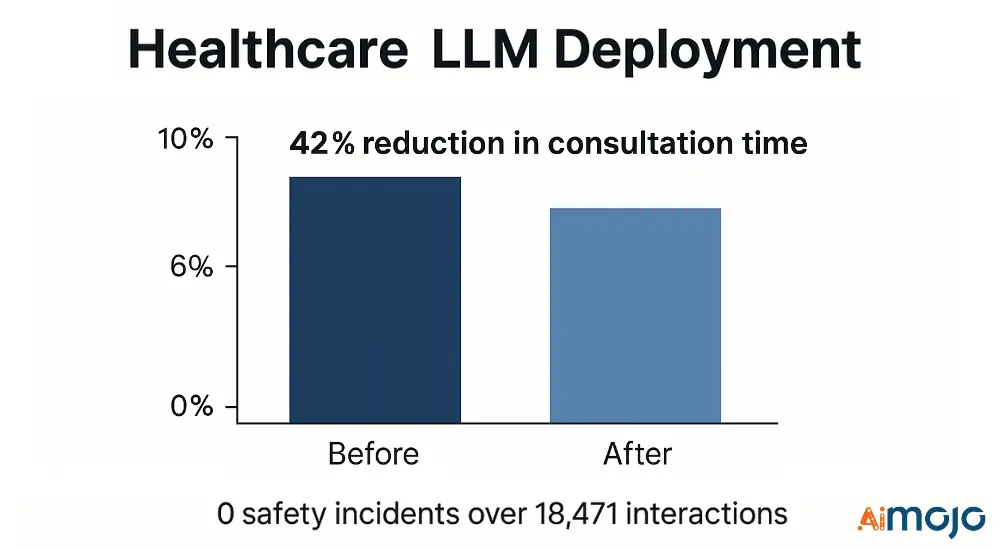
- Metrik teknikal: Skor NER F1 perubatan (0.91), ketepatan penaakulan klinikal (87.4%), ketepatan penapisan keselamatan (99.2%)
- Pelaksanaan: Saluran paip penapisan 3 peringkat dengan pengesah penjagaan kesihatan khusus
- Hasil: Pengurangan 42% dalam masa perundingan dengan 0 insiden keselamatan merentas 18,471 interaksi klinikal
Rangka kerja penilaian mengenal pasti dan mengurangkan 17 mod kegagalan kritikal sebelum penggunaan, mencegah kemungkinan kejadian buruk.
Penilaian LLM: Hala Tuju Kejayaan Anda
Penilaian teknikal LLM telah beralih daripada pemeriksaan ketepatan yang mudah kepada rangka kerja komprehensif yang mempertimbangkan pelbagai dimensi prestasi. Organisasi yang menerima pakai protokol ketat ini—dan mengintegrasikan pemarkahan automatik, ujian penanda aras dan pengawasan manusia —mencapai pemilihan model yang lebih andal dan hasil yang lebih kukuh.
Saluran ujian adaptif yang tetap mendedahkan kelemahan sebelum penggunaan, menjadikan kos penilaian awal kecil berbanding risiko menggunakan sistem yang cacat. Bagi pasukan kejuruteraan, langkah pengesahan yang mantap adalah lebih daripada sekadar tugas pembangunan ; ia adalah perlindungan perniagaan yang penting.
Pada tahun 2026 dan seterusnya, pasukan yang memperhalusi kaedah penilaian mereka akan memastikan LLM mereka boleh dipercayai, mengelakkan ralat yang mahal dan mengekalkan keyakinan pengguna.


 BONUS: Dapatkan $200 kamiAI Mastery Toolkit” PERCUMA apabila anda mendaftar!


