Turmae machinationis quae officia LLM adhibent quaestioni criticae respondere debent: quam fidum et robustum est exemplar nostrum in condicionibus vitae realis?
Aestimatio Exemplar Linguarum Magnarum (vel Magnarum) nunc ultra simplices probationes accuratae progreditur, structuras stratificatas adhibens ad retentionem contextus, validitatem ratiocinationis, et tractationem casuum extremorum examinandam. Cum forum exemplis ab parametris 1B ad 2T inundatum sit , selectio exemplaris optimi protocolla aestimationis rigorosa et multidimensionalia requirit.
Hic dux methodos technicas et mensuras fundamentales, quae optimas consuetudines anno 2026 formant, explicat, adiuvans ingeniarios machinationis automaticae (ML) vitia deprehendere antequam ad productionem perveniant.
Structurae ad Aestimationem Exemplorum Linguae Magnae
Modern LLM iudicium plura complectitur dimensiones quantitativas et qualitativas exemplar capere's verae facultates. Investigationes recentes ostendunt 67% societatum AI Distributiones propter delectum exemplaris insufficiens minus quam agunt – quod illustrat cur aestimatio subtilis non solum voluntaria sed etiam necessaria sit negotiis.

Partes aestimationis principales
A 2026 e studio Stanford's AI Index revelat societates in protocollis aestimationis LLM comprehensivis pecunias collocantes reditum investitionis 42% maius in suis videant. AI initiativa comparata cum illis quae mensuras simpliciores utuntur.
Analysis Metricarum Technicarum
Modernae rationes aestimationis plurimas mensuras speciales adhibent, quarum unaquaeque facultates LLM specificas spectat:
Metrics
Perplexitas incertitudinem praedictionis quantificat per exponentialem verisimilitatum logarithmicam negativam mediam per corpus probationis computandam. Valores inferiores meliorem efficaciam indicant, cum exemplaria artis recentissimae perplexitatem infra 3.0 in collectionibus datorum normatis assequuntur.
Punctum F1 praecisionem et revocationem per formulam mediae harmonicae coniungit:
F1 = 2 * (precision * recall) / (precision + recall)Hoc aestimationem aequilibratam creat, quae praecipue utilis est ad munera classificationis cum inaequalitate classium.
*Amissio Entropiae Cruciatae* discrepantiam inter distributiones probabilitatis praedictas et veritatem fundamentalem formula hac metitur:
L(y, ŷ) = -∑(y_i * log(ŷ_i))Hoc praedictiones certas sed falsas gravius punit, calibrationem exemplaris promovens.
BLEU (Bilingual Evaluation Understudy) superpositionem n-grammatum inter textus generatos et textus referentes computat, media geometrica notarum praecisionis cum poena brevitatis utens:
BLEU = BP * exp(∑(w_n * log(p_n)))Ubi BP est poena brevitatis et p_n est praecisio n-grammatum.
Metricae RAG-Specificae
Pro systematibus Recuperationis Augmentatae Generationis, mensurae speciales includunt:
Fidelitas quantificat congruentiam rerum inter exitum generatum et contextum receptum utens methodis QAG (Generationis Quaestionum et Responsionum). Investigationes ostendunt systemata RAG cum punctis fidelitatis infra 0.7 hallucinationes producere in 42% exitorum.
Retrieval Precision@K proportionem documentorum pertinentium inter optimos K eventus recuperatos metitur:
Precision@K = (number of relevant docs in top K) / KIndicationes industriales P@3 > 0.85 pro systematibus gradus magnarum societatum suggerunt.
Praecisio Citationis (vel Praecisio Citationis) accuratiam citationum in contento generato aestimat, sic computata:
Citation Precision = correct citations / total citationsAnalysis systematum RAG praecipuorum ostendit praecisionem citationum mediam 0.71 esse per omnes disciplinas technicas.
Datasets Comparationis: Specificationes Technicae
Datasets comparativi structuras aestimationis normatas cum certis notis technicis praebent:

MMLU-Pro 15 908 quaestiones multiplices electionis cum 10 optionibus per quaestionem (contra 4 in MMLU communi) praebet, 57 disciplinas comprehendens, inter quas mathematica provectior, medicina, ius, et scientia computatralis. Media peritia humana peritorum: 89.2%.
GPQA continet 448 quaestiones graduatas a peritis verificatas, cum longitudine media tesserarum 612, in campis STEM intendens. Praesens effectus SOTA: accuratio 41.2% (GPT-4).
MuSR problemata ratiocinationis multi-gradualis algorithmice generata cum graphis dependentiae profunditatis mediae 4.7 implementat, postulans ut exempla operationes logicas concatenatas perficiant. Discrepantia media perfunctionis inter exempla optima et lineam basalem fortuitam: 17.8 puncta percentuali.
BBH viginti tres exercitia difficilia ex BigBench comprehendit, cum duobus milibus ducentis quinquaginta quattuor exemplis singularibus, quae in ratione complexa versantur . Haec exercitia magnam correlationem (r=0.82) cum aestimationibus praeferentiarum humanarum in aestimationibus caecis ostendunt.
LEval in aestimatione longi contextus peritus est, cum 411 quaestionibus per 8 categorias operum, quarum longitudines contextus a 5K ad 200K tesseras variant. Modela currentes degradationem perfunctionis circiter 0.4% per 10K tesseras additas ostendunt.
Algorithmi Aestimationis et Implementatio
Implementatio technica aestimationis LLM modos algorithmicos specificos sequitur:
Aestimatio Semantica Vectoribus Fundata
Systema moderna insertiones vectorales adhibent ad similitudinem semanticam inter textus generatos et textus referentiales metiendam. Utentibus densis artibus recuperationis, velut HNSW (Hierarchical Navigable Small World), LSH (Locality-Sensitive Hashing), et PQ (Product Quantization), haec systemata indices similitudinis cum complexitate temporali sublineari computant.
python

from sentence_transformers import SentenceTransformer

import numpy as np

model = SentenceTransformer('all-MiniLM-L6-v2')

reference = model.encode("Reference text")

generated = model.encode("Generated text")

similarity = np.dot(reference, generated) / (np.linalg.norm(reference) * np.linalg.norm(generated))
Implementatio Systematis DeepEval
DeepEval aestimationem comprehensivam cum explicationibus metricis praebet, et RAG et scenaria subtiliter adaptata sustinens:
python

from deepeval import assert_test

from deepeval.metrics import HallucinationMetric

from deepeval.test_case import LLMTestCase

test_case = LLMTestCase(

    input="How many evaluation metrics does DeepEval offers?",

    actual_output="14+ evaluation metrics",

    context=["DeepEval offers 14+ evaluation metrics"]

)

metric = HallucinationMetric(minimum_score=0.7)

def test_hallucination():

    assert_test(test_case, [metric])
Hoc schema aestimationes tamquam probationes unitarias cum integratione Pytest tractat, non solum notas sed etiam explicationes pro gradibus perfunctionis praebens.
Modi Aestimationis Parametro-Efficientes
Ad magnam aestimationem exemplorum cum miliardibus parametrorum, rationes speciales exortae sunt:

Mechanismi Attentionis Rarae complexitatem computationalem per optimizationem exemplorum attentionis minuunt. Technicae sicut exempla attentionis Longformer ostendunt 91% accuratiam plenae attentionis cum tantum 25% computationis.
Architecturae Mixturae Peritorum (MoE) vias computationis conditionales implementant, solum subretia pertinentia ad opera specifica activantes. GShard attentionem MoE ad aestimationem parametrorum efficientem per varia criteria efficit.
Distillatio Scientiae maiora exempla magistrorum in minora, ad aestimationem propria, exempla discipulorum comprimit utens:
L_distill = α * L_CE(y, ŷ_student) + (1-α) * L_KL(ŷ_teacher, ŷ_student)
Ubi L_CE est damnum entropiae transversalis et L_KL est KL-divergentia inter distributiones probabilitatis.
Difficultates Aestimationis Systematicae
Quamvis methodologiae provectiores sint, difficultates magnae in aestimatione LLM manent:
Contaminatio Benchmark
Studia ostendunt 47% probationum popularium aliquem gradum contaminationis in datis exercitationis habere. AI Hoc demonstravit creando GSM1k, minorem varietatem probationis mathematicae GSM8k. Modela 12.3% peius in GSM1k quam in GSM8k se praebuerunt, quod indicat superaptationem potius quam... mathematicam rationem facultatem.
Analysis Correlationis Metricae
Analysis comprehensiva quattuordecim mensurarum popularium per octo munera correlationem inter mensuras humilem ostendit (Spearman media).'s ρ = 0.41), quod indicat mensuras diversas dimensiones perfunctionis comprehendere. Hoc necessitatem rationum aestimationis multi-metricarum illustrat.
Investigationes ab MIT factae ostendunt altas perplexitatis notas cum humanis praeferentiis congruere apud r=0.68, dum ROUGE-L tantum apud r=0.39 correlat, quod diversa requisita aestimationis indicat.
Quantificatio Praeiudicium Aestimationis
Analysis statistica aestimationum humanarum multiplices errores systematicos ostendit:
Haec inventa momentum randomizationis et designii experimentalis aequilibrati in protocollis aestimationis illustrant.
Optimae Praxes Aestimationis Negotiorum
Ad difficultates aestimationis superandas, has optimas rationes industriales adhibe:
Integratio Metrica Multimodalis
Metrica complementaria coniunge utens coetibus ponderatis ad structuras aestimationis holisticas creandas:
python

def ensemble_score(outputs, references, weights=None):

    metrics = {

        'bleu': compute_bleu(outputs, references),

        'bertscore': compute_bertscore(outputs, references),

        'faithfulness': compute_faithfulness(outputs, references),

        'coherence': compute_coherence(outputs)

    }

    if weights is None:

        weights = {metric: 1/len(metrics) for metric in metrics}

    return sum(weights[metric] * metrics[metric] for metric in metrics)
Societates praestantes rationes ponderis adaptivas, secundum requisita propria muneris, adhibent, ubi contenta technica fidelitatem (pondus: 0.4) prae fluentia (pondus: 0.2) praeferunt.
Protocolla Aestimationis Dominio-Specifica
Indices technici cum casibus usus specificis congruere debent. Pro applicationibus curandae valetudinis , mensurae speciales includunt:
- Accuratio terminologiae medicae (correlatio 89% cum iudicio clinico)
- Validatio viae rationis clinicae (consensus peritorum 75%)
- Praecisio recuperationis testimoniorum ex litteris medicis (P@10 > 0.92 pro usu negotiorum)
Hae mensurae singulis dominiis propriae praedictionem perfunctionis 3.2× meliorem quam mensurae generales praebent.
Implementatio Aestimationis Adversarialis
Experimenta adversaria structurata adhibe ut limites exemplaris investiges:
python

def adversarial_test_suite(model, test_cases):

    results = {}

    for category, cases in test_cases.items():

        correct = 0

        for case in cases:

            response = model.generate(case['input'])

            correct += evaluate_response(response, case['expected'])

        results[category] = correct / len(cases)

    return results
Investigationes industriales ostendunt probationes adversarias 32% plures modos defectus quam aestimatio comparativa consueta identificare, praesertim in casibus extremis quae restrictiones conflictantes vel instructiones ambiguas implicant.
Comparatio Schematum Aestimationis Technicae
Primaria aestimationis structurae varias facultates technicas offerunt:
| Framework | Focus primarius | Technical virtus: | Limitata | Integration Complexity |
|---|---|---|---|---|
| DeepEval | RAG et subtilitas | Plus quam quattuordecim mensurae speciales cum explicationibus | Subsidium multimodale limitatum | Medium (Python fundatum) |
| PromptFlow | Aestimatio ab initio ad finem | Probatio variationis prompta | Sustentatio limitata datorum | Humilis (a UI impulsus) |
| LangSmith | Elit diam | Completa investigatio et observatio | Sumptus implementationis altiores | Altum (integrationem API requirit) |
| Prometheum | LLM-ut-iudex | Strategiae systematicae adhortationis | Dependentia praejudicii Iudicis LLM | Medium (potens LLM requirit) |
| LEval | Aestimatio longi contextus | Aestimatio tesserae 200K | Ad modum textus limitatum | Humilis (congeries datorum comparativorum) |
Societates typice plura schemata instituunt, cum 73% dispositionum societatum saltem duo instrumenta aestimationis complementaria utantur.
Progressus Technici Futuri
Prospectus aestimationis cum methodis emergentibus evolvi pergit:
Investigatio Architecturae Neuralis (NAS) pro exemplaribus aestimationi propriis momentum incipit, cum investigatio ostendat optimizationem architecturae exemplaris automatam efficacitatem aestimationis 47% augere posse, dum 98% accurationis servatur.
Rationes aestimationis multimodalis ultra textum se extendunt ad exempla unificata quae textum , imagines, sonum et video tractant aestimanda. Rationes hodiernae praecisionem fundamentalem transmodalem 76.3% assequuntur, comparatae cum lineamentis humanis 91.4%.
Mensurae Efficientiae Energiae sustentationem computationalem quantificant utens FLOP/tessera, inferendo horas-vatio, et mensuras emissionum carbonis. Comparationes industriales suggerunt optima exempla consequi debere <10 mWh per 1 tesseras generatas.
Canales Aestimationis Continuae probationes per totam progressionem integrant utens fluxibus aestimationis distributis:
Preprocessing → Feature Extraction → Model Inference → Metric Computation → Statistical Analysis → Reporting
Societates quae aestimationem continuam instituunt, 68% pauciores difficultates post distributionem et 41% celeriores cyclos iterationis referunt.
Studia Casuum Implementationis in Mundo Reali
Implementationes societatum aestimationem technicam demonstrant.'s effectus practicus:
Optimizatio RAG Servitiorum Pecuniariorum
Institutum pecuniarium praestans aestimationem RAG comprehensivam pro systemate suo consiliorum clientibus oblato instituit:
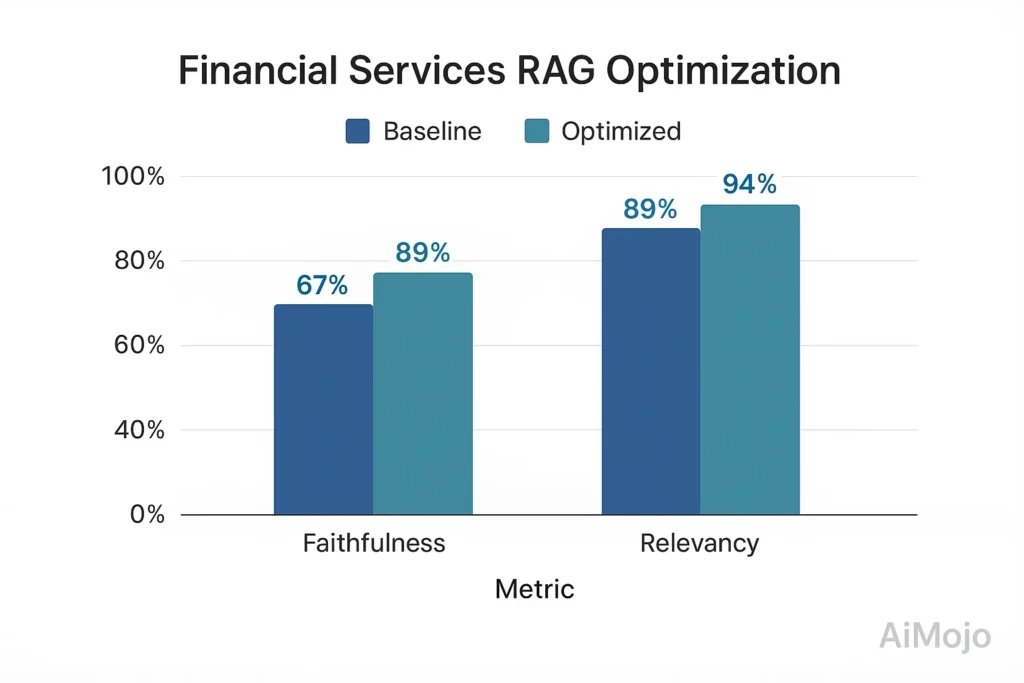
- Baseline: Fidelitas 67%, pertinentia responsorum 82%
- Post optimizationem aestimatione impulsam: Fidelitas 89%, pertinentia responsorum 94%
- implementation: Custom dominium pecuniarium series probationum cum 5,216 paribus QA a peritis verificatis
- Modus technicus: Aestimatio fidelitatis utens mensura implicationis tensoriali cum probatione contrafactuali.
Haec emendatio, aestimatione impulsa, quaestiones obsequii legibus ordinatis 78% minuit et indices satisfactionis clientium 23 punctis percentualibus auxit.
Curae Sanitatis LLM Distributio
Curator valetudinis aestimationem multistratificatam ad decisiones clinicas adiuvandas instituit:
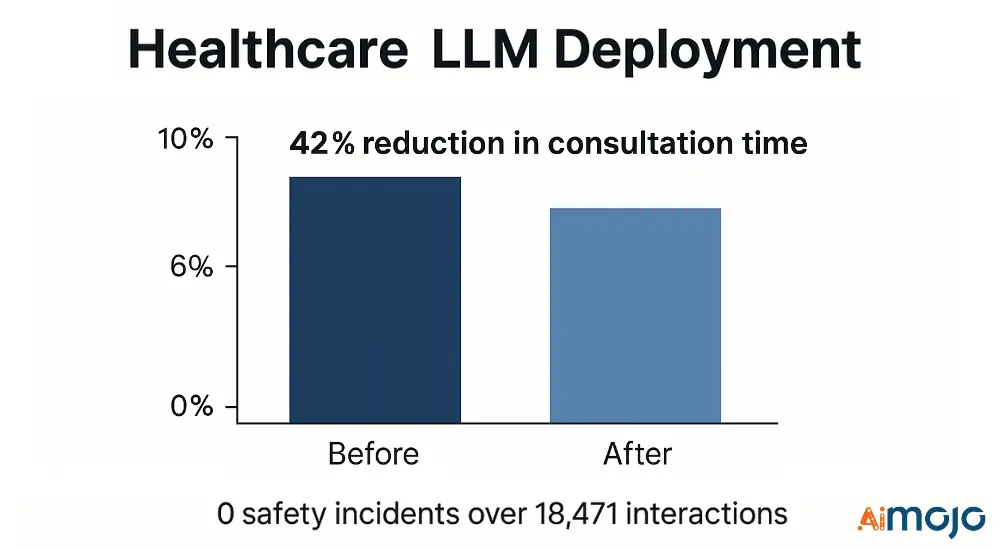
- Mensurae technicae: Punctum NER F1 medicum (0.91), accuratio rationis clinicae (87.4%), praecisio filtrationis securitatis (99.2%).
- implementation: Canalis filtrationis trium graduum cum validatoribus curationis valetudinis specialibus
- eventus: 42% reductio temporis consultationis cum nullis incidentibus salutis per 18,471 interactiones clinicas
Schema aestimationis septemdecim modos defectus critici ante usum identificavit et mitigavit, eventus adversos potentiales prohibens.
Aestimatio LLM: Via ad Successum
Aestimatio technica LLM a simplicibus probationibus accuratiae ad structuras comprehensivas quae multiplices dimensiones perfunctionis ponderat, progressa est. Societates quae haec protocolla rigorosa adoptant – et aestimationem automaticam, probationes comparativas, et supervisionem humanam integrant – selectionem exemplorum certiorem et exitus validiores consequuntur.
Series probationum regulares et adaptabiles vitia ante usum revelant, ita ut sumptus aestimationis initialis parvi sint, comparati cum periculis systematis vitiosi. Pro manipulis ingeniariis, gradus validationis robusti plus quam officia progressionis sunt ; sunt praesidia necessaria negotiorum.
Anno 2026 et ultra, turmae quae methodos aestimationis suas expoliant, suas LLMs fidissimas servabunt, errores sumptuosos vitabunt, et fiduciam usorum conservabunt.


 BONUS: Accipe ducentos nostros dollariis.AI "Instrumentarium Peritiae" GRATIS cum te inscribis!