

Fish Audio Key Insights
Audio di pesce is an AI generatore vocale per trasformare il testo in parlato, riproducendo un oratore autorizzato's voce e l'aggiunta di output vocale al software. È utile per i creatori che desiderano una voce fuori campo senza registrare ogni singola battuta, ma gli strumenti per sviluppatori sono altrettanto importanti: generazione del discorsoLa trascrizione, lo streaming audio e gli identificatori vocali persistenti sono disponibili tramite API.
A mio avviso, Fish Audio merita attenzione per i suoi controlli vocali espressivi, piuttosto che per la promessa che ogni clip generata suonerà come una voce umana.
La prova pratica è più difficile: riesci a mantenere una voce riconoscibile per tutta la durata di una lezione di 20 minuti, a pronunciare correttamente i nomi dei prodotti, a cambiare lingua senza perdere la propria identità e a prevedere i costi con l'aumento dell'utilizzo? Ho valutato queste domande in base ai controlli del prodotto, alla documentazione tecnica, ai prezzi e alle condizioni di licenza attuali. Le linee guida sul flusso di lavoro riportate di seguito rappresentano la mia valutazione della produzione, non una dichiarazione di benchmark audio privati.
Cos'è Fish Audio e chi ha effettivamente bisogno dei suoi modelli vocali?
Fish Audio è una piattaforma vocale basata su browser e accessibile tramite API sviluppata da Hanabi AI Inc. La sua capacità centrale è sintesi vocaleFornire uno script, selezionare una voce e generare un file audio. La clonazione vocale aggiunge la possibilità di ricavare l'identità di un parlante da registrazioni di riferimento; la progettazione vocale, invece, crea un nuovo concetto di voce a partire da una descrizione scritta.
Per un editor di YouTube, significa poter riutilizzare la narrazione. Per un editore di corsi di e-learning, significa correggere un paragrafo senza dover richiamare un docente. Per uno sviluppatore di videogiochi, significa poter creare diverse voci per i personaggi. Per un tecnico di contact center, significa trasmettere in streaming una risposta vocale da un assistente virtuale dopo che il suo modello linguistico ha deciso cosa dire.
Non sostituisce la sceneggiatura, il missaggio audio, l'approvazione editoriale o il permesso di utilizzare un'altra persona's voce. Considererei Fish Audio come lo strato di produzione vocale all'interno di questi progetti, non come un sostituto completo di uno studio di registrazione o di un editor video.
Fish Audio S2.1 Pro contro Drama 3: quale modello scegliere?
S2.1 Pro è la scelta ideale per la produzione generale; Drama 3 è la scelta per la regia. Entrambi generano parlato, ma i loro punti di forza differiscono. S2.1 Pro supporta 83 lingue, testo multi-parlante e indicazioni di linguaggio naturale tra parentesi quadre. La variante API gratuita, s2.1-pro-free, utilizza lo stesso modello di base per lo sviluppo, con restrizioni di utilizzo equo e senza garanzie di consegna.
Drama 3 offre agli autori un maggiore controllo su come viene recitata una frase. Le indicazioni possono descrivere l'ascoltatore, l'intento emotivo o il ritmo. Supporta inoltre il posizionamento specifico di suoni e pause, la notazione della pronuncia e le modifiche di recitazione limitate a un numero ristretto di parole. Questo lo rende utile per trailer, dialoghi e personaggi di fantasia, dove una lettura neutra risulterebbe priva di vita.
S2 Pro rimane disponibile per i progetti esistenti. S1 è obsoleto, quindi non lo consiglierei per la progettazione di un nuovo sistema. Nello sviluppo software, è preferibile impostare il modello esplicitamente piuttosto che dare per scontato che l'impostazione predefinita dell'SDK rimanga valida.
Come le etichette emotive tra parentesi influenzano AI Consegna vocale
Uno script può contenere istruzioni come [sussurrando], [eccitato], [sospiro] o [pausa]. Si tratta di indicazioni di performance, non di parole che si desidera vengano lette ad alta voce. Con i modelli S2, le descrizioni tra parentesi quadre vengono interpretate dal contesto, quindi i loro effetti possono variare a seconda della voce e del testo.
La mia regola di scrittura è di usare meno tag di quanti pensi siano necessari. Inizia con una punteggiatura chiara e un interlocutore ben scelto. Aggiungi un'indicazione di regia solo dove cambia il significato. Un tutorial su un prodotto di solito richiede un ritmo costante; un monologo drammatico può richiedere cambi di tono emotivo più bruschi. Creare un breve provino prima di una sceneggiatura lunga rende più economico correggere eventuali errori di regia.
Drama 3 offre anche tag accoppiati per parole selezionate e controlli fonetici per la pronuncia. Questi sono particolarmente utili per nomi di aziende, abbreviazioni e dialoghi in cui l'enfasi cambia una frase's significato.
Come funziona la clonazione vocale di Fish Audio con registrazioni brevi?
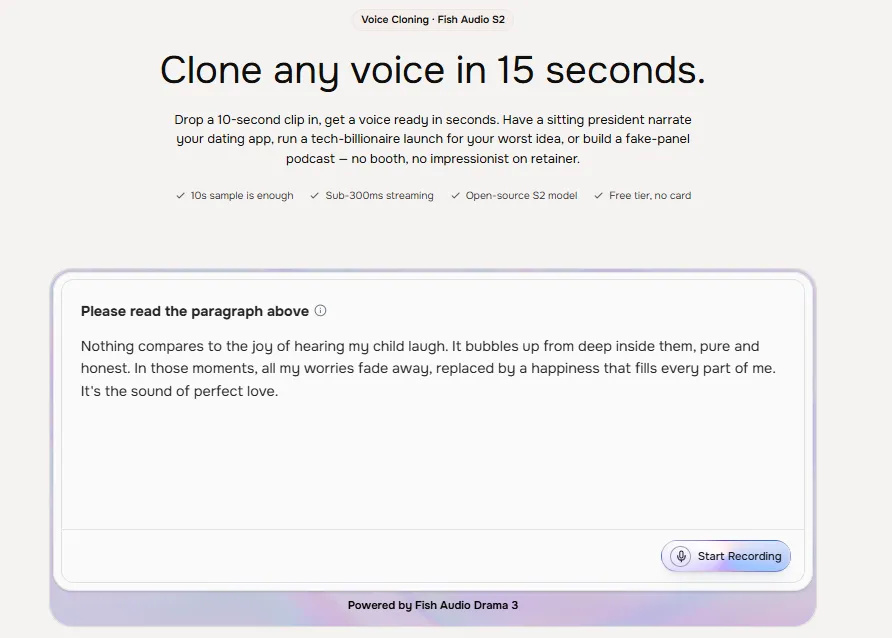
Fish Audio è in grado di creare una voce utilizzabile a partire da circa dieci secondi di parlato di riferimento, ma la durata minima dell'input non corrisponde alla qualità di registrazione ideale . La documentazione raccomanda un audio pulito, proveniente da un singolo interlocutore, e sottolinea che uno o due minuti possono migliorare la somiglianza. Musica di sottofondo, eco e interruzioni rendono più difficile apprendere una voce coerente.
Esistono due metodi pratici di clonazione. Una clonazione istantanea trasmette l'audio di riferimento con una richiesta di generazione e non richiede un modello salvato. Una clonazione persistente crea una voce memorizzata e restituisce un ID della voce. Le richieste future riutilizzano tale ID tramite il parametro reference_id.
Per marchi, corsi o personaggi ricorrenti, preferisco voci fisse, perché l'identità vocale non dovrebbe cambiare tra un episodio e l'altro. Le voci di riferimento istantanee sono più adatte a registrazioni singole approvate, dimostrazioni o scene sperimentali. Entrambe richiedono l'autorizzazione del parlante e un piano chiaro per l'archiviazione dell'audio originale.
Creazione di un riutilizzabile AI Voce senza perdere l'identità di chi parla
Iniziate con una registrazione di una sola persona che parla in una stanza silenziosa. Eliminate la musica e i lunghi silenzi. Per un primo tentativo, puntate a un minuto di parlato normale, piuttosto che a una performance teatrale. Includete il ritmo naturale, i suoni vocalici e le espressioni che rendono la voce riconoscibile.
In Fish Audio's Interfaccia browser, clonazione vocale aperta, carica il tuo campione autorizzato, crea la voce e mantienila privata se appartiene a una persona o a un'azienda. In un flusso di lavoro API, crea un modello utilizzando POST /model e salva l'ID restituito insieme al tuo progetto.'s Documentazione relativa alle licenze. È possibile fornire diversi esempi e relative trascrizioni per migliorare la pronuncia.
Genera quindi tre versioni di prova: un'introduzione neutra, una frase contenente nomi difficili e un paragrafo più espressivo. Presta attenzione alle variazioni di accento, alla gestione del respiro, alla chiarezza e alla coerenza delle consonanti. Una voce che supera solo la prima riga non è ancora adatta per la registrazione di un audiolibro completo.
Confronto tra la progettazione vocale e la clonazione di un oratore reale
Voice Design crea una voce proposta; la clonazione riproduce le caratteristiche di un parlato registrato. Voice Design accetta una descrizione, un testo di anteprima facoltativo e la lingua, quindi restituisce l'audio candidato. Il suo modello API è voice-design-1, con un costo di $0.01 per richiesta andata a buon fine. Questo è utile per i narratori fittizi quando non esiste un oratore reale che detenga l'identità.
Descriverei un personaggio usando l'accento, il ritmo del parlato, il tono della voce e l'atteggiamento, ad esempio "presentatore di documentari cordiale, tono misurato, consonanti chiare". Confronta i candidati usando esattamente la stessa frase di presentazione. Una volta scelto un personaggio, conserva una registrazione del campione selezionato in modo che gli episodi successivi abbiano un suono coerente.
Come generare voci fuori campo con sintesi vocale a tema pesci, passo dopo passo
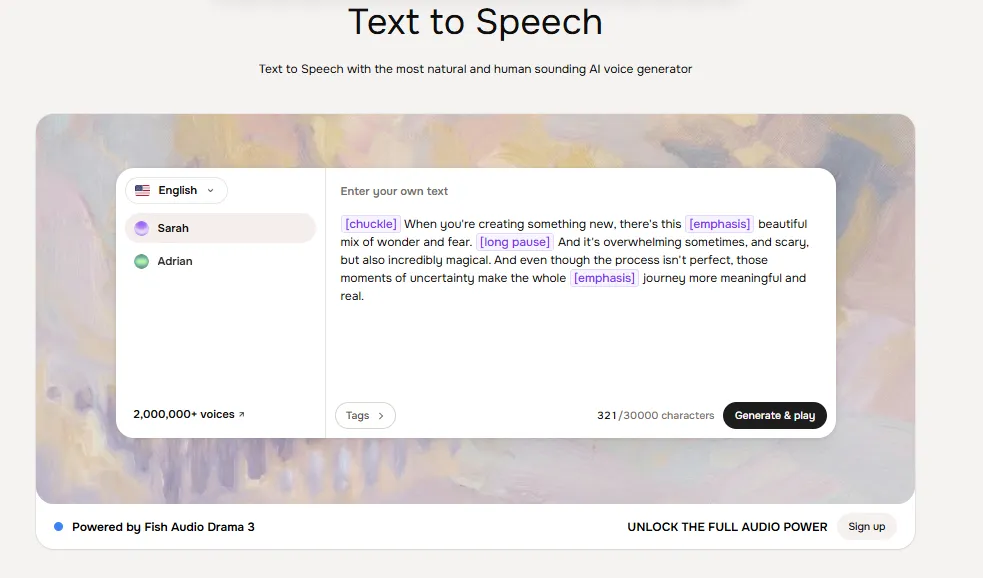
Il flusso di lavoro più semplice non richiede codice. Un creatore può scrivere, ascoltare in anteprima ed esportare il parlato direttamente nell'applicazione web. Il dettaglio importante è separare le scelte creative dalle correzioni tecniche, in modo da non sprecare crediti rigenerando un intero script per correggere una singola frase.
Fase 1: Preparare un copione per la presentazione orale
Riscrivi testi scritti densi in brevi frasi da pronunciare. Spiega per esteso le abbreviazioni non spiegate e decidi come dovrebbero essere pronunciati i nomi di valute, unità di misura e prodotti. Usa la punteggiatura per indicare i punti di respirazione naturali. Per le sceneggiature multilingue, separa i passaggi linguistici più complessi in righe distinte, quando necessario.
Consiglio di iniziare con 100-150 parole. È sufficiente per valutare la coerenza del tono senza impegnarsi per intero. Conservate una copia di riferimento del copione al di fuori dell'app, in modo che le correzioni siano facilmente tracciabili, soprattutto quando diversi editor approvano la stessa campagna.
Passaggio 2: Seleziona una voce, aggiungi la direzione e genera un'anteprima
Cerca nella libreria vocale per accento, fascia d'età, ruolo e stile. Fish Audio offre oltre due milioni di voci, quindi cercare un tipo di interpretazione specifico è più utile che navigare a caso. Verifica le autorizzazioni per l'utilizzo della voce prima di pubblicare qualsiasi contenuto a scopo commerciale.
Incolla il breve script, scegli un modello disponibile e inserisci solo gli indizi essenziali per la performance. Genera e ascolta con le cuffie e l'altoparlante del telefono. Presta attenzione alla fine delle frasi, alla pronuncia del marchio e ai bruschi cambiamenti di volume. I controlli di velocità possono essere d'aiuto, ma accelerare uno script con una punteggiatura scadente di solito peggiora la situazione.
Passaggio 3: Esporta l'audio e finalizzalo nel tuo editor
Scarica il risultato e importalo nel tuo software di editing. L'API supporta MP3, WAV, PCM e Opus; MP3 è comodo per la pubblicazione ordinaria, mentre WAV è spesso più adatto per modifiche più complesse. Aggiungi musica ed effetti dopo aver confermato la narrazione. Evita di coprire le parole troncate con una colonna sonora.
Come integrare l'API Fish Audio in un sito web o in un agente vocale
Fish Audio offre endpoint REST e SDK per Python e JavaScript. L'endpoint principale per la sintesi vocale è POST https://api.fish.audio/v1/tts. Autenticarsi con una chiave API privata, passare l'intestazione del modello desiderato e inviare lo script in formato JSON. Gli sviluppatori possono utilizzare s2.1-pro-free per i test iniziali senza dover acquistare crediti API a pagamento.
Una richiesta minima si presenta così:
curl -X POST https://api.fish.audio/v1/tts \
  -H "Authorization: Bearer $FISH_API_KEY" \
  -H "Content-Type: application/json" \
  -H "model: s2.1-pro-free" \
  -d '{"text":"Welcome to our product walkthrough.","format":"mp3"}' \
  --output welcome.mp3
Archivia la chiave API sul server, non in un file JavaScript pubblico. Se un utente finale fa clic su "Leggi ad alta voce", invia la richiesta tramite il tuo backend, convalida la lunghezza del testo e restituisci un file audio autorizzato. Memorizza nella cache i clip approvati quando il testo e la voce non sono cambiati. Questo consente di controllare i costi ed evitare richieste non necessarie.
Pianificazione dello streaming di produzione, della concorrenza e della latenza
Gli assistenti vocali in tempo reale necessitano di frammenti audio mentre il testo è ancora in fase di elaborazione. Fish Audio offre lo streaming WebSocket proprio a questo scopo. Un download completo in formato MP3 è sufficiente per un pulsante di narrazione di un blog; un operatore dell'assistenza clienti che parla trae vantaggio dalla ricezione anticipata dell'audio.
Il piano API base consente cinque richieste simultanee condivise tra le chiavi. Con una ricarica totale di 100 $ si sbloccano 15 richieste; con una ricarica di 1,000 $ se ne sbloccano 50. Questi sono limiti di concorrenza, non richieste garantite al secondo. Una richiesta che occupa uno slot per 30 secondi limita la velocità di elaborazione in modo significativo rispetto a una che termina in due secondi.
Per la distribuzione, misurare il tempo di risposta al primo audio, il tempo totale di completamento, il tasso di errore e la latenza p95 con script che simulano il traffico reale. Applicare un backoff esponenziale alle risposte HTTP 429. Non dare per scontato che l'endpoint S2.1 gratuito offra le stesse garanzie di latenza o disponibilità del modello di produzione a pagamento.
Come mantenere la coerenza nei capitoli lunghi degli audiolibri
Per un libro o un corso di lunga durata, è preferibile lavorare a sezioni piuttosto che inviare l'intero manoscritto senza alcuna preparazione. Utilizzate un ID vocale approvato, una scheda di pronuncia e una regola di denominazione audio. Generate la traccia scena per scena, quindi verificate le transizioni, le pause e i nomi dei personaggi ripetuti.
Story Studio supporta la produzione di audiolibri di lunga durata con più voci narranti all'interno della piattaforma. È utile quando un capitolo contiene diversi narratori, ma un editore dovrebbe comunque rivedere ogni scena e masterizzare il file finale. Fish Audio commercializza gli audiolibri secondo i comuni standard di distribuzione; la pubblicazione di successo dipende anche dal montaggio audio finale e dal distributore.'s assegni propri.
Fish Audio è in grado di trascrivere il parlato e gestire altre attività audio?
Sì. Fish Audio include il riconoscimento vocale, un modificatore di voce, la separazione audio, la traduzione audio , strumenti audio e funzionalità creative basate su browser. Si tratta di prodotti correlati, ma non vanno confusi con il modello di sintesi vocale in sé.
Il modello di trascrizione file consigliato è transcribe-1-pro. Supporta registrazioni fino a 60 minuti, etichette per gli oratori, turni di parola strutturati, timestamp opzionali e segnali di eventi audio. La sua API per i file ha un costo di 0.36 dollari per ora di audio. Il modello di riconoscimento in tempo reale, transcribe-stream-1, è in anteprima e costa 0.36 dollari per ora di sessione.
Prezzi di Fish Audio: crediti gratuiti, costi per Plus, Pro e API.
Fish Audio parte da 0 $, mentre il prezzo minimo per i creatori con abbonamento a pagamento è di 15 $ al mese o 11 $ al mese con fatturazione annuale. Gli abbonamenti regolano il limite mensile del prodotto browser; l'API per sviluppatori ha un proprio saldo prepagato basato sull'utilizzo. Non dare per scontato che un abbonamento Plus includa le chiamate API.
| Pianifica | Prezzo | Utilizzo incluso e limite pratico |
|---|---|---|
| Gratis | $0 | 8,000 crediti mensili; pubblicità fino a 7 minuti; 500 caratteri per generazione; 3 slot vocali pubblici |
| Plus | $ 15 mensili o $ 132 annuali | 250,000 crediti mensili; fino a 200 minuti; 15,000 caratteri per generazione; 10 slot vocali privati; Progettazione vocale |
| Pro | $ 100 mensili o $ 900 annuali | 2,000,000 di crediti mensili; fino a 1,620 minuti; 30,000 caratteri per generazione; 3 posti per squadra |
| Max | $ 999 mensili o $ 8,988 annuali | 25,000,000 di crediti mensili; fino a 6,250 minuti; 10 postazioni di team; 15 slot vocali professionali |
| Impresa | Preventivo personalizzato | Controlli organizzativi e disposizioni facoltative per l'implementazione e la gestione dei dati |
I crediti mensili si azzerano a ogni ciclo di fatturazione e la quota non utilizzata non viene riportata al ciclo successivo. Stime pubblicate per i minuti e le FAQ's Le conversioni generali da credito a minuto non sono perfettamente allineate, quindi consiglierei di pianificare il budget in base al credito disponibile sul piano tariffario e al consumo effettivo, piuttosto che moltiplicare per un tasso di conversione generico.
Prezzi dell'API Fish Audio spiegati in cifre semplici
Il servizio standard di sintesi vocale s2.1-pro e s2-pro ha un costo di 15 dollari per milione di byte UTF-8 in ingresso. L'endpoint gratuito s2.1-pro ha una tariffa di utilizzo di 0 dollari, soggetta alle restrizioni del fair use. Drama 3 ha un costo di 50 dollari per milione di byte, con una tariffa introduttiva temporanea di 10 dollari. Voice Design ha un costo di 0.01 dollari per ogni richiesta di generazione andata a buon fine.
I byte UTF-8 sono importanti. La maggior parte delle lettere inglesi occupa un byte, mentre molti caratteri non latini ne occupano di più. Pertanto, la stessa lunghezza di testo può richiedere quantità di spazio diverse a seconda della lingua. Fish Audio stima che un milione di byte di input in inglese corrispondano a circa 180,000 parole o 12 ore di parlato; si tratta di una stima, non di una durata garantita per ogni voce.
Per la pianificazione delle API, mantieni contatori di utilizzo separati per TTS, trascrizione e Voice Design. Tieni conto dei messaggi vocali e dei tag di direzione, poiché i byte di input, e non solo le parole udibili, influenzano i costi del TTS. Riserva spazio per correzioni, riprese alternative e revisioni da parte del cliente.
Casi d'uso di Fish Audio nel settore
L'utilizzo aziendale più efficace non è "generare una voce", bensì abbreviare una specifica fase di produzione mantenendo il controllo editoriale. Ecco come scomporrei il prodotto in un lavoro concreto.
| Industria o flusso di lavoro | Funzione da utilizzare | Beneficio specifico della produzione | Controllo di qualità richiesto |
|---|---|---|---|
| E-learning e formazione | Identificazione vocale persistente e narrazione dei capitoli | Sostituire una lezione modificata senza registrare nuovamente l'intero corso | Terminologia e comprensione da parte dello studente |
| Sviluppo del gioco | Progettazione vocale e recitazione 3 | Prototipare diverse identità di personaggi e stili di recitazione | Coerenza tra i diversi rami del dialogo |
| Produzione di contenuti per YouTube e podcast | Sintesi vocale, clonazione vocale e Story Studio | Riproduci una narrazione ripetuta con una voce nota | Ritmo, autorizzazioni e mastering audio |
| Assistenza clienti SaaS | API REST e riconoscimento vocale WebSocket | Leggi ad alta voce le risposte dell'assistente all'interno di un'applicazione | Ritardo nella risposta e escalation a una persona |
| Viaggi e localizzazione | Generazione multilingue S2.1 | Riprodurre le linee guida di viaggio approvate in diverse lingue. | Revisione dei toponimi da parte di un madrelingua |
| Pubblicazione accessibile | Sintesi vocale ed esportazione di file | Offrire versioni orali delle informazioni scritte | Navigazione, chiarezza e riproduzione accessibile |
| Agenzie di marketing | Registrazione del tono di voce del marchio e brevi clip salvate | Mantenere lo stesso narratore per tutte le revisioni della campagna approvate. | Rivendicazioni, diritti e pronuncia |
| squadre di trascrizione | transcribe-1-pro con turni di altoparlante | Preparare bozze separate per oratore, pronte per la revisione. | Nomi, timestamp e contenuti sensibili |
E-learning, formazione aziendale e accessibilità
L'audio didattico trae maggior beneficio da un volume stabile e da una pronuncia prevedibile rispetto a una recitazione teatrale. Consiglierei di scegliere una voce chiara, evitare tag teatrali e mantenere le unità didattiche come risorse separate. Se una policy cambia, rigenerare la sezione interessata e ricontrollare i collegamenti.
Per garantire l'accessibilità, l'audio dovrebbe integrare, non sostituire, il testo leggibile e la navigazione. Un pulsante di sintesi vocale è utile solo se i comandi da tastiera, la regolazione della velocità e l'articolo scritto rimangono disponibili. È importante rivedere la notazione matematica, gli URL e gli acronimi, poiché spesso risultano poco chiari quando vengono sintetizzati automaticamente.
Marketing, giochi e comunicazione localizzata con i clienti
I team di marketing possono creare narrazioni del marchio approvate senza dover coordinare un'altra sessione di registrazione per ogni piccola modifica. Gli studi di sviluppo di videogiochi possono fare audizioni a diverse voci fittizie prima di assumere gli interpreti o definire il cast. Per un sito web di viaggi, una voce multilingue può spiegare le procedure di connessione o le prenotazioni, ma i nomi delle destinazioni e i numeri richiedono una voce che parli fluentemente la lingua.
Il mio consiglio è di adeguare l'impegno profuso nella revisione al rischio aziendale. Un video promozionale può essere corretto dopo l'esportazione. Istruzioni mediche, bilanci o annunci di importanza critica per la sicurezza richiedono controlli umani molto più rigorosi, verifiche sulla privacy e contenuti validati prima della riproduzione.
Quanto è naturale l'audio dei pesci rispetto ad altri AI Generatori vocali?
Audio di pesce's La caratteristica più importante, secondo le indiscrezioni, è il controllo che offre sulla performance vocale: brevi campioni di clonazione, un'ampia libreria pubblica, diversi motori di sintesi vocale e tag direzionali più espressivi della semplice selezione della voce. Drama 3 è particolarmente adatto a sceneggiature che richiedono reazioni, pause o interpretazione dei personaggi.
Lo confronterei con ElevenLabs e PlayHT utilizzando lo stesso testo, non dimostrazioni di marketing. Prepara lo stesso esempio di 120 parole con un cognome difficile, una domanda, un numero, una frase tranquilla e un improvviso cambiamento emotivo.
Confronta l'intelligibilità, la coerenza dell'accento, gli artefatti audio e il costo totale per minuto approvato. In questo modo, il risultato sarà utile per le tue esigenze di produzione.
| AI Generatore vocale, software di sintesi vocale, piattaforma di clonazione vocale | Funzionalità principali | Ideale per | Prezzo di partenza |
|---|---|---|---|
| Audio di pesce | Sintesi vocale espressiva, clonazione vocale, accesso API | Applicazioni di narrazione e vocali | Gratuito; $15/mese |
| UndiciLabs | Clonazione vocale, sintesi vocale multilingue, doppiaggio | Voiceover realistici | Gratuito; $6/mese |
| Murf AI | Oltre 200 voci, modifica della voce, controlli di pronuncia | Presentazioni aziendali | Gratuito; abbonamento annuale a 19 dollari al mese. |
| LOVOAI | AI voci, editor video, clonazione vocale | Creatori di contenuti video | Gratuito; piani a pagamento |
| Assomiglia all'IA | Clonazione vocale, sintesi vocale in tempo reale, controlli delle emozioni | Sviluppatori e imprese | Prezzi basati sull'utilizzo |
Uncommon AI Problemi di linguaggio e soluzioni pratiche
Se la pronuncia non è corretta, sillaba il nome o utilizza i controlli fonetici supportati. Se il tono della voce cambia tra una clip e l'altra, riduci i tag in conflitto e riutilizza la stessa voce salvata. Se il testo sembra frettoloso, correggi la punteggiatura prima di rallentare il parlato. Se l'output multilingue cambia accento, testa passaggi più brevi con un parlante di riferimento adeguato.
Se un tag emotivo produce un'interpretazione esagerata, rimuovilo e rigenera la sezione più piccola interessata. Se una narrazione lunga risulta incoerente, dividila in corrispondenza dei confini naturali delle scene e annota il modello scelto, l'ID della voce e la velocità.
Privacy, consenso vocale e diritti commerciali di Fish Audio
Un piano a pagamento non ti autorizza a clonare la voce di qualcun altro. I termini di Fish Audio richiedono agli utenti di rispettare la proprietà intellettuale e gli altri diritti applicabili. Ottieni un consenso esplicito per la registrazione di riferimento, identifica dove la voce risultante può essere utilizzata e conserva la prova dell'autorizzazione quando crei un brand o un contenuto per un cliente.
Esiste un'importante discrepanza nella formulazione relativa al piano gratuito: il listino prezzi menziona l'uso commerciale, ma le FAQ sui prezzi e i termini generali limitano gli account gratuiti a progetti personali e non commerciali. Per la pubblicazione, consiglierei di attenersi alla regola scritta più restrittiva e di utilizzare un piano a pagamento idoneo con una voce verificata di cui si possiedono i diritti di utilizzo.
Anche la privacy è importante, perché i campioni vocali caricati possono identificare una persona. La politica di Fish Audio descrive la conservazione dei contenuti caricati per esigenze operative. Gli accordi aziendali prevedono l'opzione "Zero Data Retention" per i flussi di lavoro idonei, ma gli abbonamenti per i consumatori non devono essere considerati come se tale impostazione fosse automatica.
Mantieni le chiavi API lato server, limita l'accesso del personale alle registrazioni vocali private ed evita di inserire materiale riservato dei clienti in modelli pubblici. Qualora il lavoro coinvolga dati sanitari, minori o chiamate riservate, predisponi adeguate garanzie contrattuali e una revisione legale prima di caricare le registrazioni.
Vantaggi e svantaggi per creatori e sviluppatori
- Modelli di parlato espressivo con direzionalità basata su parentesi e controlli di recitazione Drama 3.
- Clonazione rapida e ID vocali riutilizzabili per progetti ricorrenti.
- Ampia copertura linguistica, una vasta libreria di contenuti per la comunità e un design vocale originale.
- Editor web, app per dispositivi mobili, SDK, accesso REST e streaming in tempo reale.
- Punti di accesso separati e gratuiti per la creazione amatoriale e la prototipazione da parte degli sviluppatori.
- Nonostante la formulazione incoerente dei listini prezzi, la concessione di licenze commerciali gratuite è soggetta a restrizioni.
- I crediti di abbonamento e la fatturazione API sono separati; è necessario monitorare le stime.
- Un clone di dieci secondi potrebbe aver bisogno di campioni migliori prima di una pubblicazione professionale.
- La qualità e la pronuncia variano ancora a seconda della scrittura, della voce e della lingua.
- L'accesso gratuito all'API non include garanzie di rilascio in produzione.
- Le registrazioni riservate richiedono una pianificazione della privacy più accurata rispetto alle normali registrazioni pubbliche.
Per un singolo creatore che produce poche voci fuori campo a settimana, Plus è il punto di partenza a pagamento più sensato. Gli sviluppatori dovrebbero prima utilizzare il modello API S2.1 gratuito, quindi preventivare separatamente l'utilizzo per la produzione prima di lanciare il servizio ai clienti.
Domande frequenti su Fish Audio
Queste risposte coprono le domande relative all'acquisto e alla configurazione che chiarirei prima di iniziare un progetto a pagamento.
Fish Audio è gratuito? E quante voci fuori campo posso realizzare?
Sì. Il piano web gratuito include 8,000 crediti al mese, che corrispondono a un massimo di sette minuti di generazione, con un limite di 500 caratteri per richiesta. Il numero esatto di clip dipende dalla lunghezza della sceneggiatura e dall'utilizzo della generazione. Gli account gratuiti sono destinati all'uso personale e non commerciale, secondo i termini indicati.
Fish Audio è in grado di clonare la mia voce a partire da una registrazione audio di dieci secondi?
Sì. Fish Audio offre la clonazione vocale istantanea utilizzando circa dieci secondi di parlato. È importante che l'audio sia chiaro e provenga da un singolo oratore; uno o due minuti possono produrre una voce riutilizzabile più fedele. Clona solo voci di cui possiedi i diritti o per le quali hai l'autorizzazione alla riproduzione.
Fish Audio supporta 83 lingue e le voci fuori campo per scopi commerciali?
S2.1 Pro supporta 83 lingue, tra cui inglese, cinese, giapponese, coreano, francese, tedesco e spagnolo. Gli abbonamenti a pagamento possono supportare progetti commerciali, soggetti alla proprietà della voce, alle autorizzazioni e alla piattaforma.'s termini. Il supporto linguistico non elimina la necessità di controllare la pronuncia.
L'accesso all'API Fish Audio è incluso nell'abbonamento Plus?
No. Fish Audio fattura l'utilizzo delle API per gli sviluppatori separatamente dai crediti di abbonamento per i creatori. La sua API di produzione S2.1 Pro costa 15 dollari per milione di byte di input UTF-8, mentre il modello API S2.1 Pro Free è disponibile per lo sviluppo a condizioni di utilizzo equo.
Vale la pena utilizzare Fish Audio?
Fish Audio è un'opzione da considerare quando la capacità di riprodurre voce in modo espressivo, clonare voci ripetibili e accedere direttamente alle API è fondamentale per un flusso di lavoro integrato. Drama 3 è la soluzione più interessante per i dialoghi recitati; S2.1 Pro rappresenta invece un modello di produzione più chiaro e completo. L'applicazione per browser semplifica l'utilizzo per i creatori, mentre gli SDK, i servizi di streaming e di trascrizione lo rendono molto più di un semplice strumento di narrazione.
Il mio consiglio è di scegliere una sceneggiatura di produzione reale, fare un provino a diverse voci autorizzate, verificare le parole difficili e calcolare il numero di rigenerazioni necessarie per un risultato approvato. Lo strumento può far risparmiare tempo di registrazione, ma la qualità finale dipende comunque dalla sceneggiatura, dal consenso e dal giudizio editoriale.


