
Verkfræðiteymi sem setja upp LLM-þjónustu verða að svara mikilvægri spurningu: hversu áreiðanlegt og traust er líkan okkar í raunverulegum aðstæðum?
Mat á stórum tungumálalíkönum fer nú lengra en einfaldar nákvæmnisathuganir og notar lagskipta ramma til að prófa samhengisgeymslu, rökréttleika og meðhöndlun á jaðartilvikum. Þar sem markaðurinn er yfirfullur af líkönum sem spanna allt frá 1B til 2T breytum , krefst val á bestu líkaninu strangra, fjölvíddar matsferla.
Þessi handbók lýsir tæknilegum aðferðum og helstu mælikvörðum sem móta bestu starfsvenjur árið 2026 og hjálpar vélanámsverkfræðingum að greina galla áður en þeir komast í framleiðslu.
Rammar fyrir mat á stórum tungumálalíkönum
Modern LLM mat felur í sér margvísleg megindlegar og eigindlegar víddir að fanga fyrirmynd's raunverulegur hæfileiki. Nýlegar rannsóknir sýna að 67% fyrirtækja AI Innleiðingar standa sig verr vegna ófullnægjandi líkanavals – sem undirstrikar hvers vegna flókið mat er ekki aðeins valfrjálst heldur mikilvægt fyrir viðskipti.

Kjarnaþættir mats
Rannsókn 2026 frá Stanford's AI Index leiðir í ljós að fyrirtæki sem fjárfesta í alhliða LLM matsferlum sjá 42% hærri arðsemi fjárfestingar (ROI) af verkefnum sínum. AI frumkvæði samanborið við þau sem nota einfaldaða mælikvarða.
Sundurliðun tæknilegra mælikvarða
Nútíma matsrammar nota fjölda sérhæfðra mælikvarða, sem hver um sig miðar að tilteknum hæfni í LLM:
Árangursmælingar
Rugla magngreinir óvissu í spá með því að reikna veldisvísitölu meðal neikvæðrar lógaritmalíkinda yfir prófunarsafn. Lægri gildi gefa til kynna betri frammistöðu, þar sem nýjustu líkön ná ruglingi undir 3.0 á stöðluðum gagnasöfnum.
F1 stig sameinar nákvæmni og innköllun með formúlunni fyrir harmonískt meðaltal:
F1 = 2 * (precision * recall) / (precision + recall)Þetta skapar jafnvægismat sem er sérstaklega verðmætt fyrir flokkunarverkefni með ójafnvægi í bekkjum.
Kross-entropíutap mælir misræmi milli spáðra líkindadreifinga og jarðsanninda með formúlunni:
L(y, ŷ) = -∑(y_i * log(ŷ_i))Þetta refsar öruggum en rangum spám harðar og hvetur til kvörðunar líkansins.
BLEU (Bilingual Evaluation Understudy) reiknar út n-gramma skörun milli myndaðra texta og tilvísunartexta með því að nota rúmfræðilegt meðaltal nákvæmnisskora með tilvísunarrefsingu:
BLEU = BP * exp(∑(w_n * log(p_n)))Þar sem BP er styttingarrefsing og p_n er n-gramma nákvæmni.
RAG-sértækar mælikvarðar
Fyrir kerfi með aukinni kynslóð sóknar eru sérhæfðar mælikvarðar meðal annars:
Trúverðugleiki magngreinir staðreyndasamræmi milli myndaðs úttaks og sótts samhengis með því að nota QAG (spurninga-svara myndun) aðferðir. Rannsóknir sýna að RAG kerfi með trúverðugleikastig undir 0.7 valda ofskynjunum í 42% úttaks.
Retrieval Precision@K mælir hlutfall viðeigandi skjala meðal efstu sóttra niðurstaðna í K:
Precision@K = (number of relevant docs in top K) / KViðmiðunargildi í greininni benda til þess að P@3 > 0.85 sé fyrir kerfi í fyrirtækjaflokki.
Tilvitnunarnákvæmni metur nákvæmni tilvitnana í mynduðu efni, reiknað sem:
Citation Precision = correct citations / total citationsGreining á leiðandi RAG kerfum sýnir að meðalnákvæmni tilvitnunar er 0.71 á öllum tæknilegum sviðum.
Viðmiðunargagnasöfn: Tæknilegar upplýsingar
Viðmiðunargagnasöfn bjóða upp á stöðluð matsramma með sérstökum tæknilegum eiginleikum:

MMLU-Pro býður upp á 15,908 fjölvalsspurningar með 10 valmöguleikum á hverja spurningu (á móti 4 í hefðbundnu MMLU), sem fjalla um 57 svið, þar á meðal háþróaða stærðfræði, læknisfræði, lögfræði og tölvunarfræði. Meðalárangur manna sem sérfræðinga: 89.2%.
GPQA inniheldur 448 sérfræðistaðfestar spurningar á framhaldsstigi með meðallengd 612 spurninga, með áherslu á raunvísindi, tækni, verkfræði og tækni (STEM). Núverandi SOTA árangur: 41.2% nákvæmni (GPT-4).
MuSR útfærir reiknirit sem mynduð eru með fjölþrepa rökfræðivandamálum með tengslamyndum með meðaldýpt 4.7, sem krefst þess að líkön framkvæmi keðjubundnar rökaðgerðir. Meðalframmistöðumunur milli efstu líkana og handahófskenndrar grunnlínu: 17.8 prósentustig.
BBH samanstendur af 23 krefjandi verkefnum frá BigBench með 2,254 einstökum dæmum sem einbeita sér að flókinni rökhugsun . Þessi verkefni sýna mikla fylgni (r=0.82) við einkunnir á óskum manna í blindum matsaðferðum.
LEval sérhæfir sig í langtímasamhengismati með 411 spurningum í 8 verkefnaflokkum með samhengislengd frá 5 til 200 táknum. Núverandi líkön sýna fram á um það bil 0.4% lækkun á afköstum fyrir hver 10 viðbótar tákn.
Matsreiknirit og framkvæmd
Tæknileg útfærsla á LLM-mati fylgir sérstökum reikniritum:
Vigur-byggð merkingarfræðileg mat
Nútíma kerfi nota vigurinnfellingar til að mæla merkingarfræðilega líkindi milli myndaðra texta og tilvísunartexta. Með því að nota þéttar sóknaraðferðir eins og HNSW (Hierarchical Navigable Small World), LSH (Locality-Sensitive Hashing) og PQ (Product Quantization) reikna þessi kerfi líkindisstig með undirlínulegri tímaflækjustigi.
python

from sentence_transformers import SentenceTransformer

import numpy as np

model = SentenceTransformer('all-MiniLM-L6-v2')

reference = model.encode("Reference text")

generated = model.encode("Generated text")

similarity = np.dot(reference, generated) / (np.linalg.norm(reference) * np.linalg.norm(generated))
Innleiðing DeepEval ramma
DeepEval býður upp á ítarlegt mat með skýringum á mælikvörðum, sem styður bæði RAG og fínstillingarsviðsmyndir:
python

from deepeval import assert_test

from deepeval.metrics import HallucinationMetric

from deepeval.test_case import LLMTestCase

test_case = LLMTestCase(

    input="How many evaluation metrics does DeepEval offers?",

    actual_output="14+ evaluation metrics",

    context=["DeepEval offers 14+ evaluation metrics"]

)

metric = HallucinationMetric(minimum_score=0.7)

def test_hallucination():

    assert_test(test_case, [metric])
Þetta rammi meðhöndlar mat sem einingapróf með Pytest-samþættingu og veitir ekki aðeins stig heldur einnig skýringar á frammistöðustigum.
Aðferðir til að meta breytur sem skila hagkvæmni
Til að meta líkön með milljörðum breytna í stórum stíl hafa sérhæfðar aðferðir komið fram:

Aðferðir til að auka athyglisþörf draga úr flækjustigi reiknivéla með því að fínstilla athyglismynstur. Tækni eins og athyglismynstur Longformer sýna 91% nákvæmni í fullri athygli með aðeins 25% af útreikningnum.
Blandaðar sérfræðingaarkitektúrar (MoE) nota skilyrtar útreikningsleiðir og virkja aðeins viðeigandi undirnet fyrir tiltekin verkefni. GShard notar MoE athygli fyrir skilvirka matsferla á breytum yfir fjölbreytt viðmið.
Þekkingareimun þjappar stærri kennaralíkönum saman í minni, matssértæk nemendalíkön með því að nota:
L_distill = α * L_CE(y, ŷ_student) + (1-α) * L_KL(ŷ_teacher, ŷ_student)
Þar sem L_CE er víxl-entropíutap og L_KL er KL-frávik milli líkindadreifinga.
Áskoranir í kerfisbundnu mati
Þrátt fyrir háþróaðar aðferðafræði eru enn verulegar áskoranir í mati á LLM:
Viðmiðunarmengun
Rannsóknir sýna að 47% vinsælla viðmiða hafa einhverja mengun í þjálfunargögnum. AI sýndi þetta fram með því að búa til GSM1k, minni útgáfu af stærðfræðiviðmiði GSM8k. Líkön stóðu sig 12.3% verr á GSM1k en GSM8k, sem bendir til ofmátunar frekar en stærðfræðileg rökhugsun hæfni.
Mælifræðileg fylgnigreining
Ítarleg greining á 14 vinsælum mælikvörðum í 8 verkefnum sýnir lága fylgni milli mælikvarða (meðaltal Spearman's ρ = 0.41), sem gefur til kynna að mælikvarðar nái yfir mismunandi frammistöðuvíddir. Þetta undirstrikar nauðsyn þess að nota fjölþættar aðferðir til að meta árangur.
Rannsóknir frá MIT sýna að háar ráðaleysisstiganir tengjast óskum manna við r=0.68, en ROUGE-L samsvarar aðeins við r=0.39, sem bendir til fjölbreyttra matskrafna.
Magnbundin matsskekkja
Tölfræðileg greining á mati á mönnum leiðir í ljós margvíslega kerfisbundna skekkju:
Þessar niðurstöður undirstrika mikilvægi slembivals og jafnvægis tilraunahönnunar í matsferlum.
Bestu starfsvenjur við mat á fyrirtækjum
Til að takast á við áskoranir í mati skal innleiða þessar bestu starfsvenjur í greininni:
Fjölþátta mælikvarðasamþætting
Sameinið viðbótarmælikvarða með því að nota vegin gögn til að búa til heildrænt matsramma:
python

def ensemble_score(outputs, references, weights=None):

    metrics = {

        'bleu': compute_bleu(outputs, references),

        'bertscore': compute_bertscore(outputs, references),

        'faithfulness': compute_faithfulness(outputs, references),

        'coherence': compute_coherence(outputs)

    }

    if weights is None:

        weights = {metric: 1/len(metrics) for metric in metrics}

    return sum(weights[metric] * metrics[metric] for metric in metrics)
Leiðandi stofnanir innleiða aðlögunarhæfar vigtarkerfi byggðar á verkefnasértækum kröfum, þar sem tæknilegt efni forgangsraðar trúmennsku (vigt: 0.4) fram yfir reiprennandi efni (vigt: 0.2).
Sértæk matsferli fyrir hvert svið
Tæknileg viðmið ættu að vera í samræmi við tilteknar notkunartilvik. Fyrir heilbrigðisþjónustu eru sérhæfð mælikvarðar meðal annars:
- Nákvæmni læknisfræðilegrar hugtakanotkunar (89% fylgni við mat lækna)
- Staðfesting á klínískri rökfærslu (75% samræmi við samstöðu sérfræðinga)
- Nákvæmni í sönnunargögnum úr læknisfræðilegum ritum (P@10 > 0.92 fyrir innleiðingu fyrirtækja)
Þessar sviðssértæku mælikvarðar veita 3.2 sinnum betri spá um afköst en almenn viðmið.
Innleiðing andstæðrar mats
Innleiða skipulagða andstæðuprófun til að kanna takmarkanir líkansins:
python

def adversarial_test_suite(model, test_cases):

    results = {}

    for category, cases in test_cases.items():

        correct = 0

        for case in cases:

            response = model.generate(case['input'])

            correct += evaluate_response(response, case['expected'])

        results[category] = correct / len(cases)

    return results
Rannsóknir í greininni sýna að andstæðar prófanir bera kennsl á 32% fleiri bilunarmáta en hefðbundin viðmiðunarprófanir, sérstaklega í tilfellum á jaðri kerfa þar sem skorður stangast á eða leiðbeiningar eru óljósar.
Samanburður á tæknilegum matsramma
Leiðandi matsrammar bjóða upp á mismunandi tæknilega möguleika:
| Framework | Aðaláhersla | Tæknilegur styrkur | Takmörkun | Samþættingarflækjustig |
|---|---|---|---|---|
| Djúpmat | RAG og fínstilling | 14+ sérhæfðar mælikvarðar með útskýringum | Takmarkaður fjölþættur stuðningur | Miðlungs (byggt á Python) |
| HvetjaFlow | Mat frá upphafi til enda | Hraðprófun á breytingum | Takmarkaður stuðningur við gagnasöfn | Lágt (notendaviðmótsknúið) |
| LangSmith | Þróunarvettvangur | Algjör rakning og eftirlit | Hærri framkvæmdarkostnaður | Hátt (krefst API-samþættingar) |
| Prometheus | LLM-sem-dómari | Kerfisbundnar hvatningaraðferðir | Hlutdrægni dómara í LLM | Miðlungs (krefst öflugrar LLM-gráðu) |
| LEval | Langtímamat | Mat á 200 þúsund táknum | Takmarkað við textastillingu | Lágt (viðmiðunargagnagrunnur) |
Fyrirtæki innleiða yfirleitt mörg rammaverk, þar sem 73% fyrirtækjainnleiðinga nota að minnsta kosti tvö samverkandi matsverkfæri.
Tækniþróun framtíðarinnar
Matslandslagið heldur áfram að þróast með nýjum aðferðafræði:
Leit að taugaarkitektúr (NAS) fyrir matssértæk líkön er að verða vinsælli og rannsóknir sýna að sjálfvirk hagræðing líkanaarkitektúrs getur aukið skilvirkni mats um 47% en viðhaldið 98% nákvæmni.
Fjölþátta matsrammar eru að víkka út fyrir texta til að meta sameinaðar líkön sem vinna úr texta , myndum, hljóði og myndbandi. Núverandi rammar ná 76.3% nákvæmni milli þátta samanborið við 91.4% grunnlínu hjá mönnum.
Mæligildi fyrir orkunýtingu mæla sjálfbærni í útreikningum með því að nota FLOP/merki, álykta um wattstundir og mæligildi fyrir kolefnislosun. Viðmið í greininni benda til þess að bestu líkön ættu að ná <10 mWh á hverja 1 myndaða merki.
Stöðug matsferli samþætta prófanir í gegnum þróun með því að nota dreifð matsferli:
Preprocessing → Feature Extraction → Model Inference → Metric Computation → Statistical Analysis → Reporting
Fyrirtæki sem innleiða stöðugt mat greina frá 68% færri vandamálum eftir innleiðingu og 41% hraðari ítrunarferlum.
Raunverulegar framkvæmdardæmi
Innleiðingar fyrirtækja sýna fram á tæknilegt mat's hagnýt áhrif:
Hagræðing á RAG í fjármálaþjónustu
Leiðandi fjármálastofnun innleiddi ítarlegt RAG mat á ráðgjafarkerfi sínu sem snýr sér að viðskiptavinum:
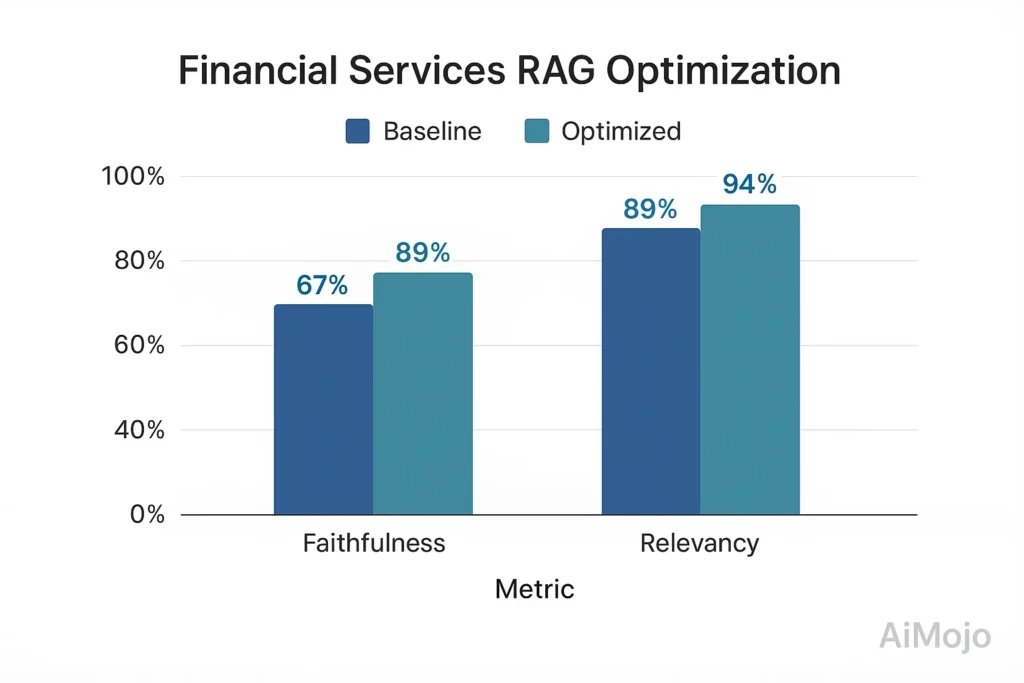
- Grunnlína: 67% trúfesti, 82% viðeigandi svar
- Eftir matsdrifin hagræðing: 89% trúfesti, 94% viðeigandi svar
- Framkvæmd: Sérhannað fjármálasvið prófunarsvíta með 5,216 sérfræðingsstaðfestum gæðaeftirlitspörum
- Tæknileg nálgun: Tryggðarmat með tensor-byggðri mælingu á þátttöku með gagnstaðreyndum prófunum
Þessi matsdrifin úrbætur drógu úr reglugerðarfylgni um 78% og jók ánægju viðskiptavina um 23 prósentustig.
Útfærsla á LLM-námi í heilbrigðisgeiranum
Heilbrigðisstarfsmaður innleiddi marglaga mat til að styðja við klínískar ákvarðanir:
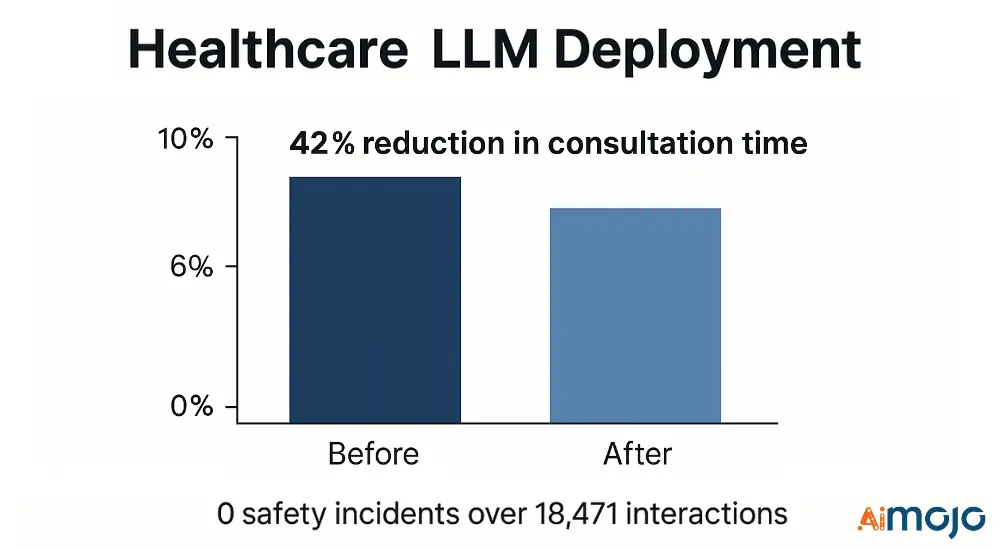
- Tæknilegar mælikvarðar: Læknisfræðilegt NER F1 stig (0.91), nákvæmni í klínískri rökhugsun (87.4%), nákvæmni í öryggissíun (99.2%)
- Framkvæmd: Þriggja þrepa síunarleiðsla með sérhæfðum heilbrigðisprófunaraðilum
- Árangur: 42% stytting á viðtalstíma með 0 öryggisatvikum í 18,471 klínískum milliverkunum
Matsramminn greindi og mildaði 17 mikilvægar bilunaraðstæður fyrir nýtingu, sem kom í veg fyrir hugsanleg aukaverkun.
LLM mat: Leiðarvísir þinn að árangri
Tæknilegt mat á LLM-námi hefur færst frá einföldum nákvæmnisprófum yfir í alhliða ramma sem vega og meta marga afkastaþætti. Fyrirtæki sem tileinka sér þessar ströngu samskiptareglur – og samþætta sjálfvirka einkunnagjöf, viðmiðunarprófanir og eftirlit með fólki – ná áreiðanlegri líkanavali og sterkari niðurstöðum.
Reglulegar, aðlögunarhæfar prófunarleiðir leiða í ljós galla fyrir uppsetningu, sem gerir kostnaðinn við upphafsmat lítinn samanborið við áhættuna af því að setja upp gallað kerfi. Fyrir verkfræðiteymi eru öflug staðfestingarskref meira en þróunarverkefni ; þau eru nauðsynleg öryggisráðstöfun fyrir fyrirtækið.
Árið 2026 og síðar munu teymi sem betrumbæta matsaðferðir sínar halda LLM-prófum sínum áreiðanlegum, koma í veg fyrir kostnaðarsöm mistök og viðhalda trausti notenda.


 Bónus: Fáðu 200 dollara okkarAI „Verkfærakista fyrir meistaranám“ ÓKEYPIS þegar þú skráir þig!


