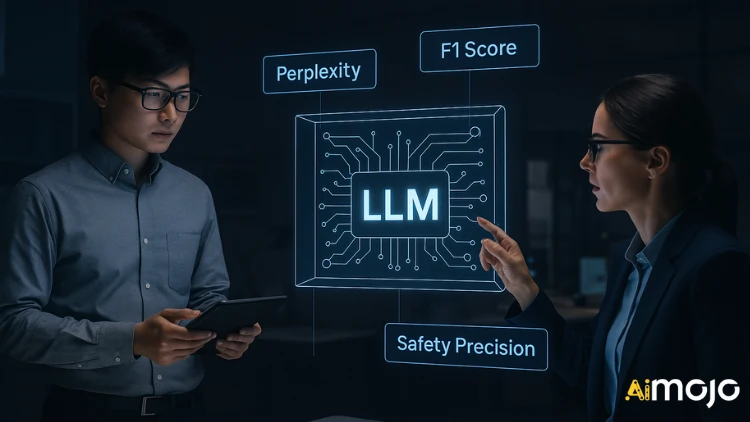
Tim teknik yang menerapkan layanan LLM harus menjawab pertanyaan penting: seberapa andal dan tangguhkah model kita dalam skenario dunia nyata?
Evaluasi Model Bahasa Skala Besar kini melampaui pemeriksaan akurasi sederhana, dengan menggunakan kerangka kerja berlapis untuk menguji retensi konteks, validitas penalaran, dan penanganan kasus-kasus ekstrem. Dengan pasar yang dibanjiri model dengan parameter mulai dari 1 miliar hingga 2 triliun , pemilihan model yang optimal membutuhkan protokol penilaian multidimensi yang ketat.
Panduan ini merinci metode teknis dan metrik inti yang membentuk praktik terbaik pada tahun 2026, membantu para insinyur ML menemukan kelemahan sebelum mencapai produksi.
Kerangka Kerja untuk Evaluasi Model Bahasa Besar
modern evaluasi LLM menggabungkan beberapa dimensi kuantitatif dan kualitatif untuk menangkap model's kemampuan yang sebenarnya. Penelitian terbaru menunjukkan 67% perusahaan AI penerapan tidak berjalan dengan baik akibat pemilihan model yang tidak memadai – menyoroti mengapa evaluasi yang canggih tidak hanya bersifat opsional tetapi juga penting bagi bisnis.

Komponen evaluasi inti
Sebuah studi 2026 dari Stanford's AI Indeks mengungkapkan perusahaan yang berinvestasi dalam protokol evaluasi LLM yang komprehensif melihat ROI 42% lebih tinggi pada AI inisiatif dibandingkan dengan inisiatif yang menggunakan metrik yang disederhanakan.
Rincian Metrik Teknis
Kerangka evaluasi modern menggunakan lusinan metrik khusus, yang masing-masing menargetkan kemampuan LLM tertentu:
Metrik Kinerja
Perplexity mengukur ketidakpastian prediksi dengan menghitung eksponensial dari rata-rata log-likelihood negatif di seluruh korpus uji. Nilai yang lebih rendah menunjukkan kinerja yang lebih baik, dengan model-model canggih mencapai perplexity di bawah 3.0 pada dataset yang distandarisasi.
Skor F1 menggabungkan presisi dan recall melalui rumus rata-rata harmonik:
F1 = 2 * (precision * recall) / (precision + recall)Hal ini menciptakan penilaian seimbang yang sangat berharga untuk tugas klasifikasi dengan ketidakseimbangan kelas.
Cross-Entropy Loss mengukur perbedaan antara distribusi probabilitas yang diprediksi dan kebenaran sebenarnya menggunakan rumus:
L(y, ŷ) = -∑(y_i * log(ŷ_i))Hal ini memberikan sanksi lebih berat terhadap prediksi yang meyakinkan tetapi salah, dan mendorong kalibrasi model.
BLEU (Bilingual Evaluation Understudy) menghitung tumpang tindih n-gram antara teks yang dihasilkan dan teks referensi, menggunakan rata-rata geometris dari skor presisi dengan penalti keringkasan:
BLEU = BP * exp(∑(w_n * log(p_n)))Di mana BP adalah penalti singkatnya dan p_n adalah presisi n-gram.
Metrik Spesifik RAG
Untuk sistem Retrieval Augmented Generation, metrik khusus meliputi:
Keakuratan mengukur konsistensi faktual antara keluaran yang dihasilkan dan konteks yang diambil menggunakan pendekatan QAG (Question-Answer Generation). Penelitian menunjukkan sistem RAG dengan skor keakuratan di bawah 0.7 menghasilkan halusinasi pada 42% keluaran.
Retrieval Precision@K mengukur proporsi dokumen relevan di antara K hasil teratas yang ditemukan:
Precision@K = (number of relevant docs in top K) / KTolok ukur industri menunjukkan P@3 > 0.85 untuk sistem tingkat perusahaan.
Presisi Sitasi mengevaluasi keakuratan sitasi dalam konten yang dihasilkan, dihitung sebagai:
Citation Precision = correct citations / total citationsAnalisis sistem RAG terkemuka mengungkapkan presisi kutipan rata-rata 0.71 di seluruh domain teknis.
Dataset Benchmark: Spesifikasi Teknis
Kumpulan data acuan menyediakan kerangka kerja evaluasi terstandarisasi dengan karakteristik teknis tertentu:

MMLU-Pro memiliki 15,908 pertanyaan pilihan ganda dengan 10 pilihan per pertanyaan (dibandingkan 4 pada MMLU standar), mencakup 57 bidang termasuk matematika tingkat lanjut, kedokteran, hukum, dan ilmu komputer. Rata-rata kinerja ahli manusia: 89.2%.
GPQA berisi 448 pertanyaan tingkat pascasarjana yang telah diverifikasi oleh para ahli dengan panjang token rata-rata 612, yang berfokus pada domain STEM. Performa SOTA saat ini: akurasi 41.2% (GPT-4).
MuSR mengimplementasikan masalah penalaran multi-langkah yang dihasilkan secara algoritmik dengan grafik ketergantungan dengan kedalaman rata-rata 4.7, yang mengharuskan model untuk melakukan operasi logika berantai. Selisih kinerja rata-rata antara model terbaik dan baseline acak: 17.8 poin persentase.
BBH terdiri dari 23 tugas menantang dari BigBench dengan 2,254 contoh individual yang berfokus pada penalaran kompleks . Tugas-tugas ini menunjukkan korelasi tinggi (r=0.82) dengan peringkat preferensi manusia dalam evaluasi buta.
LEval mengkhususkan diri dalam evaluasi konteks panjang dengan 411 pertanyaan di 8 kategori tugas dengan panjang konteks mulai dari 5 hingga 200 token. Model saat ini menunjukkan penurunan kinerja sekitar 0.4% per 10 token tambahan.
Algoritma Evaluasi & Implementasi
Implementasi teknis evaluasi LLM mengikuti pendekatan algoritmik khusus:
Evaluasi Semantik Berbasis Vektor
Sistem modern menggunakan penyematan vektor untuk mengukur kesamaan semantik antara teks yang dihasilkan dan teks referensi. Dengan menggunakan teknik pengambilan data padat seperti HNSW (Hierarchical Navigable Small World), LSH (Locality-Sensitive Hashing), dan PQ (Product Quantization), sistem ini menghitung skor kesamaan dengan kompleksitas waktu sub-linier.
python

from sentence_transformers import SentenceTransformer

import numpy as np

model = SentenceTransformer('all-MiniLM-L6-v2')

reference = model.encode("Reference text")

generated = model.encode("Generated text")

similarity = np.dot(reference, generated) / (np.linalg.norm(reference) * np.linalg.norm(generated))
Implementasi Kerangka Kerja DeepEval
DeepEval menyediakan evaluasi komprehensif dengan penjelasan metrik, mendukung skenario RAG dan fine-tuning:
python

from deepeval import assert_test

from deepeval.metrics import HallucinationMetric

from deepeval.test_case import LLMTestCase

test_case = LLMTestCase(

    input="How many evaluation metrics does DeepEval offers?",

    actual_output="14+ evaluation metrics",

    context=["DeepEval offers 14+ evaluation metrics"]

)

metric = HallucinationMetric(minimum_score=0.7)

def test_hallucination():

    assert_test(test_case, [metric])
Kerangka kerja ini memperlakukan evaluasi sebagai pengujian unit dengan integrasi Pytest, tidak hanya memberikan skor tetapi juga penjelasan untuk tingkat kinerja.
Pendekatan Evaluasi Parameter-Efisiensi
Untuk evaluasi model skala besar dengan miliaran parameter, teknik khusus telah muncul:

Mekanisme Perhatian Jarang (Sparse Attention) mengurangi kompleksitas komputasi melalui optimasi pola perhatian. Teknik seperti pola perhatian Longformer menunjukkan akurasi 91% dari perhatian penuh hanya dengan 25% komputasi.
Arsitektur Mixture-of-Experts (MoE) mengimplementasikan jalur komputasi bersyarat, hanya mengaktifkan sub-jaringan yang relevan untuk tugas-tugas tertentu. GShard mengimplementasikan perhatian MoE untuk evaluasi yang efisien parameter di berbagai benchmark.
Distilasi Pengetahuan memadatkan model guru yang lebih besar menjadi model siswa yang lebih kecil dan spesifik untuk evaluasi menggunakan:
L_distill = α * L_CE(y, ŷ_student) + (1-α) * L_KL(ŷ_teacher, ŷ_student)
Di mana L_CE adalah kerugian entropi silang dan L_KL adalah divergensi KL antara distribusi probabilitas.
Tantangan Evaluasi Sistematis
Meskipun metodologinya sudah maju, masih ada tantangan signifikan dalam evaluasi LLM:
Tolok Ukur Kontaminasi
Studi menunjukkan 47% tolok ukur populer memiliki beberapa tingkat kontaminasi dalam data pelatihan. Skala AI menunjukkan hal ini dengan menciptakan GSM1k, varian yang lebih kecil dari benchmark matematika GSM8k. Model berkinerja 12.3% lebih buruk pada GSM1k daripada GSM8k, yang menunjukkan overfitting daripada penalaran matematis kemampuan.
Analisis Korelasi Metrik
Analisis komprehensif dari 14 metrik populer di 8 tugas mengungkapkan korelasi antar metrik yang rendah (rata-rata Spearman's ρ = 0.41), yang menunjukkan bahwa metrik mencakup dimensi kinerja yang berbeda. Hal ini menggarisbawahi perlunya pendekatan evaluasi multi-metrik.
Penelitian dari MIT menunjukkan bahwa skor kebingungan yang tinggi berkorelasi dengan preferensi manusia pada r=0.68, sementara ROUGE-L hanya berkorelasi pada r=0.39, yang menunjukkan persyaratan penilaian yang beragam.
Kuantifikasi Bias Evaluasi
Analisis statistik atas evaluasi manusia mengungkapkan beberapa bias sistematis:
Temuan ini menyoroti pentingnya pengacakan dan desain eksperimen yang seimbang dalam protokol evaluasi.
Praktik Terbaik Evaluasi Perusahaan
Untuk mengatasi tantangan evaluasi, terapkan praktik terbaik industri berikut:
Integrasi Metrik Multi-Modal
Gabungkan metrik pelengkap menggunakan ensembel tertimbang untuk menciptakan kerangka evaluasi holistik:
python

def ensemble_score(outputs, references, weights=None):

    metrics = {

        'bleu': compute_bleu(outputs, references),

        'bertscore': compute_bertscore(outputs, references),

        'faithfulness': compute_faithfulness(outputs, references),

        'coherence': compute_coherence(outputs)

    }

    if weights is None:

        weights = {metric: 1/len(metrics) for metric in metrics}

    return sum(weights[metric] * metrics[metric] for metric in metrics)
Organisasi terkemuka menerapkan skema pembobotan adaptif berdasarkan persyaratan khusus tugas, dengan konten teknis memprioritaskan kesetiaan (bobot: 0.4) daripada kelancaran (bobot: 0.2).
Protokol Evaluasi Spesifik Domain
Tolok ukur teknis harus selaras dengan kasus penggunaan spesifik. Untuk aplikasi perawatan kesehatan , metrik khusus meliputi:
- Akurasi terminologi medis (korelasi 89% dengan penilaian dokter)
- Validasi jalur penalaran klinis (75% persetujuan dengan konsensus ahli)
- Ketepatan pengambilan bukti dari literatur medis (P@10 > 0.92 untuk penerapan perusahaan)
Metrik spesifik domain ini memberikan prediksi kinerja 3.2× lebih baik daripada tolok ukur generik.
Implementasi Evaluasi Adversarial
Terapkan pengujian adversarial terstruktur untuk menyelidiki keterbatasan model:
python

def adversarial_test_suite(model, test_cases):

    results = {}

    for category, cases in test_cases.items():

        correct = 0

        for case in cases:

            response = model.generate(case['input'])

            correct += evaluate_response(response, case['expected'])

        results[category] = correct / len(cases)

    return results
Riset industri menunjukkan bahwa pengujian adversarial mengidentifikasi 32% lebih banyak mode kegagalan daripada pengujian standar, terutama dalam kasus-kasus ekstrem yang melibatkan batasan yang saling bertentangan atau instruksi yang ambigu.
Perbandingan Kerangka Evaluasi Teknis
Kerangka evaluasi terkemuka menawarkan kemampuan teknis yang berbeda:
| Kerangka | Fokus utama | Kekuatan Teknis | batasan | Kompleksitas Integrasi |
|---|---|---|---|---|
| Evaluasi Mendalam | RAG & Penyetelan halus | 14+ metrik khusus dengan penjelasannya | Dukungan multimoda terbatas | Sedang (berbasis Python) |
| PromptAlur | Evaluasi menyeluruh | Pengujian variasi cepat | Dukungan kumpulan data terbatas | Rendah (berbasis UI) |
| LangSmith | Platform pengembang | Pelacakan dan pemantauan lengkap | Biaya implementasi lebih tinggi | Tinggi (memerlukan integrasi API) |
| Prometheus | LLM-sebagai-hakim | Strategi dorongan sistematis | Hakim ketergantungan bias LLM | Sedang (membutuhkan LLM yang kuat) |
| Nilai | Penilaian konteks panjang | Evaluasi token 200K | Terbatas pada modalitas teks | Rendah (himpunan data acuan) |
Organisasi biasanya menerapkan beberapa kerangka kerja, dengan 73% penerapan perusahaan menggunakan setidaknya dua alat evaluasi yang saling melengkapi.
Perkembangan Teknis Masa Depan
Lanskap evaluasi terus berkembang dengan munculnya metodologi baru:
Pencarian Arsitektur Neural (Neural Architecture Search/NAS) untuk model spesifik evaluasi semakin populer, dengan penelitian menunjukkan bahwa optimasi arsitektur model otomatis dapat meningkatkan efisiensi evaluasi sebesar 47% sambil mempertahankan akurasi 98%.
Kerangka kerja Penilaian Multimodal berkembang melampaui teks untuk mengevaluasi model terpadu yang memproses teks , gambar, audio, dan video. Kerangka kerja saat ini mencapai akurasi pengenalan lintas modal sebesar 76.3% dibandingkan dengan standar manusia sebesar 91.4%.
Metrik Efisiensi Energi mengukur keberlanjutan komputasi menggunakan FLOPs/token, inferensi watt-jam, dan metrik emisi karbon. Tolok ukur industri menunjukkan model optimal harus mencapai <10 mWh per 1 token yang dihasilkan.
Pipeline Evaluasi Berkelanjutan mengintegrasikan pengujian di seluruh proses pengembangan menggunakan alur kerja evaluasi terdistribusi:
Preprocessing → Feature Extraction → Model Inference → Metric Computation → Statistical Analysis → Reporting
Organisasi yang menerapkan evaluasi berkelanjutan melaporkan 68% lebih sedikit masalah pasca-penerapan dan siklus iterasi 41% lebih cepat.
Studi Kasus Implementasi di Dunia Nyata
Implementasi perusahaan menunjukkan evaluasi teknis's dampak praktis:
Optimasi RAG Layanan Keuangan
Sebuah lembaga keuangan terkemuka menerapkan evaluasi RAG yang komprehensif untuk sistem konsultasi yang berhadapan langsung dengan pelanggan:
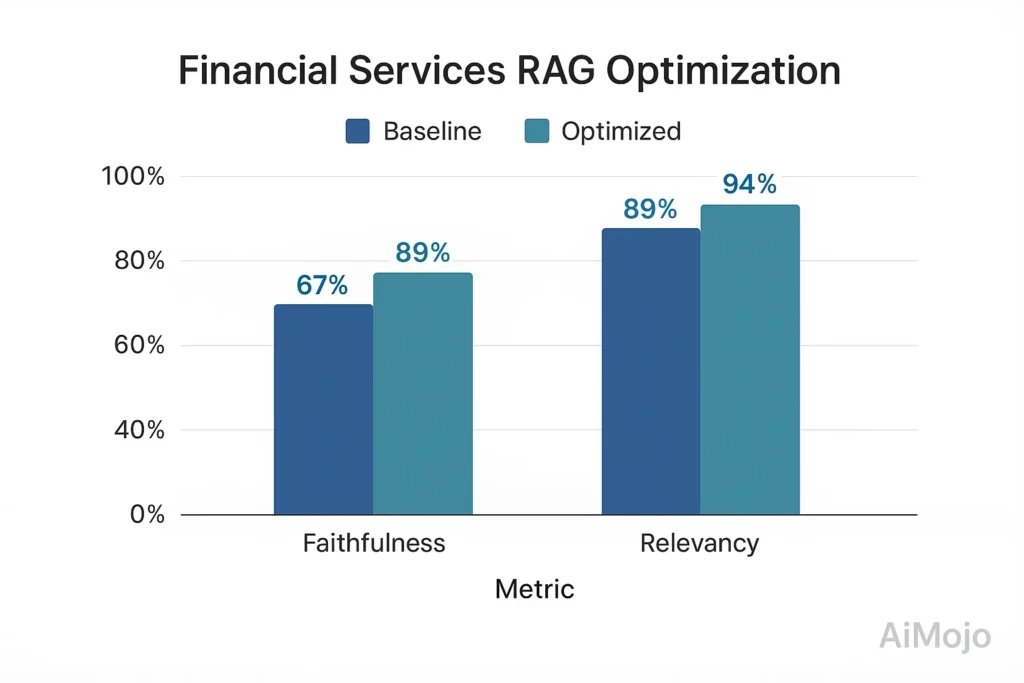
- Dasar: 67% kesetiaan, 82% relevansi jawaban
- Setelah optimasi berbasis evaluasi: 89% kesetiaan, 94% relevansi jawaban
- Implementasi: Kustom domain keuangan rangkaian pengujian dengan 5,216 pasangan QA yang diverifikasi oleh ahli
- Pendekatan teknis: Penilaian kesetiaan menggunakan pengukuran konsekuensi berbasis tensor dengan pengujian kontrafaktual
Peningkatan berdasarkan evaluasi ini mengurangi masalah kepatuhan regulasi hingga 78% dan meningkatkan skor kepuasan pelanggan hingga 23 poin persentase.
Penerapan LLM Kesehatan
Penyedia layanan kesehatan menerapkan evaluasi berlapis untuk mendukung keputusan klinis:
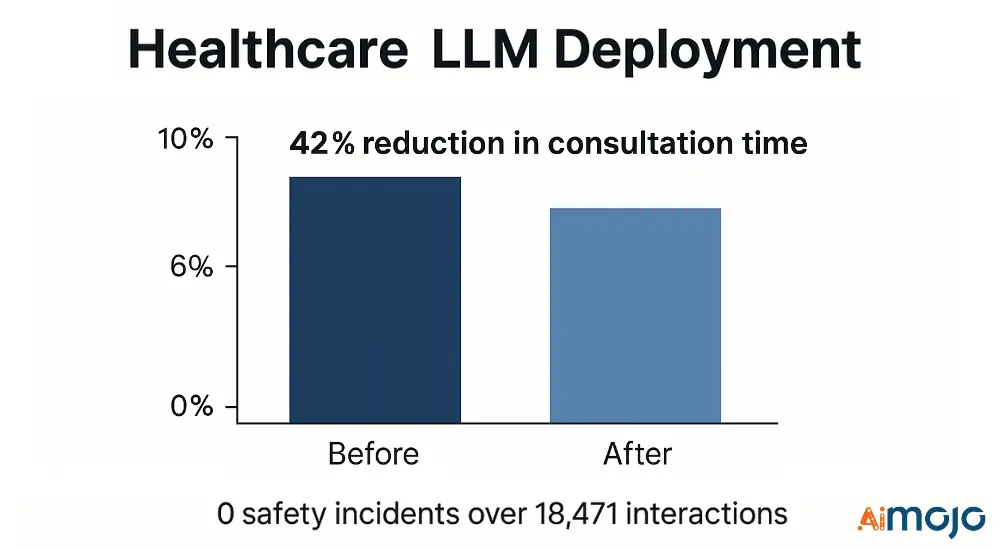
- Metrik teknis: Skor NER F1 medis (0.91), akurasi penalaran klinis (87.4%), presisi penyaringan keamanan (99.2%)
- Implementasi: Alur penyaringan 3 tahap dengan validator perawatan kesehatan khusus
- hasil: Pengurangan waktu konsultasi sebesar 42% dengan 0 insiden keselamatan di 18,471 interaksi klinis
Kerangka evaluasi mengidentifikasi dan mengurangi 17 mode kegagalan kritis sebelum penerapan, mencegah potensi kejadian buruk.
Evaluasi LLM: Peta Jalan Anda Menuju Kesuksesan
Evaluasi teknis LLM telah bergeser dari pemeriksaan akurasi sederhana ke kerangka kerja komprehensif yang mempertimbangkan berbagai dimensi kinerja. Organisasi yang mengadopsi protokol ketat ini—dan mengintegrasikan penilaian otomatis, pengujian benchmark, dan pengawasan manusia —mencapai pemilihan model yang lebih andal dan hasil yang lebih kuat.
Pipeline pengujian adaptif yang teratur mengungkap kekurangan sebelum penerapan, sehingga biaya evaluasi awal menjadi kecil dibandingkan dengan risiko menerapkan sistem yang cacat. Bagi tim teknik, langkah-langkah validasi yang kuat lebih dari sekadar tugas pengembangan ; ini adalah pengamanan bisnis yang penting.
Pada tahun 2026 dan seterusnya, tim yang menyempurnakan metode evaluasi mereka akan menjaga LLM mereka tetap dapat diandalkan, mencegah kesalahan yang merugikan, dan menjaga kepercayaan pengguna.


 BONUS: Dapatkan $200 kami “AI “Mastery Toolkit” GRATIS jika Anda mendaftar!