Escribes un script. Funciona a la perfección en un sitio de prueba. Luego lo diriges a una importante tienda o plataforma social. De repente, tu terminal se llena de errores 403 Forbidden o bucles CAPTCHA infinitos.
La era del análisis simple de HTML ha terminado.
El web scraping moderno requiere más que simplemente enviar una solicitud GET. Los sitios web actuales son aplicaciones complejas protegidas por defensas robustas. Si desea sortear los bloqueos de web scraping , debe comprender cómo se comunican los navegadores con los servidores.
Plataformas importantes como Cloudflare, Akamai y Datadome actúan como guardianes. Analizan cada conexión entrante y comprueban si eres un humano o un script. Para superarlos, necesitas herramientas que imiten a la perfección el comportamiento humano.
Te mostraremos cómo extraer datos de sitios web dinámicos de forma eficaz y por qué delegar estas tareas a Decodo es la decisión más inteligente para tu flujo de datos.
La necesidad “sin cabeza”: por qué fallan las solicitudes simples

Antes, los sitios web enviaban páginas HTML completas desde el servidor. El script descargaba el texto y se extraían los datos.
Actualmente, más del 70 % de los sitios de comercio electrónico modernos utilizan la renderización del lado del cliente (CSR). Al solicitar una URL, el servidor envía una estructura HTML vacía. El contenido real (precios, inventario, descripciones) se carga posteriormente mediante JavaScript.
Si usas una biblioteca HTTP estándar, obtienes ese shell vacío. Pierdes todos los datos.
Para visualizar el contenido, se requiere renderizado con JavaScript para el web scraping . Esto generalmente implica ejecutar un navegador como Chrome o Firefox en segundo plano, sin interfaz gráfica. Esto se conoce como web scraping sin interfaz gráfica.
Ejecutar navegadores sin interfaz gráfica consume muchos recursos. Consume mucha RAM y CPU. Además, presenta un nuevo problema: la detección.
Descifrando el código de los sistemas anti-bots
Los sistemas de seguridad no solo analizan tu dirección IP , sino que también inspeccionan el comportamiento de tu navegador.
Si usas una biblioteca de automatización estándar, deja rastros. Podría establecer una variable como navigator.webdriver = true. Esto es una señal clara. Los sistemas anti-bots detectan esta señal y te bloquean inmediatamente.
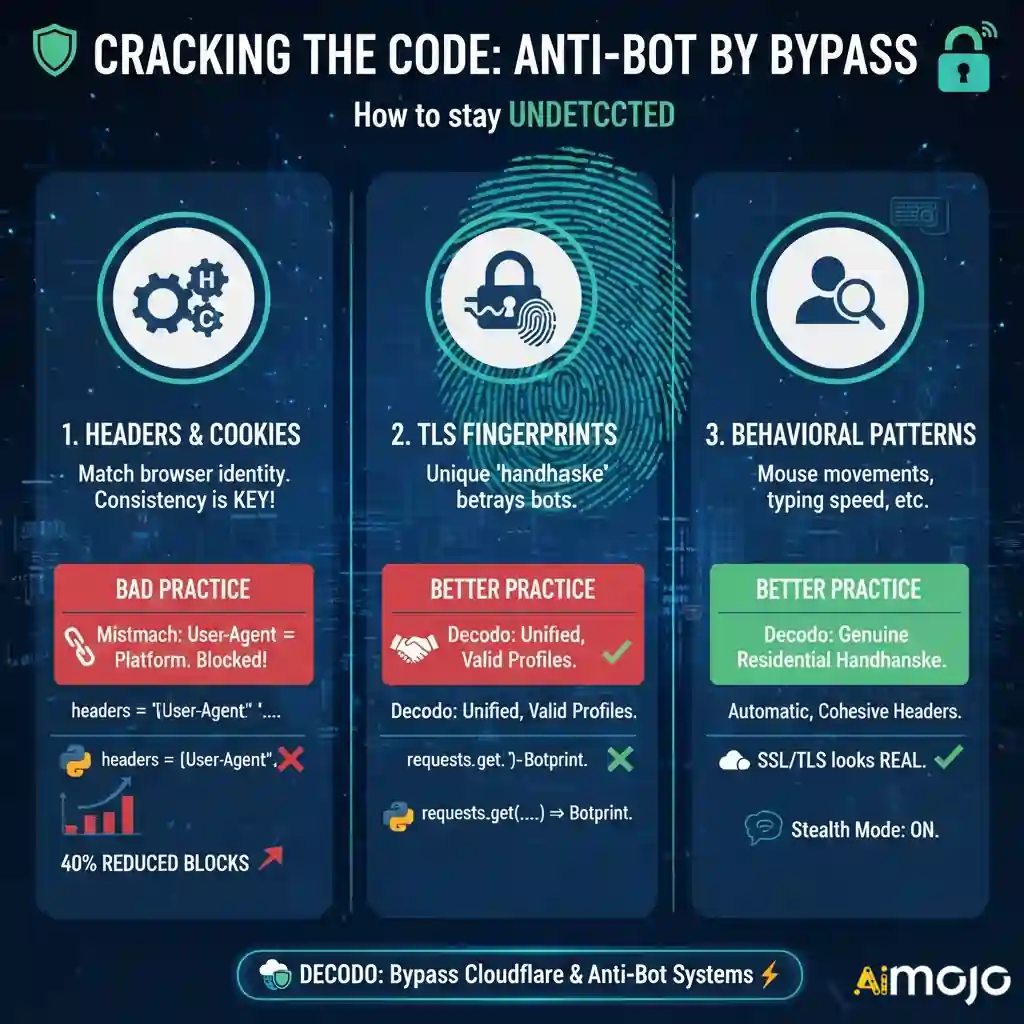
Para eludir las protecciones de Cloudflare contra el web scraping, debe gestionar tres capas críticas:
1. ¿Por qué son importantes los encabezados coincidentes en el web scraping?
Los encabezados de tu solicitud le indican al servidor quién eres. El más conocido es el User-Agent. Sin embargo, simplemente cambiar la cadena User-Agent no es suficiente.
Los encabezados deben funcionar como una unidad cohesiva. Si envías un agente de usuario que dice ser Chrome en Windows, pero los encabezados de tu plataforma parecen ser de Linux, se bloqueará. Esta discrepancia es una de las principales causas de los fallos de scraping.
Administrar correctamente los encabezados de solicitud puede reducir las tasas de bloqueo hasta en un 40% incluso antes de rotar un proxy.
# Esto a menudo se bloquea inmediatamente.
solicitudes de importación
encabezados = {'User-Agent': 'Mozilla/5.0'}
respuesta = solicitudes.get('https://ejemplo.com', encabezados=encabezados)
Decodo crea automáticamente perfiles de encabezado válidos y consistentes . Garantiza que las sugerencias de Accept-Language, Referer y platform coincidan con la versión del navegador que se está imitando.
2. La trampa oculta: la huella digital TLS
Aquí es donde la mayoría de los raspadores personalizados fallan.
Cuando su script inicia una conexión HTTPS segura, realiza un protocolo de enlace con el servidor. El orden y los parámetros de este protocolo crean una huella digital única, a menudo denominada hash JA3.
La biblioteca requests de Python utiliza un protocolo de enlace muy diferente al de un navegador Chrome real . Cloudflare detecta esta diferencia al instante. Incluso si tus encabezados son perfectos, tu estrategia para eludir la huella digital TLS podría fallar si el protocolo de enlace te delata.
Decodo gestiona esto en el backend. Modifica la negociación SSL/TLS de bajo nivel para que se vea exactamente como un usuario real navegando desde una conexión residencial.
Las mejores tácticas para extraer datos de aplicaciones de una sola página de forma segura

Las aplicaciones de una sola página (SPA) son conocidas por ser difíciles de extraer datos. Cargan los datos de forma asíncrona. Un programa de extracción puede activar la carga de la página, pero si extrae los datos demasiado pronto, no obtiene nada.
Para extraer el contenido de los sitios web de spa, es necesario esperar a que la red esté en estado inactivo. Esto significa que el navegador espera a que finalicen todas las llamadas a la API en segundo plano antes de obtener el HTML.
Implementar esto manualmente con herramientas como Puppeteer o Selenium es inestable. Los scripts fallan. Los elementos cambian los nombres de los identificadores. Las fugas de memoria ralentizan el servidor.
La API de web scraping de Decodo simplifica este proceso. Envías una solicitud, Decodo abre el navegador, renderiza el código JavaScript, espera a que la red se estabilice y devuelve el HTML limpio.
Cree flujos de trabajo de scraping escalables e indetectables con Decodo

Crear una red de rastreo de navegadores sin interfaz gráfica es costoso. Hay que parchar los controladores de Chrome, rotar miles de IP y actualizar el código constantemente cuando Cloudflare cambia su algoritmo.
Decodo ofrece una infraestructura especializada de extracción automatizada de datos de navegador que se encarga del trabajo pesado.
Características clave para la evasión
La plataforma está diseñada para sortear los bloqueos de web scraping centrándose en la imitación y la fiabilidad:
Guía de integración rápida: uso de la API de scraping de Decodo
Así de sencillo es cambiar de un script local bloqueado a Decodo. No necesitas administrar el navegador tú mismo.
import requests

# Decodo API Endpoint

url = "https://api.decodo.com/v1/scrape"

payload = {

    "url": "https://difficult-site.com/products",

    "render_js": True,  # Activates Headless Browser

    "wait_for_selector": ".product-price", # Waits for dynamic content

    "country": "US" # Uses premium US residential proxies

}

headers = {

    "Authorization": "Bearer YOUR_DECODO_API_KEY",

    "Content-Type": "application/json"

}

response = requests.post(url, json=payload, headers=headers)

if response.status_code == 200:

    print("Scraping Successful!")

    print(response.json()['content'])

else:

    print("Error:", response.text)
Fíjate en la simplicidad. No estás importando Selenium. No estás descargando Chromedriver. Simplemente le dices a Decodo: "Necesito esta URL y, por favor, renderiza el JavaScript ".
Elegir entre la API de Puppeteer, Selenium o Decodo
Muchos desarrolladores empiezan con herramientas de código abierto. Es útil comprender las ventajas y desventajas de usar puppeteer, selenium y API.
Selenium: Excelente para realizar pruebas, pero lento y fácilmente detectable. Requiere modificaciones importantes para evitar que los sistemas antibots evadan la detección.
Titiritero/Dramaturgo: Más rápido y mejor para la renderización de JavaScript para web scraping. Sin embargo, mantener un conjunto de estas instancias requiere un conocimiento significativo de DevOps. Aún así, es necesario resolver manualmente los problemas de proxy y huella digital.

API Decodo: La opción más eficiente. Ofrece la potencia de un navegador sin interfaz gráfica sin necesidad de mantenimiento. Resuelve de forma inmediata el problema de la omisión de huellas digitales TLS y la gestión de encabezados.
Con la API de Decodo, los equipos ahorran tiempo de desarrollo, reducen los costos de infraestructura y logran mayores tasas de éxito de raspado en sitios web modernos complejos.
Raspar con más inteligencia, no con más esfuerzo: deja que Decodo se encargue
La web se está volviendo más cerrada. Evadir la detección de bots es una carrera armamentística. Si dedicas tu tiempo de ingeniería a luchar contra Cloudflare, no estás dedicando tiempo a analizar tus datos.
No necesitas construir una infraestructura compleja para extraer datos de sitios web dinámicos . Con Decodo, obtienes acceso a la extracción de datos de navegadores sin interfaz gráfica de nivel empresarial, una gestión de sesiones adecuada y una rotación avanzada de huellas digitales.
Deja de bloquearte. Deja que Decodo se encargue de las complejidades del navegador mientras tú te concentras en la información.
AiMojo recomienda:


 BONUS: Obtenga nuestros $200 “AI “Mastery Toolkit” ¡GRATIS cuando te registras!