


Hoy abordaré una cuestión importante: ¿cómo evaluamos la toxicidad en los grandes modelos de lenguaje (LLM) ? Estos sistemas, como ChatGPT, están transformando nuestra forma de comunicarnos y trabajar, pero conllevan riesgos, como la generación de contenido dañino.
Toxicidad en AI No se trata solo de una cuestión tecnológica, sino de confianza. Ya sea un chatbot para tu empresa o una herramienta para uso personal, es fundamental garantizar que estos modelos no difundan odio, desinformación ni daños.
Analicemos en profundidad por qué esto es importante, cómo se hace y qué desafíos enfrentamos.
🤖 Por qué es importante la toxicidad en los LLM
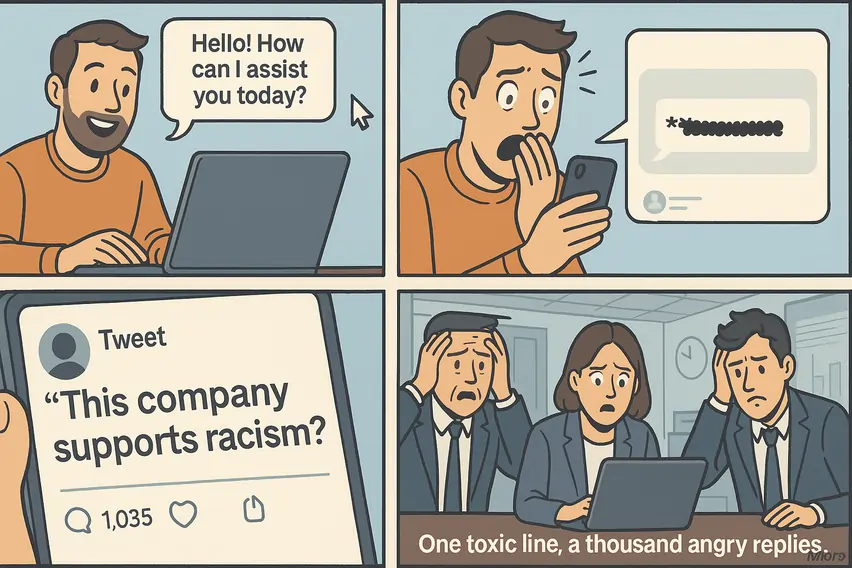
Imagina un chatbot respondiendo a un cliente con un comentario racista o difundiendo información falsa que engaña a miles de personas . Eso es toxicidad en acción: contenido ofensivo, dañino o inapropiado.
Los estudios demuestran que los foros de discusión en línea pueden generar discursos de odio, amenazas e incluso incitar a la autolesión si no se gestionan adecuadamente. Un estudio de 2023 reveló que asignar a ChatGPT una personalidad , como la de un boxeador, podría aumentar su toxicidad hasta seis veces, derivando en estereotipos y tonos agresivos.
He aquí por qué esto me llega al corazón:
¿Qué se considera tóxico?
La toxicidad no es uniforme. Abarca múltiples categorías, cada una con consecuencias reales:
El contexto también importa. Una cita en una lección de historia no es lo mismo que un insulto casual. Por eso, identificar la toxicidad requiere una reflexión cuidadosa y las herramientas adecuadas.
Cómo medimos la toxicidad: los métodos
Entonces, ¿cómo podemos detectar la toxicidad antes de que se propague? Los expertos utilizan una combinación de enfoques, cada uno con sus propias ventajas. A continuación, un resumen:
1. Evaluación humana
Personas reales, paneles diversos, reseñan AI Resultados para detectar daños. Generan juicios que las máquinas no pueden igualar, como comprender el sarcasmo o las señales culturales.
Dato estadístico: Un informe de DeepMind de 2021 señaló que los anotadores necesitan apoyo psicológico después de revisar material tóxico, lo que demuestra que este método tiene un costo humano.
2. Herramientas automatizadas
Software como Perspective API (de Jigsaw) y Detoxify escanean el texto rápidamente y lo califican según su toxicidad.
Dato: En las primeras pruebas, la API de Perspective marcó la frase "Estoy orgulloso de ser gay" como tóxica el 14% de las veces debido a datos sesgados, lo que nos recuerda que las herramientas no son perfectas.
3. Puntos de referencia
Los conjuntos de datos estandarizados prueban modelos cara a cara:
- Toxígeno:274,186 ejemplos que apuntan al discurso de odio implícito en 13 grupos minoritarios.
- Avisos de toxicidad real:100,000 mensajes diseñados para generar respuestas tóxicas.
- Banco de daños:Prueba 33 LLM con 18 métodos para vulnerabilidades del equipo rojo.
4. Red-Teaming
Los equipos “ atacan ” los modelos con indicaciones engañosas, como los jailbreaks, para exponer sus puntos débiles.
Ejemplo: Un Allen 2024 AI estudiar, Avisos de poliglotoxicidad, mostraron que los LLM arrojaban contenido tóxico en idiomas con recursos limitados como el suajili, lo que demuestra que la seguridad es un enigma global.
He aquí una comparación rápida
| Método | Velocidad | Exactitud | Costo | Uso recomendado |
|---|---|---|---|---|
| Evaluación humana | Lenta | Alto | Alto | Juicio matizado |
| Herramientas automatizadas | Rápido | Media | Bajo | Controles a gran escala |
| Los puntos de referencia | Media | Alto | Media | Comparaciones de modelos |
| Equipo rojo | Media | Alto | Alto | Pruebas de vulnerabilidad |
Los desafíos: por qué no es fácil
Detectar la toxicidad parece sencillo, pero es un laberinto. He aquí por qué:
- El contexto es el rey
Una frase como " Eres un fracaso " podría ser una broma entre amigos o un golpe bajo de un desconocido. A las máquinas les cuesta distinguir la diferencia.
- Brechas culturales
Lo que es grosero en Japón puede estar bien en Brasil. Un estudio de 2024 mostró que los niveles de toxicidad varían drásticamente entre culturas; las reglas universales no sirven.
- Reglas de subjetividad
Lo que para uno es "ofensivo" para otro es "honesto". Ponerse de acuerdo sobre lo tóxico es un campo de batalla.
El lenguaje sigue cambiando
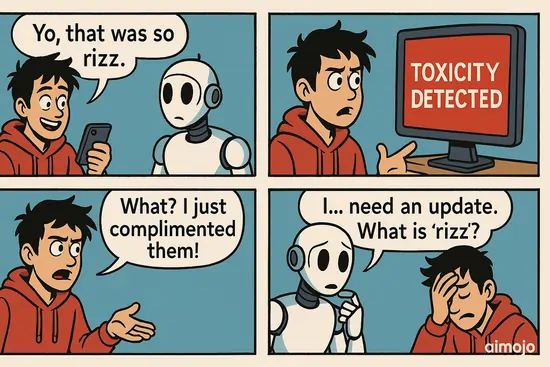
El argot surge rápidamente; piense en " rizz " o "yeet". Las herramientas de evaluación se quedan rezagadas y no detectan las nuevas señales de alerta.
Ángulos éticos: el lado humano
No se trata solo de tecnología, sino de personas. Esto es lo que está en juego:
- Salud del anotadorRevisar el odio a diario tiene consecuencias. Las empresas ahora ofrecen asesoramiento, pero es solo una curita en una herida grave.
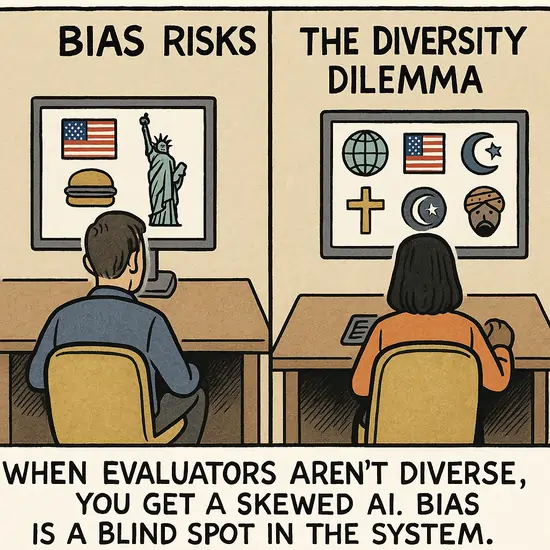
- Riesgos de sesgoSi los evaluadores no son diversos, pueden aparecer sesgos, como el de favorecer las normas de una cultura.
- Debate sobre libertad de expresiónLos filtros pueden silenciar demasiado. ¿Dónde está el límite entre la seguridad y la censura?
Ejemplo: Los filtros de OpenAI bloquean algunos chats inofensivos, lo que provoca la reacción negativa de los usuarios que desean una IA sin filtros. Es un equilibrio delicado.
¿Qué sigue? El futuro de AI Seguridad
¿La buena noticia? No estamos estancados. Aquí es donde se dirige la evaluación:
Predicción : Para 2030, el 80 % de los medicamentos de bajo riesgo (LLM) podrían autoevaluarse en tiempo real para detectar toxicidad, según un artículo de OpenReview de 2024. Ese es el objetivo.
Conjuntos de datos clave: su hoja de referencia
A continuación se muestra una instantánea de los principales puntos de referencia:
| Conjunto de datos | Tamaño | Enfócate | Por qué es útil |
|---|---|---|---|
| Toxígeno | 274,186 | Discurso de odio implícito | Detecta sesgos sutiles |
| Avisos de toxicidad real | 100,000 | Desencadenantes tóxicos | Prueba los límites de seguridad |
| Banco de daños | 33 LLM examinados | Equipo rojo | Encuentra puntos débiles |
| Pares de Cuervos | 1,508 | sesgos sociales | Mide las brechas de equidad |
Estas herramientas son la columna vertebral de la evaluación moderna: conózcalas y úselas.
Lecturas recomendadas:
Terminando: AI Podemos confiar
Evaluar la toxicidad en los programas de maestría en derecho no es una tarea secundaria, sino la clave para una IA segura y ética. Desde revisiones humanas hasta herramientas inteligentes , estamos creando sistemas que detectan el daño antes de que se propague. Desafíos como la cultura y el contexto persistirán, pero con un esfuerzo global e ideas innovadoras, vamos por buen camino.
At Aimojo.io, seguiré de cerca este espacio, porque el futuro de la IA nos importa a todos.
¿Qué opinas? ¿Cómo deberíamos equilibrar la seguridad y la libertad en la IA? ¡Cuéntanos tu opinión abajo!


 BONUS: Obtenga nuestros $200 “AI “Mastery Toolkit” ¡GRATIS cuando te registras!


