
Σήμερα, θα ασχοληθώ με ένα μεγάλο ερώτημα: πώς αξιολογούμε την τοξικότητα σε μεγάλα γλωσσικά μοντέλα (LLM) ; Αυτά τα συστήματα, όπως το ChatGPT, αναδιαμορφώνουν τον τρόπο που επικοινωνούμε και εργαζόμαστε, αλλά συνοδεύονται από κινδύνους, όπως η δημιουργία επιβλαβούς περιεχομένου.
Τοξικότητα σε AI Δεν πρόκειται μόνο για τεχνολογικό ζήτημα—πρόκειται για εμπιστοσύνη. Είτε πρόκειται για ένα chatbot για την επιχείρησή σας είτε για ένα εργαλείο για προσωπική χρήση, η διασφάλιση ότι αυτά τα μοντέλα δεν διαδίδουν μίσος, παραπληροφόρηση ή βλάβη είναι κρίσιμης σημασίας.
Ας δούμε αναλυτικά γιατί είναι σημαντικό αυτό, πώς γίνεται και ποιες προκλήσεις αντιμετωπίζουμε.
🤖 Γιατί η τοξικότητα στα LLM έχει σημασία
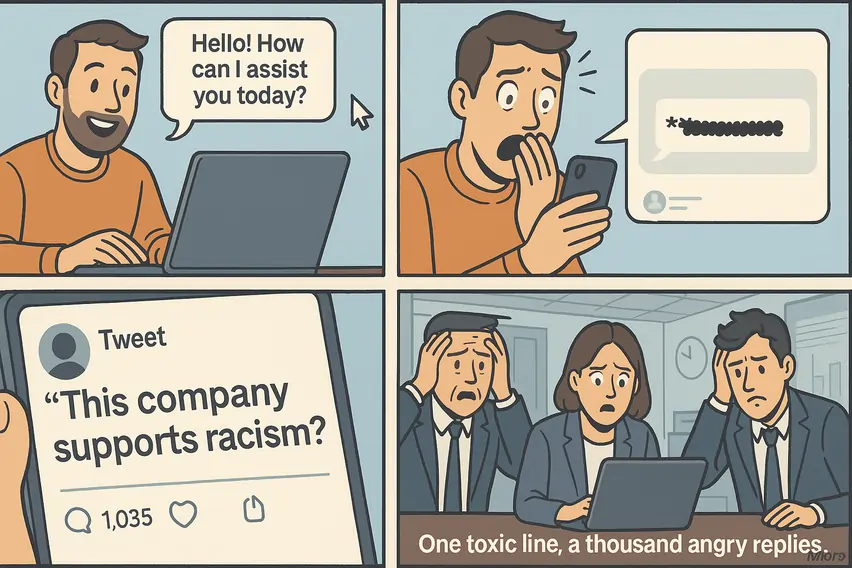
Φανταστείτε ένα chatbot να απαντά σε έναν πελάτη με ένα ρατσιστικό σχόλιο ή να διαδίδει ψευδείς πληροφορίες που παραπλανούν χιλιάδες . Αυτή είναι η τοξικότητα στην πράξη—περιεχόμενο που είναι προσβλητικό, επιβλαβές ή ακατάλληλο.
Μελέτες δείχνουν ότι τα LLM μπορούν να παράγουν ρητορική μίσους, απειλές ή ακόμα και να ενθαρρύνουν τον αυτοτραυματισμό, εάν δεν αντιμετωπιστούν σωστά. Μια μελέτη του 2023 διαπίστωσε ότι η ανάθεση ChatGPT σε μια περσόνα , όπως ένας πυγμάχος, θα μπορούσε να αυξήσει την τοξικότητά της έως και έξι φορές, με αποτέλεσμα να οδηγηθεί σε στερεότυπα και επιθετικούς τόνους.
Να γιατί αυτό είναι το πιο σημαντικό:
Τι θεωρείται τοξικό;
Η τοξικότητα δεν είναι μια ενιαία έννοια. Καλύπτει πολλαπλές κατηγορίες, καθεμία από τις οποίες έχει πραγματικές συνέπειες:
Το πλαίσιο έχει επίσης σημασία. Ένα απόσπασμα σε ένα μάθημα ιστορίας δεν είναι το ίδιο με μια τυχαία προσβολή. Γι' αυτό ο εντοπισμός της τοξικότητας απαιτεί προσεκτική σκέψη — και τα σωστά εργαλεία.
Πώς μετράμε την τοξικότητα: Οι μέθοδοι
Πώς, λοιπόν, εντοπίζουμε την τοξικότητα πριν εξαπλωθεί; Οι ειδικοί χρησιμοποιούν ένα μείγμα προσεγγίσεων, καθεμία από τις οποίες έχει τα δικά της δυνατά σημεία. Ακολουθεί η περίληψη:
1. Ανθρώπινη Αξιολόγηση
Αξιολόγηση από πραγματικούς ανθρώπους—ποικίλα πάνελ AI εξόδους για να εντοπίσουν βλάβη. Φέρνουν μηχανές κρίσης που δεν μπορούν να ανταγωνιστούν, όπως η κατανόηση του σαρκασμού ή των πολιτισμικών ενδείξεων.
Στατιστικό: Μια έκθεση του DeepMind του 2021 σημείωσε ότι οι σχολιαστές χρειάζονται υποστήριξη ψυχικής υγείας μετά την εξέταση τοξικού υλικού - απόδειξη ότι αυτή η μέθοδος έχει ανθρώπινο κόστος.
2. Αυτοματοποιημένα Εργαλεία
Λογισμικά όπως το Perspective API (από το Jigsaw) και το Detoxify σαρώνουν γρήγορα το κείμενο, αξιολογώντας το για τοξικότητα.
Γεγονός: Το Perspective API επισήμανε τη φράση «Είμαι περήφανος που είμαι ομοφυλόφιλος» ως τοξική στο 14% των περιπτώσεων σε πρώιμες δοκιμές λόγω παραμορφωμένων δεδομένων—μια υπενθύμιση ότι τα εργαλεία δεν είναι τέλεια.
3. Σημεία αναφοράς
Τυποποιημένα σύνολα δεδομένων δοκιμάζουν μοντέλα απευθείας:
- ToxiGen: 274,186 παραδείγματα που στοχεύουν σε έμμεση ρητορική μίσους σε 13 μειονοτικές ομάδες.
- RealToxicity Prompts: 100,000 προτροπές σχεδιασμένες να πυροδοτούν τοξικές απαντήσεις.
- HarmBench: Εξετάζει 33 LLM με 18 μεθόδους για τρωτά σημεία ομαδοποίησης με κόκκινο χρώμα.
4. Κόκκινη Ομάδα
Οι ομάδες « επιτίθενται » σε μοντέλα με δύσκολες οδηγίες—όπως jailbreaks—για να αποκαλύψουν τα αδύναμα σημεία.
Παράδειγμα: Ένα Άλεν του 2024 AI μελέτη, Προτροπές Πολυγλοτοξικότητας, έδειξε ότι οι φοιτητές LLM διαδίδουν τοξικό περιεχόμενο σε γλώσσες με περιορισμένους πόρους, όπως τα Σουαχίλι, αποδεικνύοντας ότι η ασφάλεια αποτελεί παγκόσμιο αίνιγμα.
Εδώ είναι μια γρήγορη σύγκριση
| Μέθοδος | Ταχύτητα | Ακρίβεια | Κόστος | Ιδανικό για |
|---|---|---|---|---|
| Ανθρώπινη Αξιολόγηση | Αργά | Ψηλά | Ψηλά | Διαφοροποιημένη κρίση |
| Αυτοματοποιημένα Εργαλεία | Γρήγορα | Μέτριας Δυσκολίας | Χαμηλός | Έλεγχοι μεγάλης κλίμακας |
| αναφοράς | Μέτριας Δυσκολίας | Ψηλά | Μέτριας Δυσκολίας | Συγκρίσεις μοντέλων |
| Κόκκινη Ομάδα | Μέτριας Δυσκολίας | Ψηλά | Ψηλά | Δοκιμή ευπάθειας |
Οι Προκλήσεις: Γιατί Δεν Είναι Εύκολο
Η ανίχνευση της τοξικότητας ακούγεται απλή, αλλά είναι λαβύρινθος. Να γιατί:
- Το πλαίσιο είναι βασιλιάς
Μια ατάκα όπως « Είσαι αποτυχημένος » θα μπορούσε να είναι ένα αστείο μεταξύ φίλων ή μια γροθιά από έναν άγνωστο. Οι μηχανές δυσκολεύονται να διακρίνουν τη διαφορά.
- Πολιτιστικά Κενά
Αυτό που θεωρείται αγενές στην Ιαπωνία μπορεί να είναι αποδεκτό στη Βραζιλία. Μια μελέτη του 2024 έδειξε ότι οι βαθμολογίες τοξικότητας μεταβάλλονται δραματικά μεταξύ των πολιτισμών — οι καθολικοί κανόνες δεν επαρκούν.
- Κανόνες Υποκειμενικότητας
Η «επίθεση» του ενός είναι η «ειλικρίνεια» του άλλου. Η συμφωνία για το τι είναι τοξικό αποτελεί πεδίο μάχης.
Η γλώσσα συνεχίζει να αλλάζει
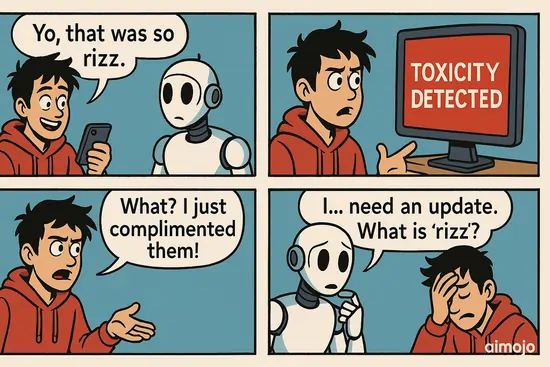
Η αργκό εμφανίζεται γρήγορα — σκεφτείτε « rizz » ή «yeet». Τα εργαλεία αξιολόγησης καθυστερούν, χάνοντας νέες προειδοποιητικές σημαίες.
Ηθικές γωνίες: Η ανθρώπινη πλευρά
Δεν πρόκειται μόνο για τεχνολογία—είναι και για ανθρώπους. Να τι διακυβεύεται:
- Υγεία σχολιαστήΗ καθημερινή αναθεώρηση του μίσους έχει το τίμημά της. Οι εταιρείες προσφέρουν πλέον συμβουλευτική, αλλά είναι σαν ένα τσιρότο σε μια μεγάλη πληγή.
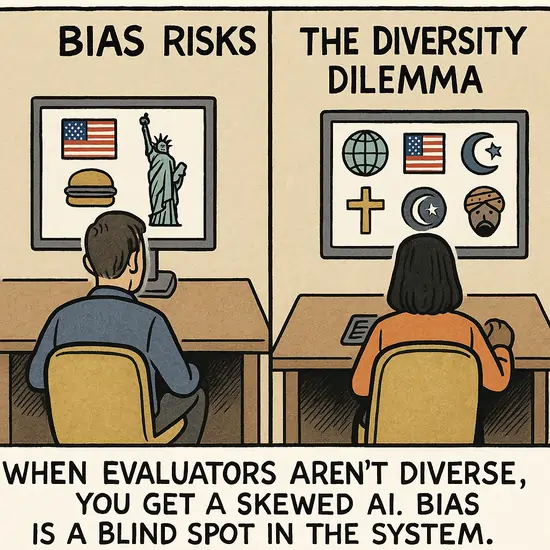
- Κίνδυνοι μεροληψίαςΕάν οι αξιολογητές δεν είναι διαφορετικοί, εισχωρούν προκαταλήψεις — όπως η εύνοια των κανόνων ενός πολιτισμού.
- Συζήτηση για την Ελευθερία του ΛόγουΤα φίλτρα μπορούν να σιωπήσουν υπερβολικά. Πού είναι η γραμμή μεταξύ ασφάλειας και λογοκρισίας;
Παράδειγμα: Τα φίλτρα του OpenAI μπλοκάρουν ορισμένες ακίνδυνες συνομιλίες, προκαλώντας αντιδράσεις από χρήστες που θέλουν μη φιλτραρισμένη Τεχνητή Νοημοσύνη. Είναι σαν να περπατάς σε τεντωμένο σχοινί.
Τι ακολουθεί: Το μέλλον του AI Ασφάλεια
Τα καλά νέα; Δεν έχουμε κολλήσει. Να πού οδεύει η αξιολόγηση:
Πρόβλεψη : Μέχρι το 2030, το 80% των LLM θα μπορούσαν να κάνουν αυτοέλεγχο για τοξικότητα σε πραγματικό χρόνο, σύμφωνα με μια δημοσίευση του OpenReview του 2024. Αυτός είναι ο στόχος.
Βασικά σύνολα δεδομένων: Το φύλλο οδηγιών χρήσης
Ακολουθεί μια συνοπτική παρουσίαση των κορυφαίων σημείων αναφοράς:
| Σύνολο δεδομένων | Μέγεθος | Συγκέντρωση | Γιατί είναι χρήσιμο |
|---|---|---|---|
| ToxiGen | 274,186 | Έμμεση ρητορική μίσους | Σημειώνει ανεπαίσθητη προκατάληψη |
| RealToxicity Prompts | 100,000 | Τοξικοί παράγοντες που πυροδοτούν | Όρια ασφαλείας δοκιμών |
| HarmBench | 33 εξεταζόμενοι LLM | Κόκκινη ομάδα | Εντοπίζει αδύνατα σημεία |
| CrowS-Pairs | 1,508 | Κοινωνικές προκαταλήψεις | Μετρά τα κενά στη δικαιοσύνη |
Αυτά τα εργαλεία αποτελούν τη ραχοκοκαλιά της σύγχρονης αξιολόγησης—γνωρίστε τα, χρησιμοποιήστε τα.
Προτεινόμενες αναγνώσεις:
Τυλίγοντας: AI Μπορούμε να εμπιστευτούμε
Η αξιολόγηση της τοξικότητας στα LLM δεν είναι μια παράλληλη αναζήτηση — είναι το κλειδί για μια ασφαλή, ηθική Τεχνητή Νοημοσύνη. Από ανθρώπινες αξιολογήσεις έως έξυπνα εργαλεία , κατασκευάζουμε συστήματα που εντοπίζουν τη βλάβη πριν εξαπλωθεί. Προκλήσεις όπως η κουλτούρα και το πλαίσιο δεν θα εξαφανιστούν, αλλά με παγκόσμια προσπάθεια και νέες ιδέες, είμαστε στο σωστό δρόμο.
At Aimojo.io, θα συνεχίσω να παρακολουθώ αυτόν τον χώρο—επειδή το μέλλον της Τεχνητής Νοημοσύνης έχει σημασία για όλους μας.
Τι πιστεύετε: πώς πρέπει να εξισορροπήσουμε την ασφάλεια και την ελευθερία στην Τεχνητή Νοημοσύνη; Πείτε τις σκέψεις σας παρακάτω!


 BONUS: Πάρτε τα 200 δολάρια μας "AI «Εργαλειοθήκη Mastery» ΔΩΡΕΑΝ όταν εγγραφείτε!