

Wichtige Erkenntnisse zu Fish Audio
Fisch-Audio ist ein AI Sprachgenerator zur Umwandlung von Text in Sprache, der einen zulässigen Sprecher wiedergibt's Sprachausgabe und das Hinzufügen von Sprachausgabe zu Software. Es dient Kreativen, die eine Sprachaufnahme wünschen, ohne jede Zeile selbst aufzunehmen, aber die Entwicklerwerkzeuge sind ebenso wichtig: SpracherzeugungTranskription, Audio-Streaming und persistente Sprachkennungen sind über APIs verfügbar.
Meiner redaktionellen Meinung nach verdient Fish Audio Aufmerksamkeit für seine ausdrucksstarken Sprachsteuerungsfunktionen und nicht für das Versprechen, dass jeder generierte Clip menschlich klingen wird.
Der Praxistest ist schwieriger: Können Sie über eine 20-minütige Unterrichtsstunde hinweg eine erkennbare Stimme beibehalten, Produktnamen korrekt aussprechen, zwischen Sprachen wechseln, ohne Ihre Identität zu verlieren, und die Kosten bei steigender Nutzung prognostizieren? Ich habe diese Fragen anhand der aktuellen Produktkontrollen, der technischen Dokumentation, der Preise und der Lizenzbedingungen bewertet. Die folgenden Workflow-Empfehlungen basieren auf meiner Produktionsbewertung und stellen keine Behauptung privater Audio-Benchmarks dar.
Was ist Fish Audio und wer braucht eigentlich seine Sprachmodelle?
Fish Audio ist eine browserbasierte und API-zugängliche Sprachplattform, die von Hanabi entwickelt wurde. AI Die zentrale Kompetenz von Inc. ist Text-zu-Sprache-SyntheseSie geben ein Skript ein, wählen eine Stimme und generieren eine Audiodatei. Die Stimmenklonung ermöglicht es, eine Sprecheridentität aus Referenzaufnahmen abzuleiten; Voice Design hingegen erstellt ein neues Stimmkonzept anhand einer schriftlichen Beschreibung.
Für einen YouTube-Editor bedeutet das wiederverwendbare Sprachaufnahmen. Für einen E-Learning-Anbieter bedeutet es, einen Absatz korrigieren zu können, ohne den Dozenten erneut hinzuziehen zu müssen. Für einen Spieleentwickler bedeutet es, mehrere Charakterstimmen zu erstellen. Für einen Callcenter-Mitarbeiter bedeutet es, eine gesprochene Antwort eines Assistenten zu streamen, nachdem dessen Sprachmodell entschieden hat, was zu sagen ist.
Es ist kein Ersatz für Drehbuchschreiben, Tonmischung, redaktionelle Genehmigung oder die Erlaubnis zur Verwendung einer anderen Person's Ich würde Fish Audio als Sprachproduktionsebene innerhalb dieser Jobs positionieren, nicht als vollständigen Ersatz für ein Tonstudio oder einen Videoeditor.
Fish Audio S2.1 Pro versus Drama 3: Welches Modell sollten Sie wählen?
S2.1 Pro ist die allgemeine Produktionslösung; Drama 3 eignet sich besonders für Regie und Performance. Beide erzeugen Sprache, ihre Stärken liegen jedoch in unterschiedlichen Bereichen. S2.1 Pro unterstützt 83 Sprachen, Mehrsprecher-Text und Regieanweisungen in natürlicher Sprache in eckigen Klammern. Die kostenlose API-Variante s2.1-pro-free nutzt dasselbe zugrundeliegende Modell für die Entwicklung, unterliegt jedoch Nutzungsbeschränkungen und bietet keine Liefergarantie.
Drama 3 gibt Autoren mehr Kontrolle darüber, wie ein Satz gesprochen wird. Anweisungen können den Zuhörer, die emotionale Absicht oder das Sprechtempo beschreiben. Es unterstützt außerdem die Platzierung von Lauten und Pausen, Aussprachehinweise und Variationen der Sprechweise innerhalb weniger Wörter. Dadurch eignet es sich besonders für Trailer, Dialoge und fiktive Charaktere, bei denen eine neutrale Lesung leblos wirkt.
S2 Pro ist weiterhin für bestehende Projekte verfügbar. S1 ist veraltet und sollte daher bei der Entwicklung neuer Systeme nicht mehr verwendet werden. Bei Softwareprojekten sollte das Modell explizit festgelegt werden, anstatt davon auszugehen, dass ein SDK-Standardwert aktuell bleibt.
Wie sich in Klammern gesetzte Emotionskennzeichnungen auswirken AI Sprachausgabe
Ein Skript kann Anweisungen wie [flüstern], [aufgeregt], [seufzen] oder [Pause] enthalten. Dies sind Sprechhinweise, keine Wörter, die vorgelesen werden sollen. Bei S2-Modellen werden die in Klammern gesetzten Beschreibungen aus dem Kontext interpretiert, daher können ihre Effekte je nach Stimme und Text variieren.
Meine Schreibregel lautet: Weniger Tags verwenden als man denkt. Beginnen Sie mit korrekter Zeichensetzung und einem passenden Sprecher. Regieanweisungen sollten nur dort hinzugefügt werden, wo sich die Bedeutung ändert. Ein Produkt-Tutorial benötigt in der Regel ein gleichmäßiges Tempo; ein dramatischer Monolog hingegen erfordert möglicherweise stärkere emotionale Wechsel. Ein kurzes Vorsprechen vor einem längeren Skript ermöglicht es, Regiefehler kostengünstig zu korrigieren.
Drama 3 bietet außerdem Wortpaare für ausgewählte Wörter und Phonemsteuerung für die Aussprache. Diese Funktionen sind besonders nützlich für Firmennamen, Abkürzungen und Dialoge, in denen die Betonung einen Satz verändert.'s Bedeutung.
Wie funktioniert die Sprachklonierung von Fish Audio bei kurzen Aufnahmen?
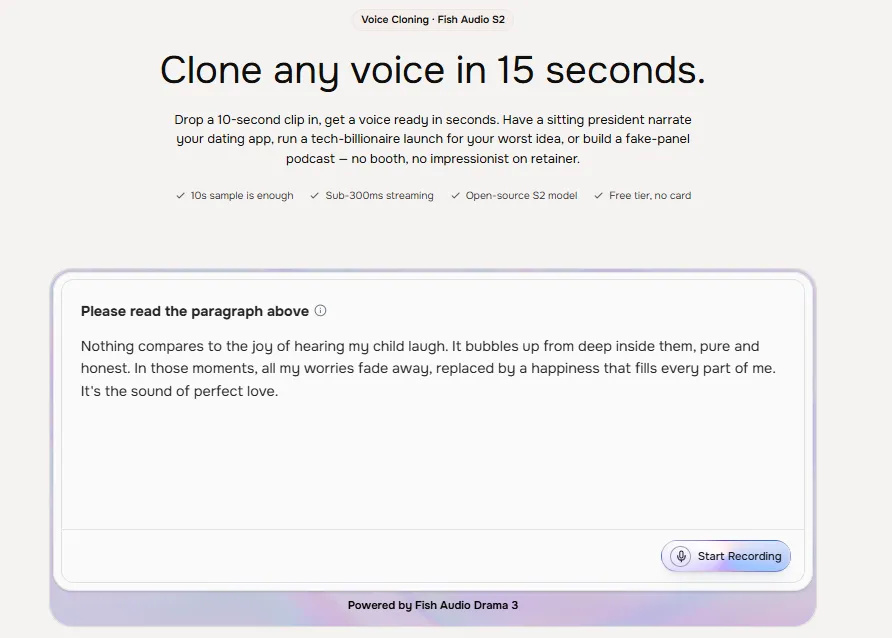
Fish Audio kann aus etwa zehn Sekunden Referenzsprache eine brauchbare Stimme erzeugen, die minimale Eingabelänge entspricht jedoch nicht der idealen Aufnahmequalität . Die Dokumentation empfiehlt sauberes Audiomaterial mit nur einem Sprecher und weist darauf hin, dass ein bis zwei Minuten die Ähnlichkeit verbessern können. Hintergrundmusik, Echo und Unterbrechungen erschweren das Erlernen einer konsistenten Stimme.
Es gibt zwei praktische Klonmethoden. Ein Instant-Clone übergibt Referenzaudio mit einer Generierungsanfrage und benötigt kein gespeichertes Modell. Ein Persistent-Clone erstellt eine gespeicherte Stimme und gibt eine Sprach-ID zurück. Zukünftige Anfragen verwenden diese ID über den Parameter `reference_id` wieder.
Für wiederkehrende Marken, Kurse oder Charaktere bevorzuge ich gleichbleibende Stimmen, da die Stimmidentität zwischen den Episoden unverändert bleiben sollte. Sofortige Referenzen eignen sich für einmalige, genehmigte Aufnahmen, Demonstrationen oder experimentelle Szenen. In beiden Fällen ist die Zustimmung des Sprechers und ein klarer Plan zur Speicherung des Originalmaterials erforderlich.
Erstellung eines wiederverwendbaren AI Stimme ohne Verlust der Sprecheridentität
Beginnen Sie mit einer Aufnahme einer einzelnen Person in einem ruhigen Raum. Entfernen Sie Musik und längere Pausen. Versuchen Sie es zunächst mit einer Minute normaler Sprache, nicht mit einer theatralischen Darbietung. Achten Sie auf den natürlichen Rhythmus, die Vokale und die Mimik, die die Stimme erkennbar machen.
In Fish Audio's Über die Browseroberfläche öffnen Sie die Sprachklonierung, laden Ihre autorisierte Sprachprobe hoch, erstellen die Stimme und schützen sie vor unbefugtem Zugriff, wenn sie einer Person oder einem Unternehmen gehört. In einem API-Workflow erstellen Sie ein Modell mit POST /model und speichern die zurückgegebene ID zusammen mit Ihrem Projekt.'s Lizenznachweis. Sie können mehrere Sprachproben und passende Transkripte zur Verfügung stellen, um die Aussprache zu verbessern.
Erstellen Sie anschließend drei Hörbeispiele: eine neutrale Einleitung, einen Satz mit schwierigen Namen und einen ausdrucksstärkeren Absatz. Achten Sie dabei auf Akzentveränderungen, Atemtechnik, Deutlichkeit und Ähnlichkeit der Konsonanten. Eine Stimme, die nur die erste Zeile fehlerfrei beherrscht, ist noch nicht für ein komplettes Hörbuch geeignet.
Sprachdesign im Vergleich zur Klonung eines echten Sprechers
Voice Design erstellt eine vorgeschlagene Stimme; durch Klonen werden Merkmale aus aufgezeichneter Sprache übernommen. Voice Design benötigt eine Beschreibung, optional einen Vorschautext und die Sprache und liefert anschließend eine Audio-Vorlage. Das API-Modell heißt voice-design-1 und kostet 0.01 $ pro erfolgreicher Anfrage. Dies ist nützlich für fiktive Erzähler, deren Identität keinem realen Sprecher gehört.
Ich würde einen Charakter anhand von Akzent, Sprechtempo, Stimmvolumen und Haltung beschreiben, zum Beispiel „freundlicher Dokumentarfilmer, bedächtige Sprechweise, deutliche Konsonanten“. Vergleichen Sie die Kandidaten anhand desselben Einleitungssatzes. Sobald Sie sich für einen entschieden haben, notieren Sie sich die entsprechende Hörprobe, damit spätere Folgen einheitlich klingen.
Wie man Schritt für Schritt Text-to-Speech-Voiceovers für Fische generiert
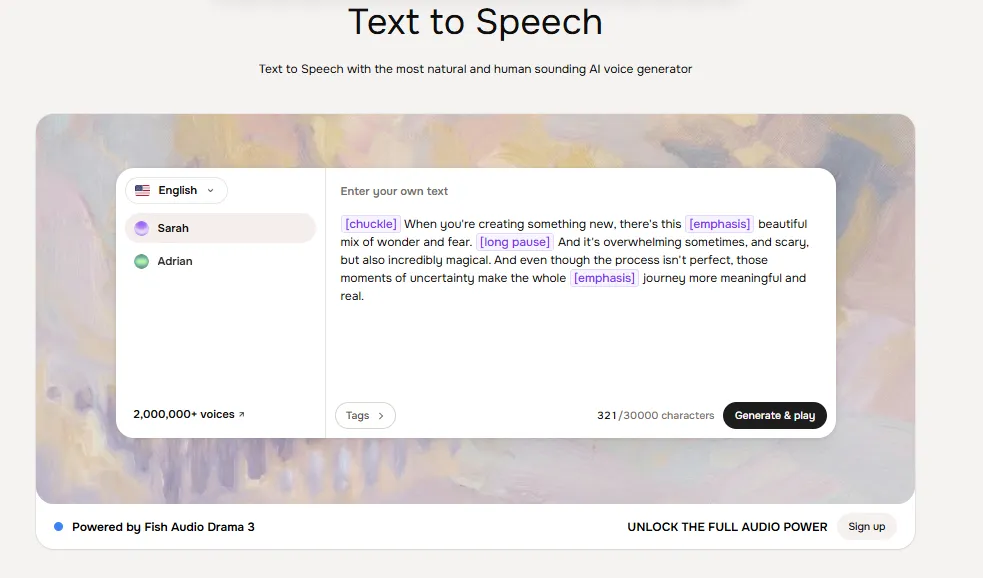
Der einfachste Workflow kommt ohne Programmierung aus. Kreative können Texte direkt in der Web-App schreiben, vorspielen und exportieren. Wichtig ist dabei, kreative Entscheidungen von technischen Korrekturen zu trennen, damit keine Credits für die Neuerstellung eines kompletten Skripts verschwendet werden, nur um einen Satz zu korrigieren.
Schritt 1: Ein Skript für die mündliche Präsentation vorbereiten
Verfassen Sie komplexe Texte in kurzen, gesprochenen Sätzen. Erklären Sie unerklärte Abkürzungen und legen Sie fest, wie Währungen, Maßeinheiten und Produktnamen ausgesprochen werden sollen. Verwenden Sie Satzzeichen, um natürliche Atempausen zu kennzeichnen. Trennen Sie bei mehrsprachigen Skripten schwierige Sprachwechsel gegebenenfalls in eigene Zeilen.
Ich empfehle, mit 100 bis 150 Wörtern zu beginnen. Das reicht aus, um einen einheitlichen Tonfall zu gewährleisten, ohne gleich das gesamte Kontingent zu verbrauchen. Bewahren Sie ein Referenzskript außerhalb der App auf, damit Korrekturen leicht nachvollziehbar bleiben, insbesondere wenn mehrere Redakteure dieselbe Kampagne freigeben.
Schritt 2: Stimme auswählen, Richtung hinzufügen und Vorschau generieren
Durchsuchen Sie die Sprachbibliothek nach Akzent, Altersgruppe, Rolle und Stil. Fish Audio bietet über zwei Millionen Stimmen an, daher ist die Suche nach einem bestimmten Sprechertyp sinnvoller als wahlloses Stöbern. Prüfen Sie die Nutzungsrechte für Ihre Stimme, bevor Sie etwas kommerziell veröffentlichen.
Fügen Sie das kurze Skript ein, wählen Sie ein verfügbares Modell und geben Sie nur die wichtigsten Sprechhinweise an. Generieren und hören Sie es sich über Kopfhörer und den Lautsprecher Ihres Telefons an. Achten Sie auf Satzenden, die Aussprache von Markennamen und abrupte Lautstärkeänderungen. Die Geschwindigkeitsregelung kann hilfreich sein, aber ein schlecht interpunktiertes Skript durch Beschleunigung zu beschleunigen, verschlimmert es meist nur.
Schritt 3: Audio exportieren und im Editor fertigstellen
Laden Sie das Ergebnis herunter und importieren Sie es in Ihre Bearbeitungssoftware. Die API unterstützt MP3, WAV, PCM und Opus; MP3 eignet sich gut für die normale Veröffentlichung, während WAV oft besser für die weitere Bearbeitung geeignet ist. Fügen Sie Musik und Effekte erst nach Bestätigung des Sprechertextes hinzu. Vermeiden Sie es, abgeschnittene Wörter mit einem Soundtrack zu überdecken.
Wie man die Fish Audio API in eine Website oder einen Sprachagenten integriert
Fish Audio bietet REST-Endpunkte sowie Python- und JavaScript-SDKs. Der zentrale Text-to-Speech-Endpunkt ist POST https://api.fish.audio/v1/tts. Authentifizieren Sie sich mit einem privaten API-Schlüssel, übergeben Sie den gewünschten Modell-Header und senden Sie das Skript als JSON. Entwickler können s2.1-pro-free für erste Tests nutzen, ohne kostenpflichtiges API-Guthaben hinzuzufügen.
Eine minimale Anfrage sieht folgendermaßen aus:
curl -X POST https://api.fish.audio/v1/tts \
  -H "Authorization: Bearer $FISH_API_KEY" \
  -H "Content-Type: application/json" \
  -H "model: s2.1-pro-free" \
  -d '{"text":"Welcome to our product walkthrough.","format":"mp3"}' \
  --output welcome.mp3
Speichern Sie den API-Schlüssel auf dem Server, nicht in öffentlich ausgeliefertem JavaScript. Wenn ein Endnutzer auf „Vorlesen“ klickt, senden Sie die Anfrage an Ihr Backend, prüfen Sie die Textlänge und geben Sie eine zulässige Audiodatei zurück. Speichern Sie freigegebene Clips im Cache, solange sich Text und Stimme nicht geändert haben. Das senkt die Kosten und vermeidet unnötige Anfragen.
Produktionsstreaming, Parallelverarbeitung und Latenzplanung
Echtzeit-Sprachassistenten benötigen Audiofragmente, während der Text noch eintrifft. Fish Audio bietet hierfür WebSocket-Streaming an. Für einen Blog-Sprachkommentar-Button reicht ein vollständiger MP3-Download aus; ein gesprochener Kundendienstmitarbeiter profitiert hingegen von einem früheren Audioempfang.
Die Starter-API-Stufe erlaubt fünf gleichzeitige Anfragen, die über mehrere Schlüssel verteilt werden. Eine Guthabenaufladung von 100 $ schaltet 15 Anfragen frei, 1,000 $ 50. Dies sind die Grenzwerte für gleichzeitige Anfragen, nicht die garantierte Anzahl an Anfragen pro Sekunde. Eine Anfrage, die 30 Sekunden lang einen Slot belegt, reduziert den Durchsatz deutlich stärker als eine Anfrage, die in zwei Sekunden abgeschlossen ist.
Messen Sie für die Bereitstellung die Zeit bis zum ersten Audiosignal, die Gesamtbearbeitungszeit, die Fehlerrate und die P95-Latenz mithilfe von Skripten, die realem Datenverkehr nachempfunden sind. Wenden Sie exponentielles Backoff auf HTTP-429-Antworten an. Gehen Sie nicht davon aus, dass der kostenlose S2.1-Endpunkt dieselben Latenz- oder Verfügbarkeitsgarantien bietet wie das kostenpflichtige Produktionsmodell.
Wie man lange Hörbuchkapitel einheitlich gestaltet
Für ein Buch oder einen längeren Kurs empfiehlt es sich, abschnittsweise zu arbeiten, anstatt das gesamte Manuskript unkommentiert einzureichen. Verwenden Sie eine genehmigte Sprecherkennung, ein Ausspracheblatt und eine Regel für die Audiobenennung. Erstellen Sie die Audioaufnahmen Szene für Szene und überprüfen Sie anschließend Übergänge, Pausen und wiederholte Charakternamen.
Story Studio unterstützt die Produktion längerer Hörbücher mit mehreren Sprechern direkt in der Plattform. Dies ist besonders nützlich, wenn ein Kapitel mehrere Sprecher enthält. Dennoch sollte der Verlag jede Szene einzeln prüfen und die fertige Datei mastern. Fish Audio vermarktet Hörbücher nach gängigen Vertriebsstandards; eine erfolgreiche Veröffentlichung hängt jedoch auch von Ihrer finalen Audiobearbeitung und dem Vertrieb ab.'s eigene Schecks.
Kann Fish Audio Sprache transkribieren und andere Audioaufgaben übernehmen?
Ja. Fish Audio umfasst Spracherkennung, einen Stimmverzerrer, Audiotrennung, Audioübersetzung , Soundwerkzeuge und browserbasierte Kreativfunktionen. Dies sind verwandte Produkte, die jedoch nicht mit der Text-zu-Sprache-Funktion selbst verwechselt werden sollten.
Das empfohlene Dateitranskriptionsmodell ist Transcribe-1-Pro. Es unterstützt Aufnahmen bis zu 60 Minuten, Sprecherbezeichnungen, strukturierte Sprecherwechsel, optionale Zeitstempel und Audio-Ereignishinweise. Die zugehörige Datei-API kostet 0.36 $ pro Audiostunde. Das Echtzeit-Erkennungsmodell Transcribe-Stream-1 befindet sich in der Vorschauphase und kostet ebenfalls 0.36 $ pro Sitzungsstunde.
Fish Audio-Preise: Kostenlose Credits, Plus-, Pro- und API-Kosten
Fish Audio ist ab 0 $ erhältlich, der niedrigste reguläre Preis für zahlende Entwickler beträgt 15 $ pro Monat bzw. 11 $ pro Monat bei jährlicher Abrechnung. Abonnements regeln das monatliche Datenvolumen des Browserprodukts; die Entwickler-API verfügt über ein eigenes, nutzungsabhängiges Guthaben. Ein Plus-Abonnement deckt keine API-Aufrufe ab.
| Hallenplan | Preis | Eingeschlossene Nutzung und praktische Grenze |
|---|---|---|
| Frei | $0 | 8,000 Credits monatlich; bis zu 7 Minuten Werbezeit; 500 Zeichen pro Generation; 3 öffentliche Sprachplätze |
| Plus | 15 $ monatlich oder 132 $ jährlich | 250,000 monatliche Credits; bis zu 200 Minuten; 15,000 Zeichen pro Generation; 10 private Sprachslots; Sprachdesign |
| Pro | 100 $ monatlich oder 900 $ jährlich | 2,000,000 Credits monatlich; bis zu 1,620 Minuten; 30,000 Zeichen pro Generation; 3 Teamplätze |
| Max | 999 $ monatlich oder 8,988 $ jährlich | 25,000,000 monatliche Credits; bis zu 6,250 Minuten; 10 Teamplätze; 15 professionelle Sprachplätze |
| Unternehmen | Individuelles Angebot | Organisationskontrollen und optionale Bereitstellungs- und Datenverarbeitungsvereinbarungen |
Monatliche Gutschriften werden zu Beginn jedes Abrechnungszeitraums zurückgesetzt, und nicht genutztes Kontingent verfällt. Veröffentlichte Minutenschätzungen und die FAQ finden Sie hier.'s Die allgemeinen Umrechnungskurse für Guthaben pro Minute sind nicht vollständig aufeinander abgestimmt. Daher würde ich mein Budget anhand des angezeigten Guthabens und des tatsächlichen Verbrauchs planen, anstatt einen allgemeinen Umrechnungskurs zu multiplizieren.
Preisgestaltung der Fish Audio API – einfach erklärt
Die Standard-Text-to-Speech-Dienste s2.1-pro und s2-pro kosten 15 US-Dollar pro Million eingegebener UTF-8-Bytes. Der kostenlose s2.1-pro-Endpunkt ist im Rahmen der Fair-Use-Bestimmungen kostenlos. Drama 3 berechnet 50 US-Dollar pro Million Bytes, mit einem befristeten Einführungspreis von 10 US-Dollar. Voice Design kostet 0.01 US-Dollar pro erfolgreicher Generierungsanfrage.
UTF-8-Bytes sind wichtig. Die meisten englischen Buchstaben belegen ein Byte, viele nicht-lateinische Zeichen hingegen mehr. Daher kann die gleiche visuelle Skriptlänge je nach Sprache unterschiedlich viel Speicherplatz benötigen. Fish Audio schätzt, dass eine Million Bytes englischer Eingabe etwa 180,000 Wörtern oder 12 Stunden Sprachausgabe entsprechen; dies ist eine Planungsbeispiel und keine garantierte Dauer für jede einzelne Stimme.
Für die API-Planung sollten separate Nutzungszähler für TTS, Transkription und Sprachdesign geführt werden. Berücksichtigen Sie Ansagen und Regieanweisungen, da die Eingabedaten – nicht nur die hörbaren Wörter – die TTS-Gebühren beeinflussen. Planen Sie ausreichend Speicherplatz für Korrekturen, alternative Aufnahmen und Kundenänderungen ein.
Anwendungsfälle in der Fisch-Audioindustrie
Der größte Nutzen im Geschäftsleben liegt nicht in der „Erzeugung von Aufmerksamkeit“. Vielmehr geht es darum, einen bestimmten Produktionsschritt zu verkürzen und gleichzeitig die redaktionelle Kontrolle zu behalten. Im Folgenden zeige ich, wie ich das Produkt in der Praxis anwenden würde.
| Branche oder Arbeitsablauf | Funktion zu verwenden | Spezifischer Produktionsvorteil | Erforderliche Qualitätsprüfung |
|---|---|---|---|
| E-Learning und Training | Permanente Spracherkennung und Kapitelvorlesung | Eine geänderte Lektion ersetzen, ohne einen kompletten Kurs neu aufzunehmen | Terminologie und Lernverständnis |
| Spielentwicklung | Voice Design und Drama 3 | Prototypen verschiedener Charakteridentitäten und Schauspielstile | Konsistenz über alle Dialogzweige hinweg |
| YouTube- und Podcast-Produktion | TTS, Sprachklonierung und Story Studio | Wiederholen Sie die Erzählung in einer bekannten Stimme. | Tempo, Berechtigungen und Audio-Mastering |
| SaaS-Kundensupport | REST-API und WebSocket-Sprachausgabe | Assistentenantworten innerhalb einer Anwendung laut vorlesen | Reaktionsverzögerung und Eskalation an eine Person |
| Reise und Lokalisierung | Mehrsprachige S2.1-Generation | Genehmigte Reisehinweise in mehreren Sprachen wiedergeben | Überprüfung von Ortsnamen durch Muttersprachler |
| Veröffentlichung von barrierefreien Inhalten | Sprachsynthese und Dateiexport | Bieten Sie mündliche Versionen schriftlicher Informationen an. | Navigation, Übersichtlichkeit und barrierefreie Wiedergabe |
| Marketingagenturen | Gespeicherte Markenstimme und kurze Clips | Beibehaltung eines einzigen Erzählers in allen genehmigten Kampagnenüberarbeitungen. | Ansprüche, Rechte und Aussprache |
| Transkriptionsteams | transcribe-1-pro mit Sprecherwechseln | Erstellen Sie nach Sprechern getrennte Entwürfe zur Bearbeitung. | Namen, Zeitstempel und sensible Inhalte |
E-Learning, betriebliche Weiterbildung und Barrierefreiheit
Für Lehr-Audio ist eine gleichbleibende Lautstärke und eine vorhersehbare Aussprache wichtiger als eine dramatische Darstellung. Ich würde eine klare Sprecherstimme wählen, auf theatralische Elemente verzichten und die Lektionseinheiten als separate Dateien verwalten. Bei einer Richtlinienänderung sollte der betroffene Abschnitt neu generiert und die Verknüpfungen erneut überprüft werden.
Für Barrierefreiheit sollte Audio den lesbaren Text und die Navigation ergänzen, nicht ersetzen. Eine Text-to-Speech-Funktion ist nur dann sinnvoll, wenn Tastatursteuerung, Geschwindigkeitsregelung und der geschriebene Artikel weiterhin verfügbar sind. Überprüfen Sie mathematische Notationen, URLs und Akronyme, da diese bei automatischer Sprachausgabe oft unnatürlich klingen.
Marketing, Spiele und lokalisierte Kundenkommunikation
Marketingteams können genehmigte Markenbotschaften erstellen, ohne für jede kleine Änderung eine weitere Aufnahmesitzung koordinieren zu müssen. Spielestudios können mehrere fiktive Stimmen vorsprechen lassen, bevor sie Sprecher engagieren oder eine feste Besetzung festlegen. Auf einer Reise-Website können mehrsprachige Sprachausgaben Verbindungsschritte oder Buchungen erklären, aber Namen und Nummern von Reisezielen erfordern einen Sprecher mit fließenden Sprachkenntnissen.
Ich empfehle, den Prüfaufwand dem Geschäftsrisiko anzupassen. Ein Werbevideo kann nach dem Export korrigiert werden. Medizinische Anweisungen, Finanzberichte oder sicherheitskritische Mitteilungen erfordern deutlich strengere manuelle Kontrollen, Datenschutzprüfungen und validierte Inhalte vor der Wiedergabe.
Wie natürlich klingt Fischgeräusch im Vergleich zu anderen? AI Sprachgeneratoren?
Fisch-Audio's Das stärkste beworbene Alleinstellungsmerkmal ist die Kontrolle über die Sprachausgabe: kurze Klon-Samples, eine große öffentliche Bibliothek, mehrere Sprachausgabe-Engines und Regieanweisungen, die ausdrucksstärker sind als die einfache Stimmauswahl. Drama 3 eignet sich besonders für Drehbücher, die Reaktionen, Pausen oder schauspielerisches Talent erfordern.
Ich würde es mit ElevenLabs und PlayHT anhand identischer Texte vergleichen, nicht anhand von Marketing-Demos. Bereiten Sie dieselbe 120-Wort-Probe mit einem schwierigen Nachnamen, einer Frage, einer Zahl, einem ruhigen Satz und einem plötzlichen Gefühlswechsel vor.
Vergleichen Sie Verständlichkeit, Akzentkonsistenz, Audioartefakte und Gesamtkosten pro freigegebener Minute. So erhalten Sie ein Ergebnis, das Ihren eigenen Produktionsanforderungen entspricht.
| AI Sprachgenerator, Text-zu-Sprache-Software, Plattform zur Stimmenklonung | Hauptfunktionen | Am besten geeignet für | Startpreis |
|---|---|---|---|
| Fisch-Audio | Ausdrucksstarke TTS, Sprachklonierung, API-Zugriff | Storytelling- und Sprachanwendungen | Kostenlos; 15 $/Monat |
| ElfLabs | Sprachklonierung, mehrsprachige TTS, Synchronisation | Realistische Voiceovers | Kostenlos; 6 $/Monat |
| Murf KI | Über 200 Stimmen, Sprachbearbeitung, Aussprachesteuerung | Geschäftspräsentationen | Kostenlos; 19 $/Monat jährlich |
| LOVO AI | AI Stimmen, Videoeditor, Stimmenklonen | Ersteller von Videoinhalten | Kostenlos; kostenpflichtige Tarife |
| KI ähneln | Stimmklonierung, Echtzeit-TTS, Emotionssteuerung | Entwickler und Unternehmen | Nutzungsbasierte Preisgestaltung |
gemeinsam AI Sprachprobleme und praktische Lösungen
Klingt die Aussprache falsch, buchstabieren Sie den Namen oder verwenden Sie die unterstützten Phonemsteuerungen. Ändert sich die Tonlage einer Stimme zwischen verschiedenen Clips, reduzieren Sie widersprüchliche Tags und verwenden Sie dieselbe gespeicherte Stimme wieder. Klingt der Text gehetzt, verbessern Sie die Zeichensetzung, bevor Sie die Sprechgeschwindigkeit anpassen. Ändert sich der Akzent bei mehrsprachiger Ausgabe, testen Sie kürzere Passagen mit einem geeigneten Referenzsprecher.
Falls eine emotionale Kennzeichnung zu einer übertriebenen Wiedergabe führt, entfernen Sie diese und erstellen Sie den kürzesten betroffenen Abschnitt neu. Falls ein längerer Erzähltext uneinheitlich klingt, teilen Sie ihn an natürlichen Szenenübergängen und notieren Sie sich das gewählte Modell, die Sprecherkennung und die Sprechgeschwindigkeit.
Fish Audio Datenschutz, Stimmrechtseinwilligung und kommerzielle Rechte
Ein kostenpflichtiges Abonnement berechtigt Sie nicht zur Verwendung fremder Stimmen. Die Nutzungsbedingungen von Fish Audio verpflichten Sie zur Achtung des geistigen Eigentums und anderer geltender Rechte. Holen Sie die ausdrückliche Einwilligung zur Verwendung der Referenzaufnahme ein, legen Sie fest, wo die resultierende Stimme verwendet werden darf, und bewahren Sie den Autorisierungsnachweis auf, wenn Sie Marken- oder Kundenmaterialien erstellen.
Es gibt einen wichtigen Widerspruch in der Formulierung des kostenlosen Tarifs: Die Preisübersicht erwähnt die kommerzielle Nutzung, die FAQ und die Allgemeinen Geschäftsbedingungen beschränken kostenlose Konten jedoch auf private, nicht-kommerzielle Projekte. Für Veröffentlichungen würde ich mich an die strengere schriftliche Regelung halten und einen berechtigten kostenpflichtigen Tarif mit einer verifizierten Stimme nutzen, für die Sie die Nutzungsrechte besitzen.
Datenschutz ist auch deshalb wichtig, weil hochgeladene Sprachproben eine Person identifizieren können. Die Richtlinien von Fish Audio sehen die Speicherung hochgeladener Inhalte für betriebliche Zwecke vor. Unternehmensverträge beinhalten die optionale Datenspeicherung ohne Speicherung für bestimmte Arbeitsabläufe, jedoch sollte bei normalen Abonnements für Endverbraucher nicht automatisch davon ausgegangen werden, dass diese Einstellung enthalten ist.
API-Schlüssel sollten serverseitig gespeichert, der Zugriff von Mitarbeitern auf private Sprachaufnahmen beschränkt und vertrauliche Kundendaten nicht in öffentliche Modelle eingebunden werden. Bei Arbeiten mit Gesundheitsdaten, Kindern oder vertraulichen Gesprächen sind vor dem Hochladen von Aufnahmen entsprechende vertragliche Schutzmaßnahmen und eine rechtliche Prüfung sicherzustellen.
Vor- und Nachteile für Kreative und Entwickler
- Ausdrucksstarke Sprachmodelle mit klammerbasierter Regieanweisung und Drama 3-Schauspielsteuerung.
- Schnellstart-Klonen plus wiederverwendbare Sprach-IDs für wiederkehrende Projekte.
- Umfassende Sprachabdeckung, eine große Community-Bibliothek und originelles Voice-Design.
- Web-Editor, mobile Apps, SDKs, REST-Zugriff und Echtzeit-Streaming.
- Separate kostenlose Einstiegspunkte für die spontane Erstellung von Inhalten und das Prototyping von Entwicklern.
- Die kostenlose kommerzielle Lizenzierung ist trotz uneinheitlicher Preisangaben eingeschränkt.
- Abonnementguthaben und API-Abrechnung sind getrennt; Kostenvoranschläge müssen überwacht werden.
- Ein zehnsekündiger Klon benötigt möglicherweise bessere Testmuster vor der professionellen Veröffentlichung.
- Qualität und Aussprache variieren nach wie vor je nach Schriftsystem, Stimme und Sprache.
- Der kostenlose API-Zugang beinhaltet keine Garantien für die termingerechte Lieferung in der Produktion.
- Vertrauliche Aufnahmen erfordern eine sorgfältigere Planung des Datenschutzes als routinemäßige öffentliche Gesprächsskripte.
Für Einzelentwickler, die einige wenige Voiceovers pro Woche produzieren, ist Plus der sinnvolle kostenpflichtige Einstieg. Entwickler sollten zunächst das kostenlose S2.1-API-Modell nutzen und die Produktionsnutzung separat budgetieren, bevor sie das Angebot für Kunden freigeben.
Häufig gestellte Fragen zu Fish Audio
Diese Antworten umfassen die Fragen zum Kauf und zur Einrichtung, die ich vor Beginn eines bezahlten Projekts klären würde.
Ist Fish Audio kostenlos und wie viele Voiceovers kann ich erstellen?
Ja. Der kostenlose Web-Tarif umfasst 8,000 Credits pro Monat, die für bis zu sieben Minuten Videomaterial mit einer Zeichenbegrenzung von 500 Zeichen pro Anfrage genutzt werden können. Die genaue Anzahl der Clips hängt von der Skriptlänge und der Nutzung ab. Kostenlose Konten sind für den privaten, nicht-kommerziellen Gebrauch gemäß den genannten Bedingungen bestimmt.
Kann Fish Audio meine Stimme aus zehn Sekunden Audiomaterial klonen?
Ja. Fish Audio bietet die Möglichkeit, Stimmen sofort zu klonen – mit nur etwa zehn Sekunden Sprachaufnahme. Wichtig ist eine klare Aufnahme mit nur einem Sprecher; ein bis zwei Minuten können eine authentischere, wiederverwendbare Stimme liefern. Klonen Sie nur Stimmen, deren Rechte Sie besitzen oder für deren Vervielfältigung Sie die Erlaubnis haben.
Unterstützt Fish Audio 83 Sprachen und kommerzielle Sprachaufnahmen?
S2.1 Pro unterstützt 83 Sprachen, darunter Englisch, Chinesisch, Japanisch, Koreanisch, Französisch, Deutsch und Spanisch. Kostenpflichtige Abonnements können – vorbehaltlich der Sprachrechte, Berechtigungen und der Plattform – auch kommerzielle Projekte unterstützen.'s Begriffe. Sprachunterstützung ersetzt nicht die Notwendigkeit, die Aussprache zu überprüfen.
Ist der Zugriff auf die Fish Audio API in einem Plus-Abonnement enthalten?
Nein. Fish Audio stellt die API-Nutzung für Entwickler separat von den Abonnementguthaben für Kreative in Rechnung. Die Produktions-API S2.1 Pro kostet 15 US-Dollar pro Million UTF-8-Eingabebytes, während das kostenlose API-Modell S2.1 Pro unter Fair-Use-Bedingungen für die Entwicklung zur Verfügung steht.
Lohnt sich die Nutzung von Fish Audio?
Fish Audio ist eine Überlegung wert, wenn ausdrucksstarke Sprache, wiederholbare Stimmen und direkter API-Zugriff in einem Workflow integriert werden sollen. Drama 3 ist die interessantere Option für gesprochene Dialoge; S2.1 Pro bietet das übersichtlichere Modell für allgemeine Produktionen. Die Browser-App senkt die Einstiegshürde für Kreative, während die SDKs, Streaming- und Transkriptionsdienste sie zu mehr als nur einem einfachen Sprachausgabetool machen.
Mein Rat: Wählen Sie ein echtes Produktionsskript, lassen Sie einige lizenzierte Sprecher vorsprechen, überprüfen Sie die schwierigen Passagen und ermitteln Sie die Anzahl der benötigten Aufnahmen für ein zufriedenstellendes Ergebnis. Das Tool kann zwar Aufnahmezeit sparen, die endgültige Qualität hängt aber weiterhin vom Skript, den Einverständniserklärungen und der redaktionellen Beurteilung ab.


