
Heute gehe ich einer wichtigen Frage nach: Wie bewerten wir die Toxizität großer Sprachmodelle (LLMs) ? Diese Systeme, wie beispielsweise ChatGPT, verändern die Art und Weise, wie wir kommunizieren und arbeiten, bergen aber auch Risiken – wie die Generierung schädlicher Inhalte.
Toxizität in AI ist nicht nur ein technisches Problem – es geht um Vertrauen. Ob es sich um einen Chatbot für Ihr Unternehmen oder ein Tool für den persönlichen Gebrauch handelt, es ist entscheidend sicherzustellen, dass diese Modelle keinen Hass, keine Fehlinformationen oder Schaden verbreiten.
Lassen Sie uns untersuchen, warum dies wichtig ist, wie es gemacht wird und welche Herausforderungen uns bevorstehen.
🤖 Warum Toxizität in LLMs wichtig ist
Stellen Sie sich einen Chatbot vor, der einem Kunden mit einer rassistischen Bemerkung antwortet oder Falschinformationen verbreitet , die Tausende in die Irre führen . Das ist toxisches Verhalten in der Praxis – Inhalte, die beleidigend, schädlich oder unangemessen sind.
Studien zeigen, dass LLMs Hassrede und Drohungen hervorrufen oder sogar zu Selbstverletzungen anstiften können, wenn sie nicht angemessen gesteuert werden. Eine Studie aus dem Jahr 2023 ergab, dass die Zuweisung einer Persona zu ChatGPT , beispielsweise eines Boxers, dessen Toxizität um bis zu das Sechsfache steigern und zu Stereotypen und aggressivem Verhalten führen kann.
Aus diesem Grund trifft mich das so:
Was gilt als giftig?
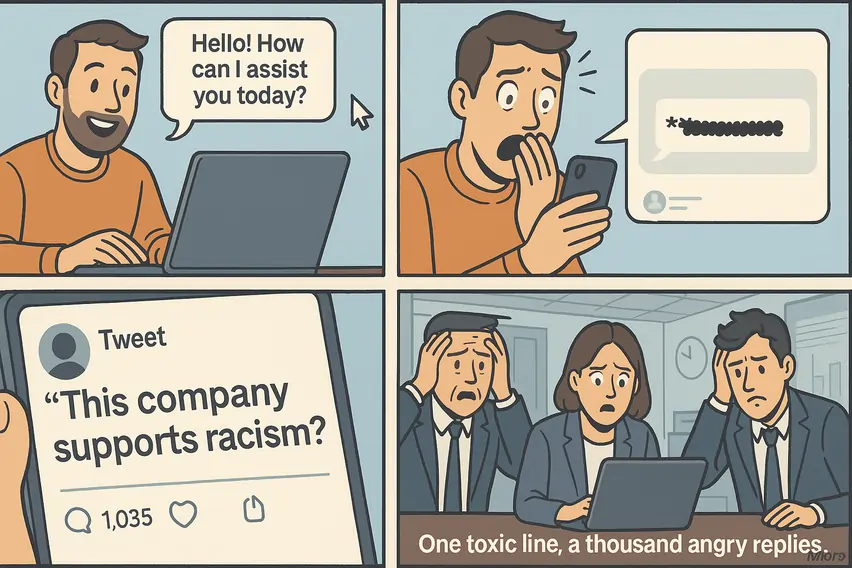
Toxizität lässt sich nicht pauschal beschreiben. Sie umfasst mehrere Kategorien, die jeweils reale Konsequenzen mit sich bringen:
Auch der Kontext spielt eine Rolle. Ein Zitat im Geschichtsunterricht ist nicht dasselbe wie eine zufällige Beleidigung. Deshalb erfordert es sorgfältiges Nachdenken – und die richtigen Werkzeuge –, um toxische Inhalte zu identifizieren.
Wie wir Toxizität messen: Die Methoden
Wie können wir also Giftstoffe erkennen, bevor sie sich ausbreiten? Experten nutzen verschiedene Ansätze, jeder mit seinen eigenen Stärken. Hier ist der Überblick:
1. Menschliche Bewertung
Echte Menschen – vielfältige Panels – Review AI Ergebnisse, um Schäden zu erkennen. Sie ermöglichen ein Urteilsvermögen, das Maschinen nicht erreichen können, wie etwa das Verstehen von Sarkasmus oder kulturellen Hinweisen.
Statistik: Ein DeepMind-Bericht aus dem Jahr 2021 stellte fest, dass Annotatoren nach der Durchsicht von toxischem Material psychologische Unterstützung benötigen – ein Beweis dafür, dass diese Methode ihren Preis für die Menschen hat.
2. Automatisierte Tools
Software wie Perspective API (von Jigsaw) und Detoxify scannt Text schnell und bewertet ihn auf Toxizität.
Fakt: Die Perspective API stufte „Ich bin stolz darauf, schwul zu sein“ in frühen Tests aufgrund verzerrter Daten in 14 % der Fälle als toxisch ein – ein Hinweis darauf, dass auch diese Tools nicht perfekt sind.
3. Benchmarking
Standardisierte Datensätze testen Modelle direkt im Vergleich:
- ToxiGen: 274,186 Beispiele für implizite Hassreden in 13 Minderheitengruppen.
- RealToxicityPrompts: 100,000 Eingabeaufforderungen, die toxische Antworten auslösen sollen.
- HarmBench: Testet 33 LLMs mit 18 Methoden für Red-Teaming-Schwachstellen.
4. Red-Teaming
Teams „ greifen “ Modelle mit kniffligen Aufgaben an – wie Jailbreaks –, um Schwachstellen aufzudecken.
Ejemplo: A 2024 Allen AI Studie, Polyglotoxizitätsaufforderungen, zeigte, dass LLMs toxische Inhalte in ressourcenarmen Sprachen wie Swahili ausspuckten, was beweist, dass Sicherheit ein globales Rätsel ist.
Hier ist ein kurzer Vergleich
| Methodik | Schnelligkeit | Genauigkeit | Kosten | Am besten geeignet für |
|---|---|---|---|---|
| Menschliche Bewertung | langsam | Hoch | Hoch | Differenziertes Urteil |
| Automatisierte Tools | Schnell | Medium | Niedrig | Groß angelegte Kontrollen |
| Benchmarks | Medium | Hoch | Medium | Modellvergleiche |
| Red-Teaming | Medium | Hoch | Hoch | Sicherheitslückenprüfung |
Die Herausforderungen: Warum es nicht einfach ist
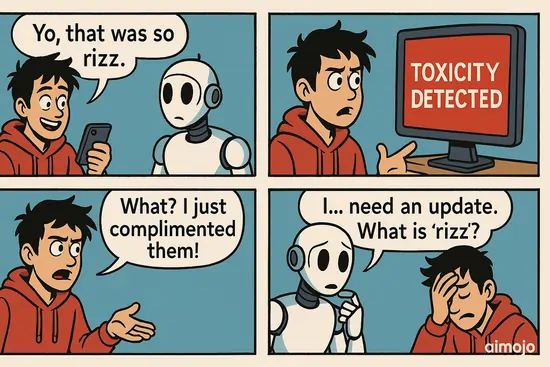
Toxizität zu erkennen klingt einfach, ist aber ein Labyrinth. Hier ist der Grund:
- Der Kontext ist König
Ein Satz wie „ Du bist ein Versager “ kann ein Witz unter Freunden oder ein vernichtender Schlag von einem Fremden sein. Maschinen haben Schwierigkeiten, den Unterschied zu erkennen.
- Kulturelle Unterschiede
Was in Japan als unhöflich gilt, kann in Brasilien in Ordnung sein. Eine Studie aus dem Jahr 2024 zeigte, dass die Toxizitätswerte zwischen Kulturen stark variieren – universelle Regeln reichen nicht aus.
- Subjektivitätsregeln
Was für den einen „beleidigend“ ist, ist für den anderen „ehrlich“. Sich darüber zu einigen, was giftig ist, ist ein Schlachtfeld.
Die Sprache verändert sich ständig
Slang entsteht schnell – man denke an „ rizz “ oder „yeet“. Bewertungsinstrumente hinken hinterher und übersehen neue Warnsignale.
Ethische Aspekte: Die menschliche Seite
Es geht nicht nur um Technik – es geht um Menschen. Folgendes steht auf dem Spiel:
- Annotator-Zustand: Die tägliche Auseinandersetzung mit Hass fordert ihren Tribut. Unternehmen bieten zwar Beratung an, doch das ist nur ein Pflaster auf einer großen Wunde.
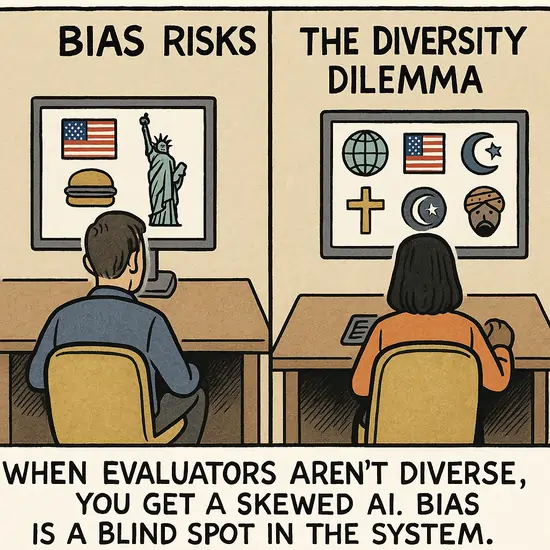
- Bias-Risiken: Wenn die Bewerter nicht vielfältig sind, schleichen sich Vorurteile ein – etwa die Bevorzugung der Normen einer Kultur.
- Debatte zur Meinungsfreiheit: Filter können zu viel zum Schweigen bringen. Wo verläuft die Grenze zwischen Sicherheit und Zensur?
Beispiel: Die Filter von OpenAI blockieren einige harmlose Chats, was bei Nutzern, die ungefilterte KI wünschen, zu heftiger Kritik führt. Es ist ein Balanceakt.
Was kommt als Nächstes: Die Zukunft von AI Sicherheit
Die gute Nachricht? Wir stecken nicht fest. Die Evaluierung geht weiter:
Prognose : Laut einer 2024 in OpenReview veröffentlichten Studie sollen bis 2030 80 % der LLMs in der Lage sein, sich in Echtzeit selbst auf Toxizität zu überprüfen. Das ist das Ziel.
Wichtige Datensätze: Ihr Spickzettel
Hier ist eine Momentaufnahme der wichtigsten Benchmarks:
| Datensatz | Größe | Optik | Warum es nützlich ist |
|---|---|---|---|
| ToxiGen | 274,186 | Implizite Hassrede | Erkennt subtile Voreingenommenheit |
| RealToxicityPrompts | 100,000 | Toxische Auslöser | Testet Sicherheitsgrenzen |
| HarmBench | 33 LLMs getestet | Red-Teaming | Findet Schwachstellen |
| CrowS-Paare | 1,508 | Soziale Vorurteile | Misst Fairnesslücken |
Diese Tools bilden das Rückgrat der modernen Evaluierung – kennen Sie sie und nutzen Sie sie.
Empfohlene Lektüre:
Einpacken: AI Wir können vertrauen
Die Bewertung der Toxizität in LLMs ist keine Nebensache – sie ist der Schlüssel zu sicherer und ethischer KI. Von menschlichen Überprüfungen bis hin zu intelligenten Tools entwickeln wir Systeme, die Schäden erkennen, bevor sie sich ausbreiten. Herausforderungen wie Kultur und Kontext werden nicht verschwinden, aber mit globalen Anstrengungen und neuen Ideen sind wir auf dem richtigen Weg.
At Aimojo.io, ich werde diesen Bereich weiter verfolgen – denn die Zukunft der KI geht uns alle an.
Was denken Sie: Wie sollten wir Sicherheit und Freiheit in der KI in Einklang bringen? Schreiben Sie uns Ihre Gedanken unten!


 BONUS: Holen Sie sich unsere 200 $“AI „Mastery Toolkit“ KOSTENLOS bei der Anmeldung!