
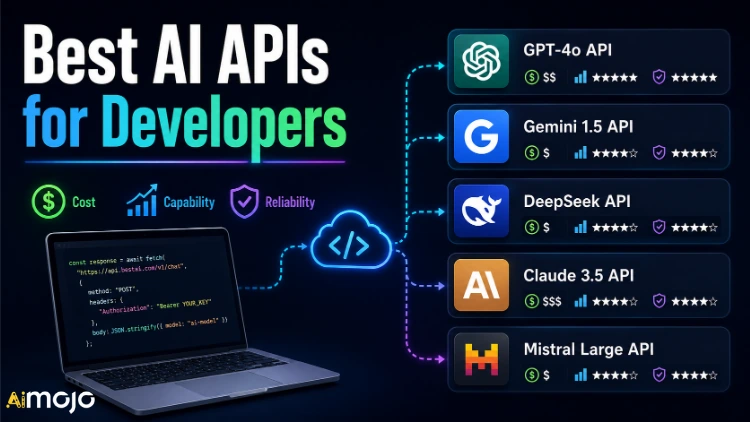
LLM API-priserne i 2026 varierer fra $0.10 til $30 pr. million tokens. Denne forskel er ikke en afrundingsfejl - den's forskellen mellem en regning på 200 USD/måned og en regning på 9,000 USD/måned for den samme arbejdsbyrde. Denne vejledning dækker AI API'er til udviklere som bygger rigtige produktionsapps, ikke weekendprototyper. Ingen gratis hobbyværktøjer her – hvis det så er tilfældet's hvad du har brug for, tjek det gratis AI API'er-vejledning først.
Det får du her: et grundigt kig på omkostninger, kapacitet og pålidelighed på tværs af de API'er, der rent faktisk betyder noget, når brugerne rammer dine endpoints klokken 3 om natten.
Hurtigvalgsguide — Bedst AI API efter udviklertype
| Udviklertype | Bedste valg | Hvorfor |
|---|---|---|
| Solo / indie hacker | Gemini Flash + DeepSeek V3.2 | Lave omkostninger, generøse grænser |
| SaaS opstart | GPT-5.4 mini eller Claude Sonnet 4.6 | Balance mellem kvalitet og pålidelighed |
| Virksomhed / reguleret | AWS Bedrock / Azure OpenAI | SLA, compliance, dataopbevaring |
| Højvolumen rørledning | DeepSeek V3.2 via OpenRouter | Billigst i stor skala |
| Kodnings-/udviklingsværktøjer | Claude Sonnet 4.6 | Bedste kodningsbenchmark i 2026 |
| Multimodale apps | Gemini 2.5 Pro | Samlet vision + tekst-slutpunkt |
3-faktor-rammen før du vælger noget AI API
Før du forpligter dig til en udbyder, skal du køre alle muligheder gennem disse tre filtre:
| faktor | Hvad skal måles | Rødt flag |
|---|---|---|
| Pris | Input/output token-rater, kontekstprisniveauer, batchrabatter | Ingen offentliggjort prisside |
| Capability | Benchmark-scorer, kontekstvindue, multimodal understøttelse | Vage "kommer snart"-funktioner |
| Pålidelighed | Oppetids-SLA, p99-latens, gennemsigtighed af hastighedsgrænse | Ingen offentlig statusside |
Hvis en udbyder ikke kan bestå alle tre, hører den ikke hjemme i din produktionsstak – uanset hvor gode demoerne ser ud.
2026 AI API-prisoversigt — Hvad du rent faktisk betaler pr. million tokens
Det er her, hvor de fleste udviklere bliver overraskede.'s hvordan markedet deler sig i 2026:
Niveau 1 — Frontier-modeller (Premium-priser)
Disse er de mest kapable, men rammer dit budget hårdest:
Niveau 2 — Mellemklassemodeller (Bedste pris-ydelsesforhold)
Det optimale punkt for de fleste SaaS-produkter:
Niveau 3 — Budget- og Open-Weight API'er
Det er her, hvor rørledninger med høj volumen befinder sig:
Fuld prisreferencetabel:
| Provider | Model | Input (pr. 1M) | Output (pr. 1M) | Kontekstvindue | Gratis niveau |
|---|---|---|---|---|---|
| OpenAI | GPT-5.4 | $2.50 | $15.00 | 128K | Ingen |
| OpenAI | GPT-5.4 mini | $0.75 | $3.00 | 128K | Limited |
| Antropisk | Claude Sonnet 4.6 | $3.00 | $15.00 | 200K | Ingen |
| Gemini 2.5 Pro | $ 1.25- $ 2.50 | $10.00 | 1M | Ja | |
| Gemini Flash | $0.15 | $0.60 | 1M | Ja | |
| DeepSeek | V3.2 | $0.28 | $1.10 | 64K | Limited |
| Groq | Flame 4 Maverick | $0.20 | $0.60 | 128K | Ja |
| Sammen AI | Various | fra $ 0.90 | fra $ 0.90 | Varierer | Ja |
Funktionssammenligning — Hvilken API klarer egentlig opgaven
Ikke alle modeller er bygget til den samme opgave. At vælge den forkerte til din brugsscene betyder at betale mere for dårligere resultater.
Bedst til generelle formål / Chat
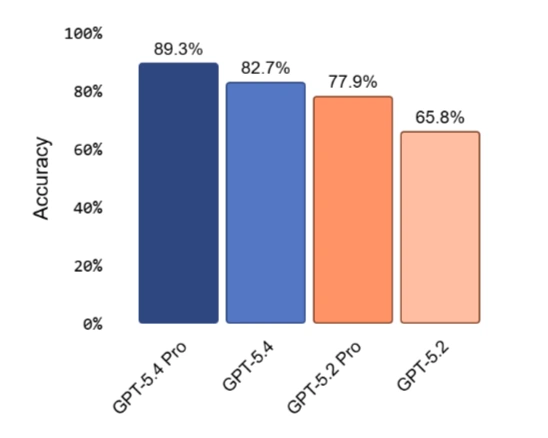
???? ÅbneAI GPT-5.4 — Stadig den stærkeste samlede benchmark-performer i 2026. Hvis din app har brug for ensartet kvalitet på tværs af forskellige prompts, er dette standardindstillingen.
Bedst til kodningsopgaver
👉 Claude Sonnet 4.6 — Overgår GPT til kodegenerering og flertrins ræsonnementsopgaver. Kontekstvinduet på 200K betyder, at den kan håndtere fulde kodebaser uden chunking.
Bedst til behandling af lange kontekster / dokumenter
👉 Gemini Flash — Billigste pr. token til langkontekstlæsninger. Hvis du behandler juridiske dokumenter, transskriptioner eller store vidensbaser, er dette den eneste fornuftige løsning i stor skala.
Bedst til store mængder/agentpipeliner
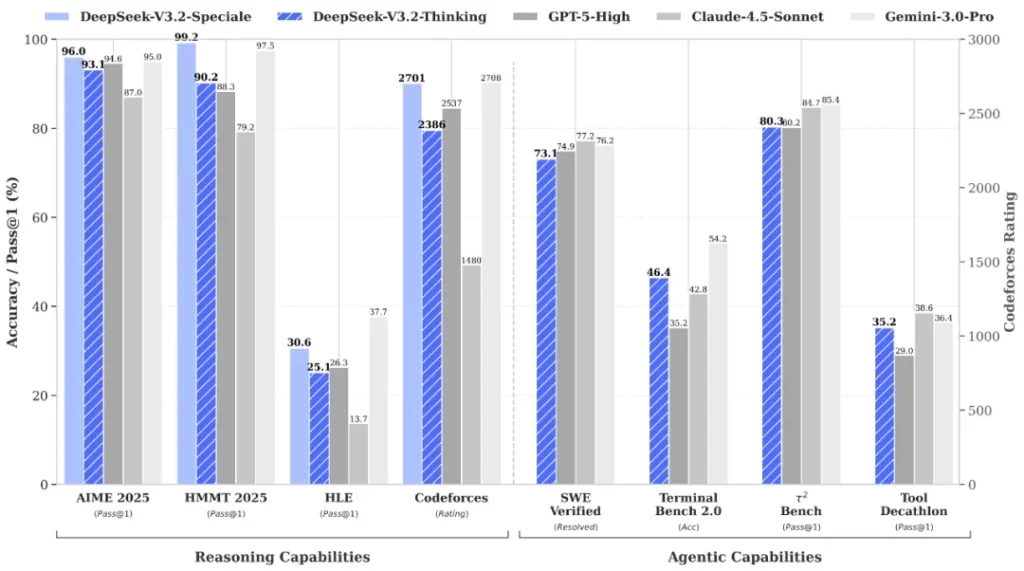
👉 DeepSeek V3.2 + MiniMax M2.5 som billige standardindstillinger med et premium fallback-mønster. For pipelines, der udfører 50+ opkald/dag, reducerer denne routing-opsætning omkostningerne med 10-50 gange.
Bedst til multimodal (tekst + billede + lyd)
👉 Gemini 2.5 Pro via Google Vertex AI — Ét samlet slutpunkt til tekst, billede og lyd. Ingen sammenføjning af separate API'er.
Reference til routing i brugsscenarier:
| Use Case | Anbefalet API | Hvorfor |
|---|---|---|
| Generel chat/assistent | GPT-5.4 | Den bedste kvalitet overordnet set |
| Generering af kode | Claude Sonnet 4.6 | Top kodningsbenchmarks, stor kontekst |
| Behandling af lange dokumenter | Gemini Flash | Billigst ved 1 mio. tokenkontekst |
| Højvolumen rørledninger | DeepSeek V3.2 | 90 % billigere i stor skala |
| Multimodale apps | Gemini 2.5 Pro | Samlet tekst + vision + lyd |
Pålidelighed i 2026 — Oppetidstal, der rent faktisk betyder noget
Oppetidsprocenter lyder kedelige, indtil din app går ned i spidsbelastningsperioder. Her's hvad disse tal betyder i realtid:
For et produktions-SaaS med rigtige brugere er selv 4 timers nedetid et mareridt for kundesupport. Men oppetid alene er ikke den fulde historie.
p99-latens er den målestok, de fleste udviklere bruger. Hvis din p50-latens er 400 ms, men p99 er 4,000 ms, betyder det, at 1 ud af 100 anmodninger tager 10 sekunder. Brugerne er ligeglade med dit gennemsnit. De bemærker de langsomme.
Et benchmark for sunde udbydere:
Kør en 24-timers belastningstest, før du sætter en udbyder i produktion. Det, der ser stabilt ud i en 5-minutters test, kan kollapse under vedvarende trafik.
Hurtig reference til pålidelighed:
| Provider | Oppetid SLA | Gennemsigtighed i hastighedsgrænser | Offentlig statusside |
|---|---|---|---|
| OpenAI | 99.9% | dokumenteret | Ja |
| Antropisk | 99.9% | dokumenteret | Ja |
| Google Vertex | 99.95% | dokumenteret | Ja |
| DeepSeek | ~ 99.5% | Delvis | Ja |
| Groq | 99.9% | dokumenteret | Ja |
| Sammen AI | 99.5% | Delvis | Ja |
Hvordan topudviklere bruger 2-3 API'er, ikke én
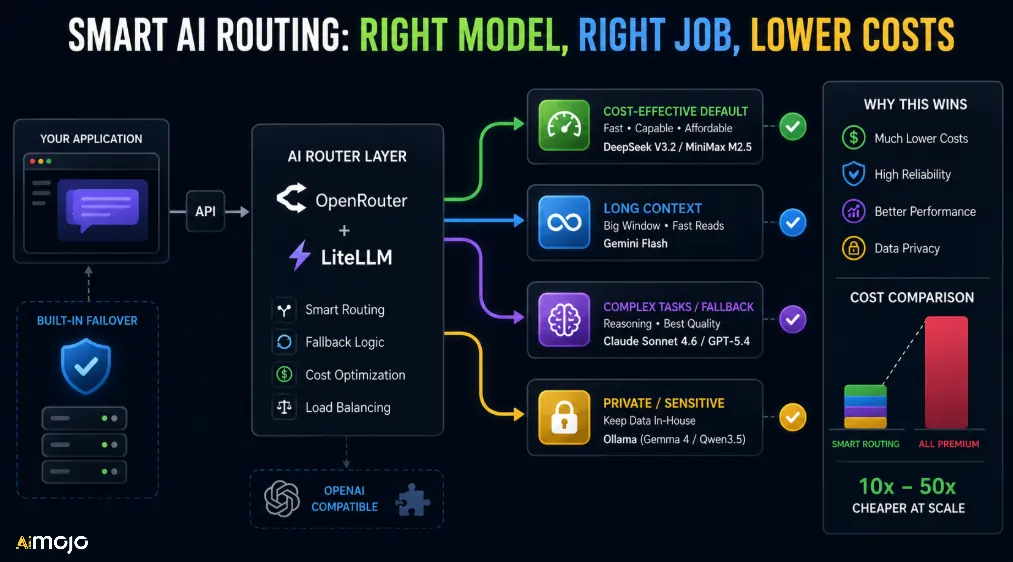
Låsning i en enkelt AI En API-udbyder i 2026 er som at have en enkelt server uden failover. Her's det rutemønster, der's bliver produktionsstandarden:
- Standardtrafik → DeepSeek V3.2 eller MiniMax M2.5 (den billigste model)
- Lang kontekstlæsning → Gemini Flash
- Komplekse opgaver / reserve → Claude Sonnet 4.6 eller GPT-5.4
- Private eller følsomme arbejdsbyrder → Lokal inferens via Ollama (Gemma 4 / Qwen3.5)
Værktøjer, der gør dette nemt: OpenRouter til samlet modeladgang, LiteLLM til et selvhostet routinglag med fallback-logik. Begge understøtter drop-in OpenAI-kompatible slutpunkter, så du ikke behøver at omskrive dine API-kald.
Omkostningsforskellen mellem en "billig standard + premium fallback"-opsætning vs. at route alt gennem GPT-5.4 kan være 10-50 gange så stor om måneden i stor skala.
Skjulte omkostninger, som de fleste udviklere ignorerer
Prisen pr. token på prissiden er aldrig den fulde historie.
Ofte stillede spørgsmål relateret til udviklere AI API'er
Hvad er det billigste AI API til produktionsbrug i 2026?
DeepSeek V3.2 til $0.28/1 mio. inputtokens er i øjeblikket den billigste produktionsmæssigt levedygtige løsning. Groq med Llama 4 Maverick følger lige efter til $0.20/1 mio. med hurtigere inferenshastigheder.
Hvilken AI Har API'en den højeste oppetid (SLA)?
Google Vertex AI tilbyder en SLA på 99.95 % oppetid, hvilket giver den en forspring på OpenAI og antropisk's 99.9 % forpligtelser til virksomhedsarbejdsbelastninger.
Hvordan beregner jeg min månedlige AI API-omkostninger før publicering?
Estimer den gennemsnitlige promptlængde + svarlængden i tokens, gang den med din forventede daglige opkaldsvolumen, og anvend derefter udbyderen's input/output token-rater. De fleste udbydere tilbyder nu omkostningsberegnere – brug dem, før du forpligter dig.
Er DeepSeek API pålidelig nok til produktion?
Det fungerer godt til ikke-kritisk eller standardtrafik med høj volumen i en routingopsætning med flere udbydere. Til missionskritiske arbejdsbelastninger, hvor nedetid er uacceptabel, skal det bruges som primær med et mere pålideligt fallback som GPT-5.4 eller Claude.
Hvad's forskellen mellem AI API-hastighedsgrænser og kontekstgrænser?
Hastighedsgrænser begrænser, hvor mange anmodninger du kan sende pr. minut eller dag. Kontekstgrænser begrænser, hvor meget tekst en enkelt anmodning kan indeholde. Begge påvirker, hvordan du designer din app – forveksl dem ikke.
Kan jeg bruge flere AI API'er samlet i én app?
Ja, og de fleste produktionsopsætninger i 2026 gør præcis det. Værktøjer som OpenRouter og LiteLLM gør routing mellem flere udbydere ligetil med minimale kodeændringer.
Hvilken AI Er API'et bedst til at bygge en kodningsassistent?
Claude Sonnet 4.6 fører an på kodningsbenchmarks i 2026 med et kontekstvindue på 200K, der håndterer virkelige kodebaser uden chunking.
AiMojo anbefaler:


 BONUS: Få vores 200 dollarsAI "Mestringsværktøjskasse" GRATIS ved tilmelding!


