
Napíšete skript. Funguje perfektně na testovacím webu. Pak ho nasměrujete na velkého prodejce nebo sociální platformu. Najednou se váš terminál zaplaví chybami 403 Forbidden nebo nekonečnými smyčkami CAPTCHA.
Éra jednoduchého parsování HTML je u konce.
Moderní web scraping vyžaduje více než jen odeslání požadavku GET. Dnešní webové stránky jsou komplexní aplikace chráněné agresivní obranou. Chcete-li obejít blokování web scrapingu , musíte pochopit, jak prohlížeče komunikují se servery.
Hlavní platformy jako Cloudflare, Akamai a Datadome fungují jako strážci brány. Analyzují každé příchozí připojení. Kontrolují, zda jste člověk nebo skript. Abyste se jim vyhnuli, potřebujete nástroje, které dokonale napodobují lidské chování.
Ukážeme vám, jak efektivně scrapingovat dynamické webové stránky a proč je přesunutí těchto úkolů na Decodo nejchytřejším krokem pro váš datový kanál.
Nutnost „bezhlavého“ přístupu: Proč jednoduché požadavky selhávají

V minulosti webové stránky odesílaly ze serveru celé HTML stránky. Váš skript stáhl text a vy jste extrahovali data.
V současné době se více než 70 % moderních e-commerce webů spoléhá na vykreslování na straně klienta (CSR). Když požádáte o URL adresu, server odešle prázdný HTML shell. Samotný obsah – ceny, skladové zásoby, popisy – se načte později pomocí JavaScriptu.
Pokud používáte standardní HTTP knihovnu, dostanete prázdný shell. Zcela vám uniknou data.
Pro zobrazení obsahu potřebujete pro scraping vykreslování pomocí javascriptu . To obvykle znamená spuštění prohlížeče, jako je Chrome nebo Firefox, na pozadí bez grafického rozhraní. Tomu se říká headless browser scraping.
Spouštění headless prohlížečů je náročné na zdroje. Spotřebovává RAM a CPU. Také to přináší nový problém: detekci.
Luštění kódu systémů proti botům
Bezpečnostní systémy se nedívají jen na vaši IP adresu . Kontrolují také chování vašeho „prohlížeče“.
Pokud používáte standardní automatizační knihovnu, zanechává stopy. Může nastavit proměnnou jako navigator.webdriver = true. To je jasný signál. Antibotové systémy tento příznak vidí a okamžitě vás zablokují.
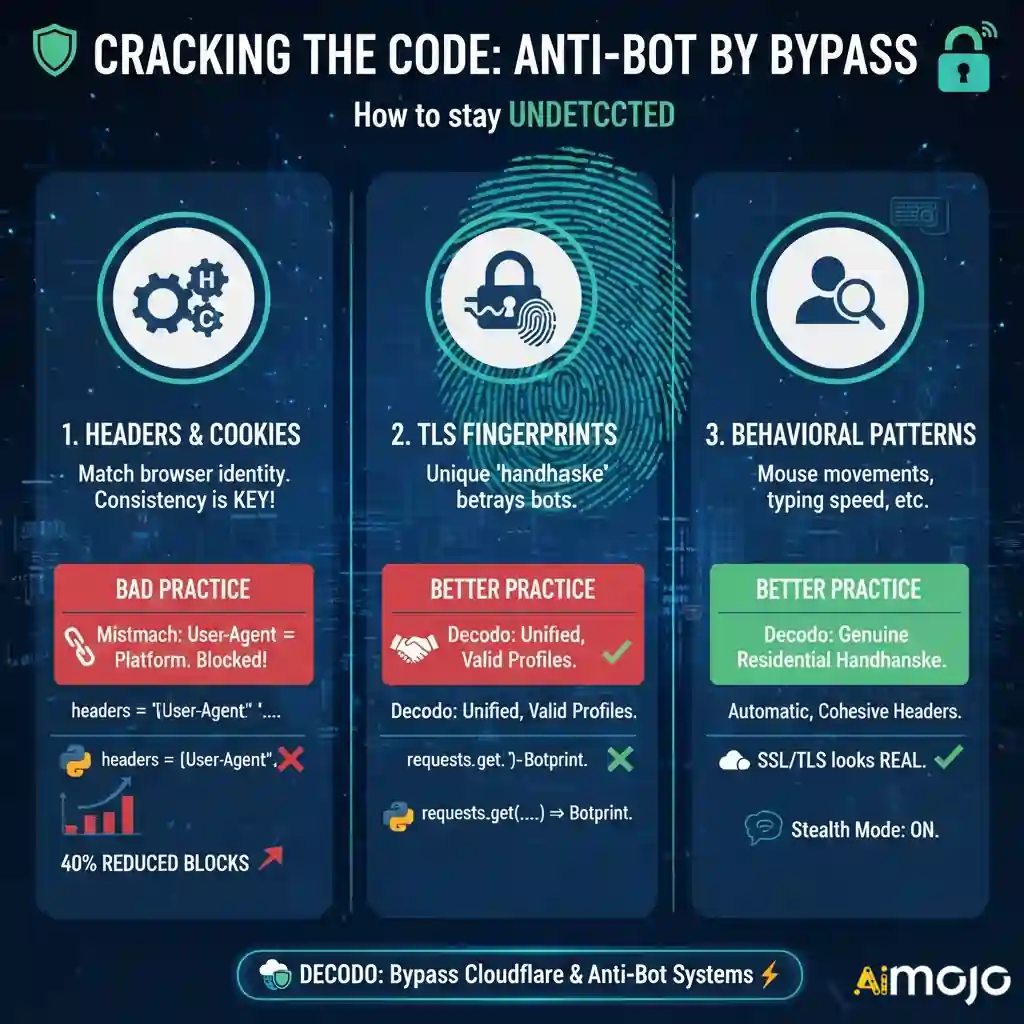
Abyste obešli ochranu proti scrapingu cloudflare , musíte spravovat tři kritické vrstvy:
1. Proč je při web scrapingu důležitá shoda záhlaví
Vaše hlavičky požadavků serveru sdělují, kdo jste. Nejznámějším z nich je User-Agent. Pouhá změna řetězce User-Agent však nestačí.
Záhlaví musí fungovat jako soudržný celek. Pokud odešlete User-Agent, který se ve Windows vydává za Chrome, ale záhlaví vaší platformy vypadají jako Linux, budete zablokováni. Tato neshoda je hlavním důvodem selhání scrapingu.
Správná správa hlaviček požadavků může snížit míru blokování až o 40 % ještě předtím, než vůbec rotujete proxy.
# Toto se často okamžitě zablokuje
požadavky na import
hlavičky = {'User-Agent': 'Mozilla/5.0'}
odpověď = requests.get('https://example.com', headers=hlavičky)
Decodo automaticky vytváří platné a konzistentní profily hlaviček . Zajišťuje, aby vaše nápovědy Accept-Language, Referer a platform odpovídaly verzi prohlížeče, kterou napodobujete.
2. Skrytá past: TLS otisky prstů
Tady selhává většina vlastních scraperů.
Když váš skript naváže zabezpečené připojení HTTPS, provede se serverem „handshake“. Pořadí a parametry tohoto handshake vytvářejí jedinečný otisk prstu, často nazývaný JA3 hash.
Knihovna požadavků v Pythonu má velmi odlišný handshake než skutečný prohlížeč Chrome . Cloudflare tento rozdíl okamžitě rozpozná. I když jsou vaše hlavičky perfektní, vaše strategie obcházení otisků TLS může selhat, pokud vás handshake prozradí.
Decodo tohle řeší na backendu. Upravuje nízkoúrovňové vyjednávání SSL/TLS tak, aby to vypadalo přesně jako skutečný uživatel prohlížející web z domácího připojení.
Nejlepší taktiky pro bezpečné scrapingování jednostránkových aplikací

Jednostránkové aplikace (SPA) jsou známé tím, že se u nich obtížně scrapinguje. Načítají data asynchronně. Scraper může spustit načítání stránky, ale pokud extrahuje data příliš brzy, nic nezíská.
Webové stránky lázní je potřeba scrapingovat čekáním na stav „Network Idle“ (nečinnost sítě). To znamená, že prohlížeč před načtením HTML kódu čeká na dokončení všech volání API na pozadí.
Ruční implementace pomocí nástrojů jako Puppeteer nebo Selenium je nestabilní. Skripty se pádují. Prvky mění názvy ID. Úniky paměti zpomalují server.
Rozhraní API pro scraping webu od Decoda to zjednodušuje. Odešlete požadavek a Decodo spustí prohlížeč, vykreslí JavaScript, počká na ustálení sítě a vrátí čistý HTML kód.
Vytvářejte škálovatelné a nedetekovatelné pracovní postupy pro scraping s Decodo

Vytvoření bezheadless prohlížečové scrapingové mřížky je drahé. Musíte opravovat ovladače Chromu, střídat tisíce IP adres a neustále aktualizovat kód, když Cloudflare změní svůj algoritmus.
Decodo nabízí specializovanou automatizovanou infrastrukturu pro scraping prohlížečů , která se postará o těžkou práci.
Klíčové vlastnosti pro úhybné manévry
Platforma je navržena tak, aby obcházela bloky způsobené scrapingem webu , a to zaměřením na mimikry a spolehlivost:
Stručný průvodce integrací: Použití scrapingového API od Decodo
Zde je návod, jak snadno přepnout z blokovaného lokálního skriptu na Decodo. Prohlížeč nemusíte spravovat sami.
import requests

# Decodo API Endpoint

url = "https://api.decodo.com/v1/scrape"

payload = {

    "url": "https://difficult-site.com/products",

    "render_js": True,  # Activates Headless Browser

    "wait_for_selector": ".product-price", # Waits for dynamic content

    "country": "US" # Uses premium US residential proxies

}

headers = {

    "Authorization": "Bearer YOUR_DECODO_API_KEY",

    "Content-Type": "application/json"

}

response = requests.post(url, json=payload, headers=headers)

if response.status_code == 200:

    print("Scraping Successful!")

    print(response.json()['content'])

else:

    print("Error:", response.text)
Všimněte si jednoduchosti. Neimportujete Selenium. Nestahujete Chromedriver. Jednoduše řeknete Decodu: „Potřebuji tuto URL adresu a prosím, vykreslete JavaScript .“
Výběr mezi Puppeteer, Selenium nebo Decodo API
Mnoho vývojářů začíná s nástroji s otevřeným zdrojovým kódem. Je užitečné pochopit kompromisy mezi Puppeteer, Seleniem a API.
Selenium: Skvělý pro testování, ale pomalý a snadno detekovatelný. Vyžaduje rozsáhlé úpravy, aby se zabránilo spouštěčům obcházení detekce antiboty.
Loutkář/Dramatik: Rychlejší a lepší pro vykreslování JavaScriptu pro scraping. Údržba velkého množství těchto instancí však vyžaduje značné znalosti DevOps. Problémy s proxy a fingerprintingem je stále nutné řešit ručně.

Decodo API: Nejefektivnější cesta. Poskytuje výkon prohlížeče bez nutnosti údržby. Řeší obcházení otisků TLS a správu hlaviček ihned po instalaci.
Díky Decodo API týmy šetří čas vývoje, snižují náklady na infrastrukturu a dosahují vyšší míry úspěšnosti scrapingu napříč složitými moderními webovými stránkami.
Chytřejší, ne těžší škrábání: Nechte to na Decodo
Web se stává čím dál uzavřenějším. Vyhýbání se detekci antibotů je závod ve zbrojení. Pokud trávíte svůj čas inženýrstvím bojem proti Cloudflare, netrávíte čas analýzou svých dat.
Pro scraping dynamických webových stránek nemusíte budovat složitou infrastrukturu . Používáním Decodo získáte přístup k bezhlavému scrapingu prohlížečů na podnikové úrovni, správě relací a pokročilé rotaci otisků prstů.
Přestaňte se blokovat. Nechte Decodo postarat se o složitosti prohlížeče, zatímco se vy budete soustředit na analýzu.
AiMojo doporučuje:


 BONUS: Získejte našich 200 dolarůAI „Sada nástrojů pro mistrovství“ ZDARMA při registraci!


