
إن AI لدى هذا العميل مشكلة. إنه يعرف كل شيء عن العالم، حتى اليوم الذي انتهى فيه تدريبه. اسأله عن أحد المنافسين.'s صفحة التسعير، أو خبر جديد، أو وثائق مكتبة تم شحنها الأسبوع الماضي، إما أن تخمن أو تعتذر.
الحل يكمن في بيانات الويب الآنية. وفي عام 2026، ستكون أسرع طريقة لتمريرها إلى أي AI النظام هو Firecrawl.
نستخدم Firecrawl عبر شبكتنا الخاصة. فهو يدعم عملية استخراج البيانات في تطبيقات الإنتاج لدينا ، ويغذي وكلاء البحث لدينا، ويعمل داخل سير عمل WordPress الخاص بنا.
هذا البرنامج التعليمي هو كل ما كنا نتمنى أن يقدمه لنا أحدهم في اليوم الأول: الإعداد بنقرة واحدة بدون كتابة أي كود، وكود بايثون ونود، والاستخراج المنظم، وخط أنابيب RAG يعمل، وحيل التكلفة التي تحافظ على الفاتورة صغيرة.
بدون أي حشو. دع's بناء. 🚀
ما سنبنيه في دليل Firecrawl هذا
بنهاية هذا الدرس ستعرف كيف:
- قم بتوصيل Firecrawl بـ Claude أو ChatGPT أو Cursor بنقرة واحدة (بدون كتابة أي كود على الإطلاق)
- استخرج أي رابط URL إلى نص Markdown نظيف وجاهز للاستخدام في LLM باستخدام Python أو Node.
- قم بفهرسة موقع ويب كامل وتحويله إلى مجموعة بيانات
- استخراج بيانات JSON منظمة من صفحات غير منظمة باستخدام مخطط
- قم بتوصيل بيانات الويب المباشرة بمسار RAG باستخدام LangChain أو LlamaIndex
- حافظ على استخدامك للائتمان منخفضًا
الشرط الوحيد هو مفتاح واجهة برمجة تطبيقات Firecrawl. هذا الجزء مجاني.
الخطوة الأولى: احصل على مفتاح API الخاص بك (1,000 رصيد مجاني، بدون بطاقة) 🔑
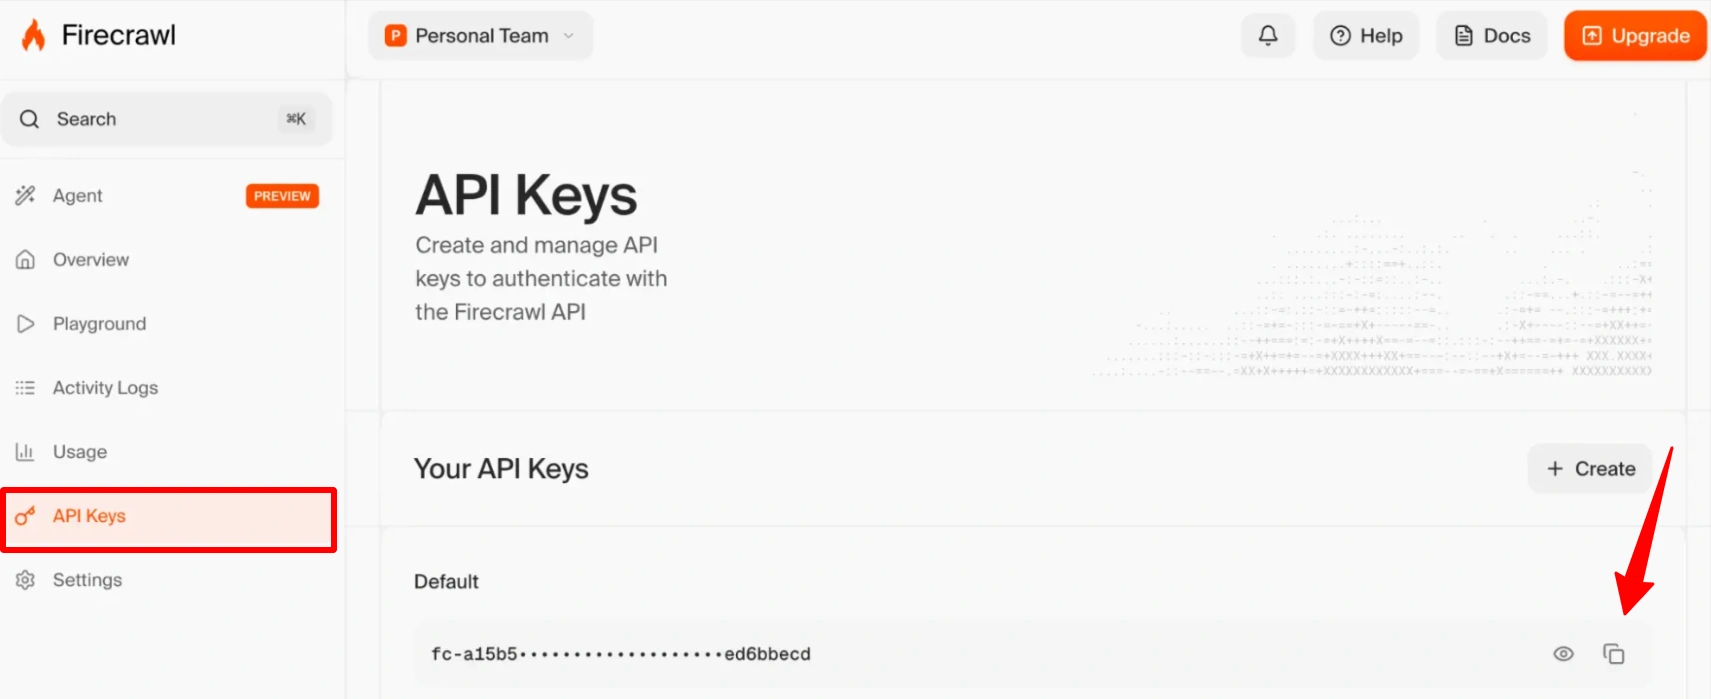
تمنحك الخطة المجانية من Firecrawl ألف رصيد شهريًا . الرصيد الواحد يعادل صفحة واحدة يتم استخراجها، أي ألف صفحة شهريًا، مع تجديد الرصيد تلقائيًا، دون الحاجة إلى بطاقة ائتمان. هذا الرصيد كافٍ جدًا لإكمال هذا الدليل التعليمي مرات عديدة.
|
بمجرد دخولك إلى لوحة التحكم، انسخ مفتاح API الخاص بك. يبدأ المفتاح بـ fc-. هذا المفتاح هو مفتاحك للوصول إلى كل ما يلي.
الخطوة الثانية: المسار بنقرة واحدة (لا يتطلب رمزًا) ⚡
قبل أن نكتب سطرًا واحدًا من التعليمات البرمجية، اعلم هذا: قد لا تحتاج إلى أي منها.
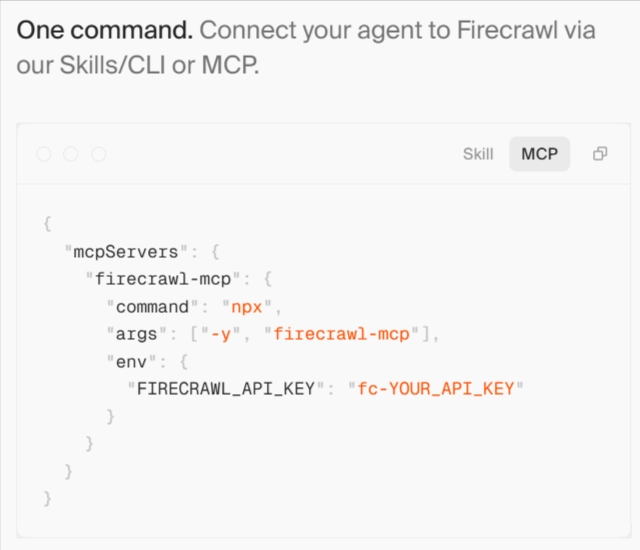
يُشغّل برنامج Firecrawl خادم MCP (بروتوكول سياق النموذج) رسميًا، ويتصل بخادمك المفضل. AI يمكنك استخدام الأدوات بنفس طريقة ربط حساب Gmail. يوجد الخادم المستضاف على العنوان التالي:
https://mcp.firecrawl.dev/v2/mcpأضف مفتاح API الخاص بك إلى عنوان URL، ويمكن لأي أداة متوافقة مع MCP استخدامه:
https://mcp.firecrawl.dev/fc-YOUR_API_KEY/v2/mcpفي Claude (الويب أو سطح المكتب): أضف Firecrawl كموصل، أو ضع هذا في ملف claude_desktop_config.json:
{
  "mcpServers": {
    "firecrawl": {
      "command": "npx",
      "args": ["-y", "firecrawl-mcp"],
      "env": {
        "FIRECRAWL_API_KEY": "fc-YOUR_API_KEY"
      }
    }
  }
}بمجرد الاتصال، AI المساعد يحصل على عشر قدرات جديدة: الكشط، والبحث، والزحف، ورسم الخرائط، والاستخراج، والتفاعل، والمراقبة، والتحليل، والبحث، ووكيل مستقل تمامًا. وتتحكم بكل ذلك بلغة إنجليزية بسيطة.
جرب استخدام عبارات مثل هذه:
- قم باستخراج البيانات من https://competitor.com/pricing وقم بتلخيص كل خطة في جدول.
- قم بتصفح المستندات الموجودة على docs.example.com، بحد أقصى 50 صفحة، واشرح كيفية عمل نظام المصادقة الخاص بهم.
- ابحث في الإنترنت عن "الأفضل" AI "مولدات الفيديو 2026" وقارن أفضل 5 نتائج.
هذا هو الإعداد الذي يستخدمه أعضاء فريقنا غير التقنيين يوميًا. لا حاجة إلى سطر أوامر، ولا كتابة أكواد، بل بيانات ويب حقيقية مباشرة في كل محادثة. إذا كان هذا كل ما تحتاجه، يمكنك التوقف هنا. أما إذا كنت تُطوّر تطبيقات، فإن واجهة برمجة التطبيقات (API) هي ما يجعل استخدام Firecrawl ممتعًا.
الخطوة 3: استخراج بيانات صفحتك الأولى باستخدام واجهة برمجة التطبيقات 🐍
حان وقت البرمجة. قم بتثبيت حزمة تطوير البرامج (SDK):
# Python
pip install firecrawl
# Node.js
npm install firecrawl
يتطلب استخراج البيانات من عنوان URL ثلاثة أسطر. إليك الكود البرمجي بلغة بايثون:
من فايركراول استورد فايركراول
firecrawl = Firecrawl(api_key="fc-YOUR_API_KEY")
doc = firecrawl.scrape("https://firecrawl.dev", formats=["markdown"])
print(doc.markdown)
وNode:
import { Firecrawl } from 'firecrawl';
const firecrawl = new Firecrawl({ apiKey: 'fc-YOUR_API_KEY' });
const doc = await firecrawl.scrape('https://firecrawl.dev', { formats: ['markdown'] });
console.log(doc.markdown);
شغّله وانظر إلى الناتج. هذه هي الميزة الفريدة التي تجعل Firecrawl مميزًا: فالناتج ليس مجرد كود HTML خام، بل هو نص Markdown نظيف يحتوي على عناوين وقوائم وروابط مناسبة، مع إزالة أشرطة التنقل وإعلانات ملفات تعريف الارتباط والبرامج النصية وعناصر التذييل غير الضرورية.
لماذا يُعدّ هذا الأمر بالغ الأهمية؟ لسببين: الرموز والدقة. قد يصل حجم كود HTML الخام لصفحة نموذجية إلى عشرة أضعاف حجم محتواها الفعلي، وكل رمز غير ضروري يُكلّف مالًا ويُضعف نموذجك.'s انتباه. تعني لغة الترميز النظيفة مطالبات أصغر، وفواتير أقل لبرنامج الماجستير في القانون، وإجابات تستند إلى المحتوى بدلاً من الفوضى.
يمكنك أيضًا طلب تنسيقات أخرى في نفس الطلب: HTML، لقطة شاشة، روابط، أو JSON منظم. قم بتجميعها حسب الحاجة.
doc = firecrawl.scrape(
    "https://example.com/blog/post",
    formats=["markdown", "links"]
)
يقوم Firecrawl بعرض جافا سكريبت افتراضيًا، لذا فإن مواقع React والصفحات الديناميكية والمحتوى المعروض من جانب العميل تظهر كاملةً. لا حاجة لمراقبة المتصفح بدون واجهة رسومية من جانبك.
الخطوة الرابعة: زحف إلى موقع ويب كامل 🕸️
الصفحة الواحدة هي عرض توضيحي. الموقع بأكمله عبارة عن مجموعة بيانات.
تتبع نقطة نهاية الزحف الروابط من عنوان URL ابتدائي وتقوم بجمع كل ما تجده، مع عناصر تحكم في العمق وحدود الصفحات وفلاتر المسار:
from firecrawl import Firecrawl
from firecrawl.types import ScrapeOptions
firecrawl = Firecrawl(api_key="fc-YOUR_API_KEY")
crawl_status = firecrawl.crawl(
    'https://docs.example.com',
    limit=100,
    scrape_options=ScrapeOptions(formats=['markdown']),
    poll_interval=30
)
for page in crawl_status.data:
    print(page.metadata.url)
إصدار Node:
const crawlResponse = await firecrawl.crawl('https://docs.example.com', {
  limit: 100,
  scrapeOptions: { formats: ['markdown'] }
});
console.log(`Crawled ${crawlResponse.data.length} pages`);
تتولى حزمة تطوير البرامج (SDK) عملية استطلاع الوظائف وترقيم الصفحات نيابةً عنك، وتعيد كل صفحة بتنسيق Markdown نظيف. ثلاثة معايير جديرة بالحفظ:
- قصر عدد الصفحات الإجمالي المسموح به. احرص على ضبطه دائمًا. هذا هو حزام الأمان الخاص بك.
- تضمين المسارات / مسارات الاستبعاد قم بتصفية عناوين URL باستخدام أنماط التعبيرات النمطية. هل تقوم بفهرسة موقع وثائقي؟ استبعد /blog/.* و /careers/.* وتوقف عن دفع ثمن الصفحات التي لن تستخدمها أبدًا.
- أقصى عمق للاكتشاف يتحكم في عدد مرات الانتقال بين الروابط التي يتبعها برنامج الزحف من عنوان URL الأساسي.
نصيحة احترافية: قبل أي عملية زحف واسعة النطاق، استخدم نقطة نهاية الخريطة أولاً. فهي تُعيد جميع عناوين المواقع الإلكترونية في غضون ثوانٍ معدودة وبتكلفة زهيدة. حدد نطاق المهمة، واحسب عدد الصفحات، ثم ازحف إلى ما تحتاجه بالضبط.
result = firecrawl.map("https://docs.example.com")
print(f"{len(result.links)} URLs found")
الخطوة 5: استخراج البيانات المنظمة باستخدام مخطط 📊
تُعدّ لغة Markdown مثاليةً لأسلوب RAG. ولكن في بعض الأحيان، تحتاج إلى حقول، لا إلى نصوص: أسماء المنتجات، والأسعار، والتقييمات. هذه هي نقطة نهاية الاستخراج.'s الوظيفة. أنت تصف شكل البيانات، فايركراول's AI يسحبها من الصفحة:
schema = {
    "type": "object",
    "properties": {
        "product_name": {"type": "string"},
        "price": {"type": "string"},
        "rating": {"type": "number"},
        "in_stock": {"type": "boolean"}
    },
    "required": ["product_name", "price"]
}
result = firecrawl.extract(
    urls=["https://example-store.com/product/xyz"],
    prompt="Extract the product details from this page",
    schema=schema
)
print(result.data)
لا توجد مُحدِّدات CSS. لا توجد XPath. لا يوجد مُحلِّل يتعطل بمجرد تغيير تصميم الموقع. أنت تُحدِّد ما تُريد، ويبقى الاستخراج سليمًا بعد إعادة التصميم لأنه يفهم المحتوى، وليس الترميز.
هذا النمط بالتحديد مُطبّقٌ في بيئة الإنتاج على شبكتنا: أحد تطبيقاتنا يستخدم أداة Extract لتحويل صفحات مزودي الخدمات غير المنظمة إلى قاعدة بيانات أسعار موحدة، تلقائيًا، وفق جدول زمني محدد. يعمل المخطط نفسه عبر عشرات المواقع ذات التصاميم المختلفة. جرّب بناء ذلك باستخدام التعبيرات النمطية وأخبرنا بالنتيجة. 😅
الخطوة السادسة: زوّد وكيلك بخاصية البحث عبر الإنترنت 🔎
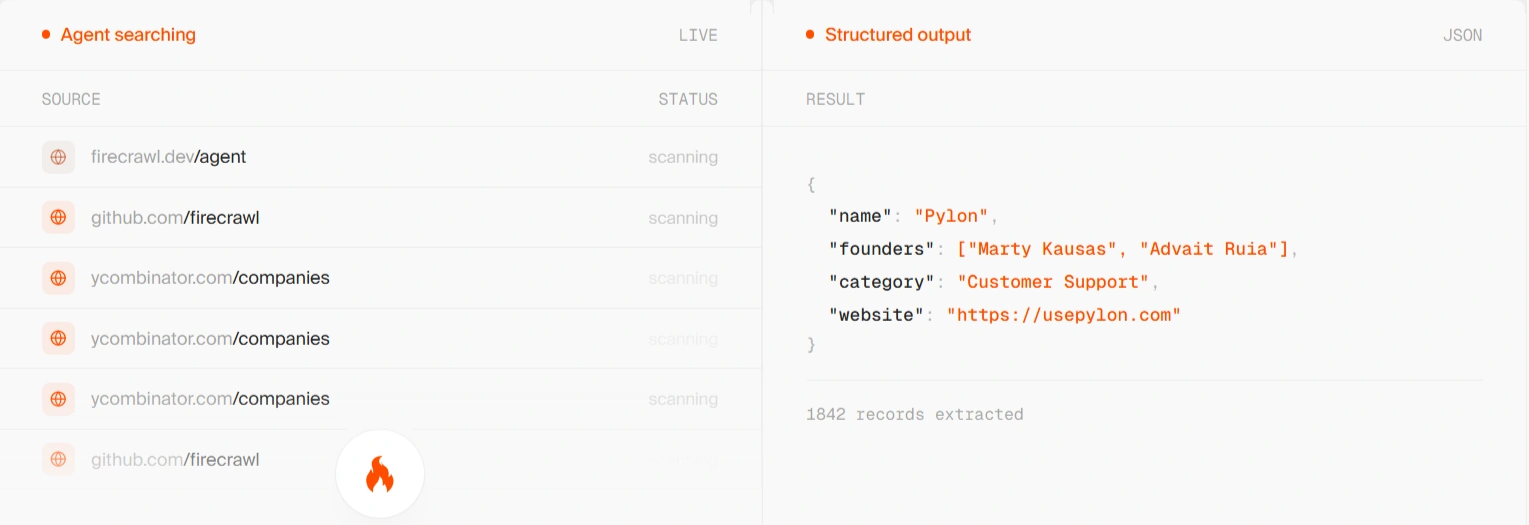
تتولى خاصية استخراج البيانات معالجة عناوين المواقع التي تعرفها بالفعل. أما خاصية البحث فتتولى معالجة العناوين التي لا تعرفها.
تُعدّ نقطة نهاية البحث في Firecrawl الميزة الأبرز في المنصة. فمعظم واجهات برمجة تطبيقات البحث تُعيد روابط ومقتطفات من النتائج، ثم تترك لك مهمة جلب كل نتيجة وتنظيفها بنفسك. أما Firecrawl، فتُعيد النتائج مع المحتوى الكامل المُستخرج ، في طلب واحد.
results = firecrawl.search(
    query="best open source LLMs 2026",
    limit=5
)
for item in results.web:
print(item.title, item.url)Node، مع تمكين استخراج المحتوى لكل نتيجة:
const results = await firecrawl.search('best open source LLMs 2026', {
  limit: 5,
  scrapeOptions: { formats: ['markdown'] }
});
هذا هو أساس عمل برامج البحث الآلية . العملية بسيطة: يقوم برنامجك بإنشاء استعلام، ثم يعرض Firecrawl محتوىً قابلاً للقراءة من أفضل النتائج، ويقوم برنامجك بتجميع الإجابة مع المصادر. هذا هو البحث المعمق، وقد أنشأته للتو في بضعة أسطر.
ملاحظة حول التكلفة: تُحسب تكلفة البحث برصيدين لكل 10 نتائج، بالإضافة إلى رصيد استخراج البيانات المعتاد عند جلب المحتوى الكامل. ومع ذلك، لا يزال هذا أرخص بكثير من أي واجهة برمجة تطبيقات مخصصة للإجابات قمنا باختبارها.
الخطوة 7: قم بتوصيله بخط أنابيب RAG 🧠
والآن الحدث الرئيسي: إطعام AI معرفة مباشرة بالويب من قبل الوكيل. كلا الإطارين الرئيسيين يوفران أدوات تحميل Firecrawl من الدرجة الأولى.
لانجشين:
- from langchain_community.document_loaders import FireCrawlLoader
- from langchain_text_splitters import RecursiveCharacterTextSplitter
- من langchain_openai استيراد OpenAIEmbeddings
- from langchain_community.vectorstores import FAISS
# 1. تحميل الموقع بأكمله كمستندات نظيفة
loader = FireCrawlLoader(
    api_key="fc-YOUR_API_KEY",
    url="https://docs.example.com",
    mode="crawl"
)
docs = loader.load()
# 2. قسّمها إلى قطع
splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=100)
chunks = splitter.split_documents(docs)
#3. التضمين والفهرسة
vectorstore = FAISS.from_documents(chunks, OpenAIEmbeddings())# 4. اطرح أسئلة على بيانات الويب المباشرة
retriever = vectorstore.as_retriever()
relevant = retriever.invoke("How do I authenticate API requests?")
مؤشر اللاما:
- from llama_index.readers.web import FireCrawlWebReader
- من llama_index.core قم باستيراد VectorStoreIndex
reader = FireCrawlWebReader(
    api_key="fc-YOUR_API_KEY",
    mode="crawl",
    url="https://docs.example.com"
)
documents = reader.load_data()
index = VectorStoreIndex.from_documents(documents)
response = index.as_query_engine().query("How does their pricing work?")
print(response)
هذه آلية كاملة للتفاعل مع أي موقع ويب في أقل من 25 سطرًا. ولأن Firecrawl يُزوّد المُحمّل بملف Markdown نظيف بدلًا من HTML، فإن أجزاء المحتوى تكون متماسكة، والتضمينات ذات معنى، وجودة الاسترجاع تتحسن بشكل ملحوظ مقارنةً بالاستخراج التقليدي. هذا هو السبب الرئيسي الذي يدفع مطوري تطبيقات RAG لاختيار Firecrawl.
تعمل نفس أدوات التحميل مع CrewAI و Dify و Flowise و n8n إذا كانت سير العمل المرئي تناسبك أكثر.
إضافة: الهندسة المعمارية الموفرة للتكاليف التي لا يتحدث عنها أحد 💡
إليكم النمط الذي يوفر لتطبيقاتنا أموالاً حقيقية كل شهر.
عندما يحتاج تطبيقك إلى إجابات متوافقة مع الويب، فإن الخيار الأمثل هو استخدام نظام إدارة التعلم (LLM) مزود بخاصية بحث ويب مدمجة . لكن مزودي هذه الخدمة يفرضون رسومًا إضافية على البحث عبر الويب، كما أن واجهات برمجة تطبيقات الإجابات المخصصة تصبح مكلفة للغاية عند التوسع.
الخيار الأذكى:
Firecrawl (جلب البيانات، حوالي 0.001 دولار/صفحة) → ماجستير قانون رخيص (السبب: لا حاجة للوصول إلى الإنترنت)
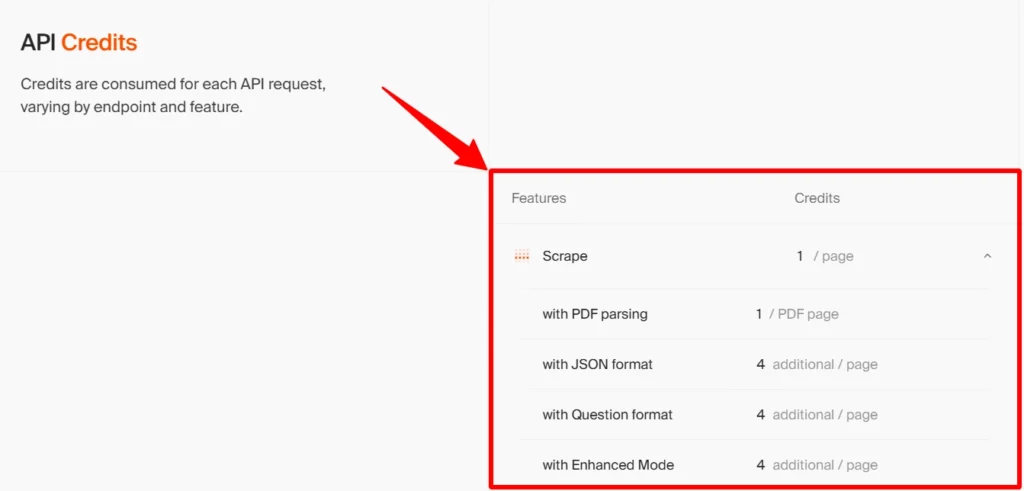
يقوم برنامج Firecrawl بالبحث وجمع البيانات مقابل رصيد أو اثنين لكل طلب. بعد ذلك، يقوم أي نموذج منخفض التكلفة، مثل DeepSeek أو GPT صغير أو Claude، أو أي نموذج مفتوح المصدر آخر تستخدمه على خادمك الافتراضي الخاص، بتلخيص وكتابة المحتوى النظيف. نفس جودة الإجابة، ولكن بتكلفة أقل بكثير.
وهذا يعمل بشكل رائع أيضًا لـ الإعدادات ذاتية الاستضافةهل تستخدم واجهة مستخدم دردشة مفتوحة المصدر مثل Open WebUI على خادم افتراضي خاص (VPS)؟ قم بتوصيل Firecrawl كطبقة بحث وزحف ويب، وخادمك المستضاف ذاتيًا. AI فجأةً، أصبح البحث المباشر العميق يشبه المنتجات التجارية الكبيرة.
نصائح لتوفير المال: استغل 1,000 رصيد مجاني لأقصى حد 🪙
مرجع سريع للحفاظ على الاستخدام الأمثل:
| اكشن | تكلفة الائتمان |
|---|---|
| كشط / زحف / رسم خرائط / مراقبة | رصيد واحد لكل صفحة |
| البحث | نقطتان لكل 10 نتائج |
| التفاعل (إجراءات المتصفح) | 2 رصيد في الدقيقة |
| الوضع الخفي (المواقع المحمية) | 5 نقاط لكل صفحة |
خمس عادات مهمة:
- ارسم الخريطة قبل أن تبدأ بالزحف. اعرف عدد الصفحات قبل أن تدفع ثمنها.
- مجموعة دائما قصر عند الزحف. القيمة الافتراضية هي 10,000 صفحة. خطتك المجانية هي 1,000 صفحة. احسبها مرة واحدة فقط، وليس لاحقًا.
- استعمل مسارات الاستبعاد بشكل عدواني. أرشيفات المدونات وصفحات الوسوم وصفحات الوظائف هي بمثابة مكبات نفايات للحقوق.
- قم بتخزين البيانات التي تجمعها مؤقتًا. تتغير مواقع المستندات أسبوعياً، وليس كل ساعة. خزّن النتائج وأعد الزحف وفقاً لجدول زمني بدلاً من كل طلب على حدة.
- لا يتم ترحيل الرصيدلذا، إذا قمت بالترقية، فاختر الخطة التي تناسب حجم استخدامك الشهري الفعلي. تبدأ الخطط المدفوعة من 16 دولارًا شهريًا مقابل 5,000 رصيد، وتمنحك الخطة القياسية مقابل 83 دولارًا 100,000 صفحة.
الأخطاء الشائعة (وحلولها السريعة) 🛠️
خمس مشكلات تُفسر جميع رسائل "Firecrawl لا يعمل" التي نتلقاها تقريبًا:
وثمة أمرٌ لا ينبغي اعتباره خطأً، يجدر معرفته: إذا فشل طلبٌ ما على Firecrawl's من ناحية أخرى، لن يتم تحصيل أي رسوم منك مقابل ذلك.
إجابات سريعة 🎯
كيف يعمل برنامج فايركراول؟
ترسل عنوان URL (أو استعلام بحث) إلى واجهة برمجة التطبيقات الخاصة بها، فتعيد المحتوى بتنسيق Markdown نظيف، أو JSON، أو لقطات شاشة، مع معالجة عرض JavaScript وإزالة العناصر غير المرغوب فيها تلقائيًا. رصيد واحد لكل صفحة.
هل لعبة Firecrawl جيدة لـ RAG؟
إنه الخيار الافتراضي في عام 2026. مخرجات Markdown النظيفة تعني أجزاء أفضل، وتضمينات أفضل، واسترجاع أفضل، مع أدوات تحميل رسمية لـ LangChain و LlamaIndex.
هل يمكنني استخدام Firecrawl بدون كتابة أكواد؟
نعم. يقوم موصل MCP بنقرة واحدة بوضع وظائف الكشط والزحف والبحث والاستخراج داخل Claude و ChatGPT و Perplexity و Cursor، مدعومة بمطالبات باللغة الإنجليزية البسيطة.
هل هناك باقة مجانية؟
١٠٠٠ رصيد شهريًا، قابلة للتجديد، بدون الحاجة إلى بطاقة. احصل عليها الآن مع خصم ١٠٪ على أول ترقية.
الخلاصة: وكيلك، الآن بعينين 👀
ملخص لما تعلمته للتو:
الفجوة بين AI عميل يخمن و AI الوكيل الذي يعرف هو مفتاح API واحد. يمنحك Firecrawl ألف رصيد مجاني شهريًا لإغلاقه، وكل مثال في هذا الدليل يعمل ضمن هذا الحد المسموح به.
هل لديك نسخة مبنية باستخدام Firecrawl؟
أخبرونا في التعليقات. أفضل مشاريع القراء ستُنشر في نشرتنا الإخبارية. ✌️


 BONUS: احصل على 200 دولارAI "مجموعة أدوات الإتقان" مجانية عند التسجيل!