
Zyte 关键见解
Zyte是什么?
合特 Zyte 是一个企业级网页抓取和数据提取平台,使企业能够从几乎任何网站大规模收集结构化网页数据。Zyte 成立于 2010 年,前身为 Scrapinghub,其旗舰产品 Zyte API 作为一个单一接口,可处理代理轮换、绕过封禁、JavaScript 渲染、验证码破解等功能。 AI 自动提取数据。
该平台还维护着最流行的开源 Python 爬虫框架 Scrapy,并提供 Scrapy Cloud 用于爬虫部署。Zyte 为全球各地的数据团队提供服务。 电商监控市场情报、搜索引擎结果页面跟踪和 AI 训练数据工作流程。凭借超过15年的运营历史和每月在116个国家/地区处理的数十亿次请求,它仍然是网络数据行业中最知名的公司之一。
Zyte 的核心优势在于其智能解封系统。该 API 会针对每个目标网站自动选择合适的代理类型、指纹识别和请求模式组合。在 Proxyway 的独立测试中,Zyte API 的成功率高达 97.82%,优于 Bright Data、Oxylabs和Smartproxy。您只需发送 URL,引擎即可确定实现成功响应的最经济路径。这意味着更少的请求失败、更低的成本,以及无需花费时间调试阻塞。
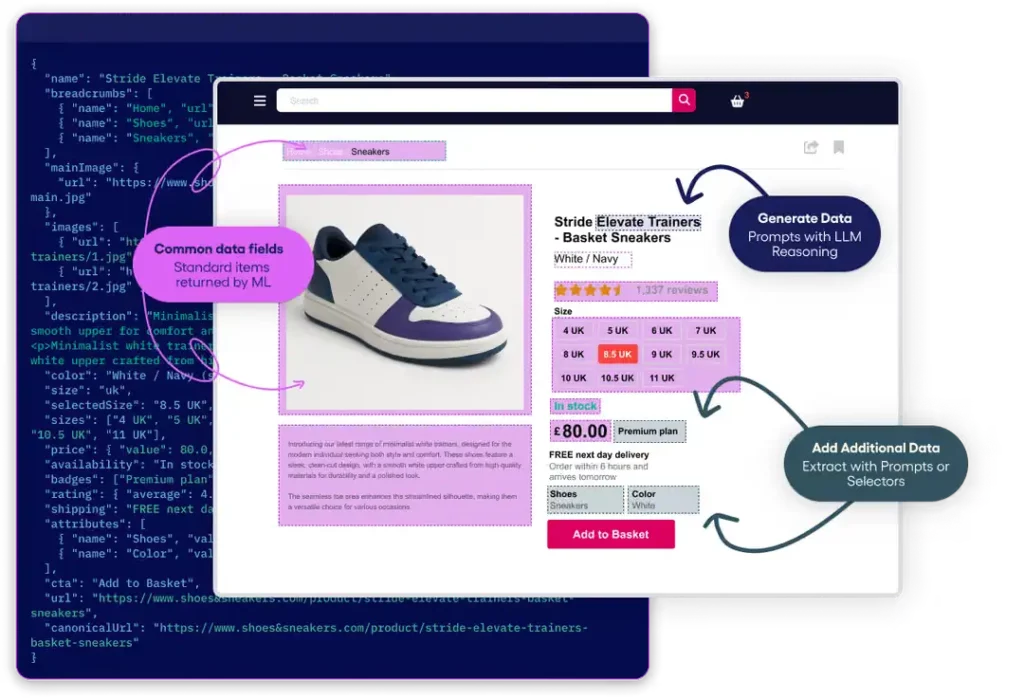
Zyte 使用机器学习模型将原始 HTML 转换为简洁、结构化的 JSON,无需您编写任何 CSS 选择器或 XPath 表达式。支持的数据类型包括产品列表、文章、职位发布和搜索引擎结果。对于内置模式之外的任何内容,由大型语言模型驱动的自定义属性提取功能允许您使用纯英文定义字段。这消除了困扰大多数网络爬虫操作的脆弱的解析器维护问题。
Zyte 抓取的每个网站都会自动被归类到五个难度等级之一,从简单到高级。系统会为每个请求分配最具成本效益的技术栈,确保您不会为简单的网站支付过高的费用。在更高级别的套餐中,HTTP 请求的起价低至每 1,000 次 0.06 美元。这种自动化方法消除了预算方面的猜测,让平台代表您优化支出。
对于 JavaScript 密集型单页应用 (SPA) 和需要用户交互的页面,Zyte 提供完整的无头浏览器渲染功能,支持点击、表单填写、滚动和导航等操作。预热的“即时浏览器”实例消除了冷启动延迟,使页面加载时间低于 100 毫秒。这对于电子商务和房地产数据抓取尤为重要,因为这些应用的内容加载在动态 UI 元素之后。
Zyte 维护着开源的 Scrapy 框架,并提供 Scrapy Cloud 作为托管环境,用于部署、调度和监控 Scrapy 爬虫。团队可以直接从 GitHub 推送代码,按计划运行任务,并查看实时日志和仪表盘。这使其成为任何基于 Scrapy 的项目的理想生产环境。
Zyte联合创立了“道德网络数据收集倡议”(Ethical Web Data Collection Initiative),并将合规保障措施直接构建于API中。个人身份信息不会被自动提取,住宅代理访问需要KYC验证,网站登录信息抓取也受到限制。对于金融和保险等受监管行业,Zyte的法律和合规团队会提供负责任数据收集方面的直接指导。
Zyte 定价计划
Zyte 提供三种不同的产品,每种产品都有自己的定价结构。
Zyte API 定价
| 租赁计划 | 每月承诺 | 每千次响应的HTTP流量 | 每 1,000 次响应的浏览器渲染次数 |
|---|---|---|---|
| 现收现付 | $0 | 从$ 0.13到$ 1.27 | 从$ 1.01到$ 16.08 |
| 100美元承诺 | $100 | 从$ 0.10到$ 0.95 | 从$ 0.75到$ 12.00 |
| 200美元承诺 | $200 | 从$ 0.08到$ 0.76 | 从$ 0.60到$ 9.60 |
| 500美元承诺 | $500 | 从$ 0.06到$ 0.61 | 从$ 0.48到$ 7.68 |
| 企业版 | 定制化 | 定制化 | 定制化 |
Zyte 数据定价
| 租赁计划 | Cost | Delivery | 格式 | 后期处理 | 爬网控制 | 质量保证 |
|---|---|---|---|---|---|---|
| 标准版 | $ 500 /月 | Zyte AWS S3 存储桶 | JSON、CSV 或 XML | 可作为升级选项 | 由 Zyte 团队管理的固定预定义配置 | 标准化,由模式预先定义 |
| 定制化 | 每月$ 1,000起 | 交付到您首选的云平台(AWS、Google Cloud、Azure) | JSON、CSV、XML 或其他格式 | 包含数据去重和匹配等高级选项 | 对爬行配置拥有完全控制权 | 客户特定基准 |
Scrapy 云定价
| 租赁计划 | Cost | 爬虫运行时 | 并发爬取 | 信息保存期限 | 生产计划 | 的解决方案 |
|---|---|---|---|---|---|---|
| 入门版 | 免费 | 爬行时间1小时 | 1 个并发爬取 | 数据保留期为7天。 | 用户手册 | 标准版 |
| 专业 | 每单位每月 9 美元 | 无限爬取运行时长 | 无限并发爬取 | 数据保留期为120天。 | 智能爬网调度 | 优先处理 |
Zyte如何处理反机器人防御
Zyte 的反封禁引擎是整个平台的核心,也是企业团队选择它而不是自行搭建代理和浏览器堆栈的主要原因。该系统采用专利技术。 AI 它会分析每个目标站点的防御措施,并选择成功应对所需的最低技术。如果数据中心的IP地址足够,它就会使用数据中心的IP地址。
如果需要轮换使用完整的浏览器渲染,系统会自动升级。这种“默认精简”的方法在保持 97.82% 基准成功率的同时,将成本降至最低。会话持久性和指纹轮换无需您进行任何配置。
Zyte托管数据服务详解
对于希望获取结构化网络数据但又不想构建或维护任何爬虫基础设施的团队,Zyte 提供完全托管的数据源服务。您只需指定数据类型、数据源和交付计划。Zyte 的工程师将构建爬虫程序,处理所有反机器人逻辑,并将清洗后的数据交付到您指定的目的地。
该服务包含合规性审查作为标准流程,因此适用于金融服务、保险和其他受监管行业。Zyte 声称,得益于其技术,新的数据源可以在数小时内上线,而不是数周。 AI 自动化 层。对于需要网络数据但缺乏内部爬虫技术的企业来说,这是一个不错的选择。
利与弊
- 独立解封成功率最高。
- AI 提取操作无需维护解析器。
- 包含完整的Scrapy生态系统集成。
- 内置法律合规保障机制。
- 只为成功的回复付费。
- 全球地理定位,覆盖116个国家。
- 分级定价可能很复杂。
- 没有可视化无代码构建器可用。
- 客服响应速度偶尔会变慢。
- 无自主代理浏览模式。


