

La plupart des gens arrivent sur Hugging Face , fixent un mur de noms de mannequins et quittent le site en moins de 30 secondes. Grosse erreur.
Alors que tout le monde débat de la question de savoir lequel AI Cet outil vaut son prix ; des dizaines de milliers de développeurs utilisent discrètement Hugging Face pour exécuter, peaufiner et… navire AApplications alimentées par I — entièrement gratuit.'s pas seulement une bibliothèque de modèles.'s la plateforme où Google, Meta, Mistral et les développeurs indépendants travaillent tous dans le même espace.
Plus d'un million de modèles, plus de 500 1 jeux de données et un hébergement d'applications gratuit : tout cela avec un seul compte. Voici une présentation complète de ce service et de son utilisation.
Qu'est-ce que le Hugging Face exactement ? (La plupart des gens se trompent à ce sujet)
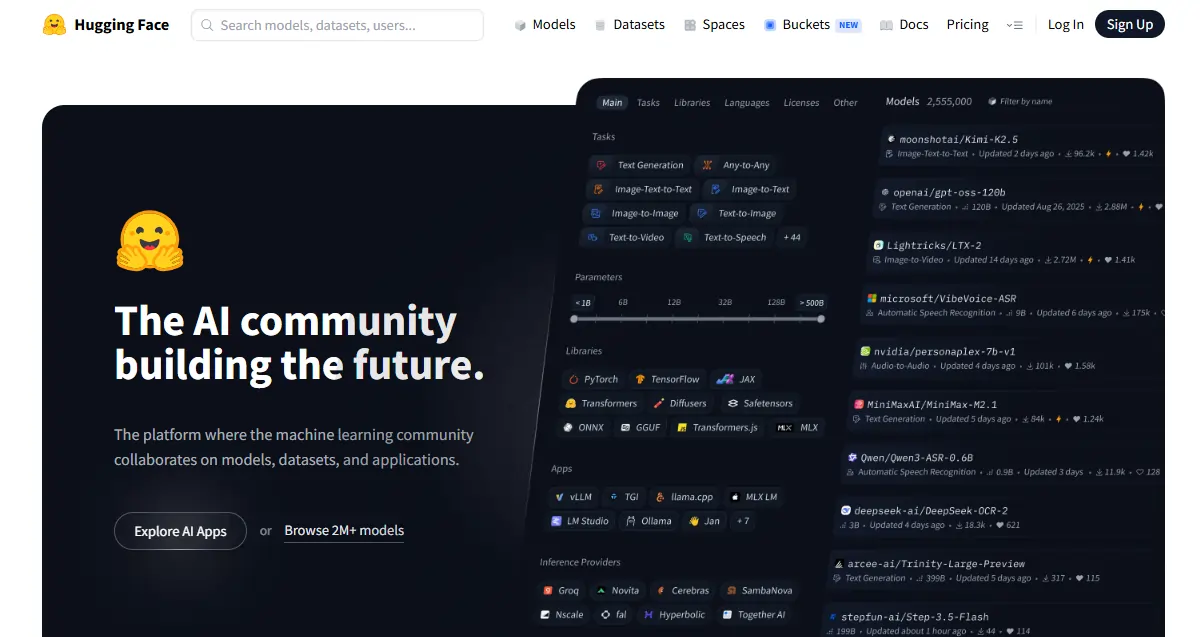
L'expression « GitHub du Machine Learning » est souvent galvaudée. Elle se vérifie dans un sens : dépôts publics, contrôle de version, contributions de la communauté. Mais elle se heurte rapidement à ses limites. Hugging Face propose également l'inférence en temps réel, héberge des applications basées sur l'IA et fournit une infrastructure d'entraînement complète. GitHub ne fait rien de tout cela.
L'entreprise a débuté comme une startup spécialisée dans les chatbots NLP, avant de se tourner vers l'open source. AI l'outillage, et je n'ai jamais regardé en arrière. La plateforme publique is fgratuit et axé sur la communautéLes produits destinés aux entreprises constituent leur principale source de revenus. Pour les débutants, la version gratuite offre tout le nécessaire. Les modèles sont publiés ici. avant Ils font les gros titres — si une nouveauté apparaît dans le domaine de l'IA, c'est sur Hugging Face qu'elle se retrouve en premier.
Les trois piliers — À connaître avant tout
Tout sur Hugging Face est organisé en trois sections principales :
| Pilier | En quoi ça consiste | Pourquoi ça compte |
|---|---|---|
| Modèles | Plus d'un million de personnes pré-entraînées AI numériques jumeaux (digital twin models) | Omettez complètement la formation à partir de zéro |
| Jeux de données | Données brutes pour l'entraînement et les tests | Données standardisées, prêtes à être chargées |
| Les espaces | Hébergement gratuit AI applications | Modèles de test sans modifier le code de déploiement |
Familiarisez-vous avec ces trois éléments — ils interagissent constamment au fur et à mesure de votre construction.
Le centre de modélisation — où vous passerez la majeure partie de votre temps
Le panneau de filtres est votre meilleur allié : il vous permet de sélectionner le type de tâche, le framework (PyTorch, TensorFlow, JAX), le langage, la licence et la taille du modèle. Triez par nombre de téléchargements pour des modèles éprouvés ; triez par date de mise à jour pour découvrir de nouvelles options.
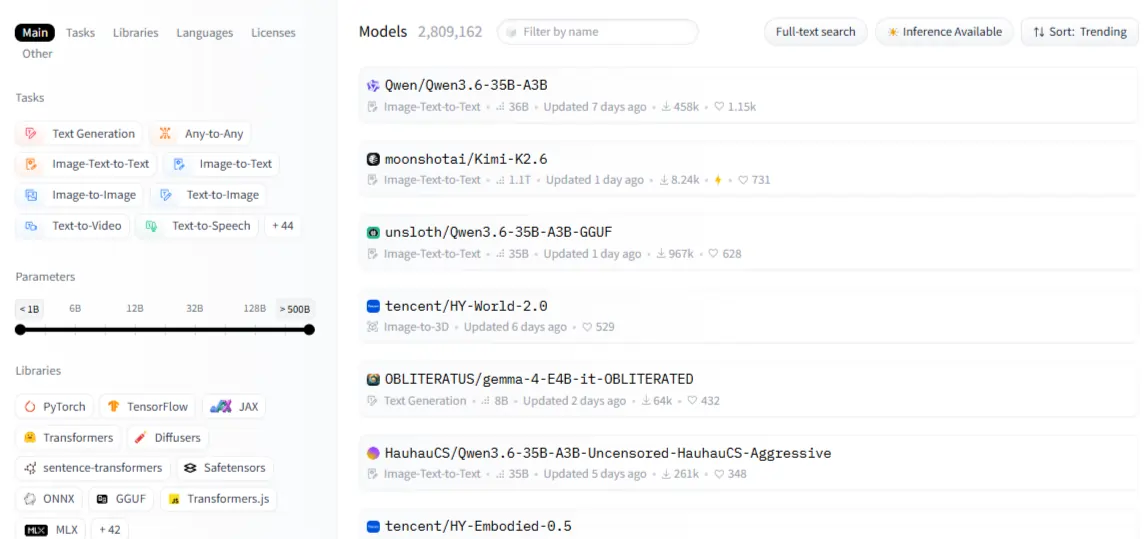
Chaque modèle possède une fiche descriptive : lisez-la attentivement. La section « Utilisation prévue » indique pour quoi le modèle a été conçu ; la section « Limitations » précise ses points faibles. Cette dernière partie est plus précieuse que n’importe quel score de référence. Les catégories de modèles couvrent le traitement automatique du langage naturel (classification de texte, résumé, traduction, réponse aux questions), la vision (classification d’images, détection d’objets, génération), l’audio (reconnaissance vocale automatique, synthèse vocale) et les tâches multimodales telles que la réponse aux questions visuelles.
Un point souvent négligé par les débutants : tous les modèles ne sont pas téléchargeables gratuitement. Les modèles à accès restreint, comme le lama de Meta, nécessitent une autorisation préalable. Une fois l’autorisation obtenue, l’authentification se fait à l’aide d’un jeton d’accès. Il est impératif de toujours vérifier la licence avant de compiler ; certains modèles interdisent toute utilisation commerciale.
La bibliothèque Transformers — Le code qui exécute la moitié du AI Monde
Le transformers une bibliothèque est une rassemblés Python paquet qui standardise la façon dont vous chargez et exécutez n'importe quel modèle sur le hub à travers PyTorch, TensorFlow et JAX avec la même API.

Le pipeline() C'est par cette fonction que la plupart des débutants devraient commencer : elle regroupe la tokenisation, le chargement du modèle et le post-traitement en un seul appel. Analyse des sentimentsGénération de texte, classification d'images : toutes ces opérations suivent exactement le même schéma. Dès que vous avez besoin d'un contrôle précis sur les résultats, il vous suffit d'écrire du code d'inférence personnalisé. En attendant, les pipelines gèrent tout.
N'omettez pas la tokenisation. Le texte brut ne peut pas être intégré directement dans un modèle. AutoTokenizer Il gère la conversion et associe automatiquement le tokenizer approprié au point de contrôle correspondant. Les erreurs les plus déroutantes rencontrées par les débutants sont souvent dues à des tokenizers incompatibles ; or, elles sont parfaitement évitables.
| Tâche | Nom du pipeline | Exemple de modèle |
|---|---|---|
| Analyse des sentiments | text-classification | base distillbert-non-case |
| Génération de texte | text-generation | Mistral-7B |
| Récapitulation | summarization | facebook/bart-large-cnn |
| Reconnaissance vocale | automatic-speech-recognition | base openai/whisper |
| Classification d'image | image-classification | google/vit-base-patch16 |
Jeux de données et espaces : deux fonctionnalités sous-utilisées.
Le datasets Cette bibliothèque charge les données au format Apache Arrow — rapide, économe en mémoire et conçue pour gérer des ensembles de données qui ne tiennent pas dans la RAM. load_dataset("name", split="train") C'est tout ce qu'il faut pour commencer. Avant de choisir un jeu de données pour un entraînement, utilisez Data Studio directement dans le navigateur pour prévisualiser et filtrer le contenu sans écrire une seule ligne de code.
Spaces est l'endroit où AI Les démos sont mises en ligne gratuitement. Votre application obtient une URL partageable en quelques minutes, sans aucune intervention DevOps. Le niveau CPU gratuit prend en charge les démos légères ; les Spaces payants, avec GPU, gèrent les modèles plus complexes.
Utilisez Gradio pour des démos de modèles rapides avec un minimum de code ; utilisez Streamlit lorsque votre application nécessite une interface de tableau de bord plus riche en données. Cloner un espace populaire est la méthode la plus rapide pour démarrer : choisissez-en un dans votre catégorie, dupliquez-le et personnalisez-le.
Configurer correctement votre compte
L'offre gratuite permet de consulter les modèles, d'utiliser les espaces CPU, de limiter le nombre d'appels API et d'accéder à l'intégralité de la communauté. L'offre Pro ajoute l'accès prioritaire aux espaces GPU, des fonctionnalités d'inférence étendues et des dépôts privés. Pour la plupart des débutants, l'offre gratuite est suffisante.
Générez un jeton d'accès sous Paramètres → Jetons d'accèsLes jetons de lecture permettent le téléchargement ; les jetons d'écriture sont nécessaires pour envoyer des modèles ou des jeux de données. Authentifiez-vous en Python avec huggingface_hub.login()Pour votre installation :

bash
pip install transformers datasets huggingface_hubAjouter accelerate, peft et trl Si des ajustements précis sont prévus, Google Colab est l'environnement le plus rapide pour les débutants absolus — et c'est gratuit. GPU, rien à configurer localement.
Exécuter votre premier modèle, puis le personnaliser
Pour l'analyse des sentiments : nous appeler pipeline("text-classification"), passer une chaîne de caractères, lire le label et score Retour. Pour la génération de texte : utilisez max_new_tokens, temperature et do_sample pour contrôler le degré de créativité par rapport à la cohérence de la production. La même chose pipeline() Ce modèle fonctionne pour la traduction, la reconnaissance vocale et la classification d'images — l'API ne change pas, seul le nom de la tâche diffère.
Quand les choses se cassent :
Une fois les bases acquises, l'étape suivante consiste à affiner le modèle. Les modèles pré-entraînés sont généraux ; les modèles affinés sont précis. L'affinage est préférable à l'aide de la fonction d'aide au démarrage lorsque vous travaillez avec des données spécifiques à un domaine, que vous avez besoin d'un comportement cohérent ou que vous souhaitez réduire les coûts d'inférence en exécutant un modèle spécialisé plus petit.
PEFT fige la majeure partie du modèle et n'entraîne que des adaptateurs légers ; inutile d'investir dans un GPU à 10 000 $. QLoRA va plus loin avec la quantification, permettant un réglage fin d'un modèle à 7 milliards de paramètres sur un simple GPU grand public.
Le Trainer L'API gère l'ensemble du cycle (traitement par lots, évaluation, point de contrôle) et le renvoi vers le hub ne nécessite qu'une seule ligne de code une fois terminé.
Inférence sans serveur dédié
L'API d'inférence hébergée vous fournit instantanément un point de terminaison REST pour tout modèle public. Le niveau gratuit est limité en débit ; il convient aux tests, mais pas à la production. Pour les applications réelles, les points de terminaison d'inférence offrent une API dédiée et privée qui s'adapte automatiquement à zéro en cas d'inactivité, ce qui permet de maîtriser les coûts malgré les variations de trafic.
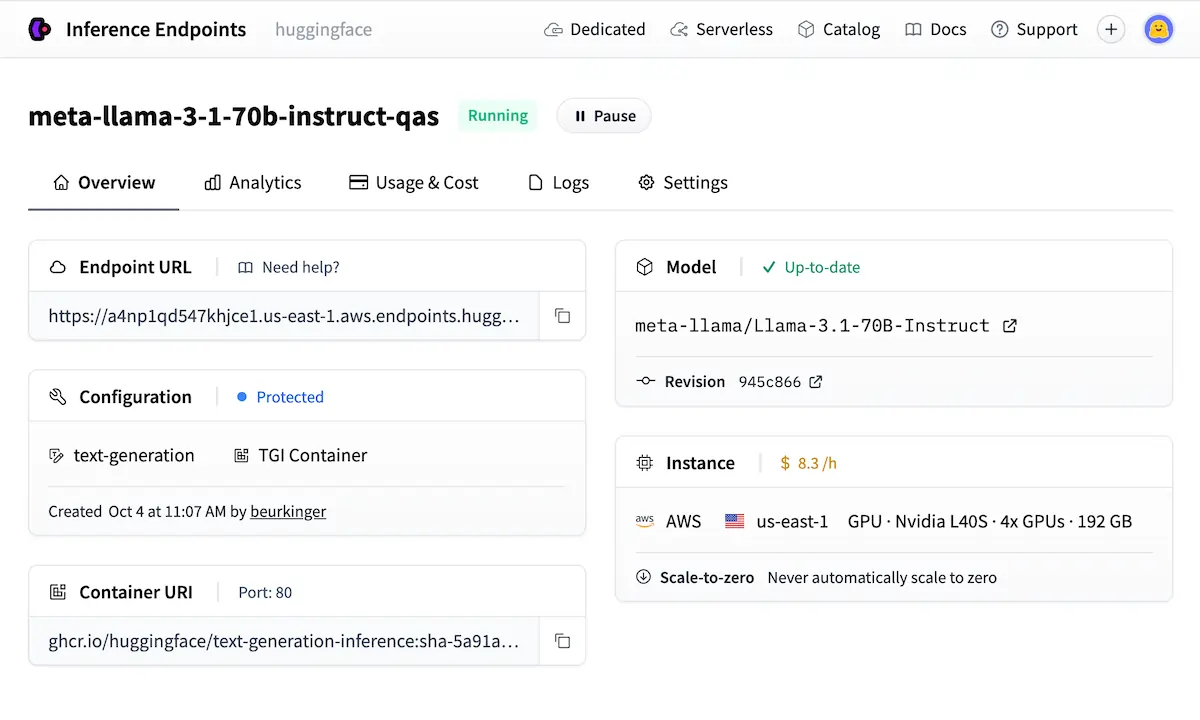
Lorsque la confidentialité des données ou la latence ne sont pas négociables, l'auto-hébergement avec TGI (Text Generation Inference) ou vLLM est la voie prête pour la production.
La communauté, les classements et pourquoi il surpasse tout le reste
Le Classement ouvert LLM Ce système classe les modèles par rapport à des critères de référence — utile pour la présélection, mais il est toujours conseillé de les valider dans votre cas d’utilisation réel avant de se fier aux scores. Les comptes d’organisation permettent aux équipes de gérer des collections de modèles partagées avec un accès contrôlé ; Meta AI, Google et EleutherAI Tous les comptes d'organisation sont exécutés directement sur le hub.
Suivre les chercheurs et les organisations vous permet de recevoir en temps réel les dernières sorties de modèles sans avoir besoin de surveiller les réseaux sociaux.
| Plateforme complète | Open source | Variété de modèle | Niveau gratuit | Outils de réglage fin |
|---|---|---|---|---|
| Étreindre le visage | ✅ Complet | ✅ 1M+ | ✅ Généreux | ✅ Pile complète |
| Hub TensorFlow | ✅ Oui | 🔶 Limité | ✅ Oui | ❌ Basique |
| Jardin modèle Google | ❌ Partiel | 🔶 Sélectionné | 🔶 GCP uniquement | 🔶 GCP uniquement |
| OuvrezAI API | ❌ Non | ❌ Fermé | ❌ Payant uniquement | 🔶 Limité |
Les erreurs qui vous coûteront des heures
- Choisir le modèle le plus grand alors qu'un modèle plus petit, adapté à une tâche spécifique, est plus rapide et moins cher.
- Passer la carte modèle's Consultez la section des limitations avant de construire quoi que ce soit par-dessus.
- Ne pas figer les révisions des modèles — les modèles se mettent à jour silencieusement et les sorties changent sans avertissement
- Utilisation de l'API Inference gratuite pour tout ce qui nécessite une disponibilité de production constante
- Transmettre directement du texte brut à un modèle sans le faire passer au préalable par un tokenizer.
AiMojo recommande :
Où aller en partant d'ici
Les cours gratuits de Hugging Face sur hf.co/learn couvrent le traitement automatique du langage naturel (TALN), l'audio et l'apprentissage par renforcement profond selon des parcours structurés conçus spécifiquement pour cette plateforme. Le meilleur premier projet : optimiser un classificateur de texte sur un jeu de données personnalisé, l'intégrer à Gradio et le déployer en tant que Space.
Cette unique compilation touche aux modèles, aux ensembles de données, au réglage fin et aux espaces en une seule opération. Une fois qu'elle's En direct, téléchargez le modèle et rédigez une fiche de modèle appropriée, couvrant l'utilisation prévue, les données d'entraînement et les limitations.
C’est ainsi que naissent les contributions publiques utiles, et c’est ainsi que l’on commence à se constituer une véritable présence dans le domaine de l’IA open source.


 BONUS: Obtenez notre 200 $ «AI « Boîte à outils de maîtrise » GRATUITE lors de votre inscription !





