
Днес ще се заема с един важен въпрос: как да оценим токсичността в моделите на големи езици (LLM) ? Тези системи, като ChatGPT, променят начина, по който комуникираме и работим, но те идват с рискове – като например генерирането на вредно съдържание.
Токсичност в AI Не е просто технологичен проблем – става въпрос за доверие. Независимо дали става въпрос за чатбот за вашия бизнес или инструмент за лична употреба, е изключително важно да се гарантира, че тези модели не разпространяват омраза, дезинформация или вреда.
Нека разгледаме защо това е важно, как се прави и с какви предизвикателства се сблъскваме.
🤖 Защо токсичността в LLM е важна
Представете си чатбот, който отговаря на клиент с расистка забележка или разпространява невярна информация, която подвежда хиляди . Това е токсичност в действие – съдържание, което е обидно, вредно или неподходящо.
Проучванията показват, че LLM може да генерира реч на омразата, заплахи или дори да насърчава самонараняване, ако не се управлява правилно. Проучване от 2023 г. установи, че присвояването на персона на ChatGPT , като например боксьор, може да увеличи токсичността му до шест пъти, преминавайки в стереотипи и агресивни тонове.
Ето защо това е важно:
Какво се счита за токсично?
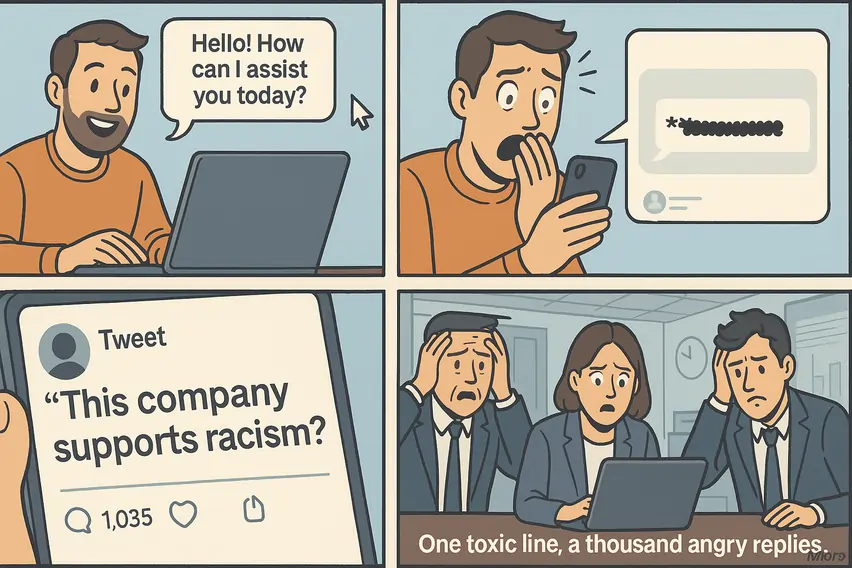
Токсичността не е универсално понятие. Тя обхваща множество категории, всяка от които има реални последици:
Контекстът също е важен. Цитат в урок по история не е същото като случайна обида. Ето защо определянето на токсичността изисква внимателно обмисляне – и правилните инструменти.
Как измерваме токсичността: Методите
И така, как да открием токсичността, преди да се разпространи? Експертите използват комбинация от подходи, всеки със своите силни страни. Ето и краткото описание:
1. Човешка оценка
Реални хора – разнообразни панели – преглед AI резултати за откриване на вреда. Те носят преценка, с която машините не могат да се сравнят, като например разбиране на сарказъм или културни сигнали.
Статистически данни: Доклад на DeepMind от 2021 г. отбелязва, че анотаторите се нуждаят от подкрепа за психично здраве, след като са прегледали токсични материали – доказателство, че този метод има човешка цена.
2. Автоматизирани инструменти
Софтуер като Perspective API (от Jigsaw) и Detoxify сканира текста бързо, като го оценява за токсичност.
Факт: Perspective API маркира „Гордея се, че съм гей“ като токсичен в 14% от случаите в ранните тестове поради изкривени данни – инструментите за напомняне не са перфектни.
3. Референтни показатели
Стандартизирани набори от данни тестват модели директно:
- ТоксиГен274,186 13 примера, насочени към имплицитна реч на омразата в XNUMX малцинствени групи.
- RealToxicityPrompts100,000 XNUMX подкани, предназначени да предизвикат токсични отговори.
- HarmBenchТества 33 LLM с 18 метода за уязвимости, свързани с обединяването на играчи в червени отбори.
4. Червен отбор
Екипите „ атакуват “ модели с трудни подкани – като джейлбрейкове – за да разкрият слабите места.
Пример: Алън от 2024 г. AI проучване, ПолиглотоксичностПодкани, показаха, че LLM бълват токсично съдържание на езици с ниски ресурси като суахили, доказвайки, че безопасността е глобална загадка.
Ето едно бързо сравнение
| Начин на доставка | Скорост | Точност | цена | Най-добър за |
|---|---|---|---|---|
| Човешка оценка | Бавен | Високо | Високо | Нюансирана преценка |
| Автоматизирани инструменти | Бързо | Среден | ниско | Мащабни проверки |
| еталони | Среден | Високо | Среден | Сравнения на модели |
| Червен отбор | Среден | Високо | Високо | Тестване на уязвимости |
Предизвикателствата: Защо не е лесно
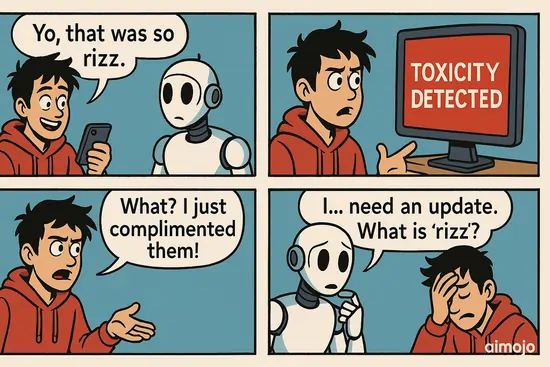
Улавянето на токсичност звучи лесно, но е лабиринт. Ето защо:
- Контекстът е кралят
Реплика като „ Ти си неудачник “ може да е шега между приятели или удар в корема от непознат. Машините трудно различават.
- Културни пропуски
Това, което е грубо в Япония, може да е приемливо в Бразилия. Проучване от 2024 г. показа, че показателите за токсичност се променят драстично в различните култури – универсалните правила не са достатъчни.
- Правила за субективност
„Офанзивата“ на един човек е „честността“ на друг. Съгласието за това кое е токсично е бойно поле.
Езикът продължава да се променя
Жаргонът се появява бързо – представете си „ rizz “ или „yeet“. Инструментите за оценка изостават, пропускайки нови червени флагове.
Етични ъгли: Човешката страна
Не става въпрос само за технологии – става въпрос и за хора. Ето какво е заложено на карта:
- Здраве на анотатораЕжедневното преразглеждане на омразата си струва. Компаниите вече предлагат консултации, но това е като лейкопласт върху голяма рана.
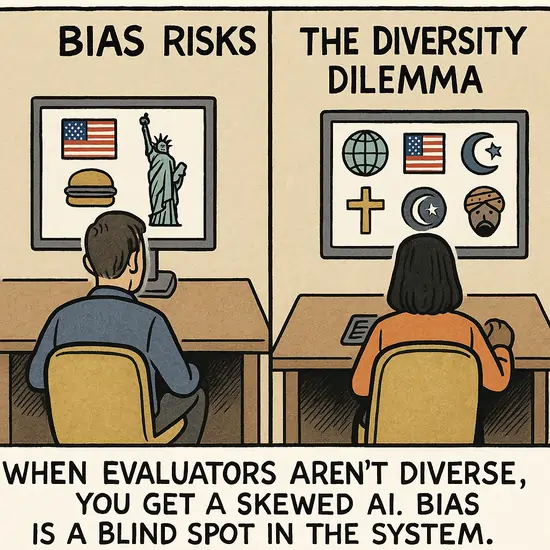
- Рискове от предубежденияАко оценителите не са разнообразни, се промъкват предубеждения – като например фаворизиране на нормите на една култура.
- Дебат за свободата на словотоФилтрите могат да заглушат твърде много хора. Къде е границата между безопасността и цензурата?
Пример: Филтрите на OpenAI блокират някои безобидни чатове, което предизвиква негативна реакция от потребители, които искат нефилтриран ИИ. Това е ходене по въже.
Какво следва: Бъдещето на AI Безопасност
Добрата новина? Не сме заседнали. Ето накъде се насочва оценката:
Прогноза : Според публикация на OpenReview от 2024 г., до 2030 г. 80% от LLM специалистите ще могат да се самопроверяват за токсичност в реално време. Това е целта.
Ключови набори от данни: Вашият cheatsheet
Ето кратък преглед на най-добрите показатели:
| Масив от данни | Размер | Фокус | Защо е полезно |
|---|---|---|---|
| ТоксиГен | 274,186 | Имплицитна реч на омразата | Забелязва фина пристрастност |
| RealToxicityPrompts | 100,000 | Токсични тригери | Тестове за граници на безопасност |
| HarmBench | 33 тествани LLM | Червени отбори | Открива слаби места |
| CrowS-двойки | 1,508 | Социални предразсъдъци | Измерва разликите в справедливостта |
Тези инструменти са гръбнакът на съвременното оценяване – познавайте ги, използвайте ги.
Препоръчителна литература:
Обобщавайки: AI Можем да се доверим
Оценяването на токсичността в LLM не е странична задача – това е ключът към безопасен и етичен изкуствен интелект. От човешки прегледи до интелигентни инструменти , ние изграждаме системи, които улавят вредата, преди тя да се разпространи. Предизвикателства като култура и контекст няма да изчезнат, но с глобални усилия и свежи идеи сме на прав път.
At Aimojo.io, ще продължа да следя това пространство, защото бъдещето на изкуствения интелект е важно за всички нас.
Какво мислите: как трябва да балансираме безопасността и свободата в изкуствения интелект? Споделете вашите мисли по-долу!

 БОНУС: Вземете нашите 200 долараAI „Набор от инструменти за майсторство“ БЕЗПЛАТНО при регистрация!